사샤 러시: 어렵게 배우는 맘바Sasha Rush: Mamba: The Hard Way
Triton으로 누적합부터 지수 이동 평균, 역전파 유도, 여러 은닉 상태를 한꺼번에 다루는 스캔까지 차근차근 쌓아 올려 Mamba의 S6 선택적 스캔을 직접 구현하는 사샤 러시의 노트북 글
Contents목차
번역문 · 원저자: Sasha Rush (Albert Gu, Tri Dao의 연구를 바탕으로 함) · 원문: Mamba: The Hard Way · 원문 라이선스: MIT (Copyright (c) 2023 Sasha Rush). 원문의 저작권 표시와 MIT 허가 문구는 글 끝 「라이선스 고지」에 그대로 옮겼습니다. 원문 글쓴이가 그리거나 코드로 만든 그림은 글과 같은 MIT 라이선스를 따르므로 그대로 실었습니다. Mamba 논문에서 가져온 그림 4개는 논문이 CC BY 4.0으로 공개되어 있어 함께 실었고, 가져온 그림 아래에는 출처와 라이선스를 달았습니다.
원문: 「Mamba: The Hard Way」, Sasha Rush, https://srush.github.io/annotated-mamba/hard.html. 원본은 Colab 노트북(Scan.ipynb)이며, 저장소에는 2024년 2월 19일에 처음 올라왔습니다. 이 글은 원문을 한국어로 옮긴 번역문입니다.
라이선스: 저장소 srush/annotated-mamba는 MIT 라이선스(Copyright (c) 2023 Sasha Rush)를 따릅니다. 코드와 코드 안 주석, 실행 결과는 원문 그대로 두었습니다. 원문 맨 위의 「Open In Colab」 배지와 노트북에서 넘어온 그림 이름표(image.png, png)는 뺐습니다. 원문 목차의 각 항목은 본문 절로 이어지는 링크인데, 여기서는 목록만 옮겼습니다.
그림 출처: Albert Gu, Tri Dao, 「Mamba: Linear-Time Sequence Modeling with Selective State Spaces」, CC BY 4.0. 원문 글쓴이가 가져다 쓴 그림입니다.
저장소와 Colab은 srush/annotated-mamba에 있습니다.
글: 사샤 러시
앨버트 구와 트라이 다오의 연구를 바탕으로 했습니다.
V2: 새 Triton 함수 몇 개를 더했고, mamba 저장소 구현과 결과를 맞춰 보는 검사를 넣었습니다.
이 글은 최근에 나온 신경망 구조인 Mamba를 다룹니다. Mamba는 대략 현대판 순환 신경망이라고 생각하면 됩니다. 이 모델은 성능이 무척 좋아서, 어디에나 쓰이는 트랜스포머 구조와 정면으로 겨룰 만한 상대입니다. 그래서 관심도 많이 받았습니다.
원래는 논문 전체를 다루는 글을 쓰려고 했습니다. 논문은 내용이 꽤 빽빽하고 통찰도 많습니다. 그런데 여기 나오는 S6 알고리즘 하나에 그만 푹 빠져 버렸습니다. 이 알고리즘은 아주 큰 RNN을 요즘 하드웨어에서 효율적으로 계산하는 방법을 설명하며, 최근 몇 년 사이에 나온 S4와 S5에서 다룬 생각을 더 넓힌 것입니다.
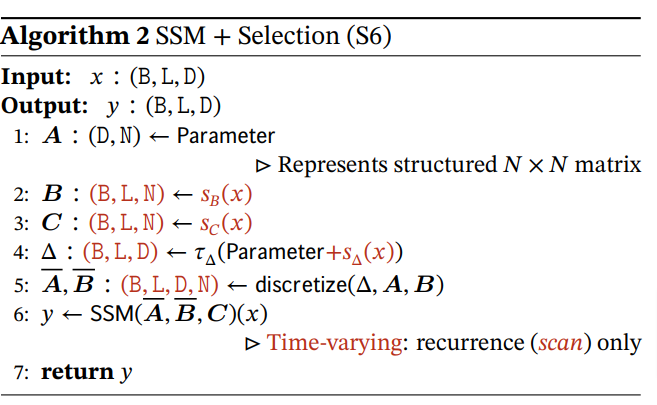
그림 출처: Albert Gu, Tri Dao, 「Mamba: Linear-Time Sequence Modeling with Selective State Spaces」, CC BY 4.0. 원문 글쓴이가 가져다 쓴 그림입니다.
그런데 솔직히 말하면, 저는 알고리즘의 바로 이 한 줄까지밖에 가지 못했습니다.

그림 출처: Albert Gu, Tri Dao, 「Mamba: Linear-Time Sequence Modeling with Selective State Spaces」, CC BY 4.0. 원문 글쓴이가 가져다 쓴 그림입니다.
이 한 줄은 충분히 흥미로워서, 이런 생각이 들었습니다. 이 스캔이 실제로 왜 빠른지는 누구나 이해할 수 있어야 하지 않을까?
알고 보니 이게 조금 까다롭습니다. 하지만 이 글을 끝까지 읽으면 이 한 줄은 확실히 이해하게 된다고 장담합니다. (어쩌면 원하는 것보다 훨씬 더 많이 알게 될지도 모릅니다.)
- 0부: Triton
- 1부: 누적합
- 2부: 지수 이동 평균
- 3부: 도함수 구하기
- 4부: 여러 개를 한꺼번에
- 5부: Mamba
0부: Triton
이 일을 하려면 Triton을 조금 배워야 합니다.
Triton은 OpenAI가 만든, GPU 코드를 쓰기 위한 프로그래밍 언어입니다. Jax나 Numba처럼 파이썬 안에 들어 있는 내장 언어이고, 생김새는 Numpy와 꽤 비슷합니다. 가장 큰 장점은 GPU 코드를 쓸 때 어려운 부분 일부를 더 간단한 명령으로 감싸 준다는 점입니다. PyTorch와도 잘 어울립니다.
Triton을 쓰는 주된 이점은 CUDA로 직접 쓸 때보다 최종 코드가 훨씬 짧아진다는 것입니다. 하지만 거기까지 한 단계씩 쌓아 올려서, 과정의 각 단계를 모두 따라올 수 있게 하려 합니다.
%%capture
# Only works with latest triton.
!pip install mamba-ssm
!pip install -U http://kermit.bounceme.net:8900/triton-3.0.0-cp310-cp310-linux_x86_64.whl
!export LC_ALL="en_US.UTF-8"
!export LD_LIBRARY_PATH="/usr/lib64-nvidia"
!export LIBRARY_PATH="/usr/local/cuda/lib64/stubs"
!ldconfig /usr/lib64-nvidia
import triton
import triton.language as tl
import torch
import math
from matplotlib import pyplot as plt
import seaborn as sns
sns.set(rc={'figure.figsize':(10,4)})
sns.set_style("whitegrid", {'axes.grid' : False})
ones = lambda *size: torch.ones(*size).float().cuda()
zeros = lambda *size: torch.zeros(*size).float().cuda()
arange = lambda n: torch.arange(n).float().cuda()
rand = lambda size: torch.rand(*size).abs().float().cuda()
def check(*inputs, prec=1e-4):
for i, (a, b) in enumerate(zip(inputs[::2], inputs[1::2])):
if isinstance(b, list):
b = torch.tensor(b)
c = torch.allclose(a.cpu(), b.cpu(), prec)
c1 = torch.isclose(a.cpu(), b.cpu(), prec)
assert c, f"{i}\n{a}\n{b}\n{c1}"
print("✔️")Triton은 작은 언어입니다. 주로 GPU 전역 메모리에서 텐서를 읽어 오고, 기본 텐서 연산으로 다룬 다음, 다시 써 내보내는 일을 할 수 있습니다. PyTorch에서 익숙하게 쓰던 기능 가운데 없는 것이 많습니다. 예를 들어 인덱싱이 없습니다!
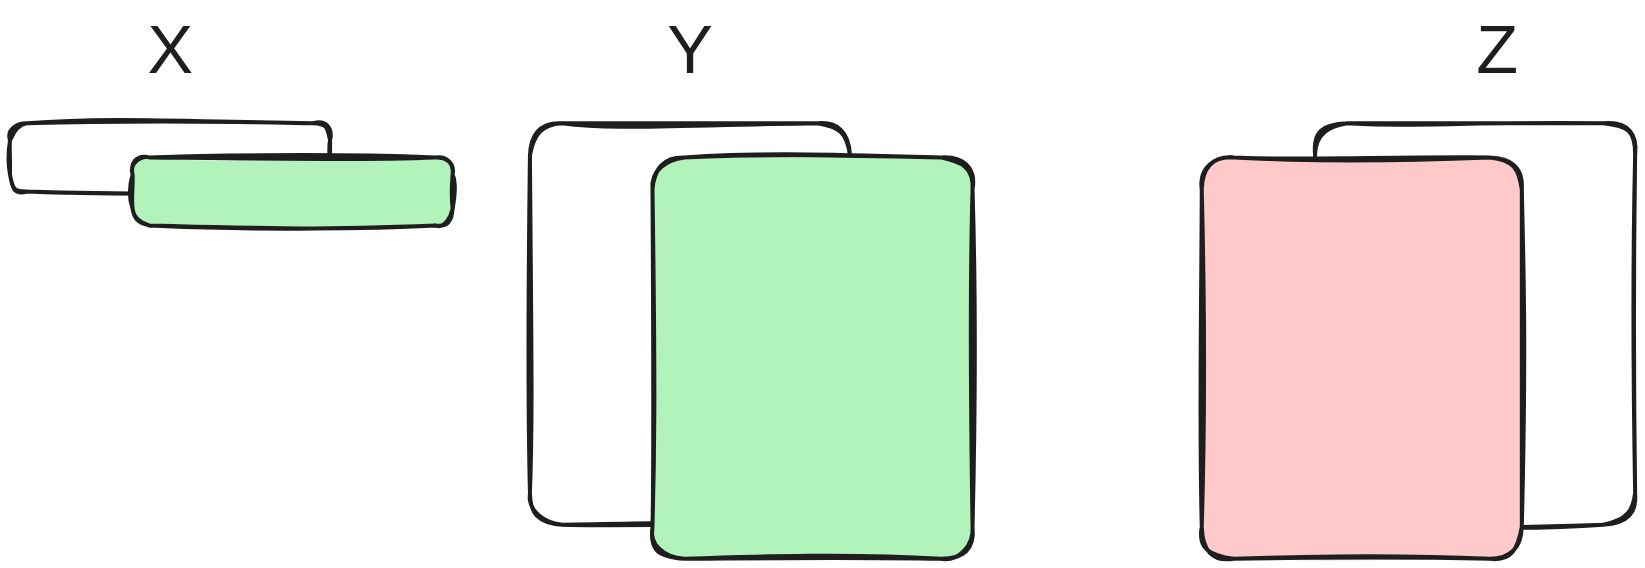
@triton.jit
def triton_hello_world(X, Y, Z, K: tl.constexpr, L: tl.constexpr):
    # Use arange to build the shape for loading
    Ks = tl.arange(0, K) # K
    Ls = tl.arange(0, L)[:, None] # L x 1

    # Load from memory
    x = tl.load(X + Ks) # K
    y = tl.load(Y + Ls*K + Ks) # L x K
    z = x + y # L x K

    # Store
    tl.store(Z + Ls*K + Ks, z) # L x K

x, y = arange(4),ones(8, 4)
z = zeros(8, 4)
triton_hello_world[(1,)](x, y, z, 4, 8)
z
tensor([[1., 2., 3., 4.],
[1., 2., 3., 4.],
[1., 2., 3., 4.],
[1., 2., 3., 4.],
[1., 2., 3., 4.],
[1., 2., 3., 4.],
[1., 2., 3., 4.],
[1., 2., 3., 4.]], device='cuda:0')성공입니다. GPU에서 돌아갔습니다. 하지만 이것만으로는 그리 흥미롭지 않습니다.
이 언어가 쓸모 있으려면 아주 큰 입력에서 돌려야 합니다. 이유는 나중에 더 분명해지겠지만, 우선 예제를 블록 형태로 고쳐 보겠습니다.
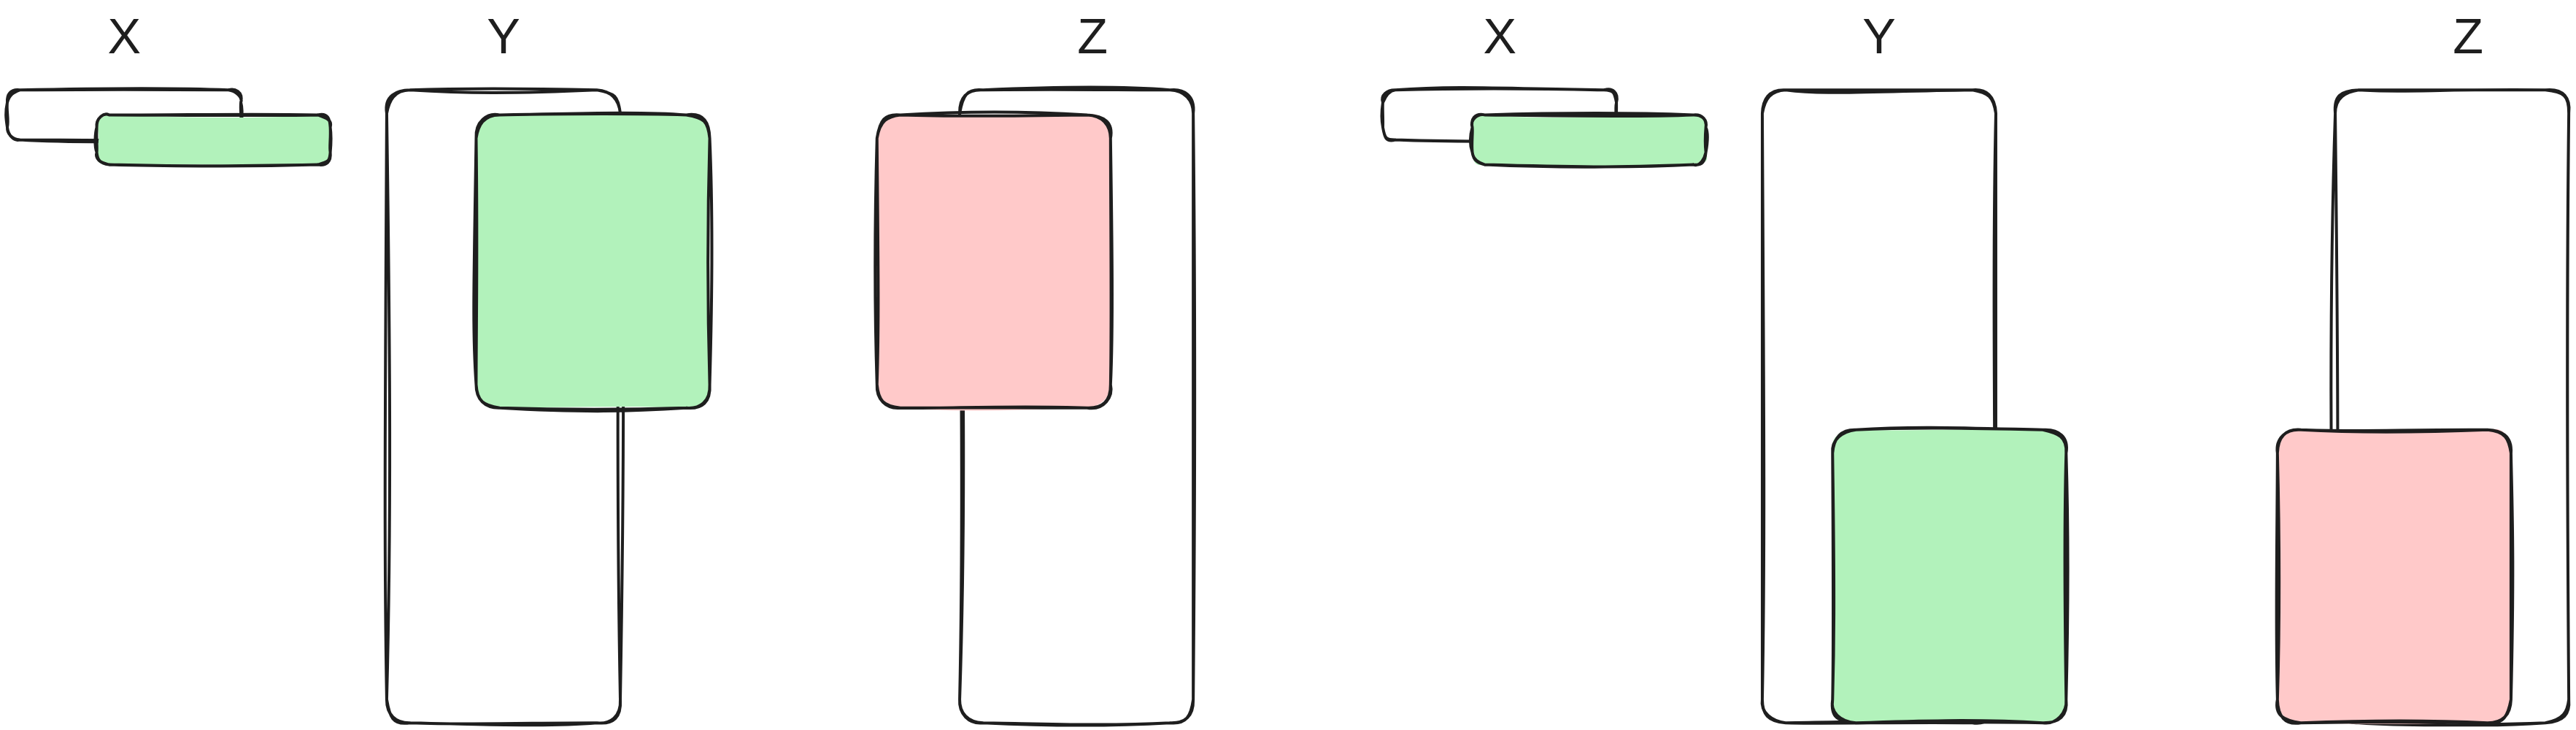
@triton.jit
def triton_hello_world_block(X, Y, Z, K: tl.constexpr, L: tl.constexpr):
    # Run each program in parallel
    pid = tl.program_id(0)
    lid = pid * L

    # Use arange to build the shape for loading
    Ks = tl.arange(0, K) # K
    Ls = tl.arange(0, L)[:, None] # L x 1

    # Load from memory
    x = tl.load(X + Ks) # K

    # Load based on program id.
    y = tl.load(Y + (Ls + lid) *K + Ks) # L x K
    z = x + y # L x K

    # Store
    tl.store(Z + (Ls + lid) * K + Ks, z) # L x K

L = 2**10
x, y = arange(4),ones(L, 4)
z = zeros(L, 4)
num_blocks = 8
triton_hello_world_block[(L // num_blocks,)](x, y, z, 4, num_blocks)
z.shape, z
(torch.Size([1024, 4]),
tensor([[1., 2., 3., 4.],
[1., 2., 3., 4.],
[1., 2., 3., 4.],
...,
[1., 2., 3., 4.],
[1., 2., 3., 4.],
[1., 2., 3., 4.]], device='cuda:0'))이것이 이 언어가 돌아가는 기본 방식이고, 이걸로 점점 더 복잡한 프로그램을 구현해 나가겠습니다. 시험하고 배우기 쉽도록, 각 프로그램마다 단순한 버전과 블록 버전을 따로 만들겠습니다.
1부: 누적합
먼저 1차원 수열의 단순한 누적합을 구현하는 데서 시작하겠습니다. torch.cumsum 함수와 같은 것입니다.
조금 깐깐하게, 이것을 다음과 같은 꼴로 쓰겠습니다.
# Constants used throughout
K = 16
BLOCKS = 8
SEQLEN = K * BLOCKS

x = arange(SEQLEN)
y = zeros(SEQLEN)
def cumsum(x):
y = []
h = 0
for k in range(len(x)):
h = h + x[k]
y.append(h)
return h, y
h_, y_ = cumsum(x.cpu())
plt.bar(range(SEQLEN), y_)<BarContainer object of 128 artists>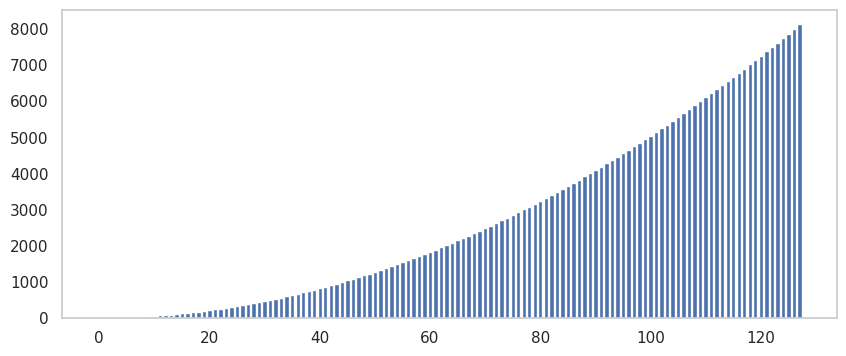
단순한 구현
이제 첫 Triton 프로그램을 써 봅시다. 1차원 텐서에 대한 누적합입니다.
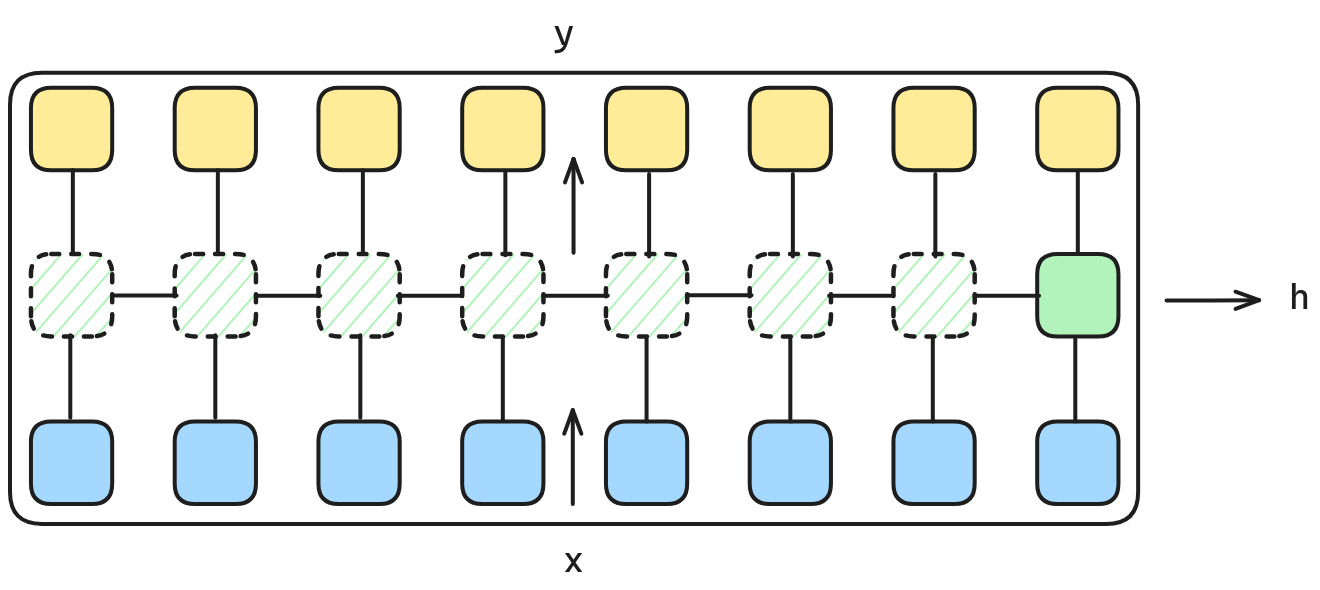
Triton 함수에는 @triton.jit를 붙입니다. 기본 함수 cumsum1_tt에 들어가는 입력은 포인터입니다. 이 포인터에서 읽고 쓰는 데에는 tl.load와 tl.store를 썼습니다. 포인터 범위는 tl.arange로 나타낼 수 있습니다. H에는 마스크를 써서 마지막 값만 써 내보냅니다.
@triton.jit
def plus_fn(a, b):
    # This is a helper function where a and b are tensors.
    return a + b

@triton.jit
def cumsum1_tt(X, Y, H, K: tl.constexpr):
    # This is the base triton function. Capital letters are pointers to memory.

    # Create a tensor from 0 to K - 1
    Ks = tl.arange(0, K)

    # Load in a sequence of K x's (blue)
    x = tl.load(X + Ks)

    # Compute h (green) and y (yellow) on axis 0.
    hs = tl.associative_scan(x, 0, plus_fn)
    y = hs

    # Write out K y's
    tl.store(Y + Ks, y)

    # Write out only the last h to memory.
    tl.store(H + Ks * 0, hs, mask=Ks == (K-1))

# Test to confirm it runs on the GPU.
h = zeros(1)
cumsum1_tt[(1,)](x, y, h, K=K)

h_, y_ = cumsum(x[:K].tolist())
check(h[0], [h_], y[:K], y_)✔️다만 내부에서는 왼쪽에서 오른쪽으로 차례차례 계산하지 않고 트리를 쌓아 올린다는 점에 주의하세요.
덧셈은 결합 법칙이 성립하므로 입니다.
그래서 Triton의 associative_scan 함수를 쓸 수 있습니다. 이 함수는 이 트리를 병렬로 계산해 모든 수를 더합니다.
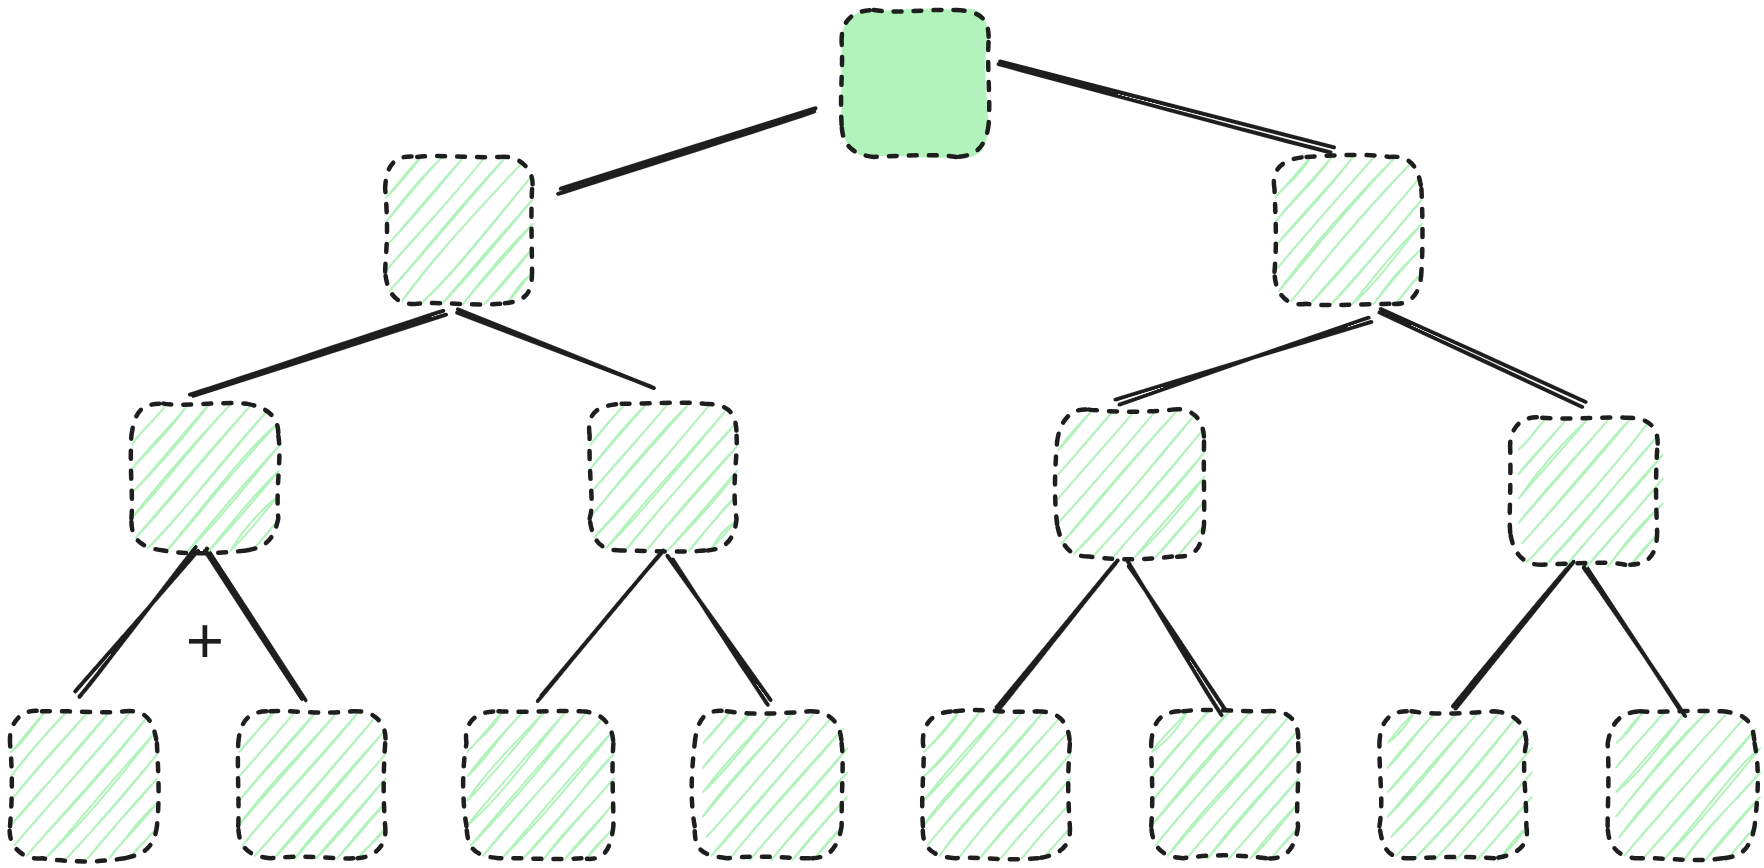
중간 항들을 계산하려면 트리를 한 번 타고 올라간 다음, 다시 한 번 타고 내려와 각 중간값을 얻어야 합니다. associative_scan이 하는 일이 바로 이것입니다.
블록 구현
그런데 문제가 하나 있습니다. 한 번에 GPU에 불러올 수 있는 값은 최대 개뿐입니다. 아주 긴 수열이라면 수열을 블록으로 나누는 편이 낫습니다.
계산의 일부는 블록마다 따로 할 수 있습니다. Triton에서는 이것이 서로 다른 프로그램 ID에 해당합니다.
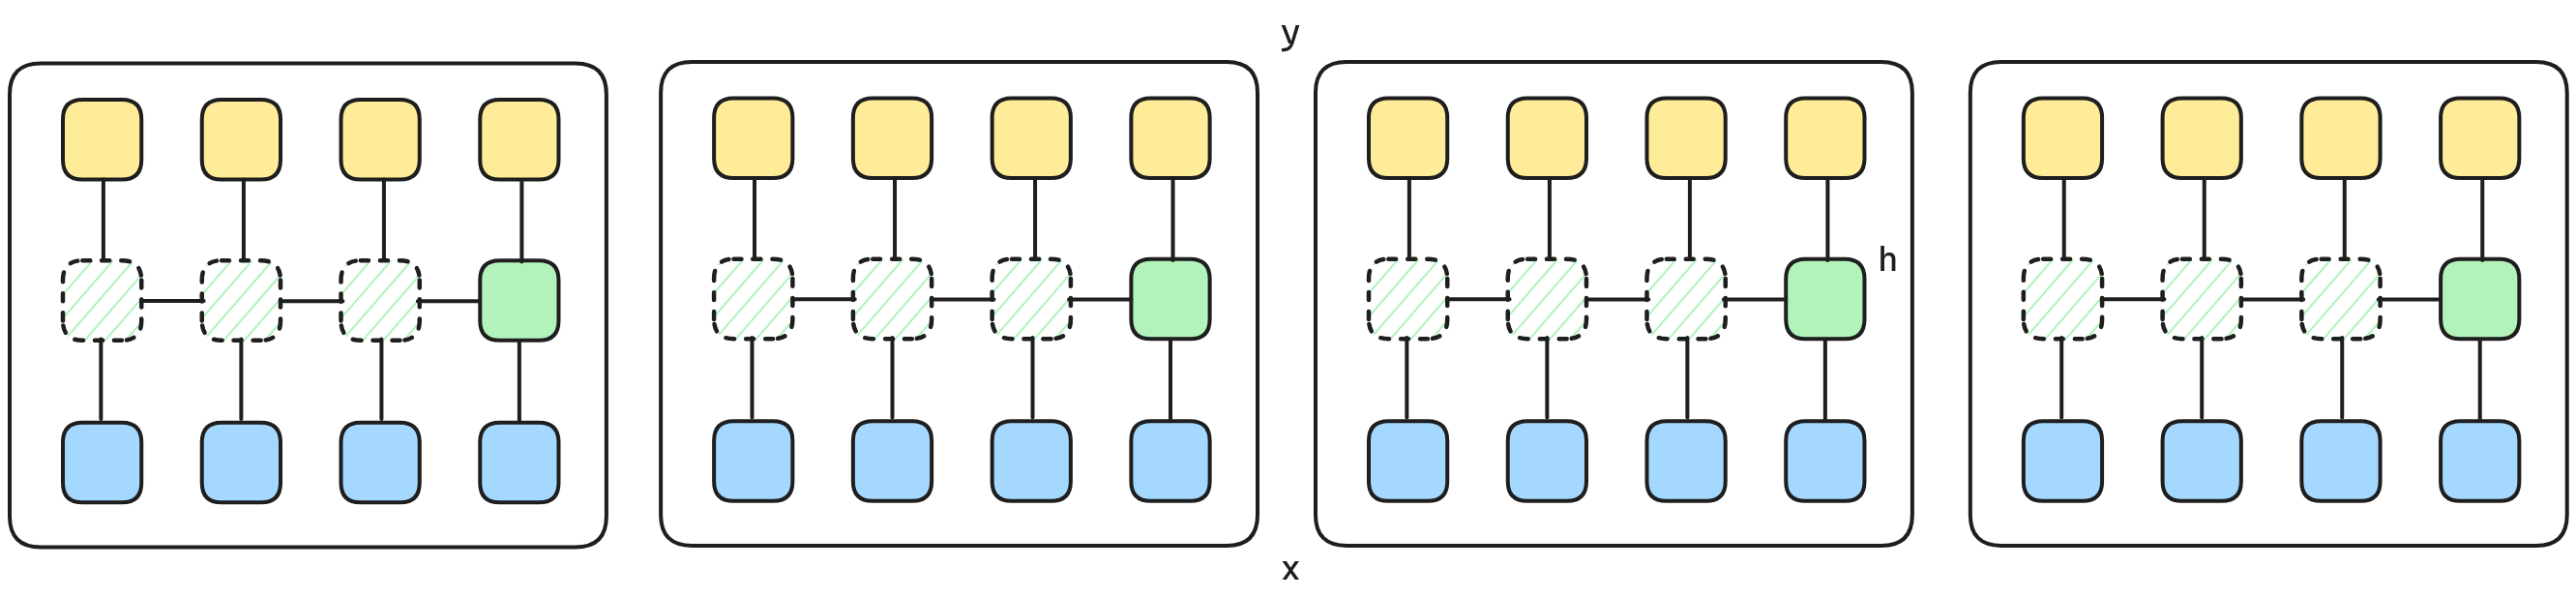
똑같은 Triton 코드가 블록마다 동시에 실행됩니다.
@triton.jit
def cumsum_tt(X, H_0, Y, H, K: tl.constexpr):
    # Which block an I?
    pid = tl.program_id(0)

    # How far into the sequence am I?
    kid = K * pid
    Ks = tl.arange(0, K)

    # Load in K x's per block and 1 starting h
    x = tl.load(X + Ks + kid)

    # Load the first value as H_0 and the rest 0
    h_0 = tl.load(H_0 + Ks * 0 + pid, Ks == 0, 0)

    # Allow for a starting value.
    x = plus_fn(h_0, x)

    # Compute scan
    hs = tl.associative_scan(x, 0, plus_fn)
    y = hs

    # Write out K y's per block and 1 h
    tl.store(Y + Ks + kid, y)

    # Write out only the last value to H
    tl.store(H + Ks * 0 + pid, hs, mask=Ks == (K-1))

h = zeros(BLOCKS)
cumsum_tt[(BLOCKS,)](x, h, y, h, K=K)
h_, y_ = cumsum(x[K:2 * K].tolist())
assert h_ == h[1]
하지만 이렇게 하면 전체 누적합이 아니라 블록마다의 합만 얻습니다.
전체 합을 얻으려면 블록들을 이어 붙여야 합니다. 이를 위해 세 단계를 거칩니다.
- 블록마다 스캔합니다.
- (1)의 결과를 다시 누적해 더합니다.
- 시작값을 넣어 블록마다 다시 스캔합니다.
다행히 코드를 그대로 다시 쓸 수 있습니다.
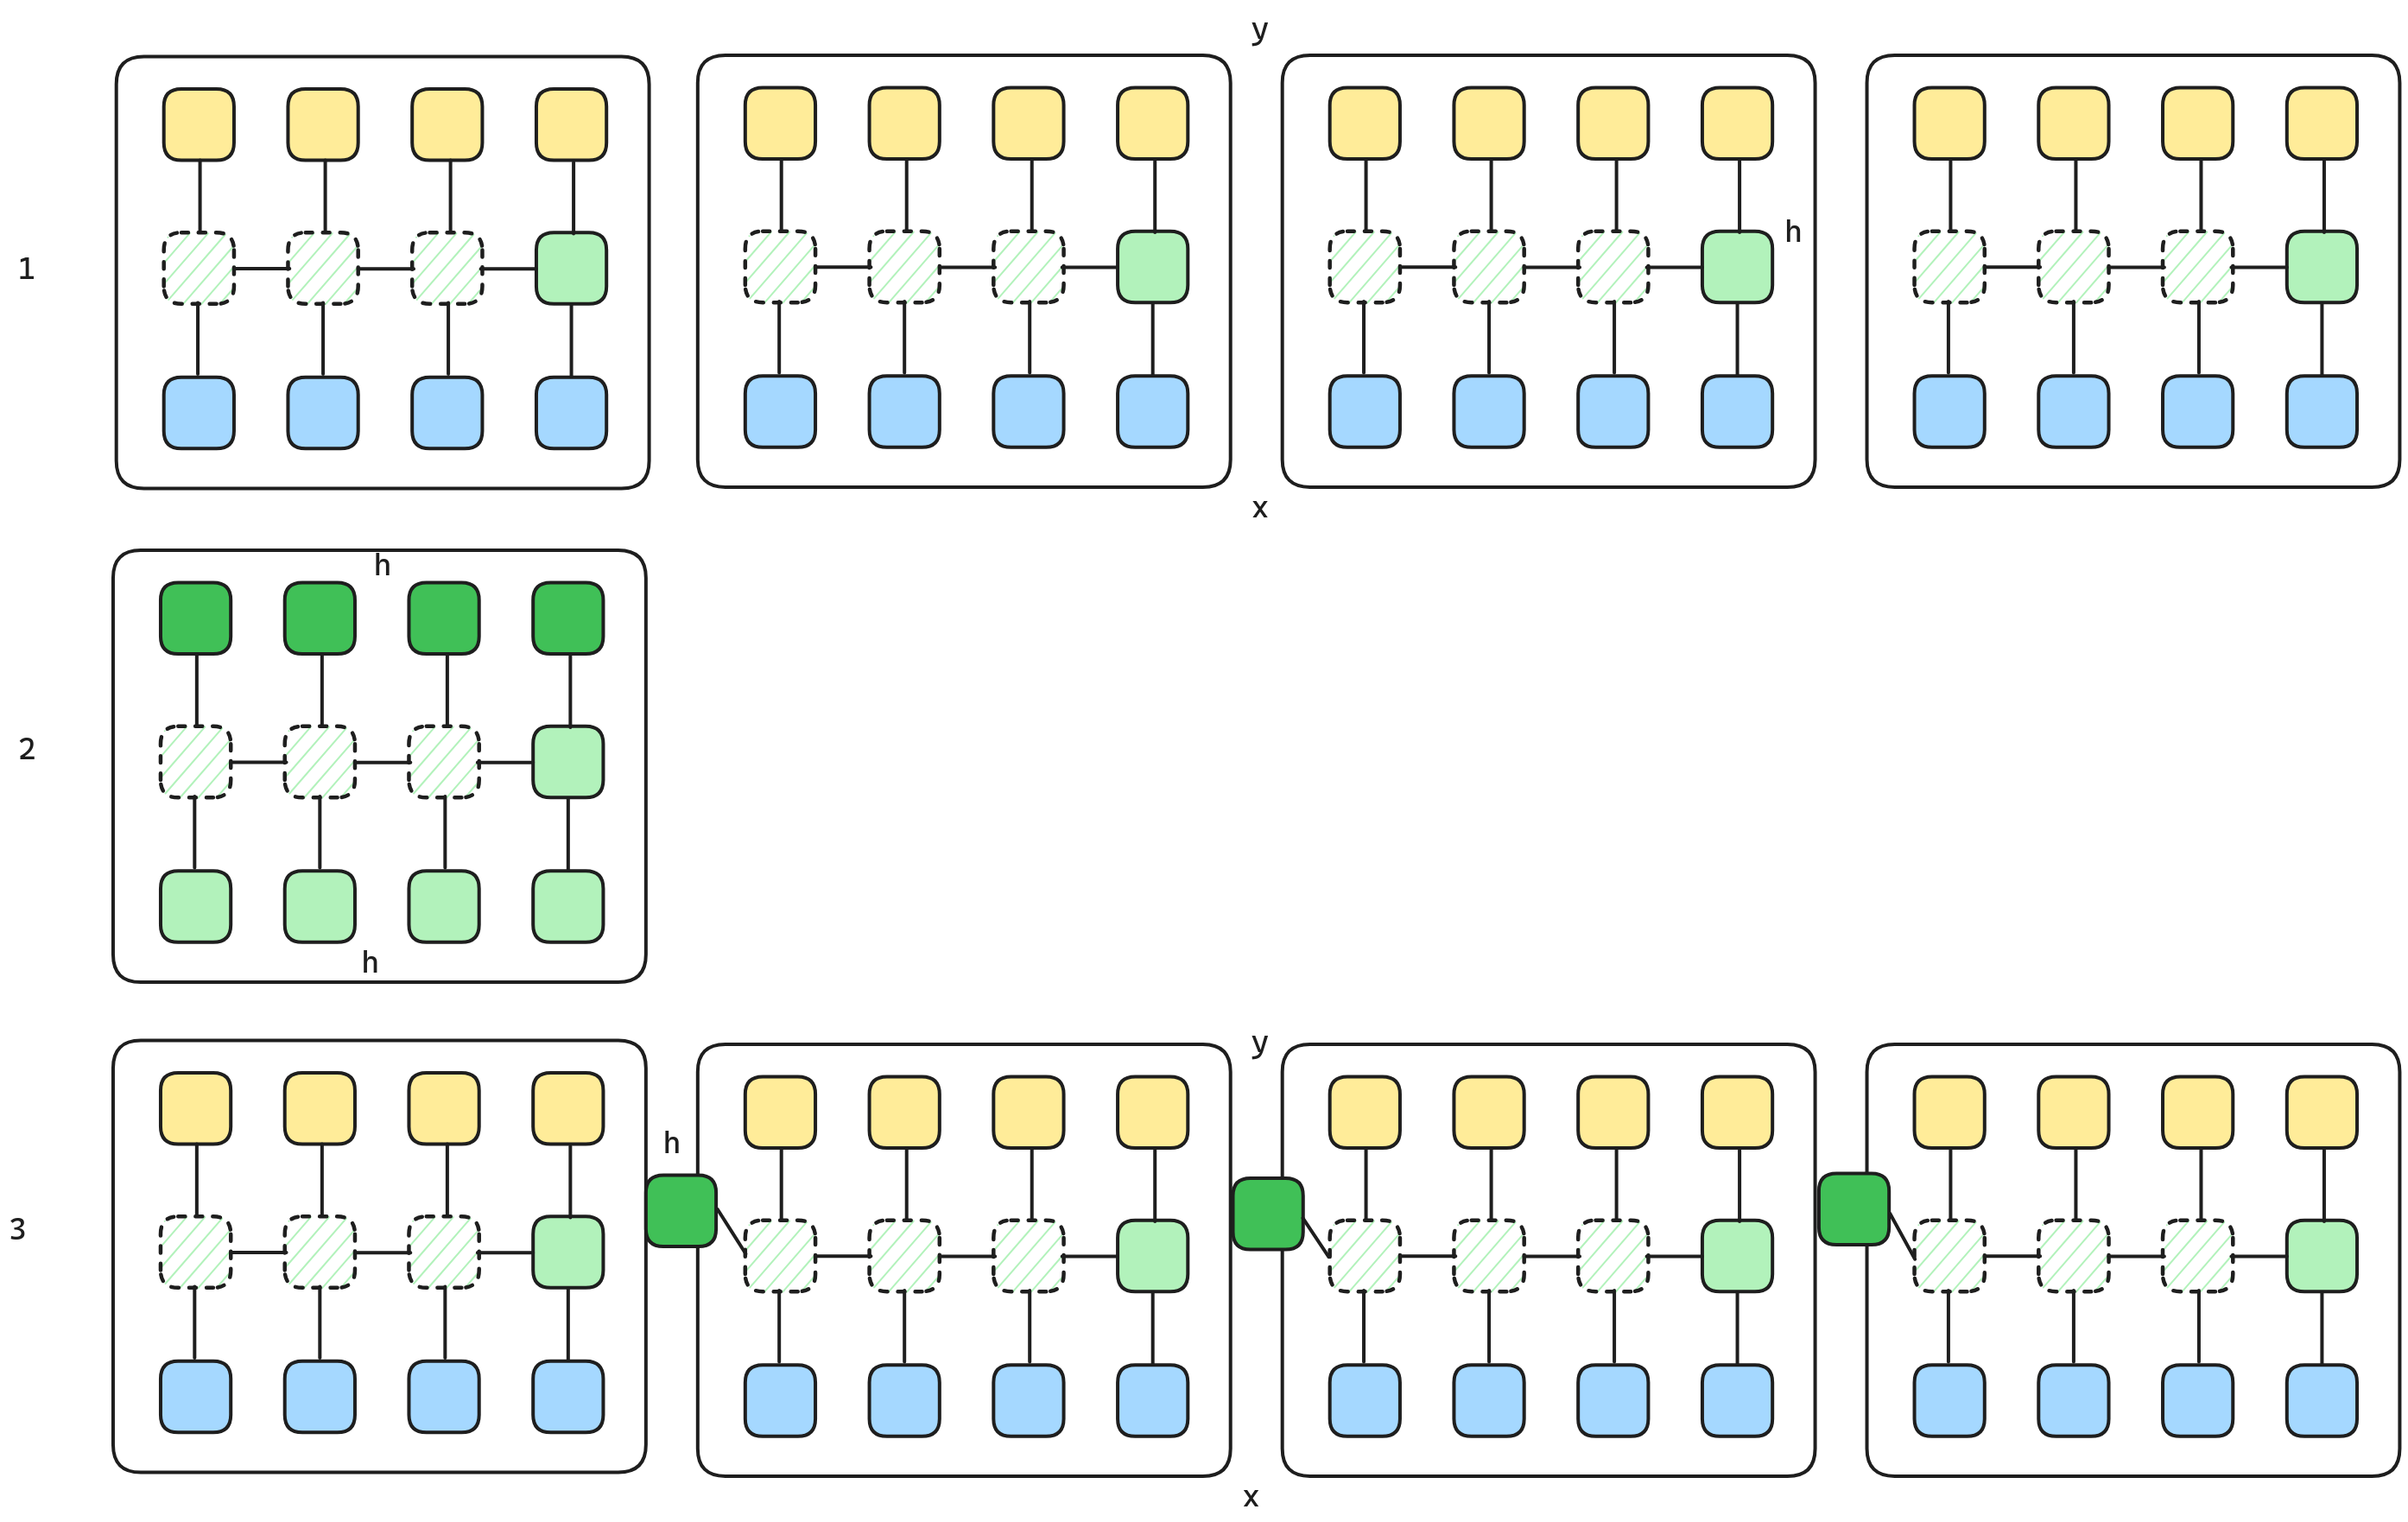
커널을 한 번 돌리고, 진한 초록 칸을 PyTorch에서 더한 뒤, 커널을 다시 돌리는 식으로 모두 하나로 엮겠습니다.
def cumsum_block(x, y, K):
    seqlen = y.shape[0]
    BLOCKS = seqlen // K
    h = zeros(2, BLOCKS)
    cumsum_tt[(BLOCKS,)](x, h[0], y, h[0], K=K)
    h[1, 1:] = h[0].cumsum(0)[:-1]
    cumsum_tt[(BLOCKS,)](x, h[1], y, h[1], K=K)

cumsum_block(x, y, K)
h_, y_ = cumsum(x.tolist())
check(y, y_)✔️y_out = zeros(2**25)
x_gpu = ones(2**25)
x_ = x_gpu.cpu()%%timeit
x_.cumsum(0)178 ms ± 7.7 ms per loop (mean ± std. dev. of 7 runs, 1 loop each)%%timeit
cumsum_block(x_gpu, y_out, K = 2**10)915 µs ± 7.64 µs per loop (mean ± std. dev. of 7 runs, 1000 loops each)좋습니다. 이 코드라면 우주 전체도 더할 수 있겠습니다.
2부: 지수 이동 평균
조금 더 복잡한 스캔으로 넘어가 봅시다.
시계열의 지수 이동 평균을 계산하려 합니다.
alpha = 0.9
def ema(x, alpha):
    y = []
    h = 0
    for k in range(len(x)):
        h = alpha * h + (1-alpha) * x[k]
        y.append(1 * h)
    return h, y

h_, y_ = ema(range(SEQLEN), alpha)
plt.bar(range(SEQLEN), y_)
<BarContainer object of 128 artists>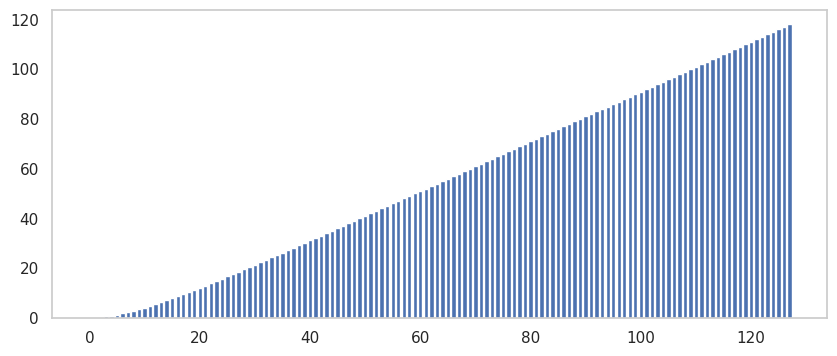
이런 꼴의 점화식을 조금 일반화해서 계수가 서로 다를 수 있게 하겠습니다. 간단히 이것을 이산 시간 상태 공간 모델 스캔이라고 부르겠습니다.
(이 글에서는 구현에 집중하고 싶어서 SSM의 세부 내용은 일부러 다루지 않겠습니다. SSM은 EMA보다 조금 더 정교하지만, EMA는 출발점으로 삼기에 무리가 없습니다.)
def ssm_scan(x, a, b, c):
    y = []
    h = 0
    for k in range(len(x)):
        h = h * a + b * x[k]
        y.append(c * h)
    return h, y

h_, y_ = ssm_scan(range(SEQLEN), alpha, (1-alpha), 1)
누적합과 비슷하지만, 얼핏 보면 결합 법칙이 성립할 것 같지 않습니다.
하지만 쌍 객체 에 작용하는 연산 를 정의하면 결합 법칙이 성립하는 꼴로 바꿀 수 있습니다. 여기서 는 다음과 같이 정의합니다.
파이썬으로는 이렇게 구현합니다.
def op(a, b):
    return (a[0] * b[0], b[0] * a[1] + b[1])

def ssm_associative(x, a, b, c):
    y = []
    h = (alpha, 0)
    for k in range(len(x)):
        h_new = (a, b * x[k])
        h = op(h, h_new)
        y.append(c * h[1])
    return h, torch.stack(y)

assert ema(x, alpha)[0] == ssm_associative(x, alpha, 1-alpha, 1)[0][1]
h_, y_ = ssm_associative(x, alpha, 1-alpha, 1)
plt.bar(range(SEQLEN), y_.cpu())
<BarContainer object of 128 artists>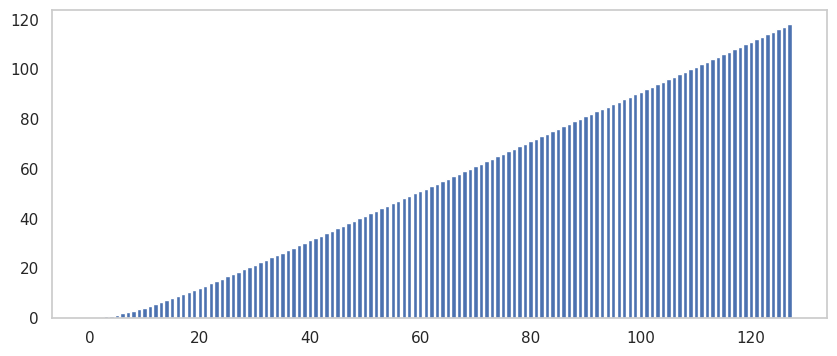
단순한 구현
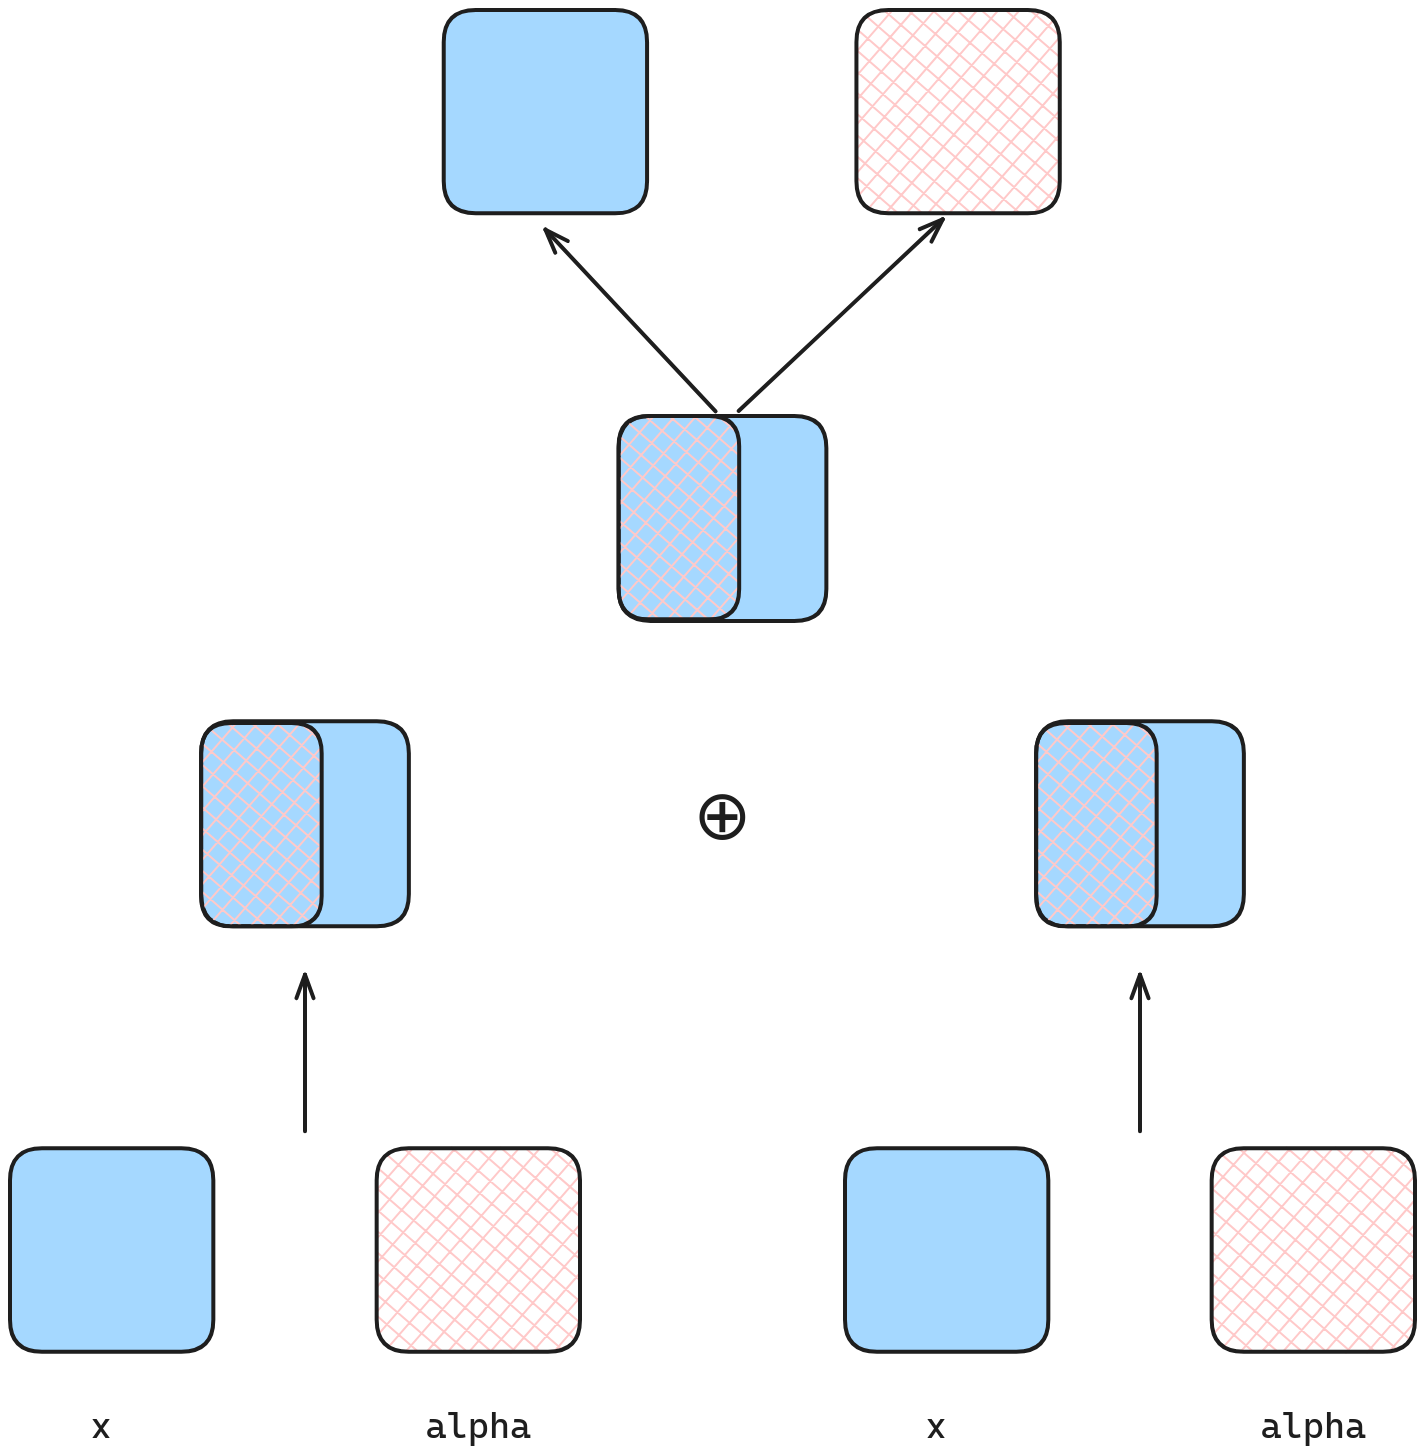
이 op를 Triton으로 구현하려면 결합 연산 함수를 작성해야 합니다.
@triton.jit
def first_order_op(fl, xl, fr, xr):
    f = fr * fl
    x = fr * xl + xr
    return f, x
이렇게 해 두면 원래 구현과 비슷하게 깔끔해집니다. 가장 큰 차이는 이제 은닉 상태가 두 부분으로 이루어진다는 점입니다.
@triton.jit
def ssm_load(Ks, A, B, C):
    "Helper for loading"
    a = tl.load(A + Ks)
    b = tl.load(B + Ks)
    c = tl.load(C + Ks)
    return a, b, c

@triton.jit
def simple_ssm_tt(X, A, B, C, Y, K: tl.constexpr):
    Ks = tl.arange(0, K)

    # Allow for a batch dimension (for Part 4)
    bid = tl.program_id(0)
    kid = bid * K
    x = tl.load(X + Ks + kid)
    a, b, c = ssm_load(Ks + kid, A, B, C)

    # Compute
    h1, h2 = tl.associative_scan((a, b*x), 0, first_order_op)
    y = c * h2

    # Save
    tl.store(Y + Ks + kid, y)
h = torch.zeros(2, BLOCKS ).float().cuda()
a, b, c = ones(SEQLEN) * alpha, ones(SEQLEN) - alpha, ones(SEQLEN)
simple_ssm_tt[(1,)](x, a, b, c, y, K=K)
h_, y_ = ema(x[:K].tolist(), alpha)
check(y[:K], y_)✔️블록 구현
여기서부터는 이 요령을 자주 쓸 테니 함수 하나로 묶어 두겠습니다. 시작값을 넣은 스캔과, 스캔 방향을 뒤집는 옵션이 들어 있습니다.
@triton.jit
def ssm_scan(h1, h2, h2_0, reversed:tl.constexpr=0, dim:tl.constexpr=0):
    # Optional flip direction (for Part 3)
    Ks = tl.arange(0, h2.shape[dim])
    # Apply initial
    n1, n2 = first_order_op(tl.zeros_like(h1)+1.0, h2_0, h1, h2)

    # Scan
    h1, h2 = tl.associative_scan((n1, n2), dim, first_order_op, reverse=reversed)
    return h1, h2
이제 누적합 때와 마찬가지로 이 함수를 블록 단위로 계산할 수 있습니다. 누적합 블록 코드와 똑같고, 스캔만 새것으로 바꿨습니다.
@triton.jit
def ema_tt(X, A, B, C, H_0, Y, H, K: tl.constexpr):
    pid = tl.program_id(0)
    nH = tl.num_programs(0)
    Ks = tl.arange(0, K)
    kid = pid * K
    a, b, c = ssm_load(Ks + kid, A, B, C)
    x = tl.load(X + Ks + kid)
    h_span = Ks*0 + pid
    h2_0 = tl.load(H_0 + nH + h_span, Ks==0, 0)

    # Compute
    h1, h2 = ssm_scan(a, b * x, h2_0, 0)

    # Save
    tl.store(Y + Ks + kid, h2)

    # Write out two part hidden state.
    tl.store(H + 0 * nH + h_span, h1, Ks == (K-1))
    tl.store(H + 1 * nH + h_span, h2, Ks == (K-1))
h = torch.zeros(2, 2, BLOCKS).float().cuda()
_ = torch.zeros(K * BLOCKS).cuda()
o = ones(BLOCKS)
ema_tt[(BLOCKS,)](x, a, b, c, h[0], y, h[0], K=K)
simple_ssm_tt[(1,)](h[0, 1], h[0, 0], o, o, h[1, 1], K=BLOCKS)
ema_tt[(BLOCKS,)](x, a, b, c, torch.roll(h[1], 1), y, h[1], K=K)
h_, y_ = ema(x.tolist(), alpha)
check(y, y_)✔️훌륭합니다! 이로써 S6 스캔의 순전파 부분에 필요한 수학과 코딩은 대부분 마쳤습니다.
3부: 도함수 구하기
저수준 코드를 다루고 있어서 자동 미분을 쓸 수 없습니다. 그래서 이 함수들의 도함수를 직접 유도해야 합니다.
이 절에서는 조금 일반화해서 가 위치마다 달라질 수 있게 하겠습니다. (앞 절에서는 이 성질을 쓰지 않았습니다.)
그리고 손실 함수는 값들의 함수인 라고 가정하겠습니다.
시험용으로, 먼저 PyTorch로 이것을 구현해 도함수를 구해 두겠습니다.
a, b, c = rand((SEQLEN,)), rand((SEQLEN,)), rand((SEQLEN,))
def ssm_torch(x, a, b, c):
    y = []
    h = 0
    for k in range(len(x)):
        h = a[k] * h + b[k] * x[k]
        y.append(c[k] * h)
    return h, torch.stack(y)

def L(x, a, b, c):
    return ssm_torch(x, a, b, c)[1].sum()

x_ = x.clone()
h, y_ = ssm_torch(x_, a, b, c)

g = torch.func.grad(L, tuple(range(4)))
dx_, da_, db_, dc_ = g(x_, a, b, c)

plt.bar(range(SEQLEN), dx_.cpu())
<BarContainer object of 128 artists>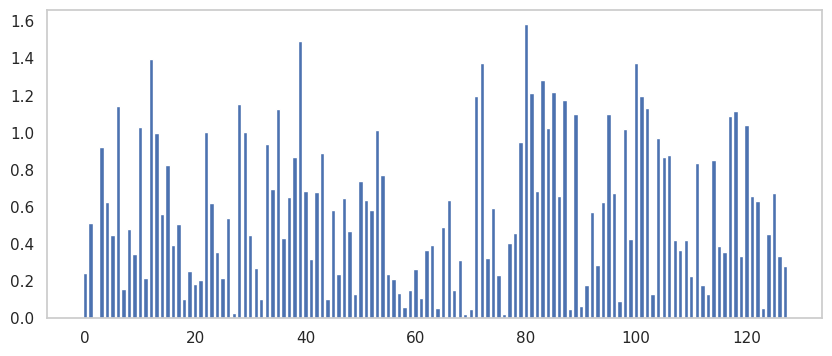
이제 수학을 조금 해 봅시다.
은 함수 이고 중간 항으로 와 를 거친다는 점에 주목하세요. 을 에 대해 미분하면 다음을 얻습니다.
조금 어수선해 보이니, 표기를 위해 각 항 를 (코드에서는 dh)로 바꿔 부르겠습니다.
이렇게 하고 나면, 도함수 계산이 같은 스캔을 거꾸로 한 것과 닮았다는 점이 보입니다.
우리 코드로 이것을 확인해 봅시다.
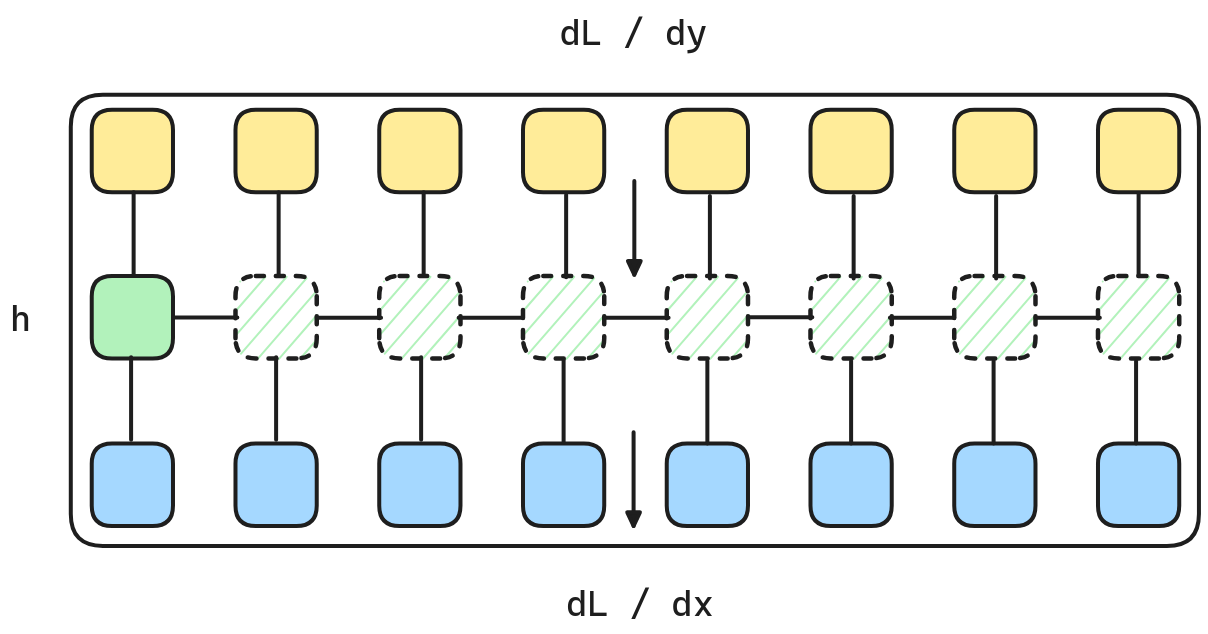
dy, dx = ones(SEQLEN), ones(SEQLEN)
da, db, dc = [torch.zeros(K*BLOCKS).float().cuda() for _ in range(3)]
_, _ign = torch.zeros(K * BLOCKS).cuda(), torch.zeros(K * BLOCKS).cuda()simple_ssm_tt[(1,)](dy.flip(0), a.flip(0).roll(1), c.flip(0), b.flip(0), dx, K=SEQLEN)
dx = dx.flip(0)
check(dx, dx_)
plt.bar(range(SEQLEN), dx.cpu())✔️
<BarContainer object of 128 artists>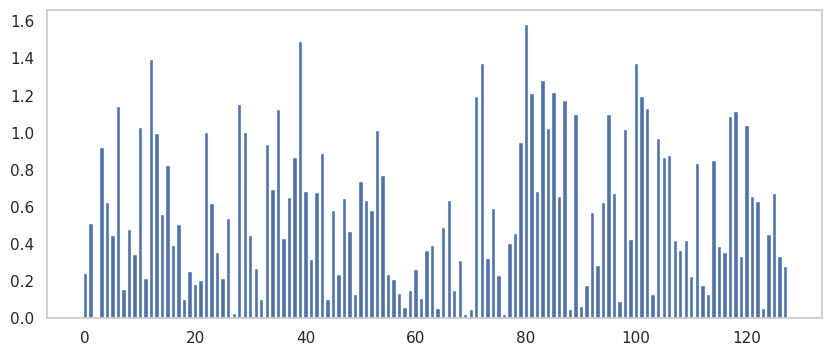
이게 전부라면 정말 좋겠지만, 계수 도 학습하는 값이므로 이들에 대한 도함수도 계산해야 합니다. 어려운 쪽은 인데, 순방향 은닉 상태와 역방향 은닉 상태가 모두 필요하기 때문입니다.
순방향 은닉 상태는 저장해 두지 않으므로, 이 계산은 Triton 안에서 해야 합니다.
plt.bar(range(SEQLEN), da_.cpu())<BarContainer object of 128 artists>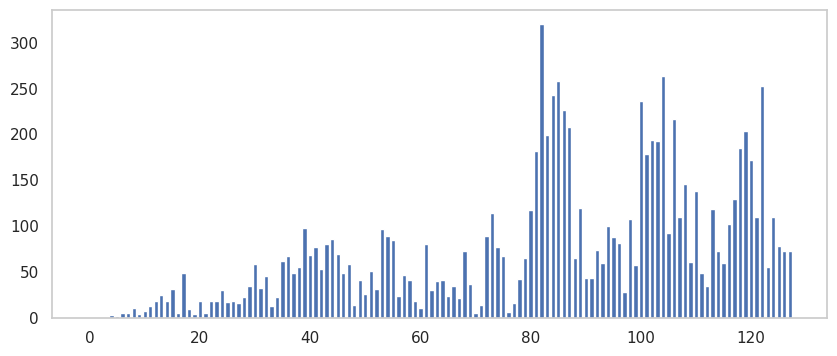
단순한 구현
Triton 구현은 앞의 구현과 거의 같습니다. 다만 스캔을 순방향과 역방향으로 모두 계산합니다.
@triton.jit
def rol(a1, b1_last, b1_cur, a2, b2_last, b2_cur):
    return a1 + a2, tl.where(a2 == 1, b1_cur, 0) + b2_last, b2_cur

@triton.jit
def roll(y, dim, rev=0):
    _, rh2, _ = tl.associative_scan((1 + 0*y, 0.0*y, y), dim, rol, reverse=rev)
    return rh2

@triton.jit
def ssm_store(Ks, dA, da, dB, db, dC, dc):
    "Helper"
    tl.store(dA + Ks, da)
    tl.store(dB + Ks, db)
    tl.store(dC + Ks, dc)

@triton.jit
def ssm1_tt(X, dX, A, dA, B, dB, C, dC, Y, dY, K: tl.constexpr):
    Ks = tl.arange(0, K)
    a, b, c = ssm_load(Ks, A, B, C)
    x = tl.load(X + Ks)
    dy = tl.load(dY + Ks)
    id2 = tl.zeros_like(a) # 0.0

    # Compute Forward (same as before)
    h1, h2 = ssm_scan(a, b * x, id2)
    y = c * h2
    tl.store(Y + Ks, y)
    a_shift = tl.load(A + Ks + 1, Ks + 1 < K, 0)

    # Compute Backward (now reversed)
    h1, dh = ssm_scan(a_shift, c * dy, id2, reversed=1)
    rh2 = roll(h2, 0)

    # Save
    tl.store(dX + Ks, b * dh)
    ssm_store(Ks, dA, dh*rh2, dB, dh*x, dC, h2 * dy)
dx, da, db, dc = [torch.zeros(SEQLEN).float().cuda() for _ in range(4)]
dy = torch.ones(SEQLEN).float().cuda()
ssm1_tt[(1,)](x, dx, a, da, b, db, c, dc, y, dy, K=SEQLEN)
check(da, da_, dc, dc_, dx, dx_, db, db_)
plt.bar(range(SEQLEN), da.cpu())✔️
<BarContainer object of 128 artists>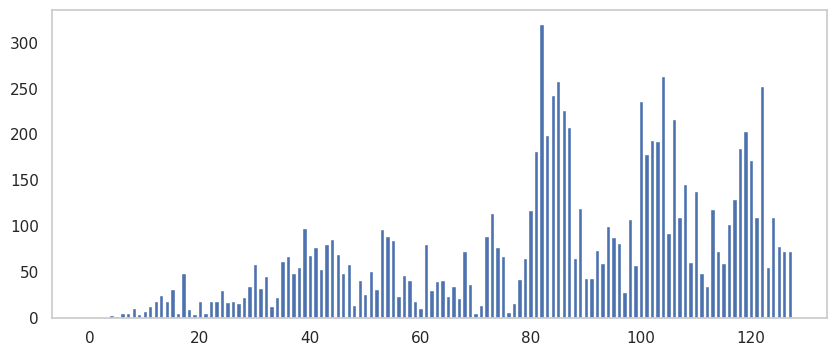
블록 구현
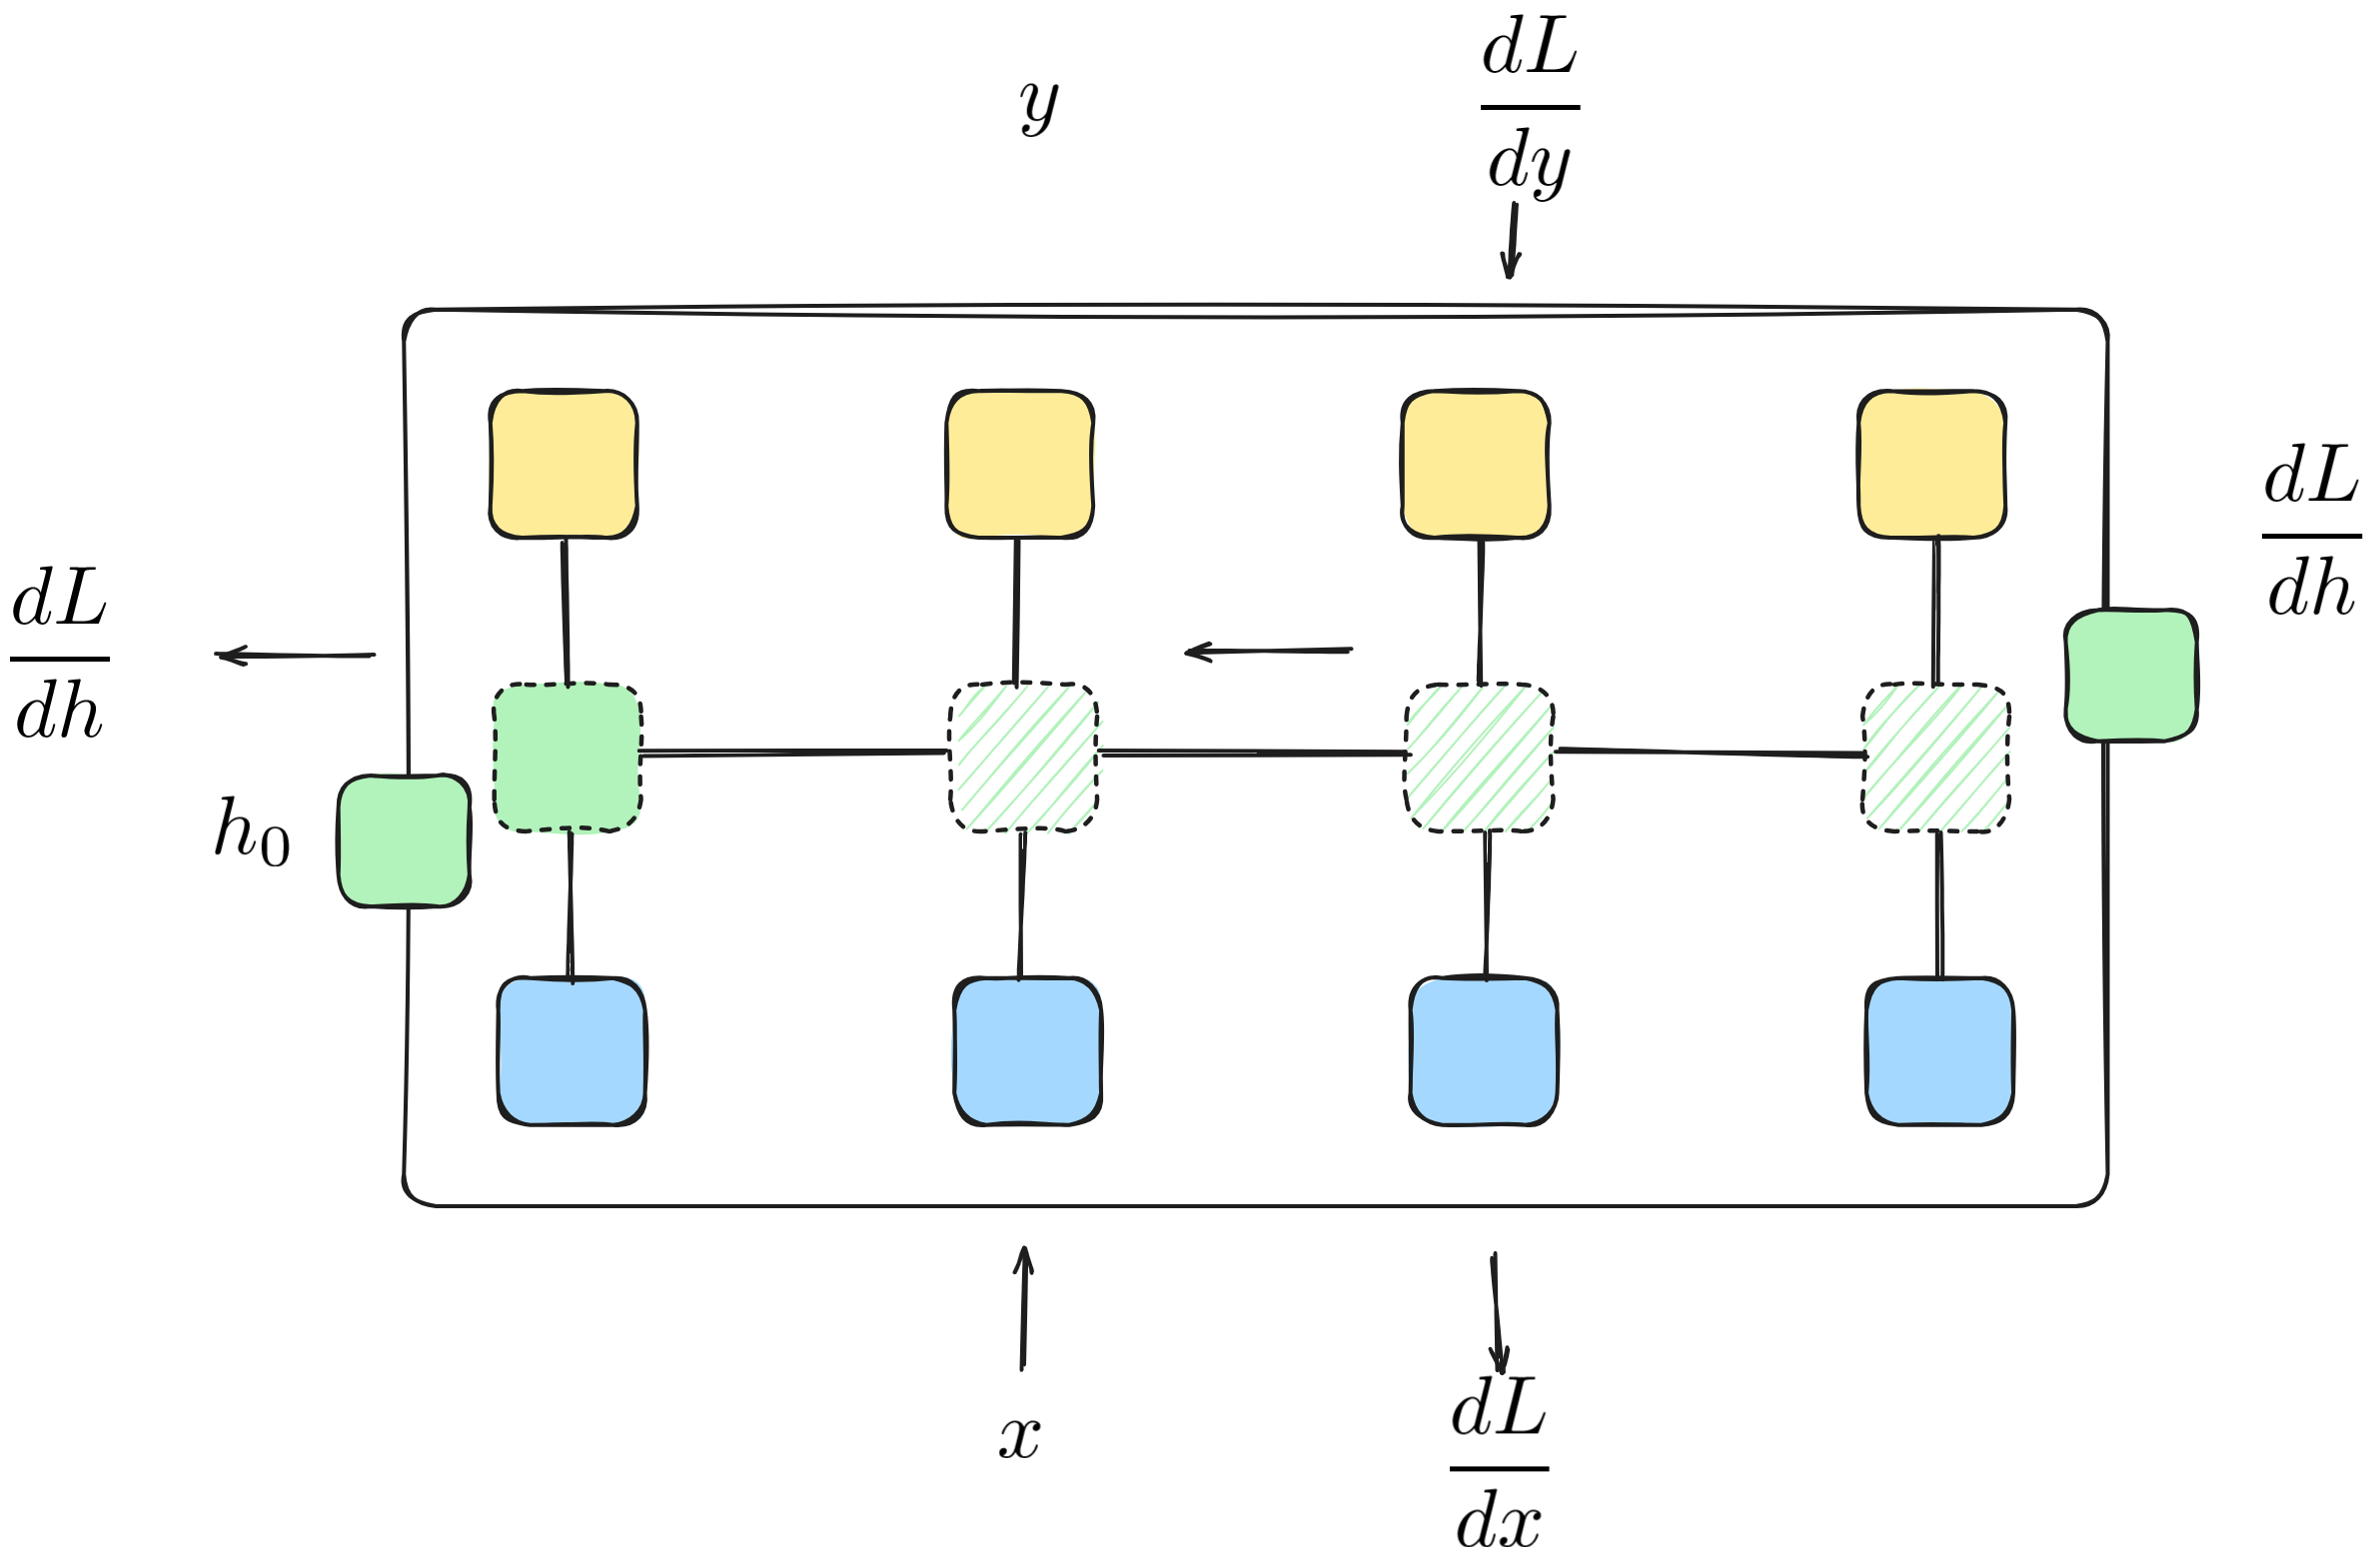
같은 생각을 블록 구현으로 넓힐 수 있습니다. 다만 왼쪽에서 오른쪽으로 움직이는 값과 오른쪽에서 왼쪽으로 움직이는 값을 동시에 추적해야 해서, 장부 정리가 악몽 수준입니다.
# Group together all the inputs and all the grads.
@triton.jit
def ssm_tt(X, dX, A, dA, B, dB, C, dC, H_0, dH_0, H, dH, Y, dY,
           back: tl.constexpr,
           K: tl.constexpr):
    pid = tl.program_id(0)
    nH = tl.num_programs(0)

    Ks = tl.arange(0, K)
    kid = pid * K

    # Load
    x = tl.load(X + Ks + kid)
    a, b, c = ssm_load(Ks + kid, A, B, C)
    h2_0 = tl.load(H_0 + nH + Ks*0 + pid, Ks==0, 0)

    # # Compute Forward (Move L-to-R)
    h1, h2 = ssm_scan(a, b * x, h2_0)
    y = c * h2

    tl.store(Y + Ks + kid, y)
    tl.store(H + 0*nH + Ks * 0 + pid, h1, Ks == K-1)
    tl.store(H + 1*nH + Ks * 0 + pid, h2, Ks == K-1)
    if not back: return

    # Compute Backward (Move R-to-L)
    dy = tl.load(dY + Ks + kid)
    a_shift = tl.load(A + Ks + kid + 1)

    dh_0 = tl.load(dH_0 + nH + pid) * (Ks==K-1)
    dh1, dh = ssm_scan(a_shift, c * dy, dh_0, reversed=1)
    rh2 = roll(h2, 0) + h2_0


    # Save
    tl.store(dX + Ks + kid, b * dh)
    ssm_store(Ks + kid, dA, dh*rh2, dB, dh*x, dC, h2 * dy)
    tl.store(dH + 0*nH + Ks * 0 + pid, dh1, Ks == 0)
    tl.store(dH + 1*nH + Ks * 0 + pid, dh,  Ks == 0)
h, dh = (zeros(2, 2, BLOCKS) for _ in range(2))
dx = zeros(SEQLEN)
def run(h, dh):
ssm_tt[(BLOCKS,)](x, dx, a, da, b, db, c, dc, h, dh, h, dh, y, dy,
back=1, K=K)
def reduce(v, rev, batch = 1):
if rev:
v[0, :] = v[0].flip(-1)
o = torch.ones_like(v[0, 0])
simple_ssm_tt[(batch,)](v[0, 1], v[0, 0], o, o, v[1, 1], K=v.shape[-1])
v[..., -1] = 0.0
v[:] = torch.roll(v, 1)
if rev:
v[1, :] = v[1].flip(-1)
run(h[0], dh[0])
reduce(h, False)
reduce(dh, True)
run(h[1], dh[1])
dx_, da_, b_, dc_ = g(x, a, b, c)
#check(dx, dx_, dc, dc_, db, db_, da, da_)좋습니다! 역전파에는 변수가 많이 필요했지만, 쓰는 방식은 순전파와 똑같았습니다. 읽기와 쓰기를 짝 맞추는 일일 뿐이었습니다.
4부: 여러 개를 한꺼번에
지금까지는 스칼라 은닉 상태 하나만 생각했습니다. 이제 서로 다른 은닉 상태 여러 개를 동시에 계산하는 경우를 생각해 보겠습니다. 은닉 상태마다 연결된 값이 다릅니다.
수식은 비슷해 보이지만, 추적해야 할 인덱스 이 하나 더 생깁니다.
N = 4
def ssm_multiscan(x, a, b, c):
    y = []
    h = zeros(N)
    for k in range(len(x)):
        h = h * a[:, k] + b[:, k] * x[k]
        y.append((c[:, k] * h).sum(0))
    return h, torch.stack(y)

alpha = (((arange(N) + 1) / 8)[:, None]).expand((N, SEQLEN)).clone()
a, b, c = alpha, (1-alpha), ones(N, SEQLEN)
h_, y_ = ssm_multiscan(x, a, b, c)
plt.bar(range(SEQLEN), y_.cpu())
<BarContainer object of 128 artists>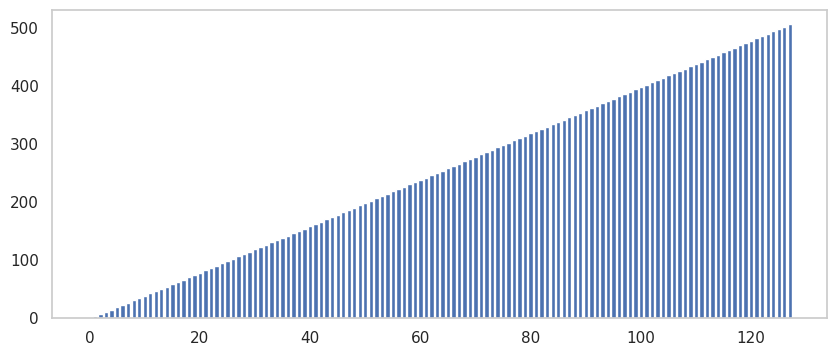
이 부분이 중요합니다. 지금까지는 은닉 상태 하나만 추적했습니다. 하지만 이제는 위치마다 값이 개씩 있습니다. 이렇게 생각하면 됩니다.
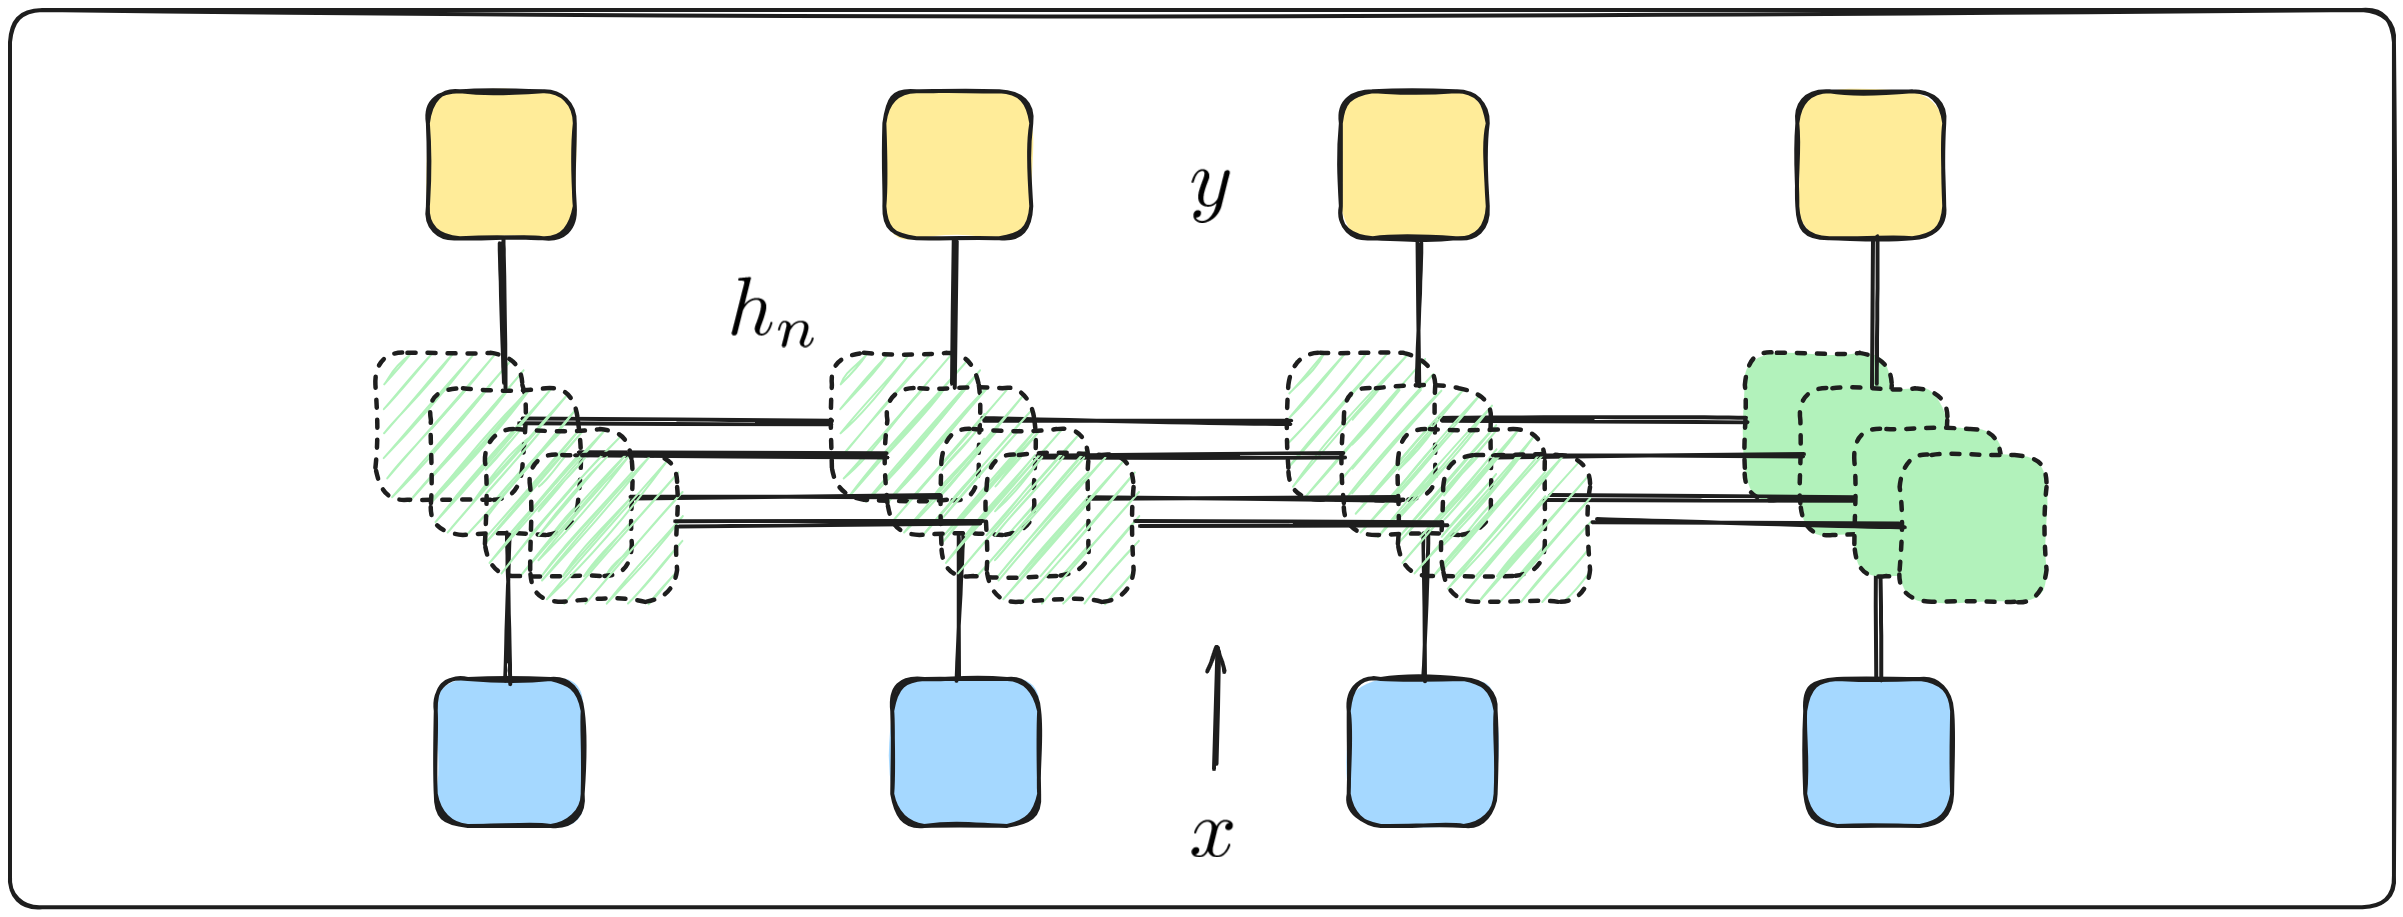
문제는 안쪽의 상태들이 정말 커진다는 것입니다! 그래서 이것들을 모두 읽고 쓸 수는 없습니다. 애초에 Triton을 쓰는 이유가 바로 이것입니다. GPU 안에서 처리할 수는 있지만, 전부 써 내보내지는 않습니다.
블록 구현
이번에는 역전파는 빼고 바로 순전파 블록 구현으로 넘어가겠습니다. 그래야 새로운 부분, 특히 여러 상태를 다루는 부분에 집중할 수 있습니다.
가장 큰 차이는 최종 은닉 상태를 나타내는 차원 를 써 내보낸다는 점입니다.
@triton.jit
def select(X, mask, dim=-1):
    return tl.sum(X * mask, dim, 1)

@triton.jit
def multiema_tt(X, A, B, C, H_0, Y, H, K: tl.constexpr,
                L: tl.constexpr, N: tl.constexpr):
    # L is the total length of the sequence.
    pid = tl.program_id(0)
    nH = tl.num_programs(0) # Number of blocks.
    Ks = tl.arange(0, K)[None, :]
    Ns = tl.arange(0, N)[:, None] # N x 1 - For each hidden.
    kid = pid * K
    h_span = Ns*nH + pid

    a, b, c = ssm_load(Ns * L + Ks + kid, A, B, C) # N x K
    x = tl.load(X + Ks + kid) # K
    h2_0 = tl.load(H_0 + nH*N + h_span) * (Ks==0)

    # Compute forward for all hidden.
    h1, h2 = ssm_scan(a, b * x, h2_0, dim=1)
    y = tl.sum(c * h2, 0)

    # Save
    tl.store(Y + Ks + kid, y[None, :])
    tl.store(H + 0 * nH*N + h_span, select(h1, Ks == (K-1)))
    tl.store(H + 1 * nH*N + h_span, select(h2, Ks == (K-1)))
이제 세 단계 스캔을 돌릴 수 있습니다. 지금까지 한 것과 거의 똑같아 보이지만, 가운데 2단계가 차원이 하나 더 붙은 상태에 작용한다는 점이 다릅니다. 그래도 앞에서 배치를 지원하도록 구현해 두었으니 문제없을 겁니다.
N = 4
h = zeros(2, 2, N, BLOCKS)
o = ones(N, BLOCKS)
multiema_tt[(BLOCKS,)](x, a, b, c, h[0], y, h[0], K=K, L=x.shape[0], N=N)
simple_ssm_tt[(N,)](h[0, 1], h[0, 0], o, o, h[1, 1], K=BLOCKS)
h[..., -1] = 0
multiema_tt[(BLOCKS,)](x, a, b, c, torch.roll(h[1], 1, -1), y, h[1], K=K, L=x.shape[0], N=N)
check(y, y_)✔️이제 Mamba에 맞설 도구를 모두 갖췄습니다.
5부: Mamba / S6
Mamba는 4부에서 본 것과 똑같은 SSM 비슷한 모델입니다. 다시 떠올려 보면 이렇게 생겼습니다.
그런데 가장 큰 차이는, 앞에서 본 지수 이동 평균 파라미터화와 달리 Mamba는 이 식을 “연속 시간”으로 다룬다는 점입니다. 세부 내용까지 너무 깊이 들어가지는 않겠습니다.
요점은 (코드에서는 a_와 b_)를 직접 건드리지 않고, 연속 시간의 와 시간 간격 를 쓴 다음 이것을 우리의 표준 꼴로 바꾼다는 것입니다. 이 방식의 이점은 논문을 참고하세요. 핵심이 되는 변환은 다음과 같습니다.
def discretize(a, b, delta):
    da = delta * a
    a_ = torch.exp(da)
    b_ = b * delta
    return a_, b_
ax = plt.figure().add_subplot(projection='3d')
a = torch.linspace(-1, 1, 100)[None].expand(100, 100)
delta = torch.linspace(-1, 1, 100)[:, None].expand(100, 100)
ax.plot_surface(a.cpu(), delta.cpu(), discretize(a, 1, delta)[0].cpu())
ax.set_xlabel('$A$')
ax.set_ylabel('$\Delta$')
Text(0.5, 0.5, '$\\Delta$')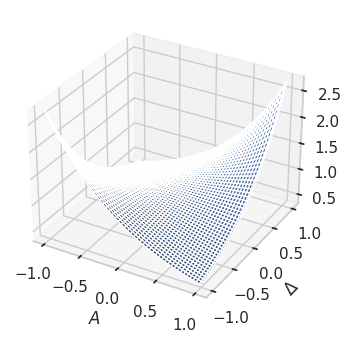
수식은 앞과 같아 보입니다. 유일한 차이는 점화식을 돌리기 전에 먼저 이산화한다는 점입니다.
x = arange(SEQLEN)
a, b, c, delta = [ones(SEQLEN) for _ in range(4)]
delta[:] = 0.01
def simple_mamba_torch(x, a, b, c, delta):
    y = []
    h = 0
    a_, b_ = discretize(a, b, delta)
    for k in range(len(x)):
        h = a_[k] * h + b_[k] * x[k]
        y.append(c[k] * h)
    return h, torch.stack(y)

def L(x, a, b, c, delta):
    return simple_mamba_torch(x, a, b, c, delta)[1].sum()

h, y_ = simple_mamba_torch(x, a, b, c, delta)
g = torch.func.grad(L, tuple(range(5)))
dx_, da_, db_, dc_, ddelta_ = g(x_, a, b, c, delta)
앞의 표준 지수 이동 평균을 다시 구현하고 싶다면 그렇게 할 수 있습니다. 변환은 다음과 같습니다.
delt = 0.5
alpha = 0.9
discretize(torch.tensor(alpha).log() / delt, -torch.tensor(alpha).log(), torch.tensor(delt))
(tensor(0.9000), tensor(0.0527))이 코드도 Triton으로 옮겨야 합니다. 순전파는 간단합니다. 하지만 역전파 코드도 작성해야 합니다. (솔직히 이 부분은 그냥 Wolfram Alpha에 물어봤습니다.)
@triton.jit
def discretize_tt(a, b, delta):
    da = delta * a
    a_ = tl.exp(da)
    b_ = b * delta
    return a_, b_

@triton.jit
def discretize_back(a, b, d, da_, db_):
    da = d * a
    a_ = tl.exp(da)

    da_da = d * a_
    da_ddelta = a * a_

    inter = (b * (da - 1) * a_ + b) / da

    #db_da = 0
    db_db = d
    db_ddelta = b

    return da_ * da_da, db_ * db_db, da_ * da_ddelta + db_ * db_ddelta
단순한 구현
이제 드디어 Mamba 스캔을 구현할 수 있습니다. 먼저 1차원에서 해 보겠습니다. 이쯤 되면 코드가 아주 낯익어 보일 겁니다.
@triton.jit
def mamba1_tt(X, dX, A, dA, B, dB, C, dC, Delta, dDelta, Y, dY, K: tl.constexpr):
    Ks = tl.arange(0, K)
    a, b, c = ssm_load(Ks, A, B, C)
    x = tl.load(X + Ks)
    dy = tl.load(dY + Ks)
    delta = tl.load(Delta + Ks)
    id2 = Ks * 0.0

    # Compute Forward
    a_, b_ = discretize_tt(a, b, delta)
    h1, h2 = ssm_scan(a_, b_ * x, id2)
    y = c * h2
    tl.store(Y + Ks, y)

    # Compute Backward
    h1, dh = ssm_scan(roll(a_, 0, 1), c * dy, id2, reversed=1)
    rh2 = roll(h2, 0)
    da_ = dh*rh2
    db_ = dh*x
    da, db, ddelta = discretize_back(a, b, delta, da_, db_)

    # Save
    tl.store(dDelta + Ks, ddelta)
    tl.store(dX + Ks, b_ * dh)
    ssm_store(Ks, dA, da, dB, db, dC, h2 * dy)

dx, da, db, dc, ddelta = [zeros(SEQLEN) for _ in range(5)]
y, dy = [ones(SEQLEN) for _ in range(2)]
mamba1_tt[(1,)](x, dx, a, da, b, db, c, dc, delta, ddelta, y, dy, K=SEQLEN)
dx_, da_, db_, dc_, ddelta_ = g(x_, a, b, c, delta)
check(y, y_, dx, dx_, da[-2*K:], da_[-2*K:], db[-2*K:], db_[-2*K:], ddelta[-2*K:], ddelta_[-2*K:])✔️검산 삼아 이것으로 이동 평균을 계산해 봅시다.
a = (torch.zeros_like(a) + 0.9).log()
b = -(torch.zeros_like(b) + 0.9).log()
delta = torch.ones_like(delta)
mamba1_tt[(1,)](x, dx, a, da, b, db, c, dc, delta, ddelta, y, dy, K=SEQLEN)
plt.bar(range(SEQLEN), y.cpu())
<BarContainer object of 128 artists>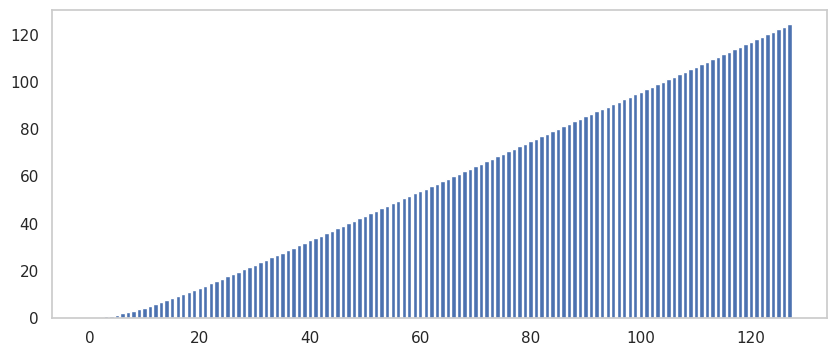
블록 구현
이제 모두 하나로 엮어 봅시다!
마지막으로 구현해야 할 알고리즘은 이것을 아주 크게 배치로 묶은 버전입니다.
이 그림이 텐서 모양을 설명해 줍니다.
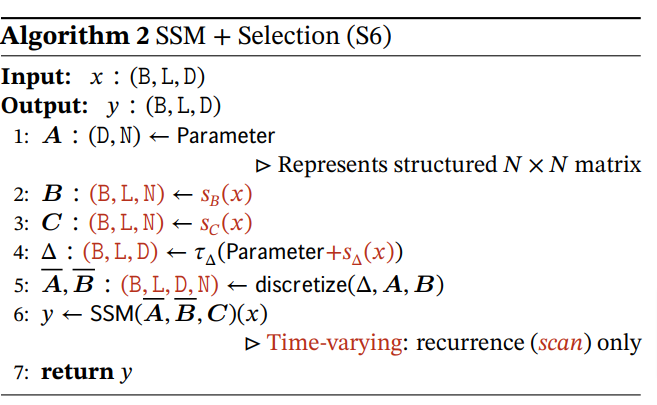
그림 출처: Albert Gu, Tri Dao, 「Mamba: Linear-Time Sequence Modeling with Selective State Spaces」, CC BY 4.0. 원문 글쓴이가 가져다 쓴 그림입니다.
먼저 이것을 단순한 PyTorch 코드로 옮겨 보겠습니다. 일의 대부분은 텐서 모양을 맞추는 데 있습니다.
def mamba_torch(x, a, b, c, delta):
    "PyTorch Implementation"
    y = []
    h = 0
    a_, b_ = discretize(a, b, delta)
    for k in range(x.shape[-1]):
        h = a_[..., k] * h + b_[..., k] * x[..., k]
        y.append((c[..., k] * h).sum(1, keepdim=True))
    return h, torch.stack(y, -1)
Triton 코드도 상당 부분이 바로 이 모양대로 값을 불러오는 일입니다. 값을 다 불러오고 나면 핵심 루프는 3부와 4부의 것과 똑같아 보인다는 점을 눈여겨보세요.
@triton.jit
def mamba_tt(X, dX, A, dA, B, dB, C, dC, Delta, dDelta,
             H_0, dH_0, Y, dY, H, dH,
             back:tl.constexpr,
             step:tl.constexpr,
             L: tl.constexpr, K: tl.constexpr, D_step: tl.constexpr,
             D:tl.constexpr, N: tl.constexpr):
    # Setup
    pid = tl.program_id(0)
    bid = tl.program_id(1)
    kid = pid * K
    nH = tl.num_programs(0)
    Ba = tl.num_programs(1)
    Ks = tl.arange(0, K)[None, None, :] # 1 x 1 x K
    Ns = tl.arange(0, N)[:, None, None] # N x 1 x 1
    Nx1xK = bid*N*L + Ns*L + (Ks + kid)


    # Load forward
    b = tl.load(B + Nx1xK)
    c = tl.load(C + Nx1xK)
    db_out = tl.zeros_like(b)
    dc_out = tl.zeros_like(c)

    Ds = tl.arange(0, D_step)[None, :, None] # 1 x D x 1

    for did in range(0, D // D_step):
        DxK = bid*D*L + Ds*L + Ks + kid
        NxDx1 = bid*N*D + Ns*D + Ds
        a = tl.load(A + NxDx1)
        NxDx1_H = bid*N*D*nH + Ns*D*nH + Ds*nH + pid
        h_off = Ba*N*D*nH

        # Load forward
        delta = tl.load(Delta + DxK)
        x = tl.load(X + DxK)
        a_, b_ = discretize_tt(a, b, delta)

        if step == 2:
            h2_0 = tl.load(H_0 + 1*h_off + NxDx1_H) * (Ks == 0)
        else:
            h2_0 = tl.zeros_like(a_)
        # Compute Forward
        h1, h2 = ssm_scan(a_, b_ * x, h2_0, dim=2)
        y = tl.sum(c * h2, 0, 1)
        if step == 1:
            tl.store(H + 0 * h_off + NxDx1_H + 0*Ks, h1, Ks==K-1)
            tl.store(H + 1 * h_off + NxDx1_H + 0*Ks, h2, Ks==K-1)
        if step == 2:
            tl.store(Y + DxK, y)

        # #Compute backward
        if back == 1:
            # Load Backward
            dy = tl.load(dY + DxK)
            dh2_0 = tl.load(dH_0 + 1*h_off + NxDx1_H) * (Ks==K-1)
            delta_shift = tl.load(Delta + DxK + 1, (Ks + kid) < L - 1, 0)
            a_s, _ = discretize_tt(a, b, delta_shift)
            dh1, dh = ssm_scan(a_s, c * dy, dh2_0, reversed=1, dim=2)
            if step == 1:
                tl.store(dH + 0*h_off + NxDx1_H + 0*Ks, dh1, Ks == 0)
                tl.store(dH + 1*h_off + NxDx1_H + 0*Ks, dh, Ks == 0)

        if back == 1 and step == 2:
            dc = tl.sum(h2 * dy, 1, 1) # N x K
            rh2 = roll(h2, 2)
            rh2 = h2_0 * (Ks == 0) + rh2 * (Ks > 0)
            da, db, ddelta = discretize_back(a, b, delta, dh * rh2, dh * x)

            # Save (sums keep_dims=1)
            tl.store(dX + DxK, tl.sum(b_ * dh, 0, 1))
            tl.store(dA + NxDx1_H, tl.sum(da, 2, 1))
            tl.store(dDelta + DxK, tl.sum(ddelta, 0, 1))
            db_out = db_out + tl.sum(db, 1, 1)
            dc_out = dc_out + dc
        Ds = Ds + D_step

    if back==1 and step==2:
        tl.store(dB + Nx1xK, db_out)
        tl.store(dC + Nx1xK, dc_out)
이제 같은 코드 설정으로 이것을 시험해 볼 수 있습니다.
def create(S = 128, Ba = 2, D = 4, N = 4):
    x = rand((Ba, 1, D, S))
    a = -ones((Ba, N, D, 1))
    b = ones((Ba, N, 1, S)) * 0.1
    c = rand((Ba, N, 1, S)) * 0.1
    delta = rand((Ba, 1, D, S)) * 0.1
    return x, a, b, c, delta

def mamba(x, a, b, c, delta, K=16, D_step=2):
    Ba = x.shape[0]
    N = a.shape[1]
    D = delta.shape[2]
    SEQLEN = x.shape[-1]
    BLOCKS = SEQLEN // K
    dx, da, db, dc, ddelta = [torch.zeros_like(b) for b in [x,a,b,c,delta]]
    da = zeros(Ba, N, D, BLOCKS)
    y, dy = [ones(Ba, 1, D, SEQLEN) for _ in range(2)]
    h, dh = [zeros(2, 2, Ba, N, D, BLOCKS) for _ in range(2)]
    assert BLOCKS == SEQLEN // K
    assert D % D_step == 0
    mamba_tt[(BLOCKS, Ba)](x, dx, a, da, b, db, c, dc, delta, ddelta, h[0], dh[0], y, dy, h[0], dh[0], back=1, step=1, L=SEQLEN, K=K, D_step=D_step, D=D, N=N)
    reduce(h, False, Ba * N * D)
    reduce(dh, True, Ba * N * D)
    mamba_tt[(BLOCKS, Ba)](x, dx, a, da, b, db, c, dc, delta, ddelta, h[1], dh[1], y, dy, h[1], dh[1], back=1, step=2, L=SEQLEN, K=K, D_step=D_step, D=D, N=N)
    return y, dx, da.sum(-1, keepdim=True), db, dc, ddelta

x, a, b, c, delta = create()
y, dx, da, db, dc, ddelta = mamba(x, a, b, c, delta)
for v in [x, a, b, c, delta]:
    v.requires_grad_()
_, y_ = mamba_torch(x, a, b, c, delta)
y_.sum().backward()
check(y, y_, da, a.grad, dx, x.grad, dc, c.grad, db, b.grad, prec=1e-3)✔️이제 Mamba 저장소의 구현과 결과가 같은지 확인해 봅시다.
import selective_scan_cuda
y_from_repo = selective_scan_cuda.fwd(x.squeeze(1), delta.squeeze(1), a[0].squeeze(-1).T, b.squeeze(-2)[:, None, :, :], c.squeeze(-2)[:, None, :, :], None, None, None, False)

check(y.squeeze(1), y_from_repo[0])✔️좋습니다, 이제 돌아가는 커널이 생겼습니다. 실제로 꽤 빠르지만, 아쉽게도 Mamba 구현보다는 아직 조금 느립니다.
y_ = mamba(*create(S = 2048, Ba = 8, D = 1024, N=4), K = 128, D_step=16)야호! 완전히 구현했고 잘 돌아갑니다.
자, 여기서 마치겠습니다. Mamba / S6 알고리즘 전체 버전을 돌린다는 첫 목표를 이뤘습니다. 다음 버전에서는 프로파일링과 핵심 알고리즘 속도 높이기를 더 자세히 다뤄 보고 싶습니다. 그러면 더 빠르게 돌릴 수 있기를 바랍니다.
그럼 이만, 사샤
라이선스 고지
원문은 MIT 라이선스로 공개되어 있습니다. 아래는 원문 저장소(srush/annotated-mamba)의 저작권 표시와 허가 문구 전문입니다.
Copyright (c) 2023 Sasha Rush
Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the "Software"), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions:
The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software.
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.