사샤 러시, 시드 카람체티: 주석으로 읽는 S4Sasha Rush, Sidd Karamcheti: The Annotated S4
상태 공간 모델의 기초와 이산화, 순환과 합성곱 두 가지 표현, HiPPO 초기화, 생성 함수와 코시 커널, 우드버리 항등식으로 S4 커널을 빠르게 계산하는 방법까지 논문 문장과 JAX 코드를 나란히 놓고 따라가는 사샤 러시와 시드 카람체티의 글Efficiently Modeling Long Sequences with Structured State Spaces
Contents목차
번역문 · 원저자: Sasha Rush, Sidd Karamcheti (논문 저자 Albert Gu, Karan Goel, Christopher Ré) · 원문: The Annotated S4 · 원문 라이선스: MIT (Copyright (c) 2023 Sasha Rush). 원문의 저작권 표시와 MIT 허가 문구는 글 끝 「라이선스 고지」에 그대로 옮겼습니다. 원문 글쓴이가 그리거나 코드로 만든 그림은 글과 같은 MIT 라이선스를 따르므로 그대로 실었습니다. S4 논문과 HiPPO 논문에서 가져온 그림 3개는 두 논문에 다른 곳에 다시 실어도 된다는 라이선스가 붙어 있지 않아 싣지 않고 설명만 남겼으니, 이 그림은 원문에서 보세요.
원문: 「The Annotated S4」, Sasha Rush, Sidd Karamcheti, https://srush.github.io/annotated-s4/. 저장소에는 2022년 1월 10일에 처음 올라왔고, 이 번역은 v3을 옮겼습니다. 이 글은 원문을 한국어로 옮긴 번역문입니다.
라이선스: 저장소 srush/annotated-s4는 MIT 라이선스를 따릅니다. 코드와 코드 안 주석은 원문 그대로 두었습니다. 원문의 머리 그림과 말소리 실험 절에는 생성한 소리를 들어 볼 수 있는 오디오 재생기(wav 파일, 모두 22개)가 붙어 있는데, 이 번역에는 싣지 않았습니다. 들어 보려면 원문 페이지를 열어 주세요. 원문 목차의 각 항목과 2부 첫머리의 「Skip Button」은 본문 절로 이어지는 링크인데, 여기서는 목차를 목록으로만 옮기고 건너뛰기 링크는 문장으로 바꿨습니다. 논문을 인용한 부분은 원문처럼 인용 블록으로 두었습니다.
구조화된 상태 공간으로 긴 시퀀스를 효율적으로 모델링하기(Efficiently Modeling Long Sequences with Structured State Spaces)
앨버트 구, 커런 고얼, 크리스토퍼 레.
[그림: S4 논문의 개요 그림. 왼쪽부터 연속 상태 공간 식과 블록도(Continuous State Space), HiPPO 행렬 A로 먼 과거를 기억하는 곡선(Long-Range Dependencies), 이산화한 순환식과 합성곱 커널 K̄로 표현한 식(Discrete Representations)의 세 칸]
블로그 글과 라이브러리: 사샤 러시, 시드 카람체티, v3
시퀀스 모델링을 위한 구조화된 상태 공간(Structured State Space for Sequence Modeling), 줄여서 S4는 시각, 언어, 오디오 분야에서 아주 긴 범위의 시퀀스를 다루는 새로운 구조입니다. 수만 단계에 걸친 의존 관계를 잡아낼 수 있다는 것을 보여 주었습니다. 특히 어렵기로 이름난 롱 레인지 아레나 벤치마크 결과가 인상적인데, 길이가 16,000개 이상인 시퀀스에서도 높은 정확도로 추론해 냅니다.
[그림: 롱 레인지 아레나 벤치마크 결과 표. Transformer, Reformer, BigBird, Linear Trans., Performer, FNet, Nyströmformer, Luna-256, S4의 ListOps, Text, Retrieval, Image, Pathfinder, Path-X 점수와 평균. 다른 모델은 Path-X를 모두 풀지 못했고(✗), S4는 Path-X 88.10, 평균 80.48로 모든 열에서 가장 높다]
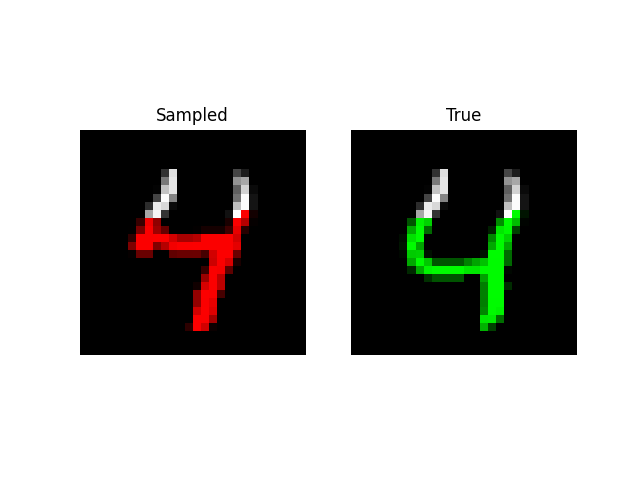
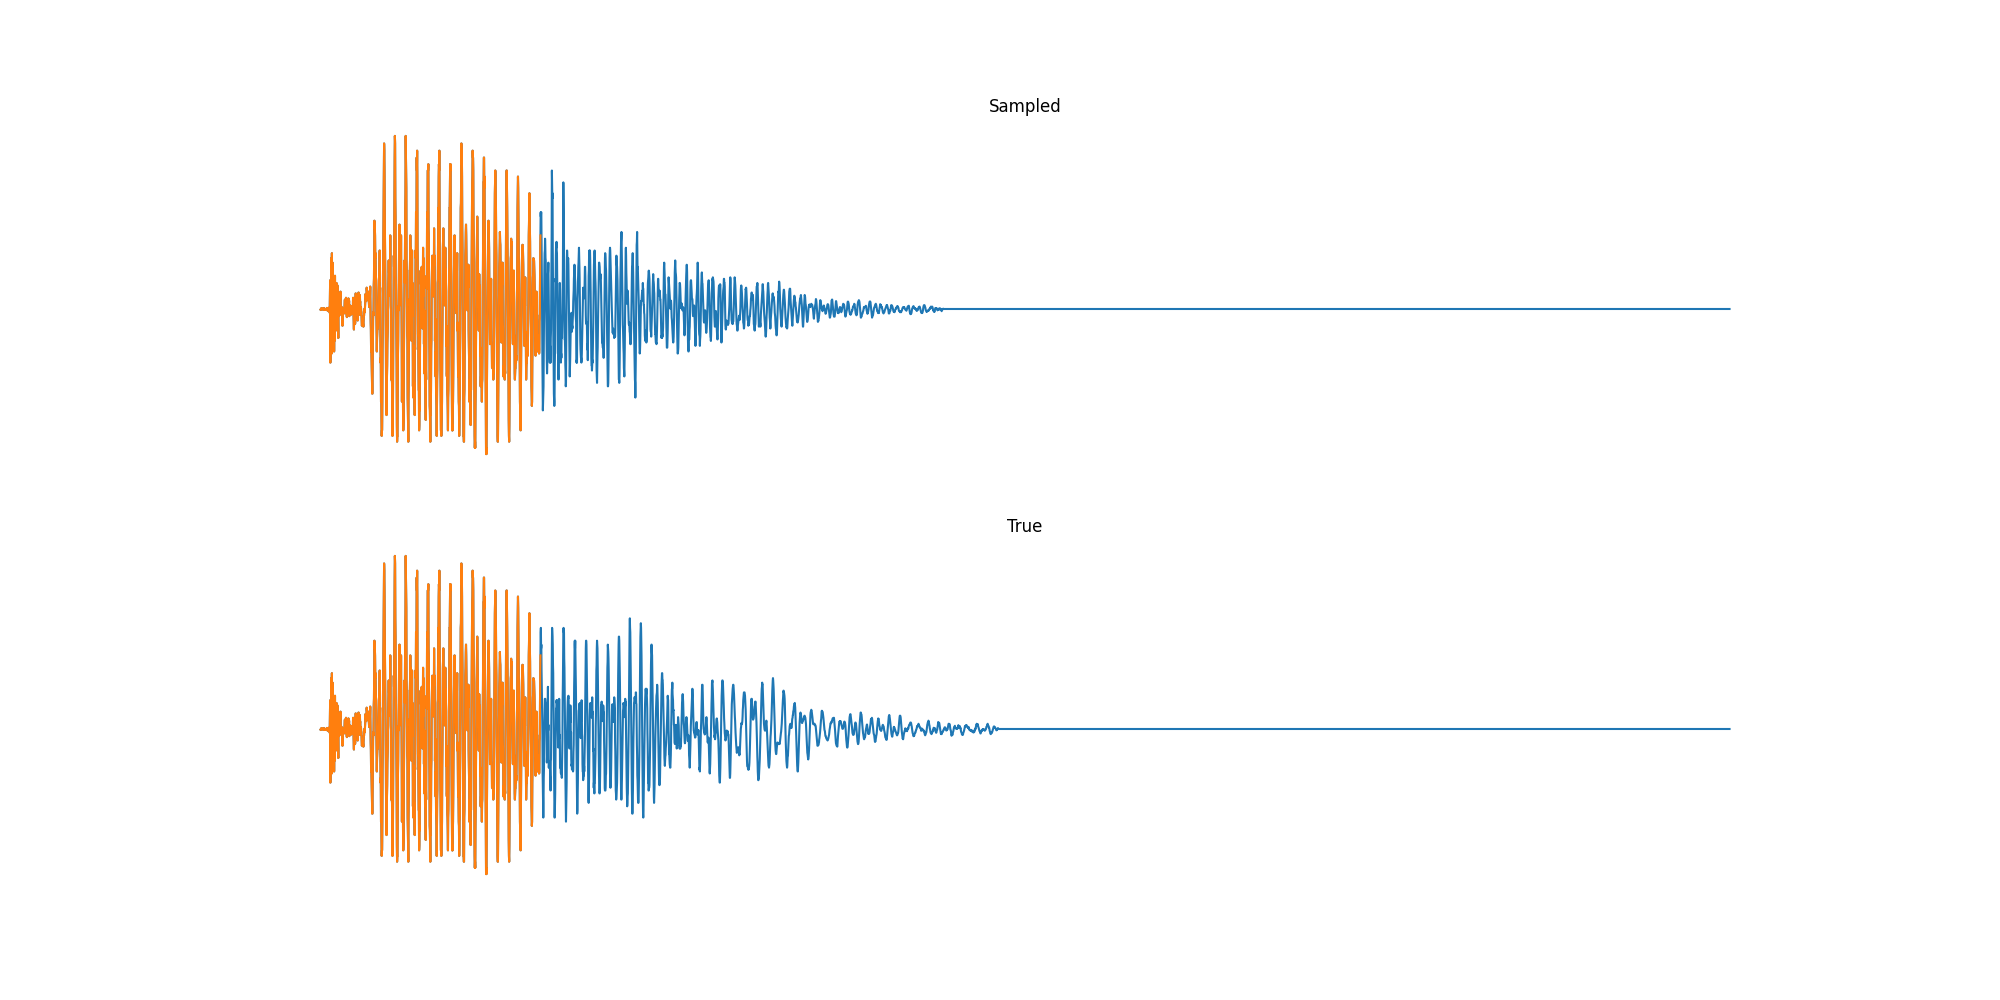
이 논문은 트랜스포머에서 벗어나 중요한 문제 영역을 전혀 다른 방식으로 접근한다는 점에서도 신선합니다. 그런데 주변 동료 여럿이 이 모델을 직관적으로 이해하기가 어렵다고 사석에서 털어놓기도 했습니다. 이 블로그 글은 그런 직관을 얻기 위한 첫걸음으로, S4 논문의 설명과 구체적인 코드 구현을 하나로 이어 놓았습니다. 주석 달린 트랜스포머와 아주 비슷한 방식입니다. 코드와 글로 풀어 쓴 설명을 함께 보면 모델의 세부를 따라가기가 한결 쉬워지기를 바랍니다. 글을 끝까지 읽으면 학습할 때는 CNN처럼 동작하고 테스트할 때는 효율적인 RNN으로 바뀌는, 실제로 돌아가는 효율적인 S4 구현을 손에 쥐게 됩니다. 결과를 미리 보여 드리면, 평범한 GPU 한 장으로 픽셀에서 이미지를 생성하고 오디오 파형에서 바로 소리를 생성할 수 있습니다.
목차
- 1부: 상태 공간 모델 (모델링)
- 이산 시간 SSM: 순환 표현
- 곁가지: 역학 예제
- SSM 학습하기: 합성곱 표현
- SSM 신경망
- 1b부: HiPPO로 먼 거리 의존성 다루기
- 2부: S4 구현하기 (심화)
- 1단계. SSM 생성 함수
- 2단계: 대각 행렬인 경우
- 3단계: 대각 더하기 저랭크
- 대각 더하기 저랭크 RNN
- HiPPO를 DPLR로 바꾸기
- 마지막 점검
- 3부: 실전 S4 (신경망 구현)
- S4 CNN / RNN 층
- 샘플링과 캐시
- 실험: MNIST
- 실험: QuickDraw
- 실험: 숫자 말소리
- 맺음말
이 프로젝트는 JAX와 신경망 라이브러리 Flax를 씁니다. 저희는 평소에 주로 Torch를 쓰지만, S4의 까다로운 부분 몇 가지에는 JAX의 함수형 성격이 잘 맞습니다. vmap과 scan, 그리고 이 둘의 신경망 버전을 많이 쓰고, 무엇보다 jax.jit으로 빠르고 효율적인 S4 층을 컴파일합니다.
from functools import partial
import jax
import jax.numpy as np
from flax import linen as nn
from jax.nn.initializers import lecun_normal, normal
from jax.numpy.linalg import eigh, inv, matrix_power
from jax.scipy.signal import convolve
if __name__ == "__main__":
# For this tutorial, construct a global JAX rng key
# But we don't want it when importing as a library
rng = jax.random.PRNGKey(1)1부: 상태 공간 모델
시작해 봅시다! 목표는 긴 시퀀스를 효율적으로 모델링하는 것입니다. 이를 위해 상태 공간 모델을 바탕으로 새로운 신경망 층을 만들 것입니다. 이 절을 마치면 이 층으로 모델을 만들어 돌려 볼 수 있습니다. 다만 그러려면 기술적인 배경지식이 좀 필요합니다. 논문의 배경부터 차근차근 짚어 보겠습니다.
상태 공간 모델은 다음의 간단한 식으로 정의됩니다. 1차원 입력 신호 를 차원 잠재 상태 로 옮긴 뒤, 이를 다시 1차원 출력 신호 로 사영합니다.
우리의 목표는 SSM을 깊은 시퀀스 모델 안의 블랙박스 표현으로 쓰는 것이며, 이때 는 경사 하강법으로 학습하는 파라미터입니다. 이후로는 설명을 간단히 하려고 파라미터 를 생략합니다. ( 항은 스킵 연결로 볼 수 있고 계산하기도 쉬우므로 이라고 가정해도 마찬가지입니다.)
SSM은 입력 를 상태 표현 벡터 와 출력 로 옮깁니다. 간단히 하려고 입력과 출력은 1차원, 상태 표현은 차원이라고 가정합니다. 첫 번째 식은 가 시간에 따라 어떻게 바뀌는지를 정의합니다.
우리의 SSM은 학습할 세 행렬 로 정의됩니다. 우선은 크기를 정하기 위해 무작위 SSM부터 만들어 봅니다.
def random_SSM(rng, N):
    a_r, b_r, c_r = jax.random.split(rng, 3)
    A = jax.random.uniform(a_r, (N, N))
    B = jax.random.uniform(b_r, (N, 1))
    C = jax.random.uniform(c_r, (1, N))
    return A, B, C
이산 시간 SSM: 순환 표현
연속 함수 가 아니라 이산 입력 시퀀스 에 적용하려면, 입력의 해상도를 나타내는 간격 로 SSM을 이산화해야 합니다. 개념적으로 입력 는 그 밑에 숨어 있는 연속 신호 를 샘플링한 값, 곧 로 볼 수 있습니다.
연속 시간 SSM을 이산화할 때는 쌍선형 방법을 씁니다. 이 방법은 상태 행렬 를 근사 행렬 로 바꿉니다. 이산 SSM은 다음과 같습니다.
def discretize(A, B, C, step):
    I = np.eye(A.shape[0])
    BL = inv(I - (step / 2.0) * A)
    Ab = BL @ (I + (step / 2.0) * A)
    Bb = (BL * step) @ B
    return Ab, Bb, C
이제 이 식은 함수에서 함수로 가는 사상이 아니라 시퀀스에서 시퀀스로 가는 사상 입니다. 게다가 상태 방정식이 이제 에 대한 점화식이 되었으므로, 이산 SSM을 RNN처럼 계산할 수 있습니다. 구체적으로 은 전이 행렬이 인 은닉 상태로 볼 수 있습니다.
논문 말대로 이 “한 단계” 함수는 겉보기에는 RNN의 한 단계 함수와 정말 닮았습니다. JAX에서는 scan으로 구현할 수 있습니다.
def scan_SSM(Ab, Bb, Cb, u, x0):
    def step(x_k_1, u_k):
        x_k = Ab @ x_k_1 + Bb @ u_k
        y_k = Cb @ x_k
        return x_k, y_k

    return jax.lax.scan(step, x0, u)
모두 합치면, 먼저 이산화하고 나서 한 단계씩 반복해 SSM을 돌릴 수 있습니다.
def run_SSM(A, B, C, u):
    L = u.shape[0]
    N = A.shape[0]
    Ab, Bb, Cb = discretize(A, B, C, step=1.0 / L)

    # Run recurrence
    return scan_SSM(Ab, Bb, Cb, u[:, np.newaxis], np.zeros((N,)))[1]
곁가지: 역학 예제
직관을 조금 더 얻고 SSM 구현도 시험해 볼 겸, 기계 학습은 잠시 내려놓고 역학의 고전적인 예제를 구현해 보겠습니다.
이 예제에서는 용수철로 벽에 매달린 물체의 앞뒤 방향 위치 를 생각합니다. 시간이 흐르면서 이 물체에 크기가 바뀌는 힘 가 가해집니다. 이 계는 질량(), 용수철 상수(), 마찰 상수()로 정해집니다. 이들 사이의 관계는 다음 미분 방정식으로 쓸 수 있습니다.
이를 행렬 꼴로 다시 쓰면 다음과 같은 SSM이 나옵니다.
def example_mass(k, b, m):
    A = np.array([[0, 1], [-k / m, -b / m]])
    B = np.array([[0], [1.0 / m]])
    C = np.array([[1.0, 0]])
return A, B, C를 보면 은닉 상태의 첫 번째 차원이 위치라는 것을 납득할 수 있습니다(그 값이 그대로 가 되니까요). 두 번째 차원은 속도인데, 를 거쳐 의 영향을 받기 때문입니다. 전이 행렬 는 이 두 항을 서로 이어 줍니다.
는 에 대한 연속 함수로 정하겠습니다.
@partial(np.vectorize, signature="()->()")
def example_force(t):
    x = np.sin(10 * t)
    return x * (x > 0.5)
이 SSM을 우리 코드로 돌려 봅시다.
def example_ssm():
    # SSM
    ssm = example_mass(k=40, b=5, m=1)

    # L samples of u(t).
    L = 100
    step = 1.0 / L
    ks = np.arange(L)
    u = example_force(ks * step)

    # Approximation of y(t).
    y = run_SSM(*ssm, u)

    # Plotting ---
    import matplotlib.pyplot as plt
    import seaborn
    from celluloid import Camera

    seaborn.set_context("paper")
    fig, (ax1, ax2, ax3) = plt.subplots(3)
    camera = Camera(fig)
    ax1.set_title("Force $u_k$")
    ax2.set_title("Position $y_k$")
    ax3.set_title("Object")
    ax1.set_xticks([], [])
    ax2.set_xticks([], [])

    # Animate plot over time
    for k in range(0, L, 2):
        ax1.plot(ks[:k], u[:k], color="red")
        ax2.plot(ks[:k], y[:k], color="blue")
        ax3.boxplot(
            [[y[k, 0] - 0.04, y[k, 0], y[k, 0] + 0.04]],
            showcaps=False,
            whis=False,
            vert=False,
            widths=10,
        )
        camera.snap()
    anim = camera.animate()
    anim.save("images/line.gif", dpi=150, writer="imagemagick")
if False:
example_ssm()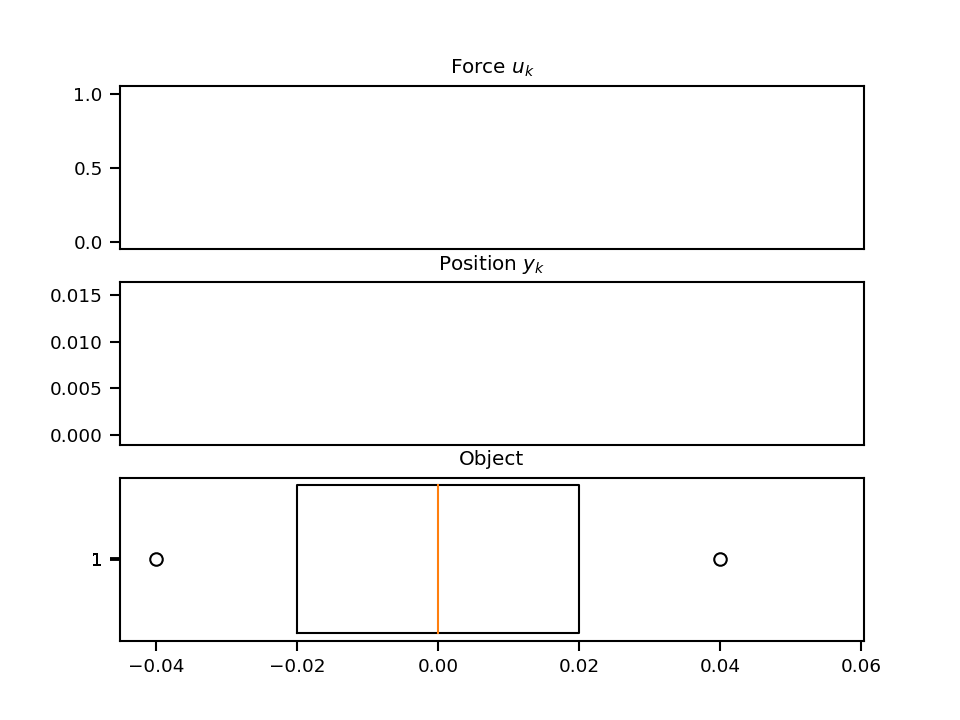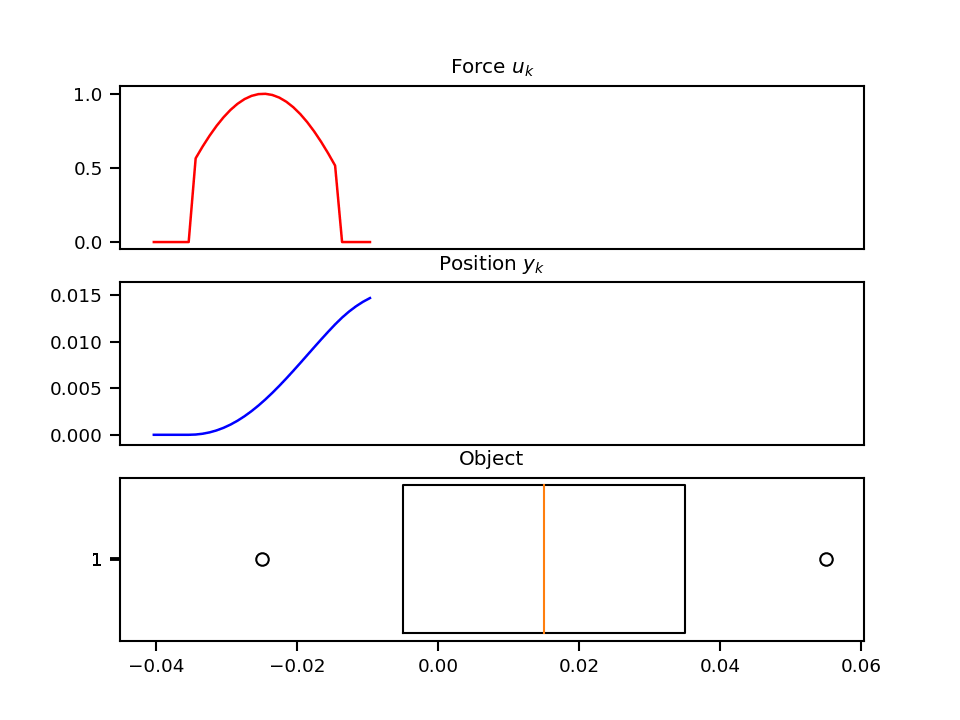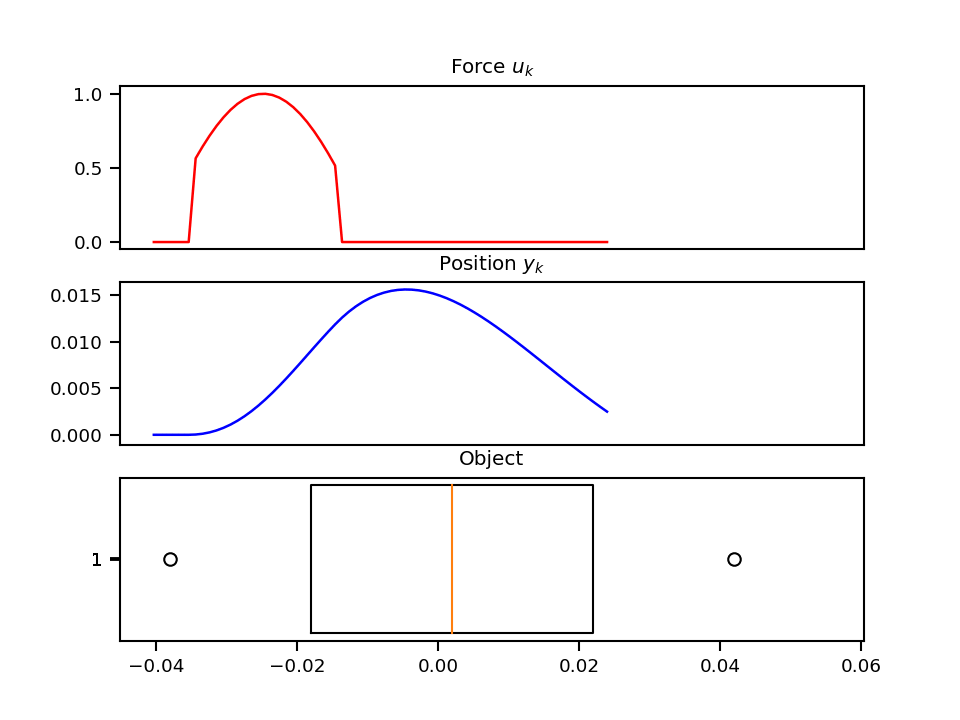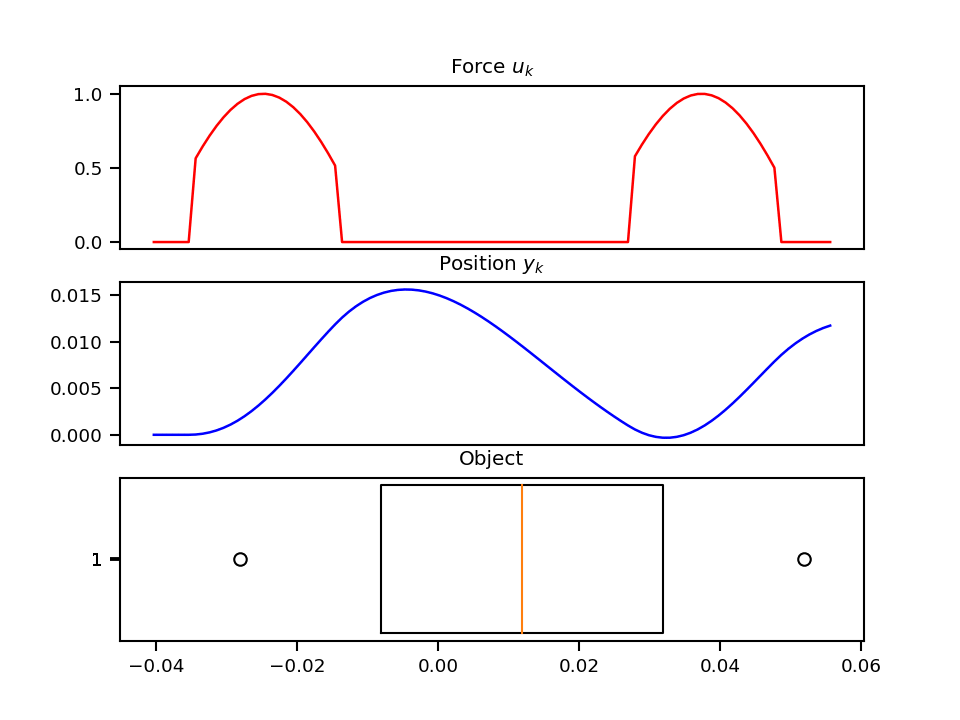
멋지죠! 이것은 은닉 상태 2개짜리 SSM 단 하나를 100단계 동안 돌린 것입니다. 최종 모델은 수백 개의 SSM을 쌓아 수천 단계를 처리하게 됩니다. 하지만 그 전에, 이런 모델을 실제로 학습할 수 있게 만들어야 합니다.
SSM 학습하기: 합성곱 표현
이 절의 핵심은 위의 “RNN”을 펼쳐서 “CNN”으로 바꿀 수 있다는 것입니다. 유도 과정을 따라가 보겠습니다.
순환 SSM은 순차적으로 계산해야 하므로 요즘 하드웨어에서 학습하기에는 실용적이지 않습니다. 그 대신 선형 시불변(linear time-invariant, LTI) SSM과 연속 합성곱 사이에는 잘 알려진 관계가 있습니다. 이에 따라 순환 SSM은 사실 이산 합성곱으로 쓸 수 있습니다.
간단히 초기 상태를 이라고 둡시다. 그러면 직접 펼쳐서 다음을 얻습니다.
이를 벡터화하면 합성곱 커널을 명시적인 식으로 나타낸 합성곱이 됩니다.
이 를 SSM 합성곱 커널, 또는 필터라고 부릅니다.
이 필터가 어마어마하게 크다는 데 주목하세요. 시퀀스 전체 길이만 합니다!
def K_conv(Ab, Bb, Cb, L):
    return np.array(
        [(Cb @ matrix_power(Ab, l) @ Bb).reshape() for l in range(L)]
    )
주의: 이 구현은 단순하고 불안정합니다. 실제로는 길이가 아주 짧을 때가 아니면 제대로 동작하지 않습니다. 하지만 2부에서 S4로 바꿔 끼울 것이므로, 지금은 자리만 지키는 용도로 남겨 둡니다.
이 필터를 적용한 결과는 보통의 직접 합성곱으로 계산할 수도 있고, 고속 푸리에 변환을 이용한 합성곱 정리로 계산할 수도 있습니다. 두 시퀀스의 순환 합성곱에 대한 이산 합성곱 정리를 쓰면, 먼저 입력 시퀀스들의 FFT를 곱한 뒤 역 FFT를 적용하는 식으로 합성곱 결과를 효율적으로 구할 수 있습니다. 우리처럼 순환이 아닌 합성곱에 이 정리를 쓰려면, 입력 시퀀스 뒤에 0을 덧대고 나중에 출력 시퀀스에서 그만큼 잘라 내야 합니다. 길이가 길어질수록 이 FFT 방법이 직접 합성곱보다 효율적입니다.
def causal_convolution(u, K, nofft=False):
    if nofft:
        return convolve(u, K, mode="full")[: u.shape[0]]
    else:
        assert K.shape[0] == u.shape[0]
        ud = np.fft.rfft(np.pad(u, (0, K.shape[0])))
        Kd = np.fft.rfft(np.pad(K, (0, u.shape[0])))
        out = ud * Kd
        return np.fft.irfft(out)[: u.shape[0]]
CNN 방식과 RNN 방식은 (거의) 같은 결과를 냅니다.
def test_cnn_is_rnn(N=4, L=16, step=1.0 / 16):
    ssm = random_SSM(rng, N)
    u = jax.random.uniform(rng, (L,))
    jax.random.split(rng, 3)
    # RNN
    rec = run_SSM(*ssm, u)

    # CNN
    ssmb = discretize(*ssm, step=step)
    conv = causal_convolution(u, K_conv(*ssmb, L))

    # Check
    assert np.allclose(rec.ravel(), conv.ravel())
SSM 신경망
이제 기본적인 SSM 신경망 층을 만드는 데 필요한 장치를 모두 갖췄습니다. 앞에서 정의했듯이 이산 SSM은 인 사상, 곧 1차원 시퀀스 사상을 정의합니다. 파라미터 와 , 그리고 간격 와 스칼라 파라미터 를 학습한다고 가정합니다. 전이 행렬 로는 HiPPO 행렬을 씁니다. 간격은 로그 공간에서 학습합니다.
def log_step_initializer(dt_min=0.001, dt_max=0.1):
    def init(key, shape):
        return jax.random.uniform(key, shape) * (
            np.log(dt_max) - np.log(dt_min)
        ) + np.log(dt_min)

    return init
SSM 층에서 할 일은 대부분 필터를 만드는 것입니다. 신경망을 실제로 호출하는 부분은 앞에서 정한 (거대한) 합성곱 하나뿐입니다.
Torch 사용자를 위한 참고: Flax의 setup은 파라미터가 갱신될 때마다 호출됩니다. Torch의 parametrization과 비슷합니다.
앞에서 말했듯이 같은 층을 RNN으로도 CNN으로도 쓸 수 있습니다. 어느 쪽 경로를 쓸지는 인자 decode가 정합니다. RNN일 때는 호출할 때마다 직전 상태를 cache라는 Flax 변수 컬렉션에 캐시해 둡니다.
class SSMLayer(nn.Module):
    N: int
    l_max: int
    decode: bool = False

    def setup(self):
        # SSM parameters
        self.A = self.param("A", lecun_normal(), (self.N, self.N))
        self.B = self.param("B", lecun_normal(), (self.N, 1))
        self.C = self.param("C", lecun_normal(), (1, self.N))
        self.D = self.param("D", nn.initializers.ones, (1,))

        # Step parameter
        self.log_step = self.param("log_step", log_step_initializer(), (1,))

        step = np.exp(self.log_step)
        self.ssm = discretize(self.A, self.B, self.C, step=step)
        self.K = K_conv(*self.ssm, self.l_max)

        # RNN cache for long sequences
        self.x_k_1 = self.variable("cache", "cache_x_k", np.zeros, (self.N,))

    def __call__(self, u):
        if not self.decode:
            # CNN Mode
            return causal_convolution(u, self.K) + self.D * u
        else:
            # RNN Mode
            x_k, y_s = scan_SSM(*self.ssm, u[:, np.newaxis], self.x_k_1.value)
            if self.is_mutable_collection("cache"):
                self.x_k_1.value = x_k
            return y_s.reshape(-1).real + self.D * u
우리의 SSM은 스칼라를 다루므로, 파라미터가 서로 다른 복사본 개(서로 다른 SSM 개!)를 만들어 쌓습니다. 여기서는 Flax vmap으로 이 복사본들을 손쉽게 정의합니다.
def cloneLayer(layer):
    return nn.vmap(
        layer,
        in_axes=1,
        out_axes=1,
        variable_axes={"params": 1, "cache": 1, "prime": 1},
        split_rngs={"params": True},
    )
SSMLayer = cloneLayer(SSMLayer)이렇게 만든 SSM 층은 일반적인 신경망 안에 넣을 수 있습니다. 여기서는 SSM 호출에 드롭아웃과 선형 사영을 짝지은 블록을 하나 더합니다.
class SequenceBlock(nn.Module):
    layer_cls: nn.Module
    layer: dict  # Hyperparameters of inner layer
    dropout: float
    d_model: int
    prenorm: bool = True
    glu: bool = True
    training: bool = True
    decode: bool = False

    def setup(self):
        self.seq = self.layer_cls(**self.layer, decode=self.decode)
        self.norm = nn.LayerNorm()
        self.out = nn.Dense(self.d_model)
        if self.glu:
            self.out2 = nn.Dense(self.d_model)
        self.drop = nn.Dropout(
            self.dropout,
            broadcast_dims=[0],
            deterministic=not self.training,
        )

    def __call__(self, x):
        skip = x
        if self.prenorm:
            x = self.norm(x)
        x = self.seq(x)
        x = self.drop(nn.gelu(x))
        if self.glu:
            x = self.out(x) * jax.nn.sigmoid(self.out2(x))
        else:
            x = self.out(x)
        x = skip + self.drop(x)
        if not self.prenorm:
            x = self.norm(x)
        return x
그다음 이런 블록 여러 개를 차곡차곡 쌓아 SSM 층 스택을 만들 수 있습니다. 이 스택은 트랜스포머와 똑같은 표준 방식으로 분류나 생성에 쓸 수 있습니다.
class Embedding(nn.Embed):
    num_embeddings: int
    features: int

    @nn.compact
    def __call__(self, x):
        y = nn.Embed(self.num_embeddings, self.features)(x[..., 0])
        return np.where(x > 0, y, 0.0)
class StackedModel(nn.Module):
layer_cls: nn.Module
layer: dict # Extra arguments to pass into layer constructor
d_output: int
d_model: int
n_layers: int
prenorm: bool = True
dropout: float = 0.0
embedding: bool = False # Use nn.Embed instead of nn.Dense encoder
classification: bool = False
training: bool = True
decode: bool = False # Probably should be moved into layer_args
def setup(self):
if self.embedding:
self.encoder = Embedding(self.d_output, self.d_model)
else:
self.encoder = nn.Dense(self.d_model)
self.decoder = nn.Dense(self.d_output)
self.layers = [
SequenceBlock(
layer_cls=self.layer_cls,
layer=self.layer,
prenorm=self.prenorm,
d_model=self.d_model,
dropout=self.dropout,
training=self.training,
decode=self.decode,
)
for _ in range(self.n_layers)
]
def __call__(self, x):
if not self.classification:
if not self.embedding:
x = x / 255.0 # Normalize
if not self.decode:
x = np.pad(x[:-1], [(1, 0), (0, 0)])
x = self.encoder(x)
for layer in self.layers:
x = layer(x)
if self.classification:
x = np.mean(x, axis=0)
x = self.decoder(x)
return nn.log_softmax(x, axis=-1)Flax에서는 배치 차원을 끌어올린 변환으로 덧붙입니다. 이때 RNN 캐시와 파라미터 캐시를 다루는 변수 컬렉션 몇 개를 함께 넘겨 줘야 합니다(아래에서 설명합니다).
BatchStackedModel = nn.vmap(
    StackedModel,
    in_axes=0,
    out_axes=0,
    variable_axes={"params": None, "dropout": None, "cache": 0, "prime": None},
    split_rngs={"params": False, "dropout": True},
)
정리하면, 이 코드는 모양이 (배치 크기, 시퀀스 길이, 은닉 차원)인 시퀀스에서 시퀀스로 가는 사상을 정의합니다. 트랜스포머, RNN, CNN 같은 다른 시퀀스 모델이 내놓는 시그니처와 똑같습니다.
학습용 전체 코드는 training.py에 있습니다.
이제 주 모델은 갖췄지만, SSM에는 핵심 문제가 두 가지 있습니다. 첫째, 무작위로 초기화한 SSM은 실제로 성능이 그다지 좋지 않습니다. 둘째, 지금까지처럼 단순하게 계산하면 정말 느리고 메모리도 많이 듭니다. 다음으로는 먼 거리 의존성을 위한 특별한 초기화를 정의해 S4의 모델링 측면 이야기를 마무리하고, 이어서 이 SSM 층을 더 빠르게, 그것도 훨씬 빠르게 계산하는 방법을 찾아보겠습니다(2부)!
1b부: HiPPO로 먼 거리 의존성 다루기
[그림: HiPPO의 작동 방식을 보여 주는 그림. 왼쪽은 시각 t에 따라 변하는 함수 f(t)이고, 이를 측도 μ에 대해 사영(proj)해 다항식으로 근사한 뒤 계수(coef)를 뽑는다. 이 계수는 연속 시간 HiPPO 상미분 방정식을 따르며, 이를 이산화하면 아래쪽의 이산 시간 HiPPO 점화식(Discrete-time HiPPO Recurrence) c_{k+1} = A_k c_k + B_k f_k가 된다. 오른쪽 위에는 생각에 잠긴 하마 그림이 있다]
앞선 연구에서 기본 SSM은 실제로 성능이 매우 나쁘다는 것이 드러났습니다. 직관적으로 설명하면, 기울기가 시퀀스 길이에 따라 지수적으로 커지거나 작아지는 문제(곧 기울기 소실과 폭발 문제)를 겪기 때문일 수 있습니다. 이 문제를 풀려고 앞선 연구에서는 연속 시간 기억에 관한 HiPPO 이론을 만들었습니다.
HiPPO는 특정한 행렬 의 부류를 정해 주는데, 이 행렬을 넣으면 상태 가 입력 의 이력을 기억할 수 있게 됩니다. 이 부류에서 가장 중요한 행렬은 HiPPO 행렬로 정의됩니다.
앞선 연구에서는 SSM의 를 무작위 행렬에서 HiPPO로 바꾸기만 해도 순차 MNIST 분류 벤치마크 성능이 에서 로 올라갔습니다.
이 행렬은 앞으로 아주 중요하게 쓰이지만, 조금은 마법 같은 구석이 있습니다. 우리 목적에 필요한 것은 주로 두 가지입니다. 1) 이 행렬은 한 번만 계산하면 되고, 2) 깔끔하고 단순한 구조를 가지고 있습니다(2부에서 이 구조를 활용합니다). 상미분 방정식 수학까지 들어가지 않고 핵심만 말하면, 이 행렬은 지난 이력을 압축해 그 이력을 대략 되살릴 수 있을 만큼의 정보를 담은 상태로 만드는 것을 목표로 합니다.
def make_HiPPO(N):
    P = np.sqrt(1 + 2 * np.arange(N))
    A = P[:, np.newaxis] * P[np.newaxis, :]
    A = np.tril(A) - np.diag(np.arange(N))
    return -A
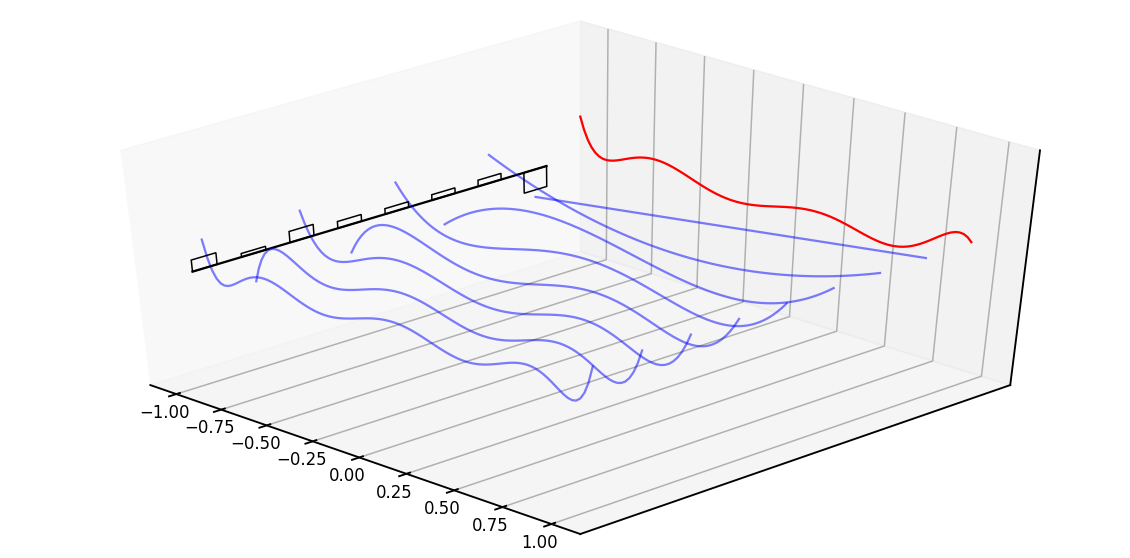
조금 더 깊이 들어가 보면, 이 행렬을 직관적으로 이렇게 설명할 수 있습니다. 이 행렬은 자기 이력을 기억하는 은닉 상태를 만들어 냅니다. 르장드르 다항식의 계수를 계속 추적하는 방식으로 그렇게 합니다. 이 계수들로 지난 이력 전체를 근사할 수 있습니다. 예를 하나 봅시다.
def example_legendre(N=8):
    # Random hidden state as coefficients
    import numpy as np
    import numpy.polynomial.legendre

    x = (np.random.rand(N) - 0.5) * 2
    t = np.linspace(-1, 1, 100)
    f = numpy.polynomial.legendre.Legendre(x)(t)

    # Plot
    import matplotlib.pyplot as plt
    import seaborn

    seaborn.set_context("talk")
    fig = plt.figure(figsize=(20, 10))
    ax = fig.gca(projection="3d")
    ax.plot(
        np.linspace(-25, (N - 1) * 100 + 25, 100),
        [0] * 100,
        zs=-1,
        zdir="x",
        color="black",
    )
    ax.plot(t, f, zs=N * 100, zdir="y", c="r")
    for i in range(N):
        coef = [0] * N
        coef[N - i - 1] = 1
        ax.set_zlim(-4, 4)
        ax.set_yticks([])
        ax.set_zticks([])
        # Plot basis function.
        f = numpy.polynomial.legendre.Legendre(coef)(t)
        ax.bar(
            [100 * i],
            [x[i]],
            zs=-1,
            zdir="x",
            label="x%d" % i,
            color="brown",
            fill=False,
            width=50,
        )
        ax.plot(t, f, zs=100 * i, zdir="y", c="b", alpha=0.5)
    ax.view_init(elev=40.0, azim=-45)
    fig.savefig("images/leg.png")
if False:
example_legendre()빨간 선은 우리가 근사하려는 곡선이고, 검은 막대는 은닉 상태의 값입니다. 각 값은 파란 함수로 그린 르장드르 급수의 한 항에 곱하는 계수입니다. 직관적으로는 HiPPO 행렬이 매 단계 이 계수들을 갱신한다고 보면 됩니다.
2부: S4 구현하기
주의: 이 절에는 수학이 많이 나옵니다. 대략 말하면 1부의 필터를 “HiPPO 같은” 행렬에 대해 정말 빠르게 계산하는 방법을 찾는 이야기입니다. 관심이 있다면 세부 내용이 정말 흥미로울 것입니다. 그렇지 않다면 MNIST 이어 그리기 같은 멋진 응용이 나오는 3부로 건너뛰어도 됩니다.
(원문에는 여기에 3부로 바로 건너뛰는 버튼이 있습니다.)
먼저 무대를 정리해 봅시다. S4는 기본 SSM과 크게 두 가지가 다릅니다. 첫째는 먼 거리 의존성이라는 모델링 과제를 다루는 것으로, 앞 절에서 정의한 행렬의 특별한 식을 씁니다. 이런 특별한 SSM은 S4에 앞선 선행 연구들에서도 다뤘습니다.
S4의 두 번째 주요 특징은 이 행렬을 다룰 수 있게 해 주는 특별한 표현과 알고리즘을 도입해 SSM의 계산 과제를 푼다는 것입니다!
이산 시간 SSM 계산의 근본적인 병목은 를 되풀이해 곱해야 한다는 데 있습니다. 예를 들어 단순하게 계산하면 를 번 잇달아 곱해야 하므로 번의 연산과 의 공간이 듭니다.
구체적으로는 앞에서 본 이 함수를 떠올려 보세요.
def K_conv(Ab, Bb, Cb, L):
   return np.array(
       [(Cb @ matrix_power(Ab, l) @ Bb).reshape() for l in range(L)]
   )
S4가 기여한 것은 바로 이 연산을 안정적으로 빠르게 하는 방법입니다. 이를 위해 SSM에 특별한 구조가 있는 경우, 구체적으로는 복소 공간에서 대각 더하기 저랭크(Diagonal Plus Low-Rank, DPLR)인 경우에 집중하겠습니다.
DPLR SSM은 어떤 대각 행렬 와 행렬 에 대해 꼴인 SSM입니다. 일반성을 잃지 않고 랭크가 , 곧 이 행렬들이 벡터라고 가정합니다.
이 DPLR 가정 아래에서 S4는 세 단계로 속도 병목을 넘어섭니다.
- 를 직접 계산하는 대신, 그 잘린 생성 함수(truncated generating function) 의 값을 구해 스펙트럼을 계산합니다. 이제 행렬의 거듭제곱 대신 역행렬을 다루게 됩니다.
- 대각 행렬인 경우는 코시 커널 을 계산하는 것과 같다는 것을 보입니다.
- 저랭크 항은 우드버리 항등식 을 적용해 보정할 수 있음을 보입니다. 이 항등식은 을 로 나타내 주므로, 문제가 정말로 대각 행렬인 경우로 줄어듭니다.
1단계. SSM 생성 함수
핵심 단계는 시퀀스 자체를 계산하는 대신 그 생성 함수를 계산하는 쪽으로 바꾸는 것입니다. 논문 부록의 설명을 옮깁니다.
의 거듭제곱을 계산하는 문제를 풀기 위해 또 다른 기법을 도입합니다. SSM 합성곱 필터 를 직접 계산하는 대신, 그 계수들로 생성 함수를 만들고 그 함수의 값을 계산합니다.
노드 에서 길이 로 자른 잘린 SSM 생성 함수는 다음과 같습니다.
def K_gen_simple(Ab, Bb, Cb, L):
    K = K_conv(Ab, Bb, Cb, L)

    def gen(z):
        return np.sum(K * (z ** np.arange(L)))

    return gen
생성 함수는 본질적으로 SSM 합성곱 필터를 시간 영역에서 주파수 영역으로 옮깁니다. 제어 공학 문헌에서는 이 변환을 (부호 하나 차이를 빼면) z 변환이라고도 부릅니다. 중요한 점은 이 변환이 정보를 그대로 보존하므로 원하는 SSM 합성곱 필터를 되살릴 수 있다는 것입니다. 이산 시퀀스의 z 변환을 알면, z 변환의 값을 1의 거듭제곱근 에서 구해 필터의 이산 푸리에 변환을 얻을 수 있습니다. 그런 다음 FFT로 역 푸리에 변환을 적용하면 번의 연산으로 안정적으로 필터를 되살릴 수 있습니다.
def conv_from_gen(gen, L):
    # Evaluate at roots of unity
    # Generating function is (-)z-transform, so we evaluate at (-)root
    Omega_L = np.exp((-2j * np.pi) * (np.arange(L) / L))
    atRoots = jax.vmap(gen)(Omega_L)
    # Inverse FFT
    out = np.fft.ifft(atRoots, L).reshape(L)
    return out.real
더 중요한 것은, 생성 함수에서는 행렬 거듭제곱을 역행렬로 바꿀 수 있다는 점입니다!
그리고 모든 에 대해 이므로 그 항은 사라집니다. 그런 다음 이 상수 항을 새로운 안으로 끌어들입니다. 결정적으로, 이 함수는 K_conv를 호출하지 않습니다.
def K_gen_inverse(Ab, Bb, Cb, L):
    I = np.eye(Ab.shape[0])
    Ab_L = matrix_power(Ab, L)
    Ct = Cb @ (I - Ab_L)
    return lambda z: (Ct.conj() @ inv(I - Ab * z) @ Bb).reshape()
그런데도 같은 값을 냅니다.
def test_gen_inverse(L=16, N=4):
    ssm = random_SSM(rng, N)
    ssm = discretize(*ssm, 1.0 / L)
    b = K_conv(*ssm, L=L)

    a = conv_from_gen(K_gen_inverse(*ssm, L=L), L)
    assert np.allclose(a, b)
정리하면, 1단계에서는 잘린 생성 함수를 이용해 행렬 거듭제곱을 역행렬로 바꿀 수 있었습니다. 하지만 이 역행렬은 여전히 (1의 거듭제곱근 하나하나에 대해) 번 계산해야 합니다.
2단계: 대각 행렬인 경우
다음 단계는 행렬 에 특별한 구조가 있다고 가정해, 단순한 역행렬 계산보다 빠르게 역행렬을 구하는 것입니다. 우선 위의 식을 원래 SSM 행렬로 다시 써 봅시다. 대수 계산을 조금 하면 이산화를 펼쳐서 다음을 보일 수 있습니다.
이제 어떤 대각 행렬 에 대해 라고 생각해 봅시다. 이산화 식에 대입하면, 저자들이 보였듯 생성 함수를 다음과 같이 쓸 수 있습니다.
여기서 는 상수이고 는 의 함수입니다.
결과적으로 역행렬을 가중 내적으로 바꾼 셈입니다. 앞으로 쓸 수 있게 이 가중 내적을 계산하는 작은 도우미 함수를 만들어 둡시다.
def cauchy_dot(v, omega, lambd):
    return (v / (omega - lambd)).sum()
우리 구현에서 중요하지는 않지만, 이것이 코시 커널이며 다른 여러 빠른 구현의 주제이기도 하다는 점은 짚어 둘 만합니다.
3단계: 대각 더하기 저랭크
마지막 단계는 대각 가정을 느슨하게 하는 것입니다. 대각 항에 더해, 인 저랭크 성분을 허용해 다음과 같이 둡니다.
우드버리 항등식에 따르면, 대각 행렬 더하기 랭크 1 항의 역행렬은 대각 행렬의 역행렬 더하기 랭크 1 항과 같습니다. 저랭크 항을 더한 꼴로 써 보면 다음과 같습니다.
부록에 대수 계산이 잔뜩 나옵니다. 대부분은 A 자리에 이 성분을 대입하고, 우드버리 항등식을 적용하고, 항을 분배하는 과정입니다. 그러면 모두 위의 2단계처럼 생긴 항 4개가 남습니다.
코드는 이 항들을 모아 가중 내적 4개를 적용하는 것이 전부입니다.
def K_gen_DPLR(Lambda, P, Q, B, C, step, unmat=False):
    aterm = (C.conj(), Q.conj())
    bterm = (B, P)

    def gen(o):
        g = (2.0 / step) * ((1.0 - o) / (1.0 + o))
        c = 2.0 / (1.0 + o)

        def k(a):
            # Checkpoint this calculation for memory efficiency.
            if unmat:
                return jax.remat(cauchy_dot)(a, g, Lambda)
            else:
                return cauchy_dot(a, g, Lambda)

        k00 = k(aterm[0] * bterm[0])
        k01 = k(aterm[0] * bterm[1])
        k10 = k(aterm[1] * bterm[0])
        k11 = k(aterm[1] * bterm[1])
        return c * (k00 - k01 * (1.0 / (1.0 + k11)) * k10)

    return gen
이것이 함수의 최종 버전입니다. conv_from_gen은 언제나 생성 함수(예를 들어 K_gen_DPLR)와 함께 호출되므로, 둘을 합쳐 모든 파라미터로부터 DPLR SSM 커널을 계산하는 전용 함수를 정의하겠습니다. (간접 호출 단계가 줄어들면 XLA 컴파일러가 최적화하기도 더 쉬워질 수 있습니다.)
@jax.jit
def cauchy(v, omega, lambd):
    """Cauchy matrix multiplication: (n), (l), (n) -> (l)"""
    cauchy_dot = lambda _omega: (v / (_omega - lambd)).sum()
    return jax.vmap(cauchy_dot)(omega)
def kernel_DPLR(Lambda, P, Q, B, C, step, L):
# Evaluate at roots of unity
# Generating function is (-)z-transform, so we evaluate at (-)root
Omega_L = np.exp((-2j * np.pi) * (np.arange(L) / L))
aterm = (C.conj(), Q.conj())
bterm = (B, P)
g = (2.0 / step) * ((1.0 - Omega_L) / (1.0 + Omega_L))
c = 2.0 / (1.0 + Omega_L)
# Reduction to core Cauchy kernel
k00 = cauchy(aterm[0] * bterm[0], g, Lambda)
k01 = cauchy(aterm[0] * bterm[1], g, Lambda)
k10 = cauchy(aterm[1] * bterm[0], g, Lambda)
k11 = cauchy(aterm[1] * bterm[1], g, Lambda)
atRoots = c * (k00 - k01 * (1.0 / (1.0 + k11)) * k10)
out = np.fft.ifft(atRoots, L).reshape(L)
return out.real이제 제대로 동작하는지 확인해 볼 수 있습니다. 먼저 무작위 대각 더하기 저랭크 행렬을 만듭니다.
def random_DPLR(rng, N):
    l_r, p_r, q_r, b_r, c_r = jax.random.split(rng, 5)
    Lambda = jax.random.uniform(l_r, (N,))
    P = jax.random.uniform(p_r, (N,))
    Q = jax.random.uniform(q_r, (N,))
    B = jax.random.uniform(b_r, (N, 1))
    C = jax.random.uniform(c_r, (1, N))
    return Lambda, P, Q, B, C
DPLR 방법이 를 직접 계산할 때와 같은 필터를 내는지 확인할 수 있습니다.
def test_gen_dplr(L=16, N=4):
    I = np.eye(4)

    # Create a DPLR A matrix and discretize
    Lambda, P, B, _ = make_DPLR_HiPPO(N)
    A = np.diag(Lambda) - P[:, np.newaxis] @ P[:, np.newaxis].conj().T
    _, _, C = random_SSM(rng, N)

    Ab, Bb, Cb = discretize(A, B, C, 1.0 / L)
    a = K_conv(Ab, Bb, Cb.conj(), L=L)

    # Compare to the DPLR generating function approach.
    C = (I - matrix_power(Ab, L)).conj().T @ Cb.ravel()
    b = kernel_DPLR(Lambda, P, P, B, C, step=1.0 / L, L=L)
    assert np.allclose(a.real, b.real)
대각 더하기 저랭크 RNN
DPLR 분해의 부수적인 장점은 행렬의 역행렬을 직접 구하지 않고도 SSM의 이산화된 형태를 계산할 수 있게 해 준다는 것입니다. 여기서는 유도 과정을 다시 논문에서 가져옵니다.
이산화에서 계산하는 값을 떠올려 봅시다.
의 정의에 있는 두 항을 따로따로 단순화합니다. 첫 번째 항은 다음과 같습니다.
여기서 은 마지막 대괄호 안의 항으로 정의합니다.
두 번째 항은 후진 오일러 방법이라고 합니다. 이런 역행렬 항은 보통 다루기 어렵지만, DPLR인 경우에는 위에서 설명한 우드버리 항등식으로 단순화할 수 있습니다.
여기서 이고, 은 마지막 대괄호 안의 항으로 정의합니다.
그러면 이산 시간 SSM은 다음과 같이 됩니다.
def discrete_DPLR(Lambda, P, Q, B, C, step, L):
    # Convert parameters to matrices
    B = B[:, np.newaxis]
    Ct = C[np.newaxis, :]

    N = Lambda.shape[0]
    A = np.diag(Lambda) - P[:, np.newaxis] @ Q[:, np.newaxis].conj().T
    I = np.eye(N)

    # Forward Euler
    A0 = (2.0 / step) * I + A

    # Backward Euler
    D = np.diag(1.0 / ((2.0 / step) - Lambda))
    Qc = Q.conj().T.reshape(1, -1)
    P2 = P.reshape(-1, 1)
    A1 = D - (D @ P2 * (1.0 / (1 + (Qc @ D @ P2))) * Qc @ D)

    # A bar and B bar
    Ab = A1 @ A0
    Bb = 2 * A1 @ B

    # Recover Cbar from Ct
    Cb = Ct @ inv(I - matrix_power(Ab, L)).conj()
    return Ab, Bb, Cb.conj()
HiPPO를 DPLR로 바꾸기
이 방법은 DPLR 행렬에 적용되지만, 우리는 HiPPO 행렬에도 적용되기를 바란다는 것을 잊지 마세요. HiPPO 행렬은 지금 꼴로는 DPLR이 아니지만 특별한 구조를 가지고 있습니다. 바로 정규 더하기 저랭크(Normal Plus Low-Rank, NPLR)입니다. 정규 행렬은 정확히 유니터리 대각화가 가능한 행렬들의 부류이므로, SSM 모델의 관점에서 NPLR 행렬은 본질적으로 DPLR 행렬과 같습니다. SSM 신경망을 학습하는 목적에서는 DPLR만큼이나 쓸모가 있다는 뜻입니다.
S4 기법은 정규 더하기 저랭크 로 분해할 수 있는 어떤 행렬 에도 적용할 수 있습니다.
여기서 은 유니터리 행렬, 는 대각 행렬, 은 저랭크 인수분해입니다. 따라서 NPLR SSM은 어떤 DPLR 행렬과 유니터리 동치입니다.
S4에서는 로 HiPPO 행렬을 써야 합니다. 그러려면 먼저 HiPPO 행렬을 정규 항 더하기 저랭크 항으로 쓰고, 그다음 대각화해서 이 분해로부터 를 뽑아내야 합니다. 논문 부록은 정규 부분을 반대칭 행렬(에 단위 행렬의 상수배를 더한 것)로 써서 이를 보이는데, 반대칭 행렬은 정규 행렬의 특별한 한 부류입니다.
한 가지 더 단순하게 만들 수 있는 점은, 저랭크 성분을 로 묶는 표현이 실제로 있다는 것입니다. 후속 연구에서 이것이 안정성에 중요하다는 것이 밝혀졌습니다.
def make_NPLR_HiPPO(N):
    # Make -HiPPO
    nhippo = make_HiPPO(N)

    # Add in a rank 1 term. Makes it Normal.
    P = np.sqrt(np.arange(N) + 0.5)

    # HiPPO also specifies the B matrix
    B = np.sqrt(2 * np.arange(N) + 1.0)
    return nhippo, P, B
정규 부분을 뽑아낸 다음에는 대각화해서 DPLR 항들을 얻을 수 있습니다. 정규 부분이 실제로는 반대칭이므로 의 실수부와 허수부를 따로 뽑아낼 수 있습니다. 이렇게 하면 두 가지 이점이 있습니다. 첫째, 실수부와 허수부를 더 세밀하게 다룰 수 있어 안정성을 높이는 데 쓸 수 있습니다. 둘째, 에르미트 행렬을 위한 더 강력한 대각화 알고리즘을 쓸 수 있습니다. 실제로 지금 버전의 JAX는 에르미트가 아닌 행렬의 GPU 대각화를 지원하지 않습니다!
def make_DPLR_HiPPO(N):
    """Diagonalize NPLR representation"""
    A, P, B = make_NPLR_HiPPO(N)

    S = A + P[:, np.newaxis] * P[np.newaxis, :]

    # Check skew symmetry
    S_diag = np.diagonal(S)
    Lambda_real = np.mean(S_diag) * np.ones_like(S_diag)
    # assert np.allclose(Lambda_real, S_diag, atol=1e-3)

    # Diagonalize S to V \Lambda V^*
    Lambda_imag, V = eigh(S * -1j)

    P = V.conj().T @ P
    B = V.conj().T @ B
    return Lambda_real + 1j * Lambda_imag, P, B, V
이 항등식들이 정말 성립하는지 확인하는 간단한 점검입니다.
def test_nplr(N=8):
    A2, P, B = make_NPLR_HiPPO(N)
    Lambda, Pc, Bc, V = make_DPLR_HiPPO(N)
    Vc = V.conj().T
    P = P[:, np.newaxis]
    Pc = Pc[:, np.newaxis]
    Lambda = np.diag(Lambda)

    A3 = V @ Lambda @ Vc - (P @ P.T)  # Test NPLR
    A4 = V @ (Lambda - Pc @ Pc.conj().T) @ Vc  # Test DPLR
    assert np.allclose(A2, A3, atol=1e-4, rtol=1e-4)
    assert np.allclose(A2, A4, atol=1e-4, rtol=1e-4)
마지막 점검
모든 것이 계획대로 동작하는지 시험합니다.
def test_conversion(N=8, L=16):
    step = 1.0 / L
    # Compute a HiPPO NPLR matrix.
    Lambda, P, B, _ = make_DPLR_HiPPO(N)
    # Random complex Ct
    C = normal(dtype=np.complex64)(rng, (N,))

    # CNN form.
    K = kernel_DPLR(Lambda, P, P, B, C, step, L)

    # RNN form.
    Ab, Bb, Cb = discrete_DPLR(Lambda, P, P, B, C, step, L)
    K2 = K_conv(Ab, Bb, Cb, L=L)
    assert np.allclose(K.real, K2.real, atol=1e-5, rtol=1e-5)

    # Apply CNN
    u = np.arange(L) * 1.0
    y1 = causal_convolution(u, K.real)

    # Apply RNN
    _, y2 = scan_SSM(
        Ab, Bb, Cb, u[:, np.newaxis], np.zeros((N,)).astype(np.complex64)
    )
    assert np.allclose(y1, y2.reshape(-1).real, atol=1e-4, rtol=1e-4)
3부: 실전 S4
일이 정말 많았지만, 이제 실제 모델은 간결합니다. 사실 쓰는 함수는 넷뿐입니다.
K_gen_DPLR→ 가 DPLR일 때의 잘린 생성 함수(S4 부분)conv_from_gen→ 생성 함수를 필터로 바꾸기causal_convolution→ 합성곱 실행하기discretize_DPLR→ RNN을 위해 SSM을 이산 형태로 바꾸기
S4 CNN / RNN 층
완전한 S4 층은 위의 단순한 SSM 층과 아주 비슷합니다. 다른 점은 를 계산하는 부분뿐입니다. 또 대신 를 학습해서 의 거듭제곱을 계산하지 않아도 되게 합니다. 원래 논문에서는 도 학습한다는 점도 짚어 둡니다. 하지만 이 글에서는 단순하게 하려고 이들을 고정해 둡니다.
class S4Layer(nn.Module):
    N: int
    l_max: int
    decode: bool = False

    # Special parameters with multiplicative factor on lr and no weight decay (handled by main train script)
    lr = {
        "Lambda_re": 0.1,
        "Lambda_im": 0.1,
        "P": 0.1,
        "B": 0.1,
        "log_step": 0.1,
    }

    def setup(self):
        # Learned Parameters (C is complex!)
        init_A_re, init_A_im, init_P, init_B = hippo_initializer(self.N)
        self.Lambda_re = self.param("Lambda_re", init_A_re, (self.N,))
        self.Lambda_im = self.param("Lambda_im", init_A_im, (self.N,))
        # Ensure the real part of Lambda is negative
        # (described in the SaShiMi follow-up to S4)
        self.Lambda = np.clip(self.Lambda_re, None, -1e-4) + 1j * self.Lambda_im
        self.P = self.param("P", init_P, (self.N,))
        self.B = self.param("B", init_B, (self.N,))
        # C should be init as standard normal
        # This doesn't work due to how JAX handles complex optimizers https://github.com/deepmind/optax/issues/196
        # self.C = self.param("C", normal(stddev=1.0, dtype=np.complex64), (self.N,))
        self.C = self.param("C", normal(stddev=0.5**0.5), (self.N, 2))
        self.C = self.C[..., 0] + 1j * self.C[..., 1]
        self.D = self.param("D", nn.initializers.ones, (1,))
        self.step = np.exp(self.param("log_step", log_step_initializer(), (1,)))

        if not self.decode:
            # CNN mode, compute kernel.
            self.K = kernel_DPLR(
                self.Lambda,
                self.P,
                self.P,
                self.B,
                self.C,
                self.step,
                self.l_max,
            )

        else:
            # RNN mode, discretize

            # Flax trick to cache discrete form during decoding.
            def init_discrete():
                return discrete_DPLR(
                    self.Lambda,
                    self.P,
                    self.P,
                    self.B,
                    self.C,
                    self.step,
                    self.l_max,
                )

            ssm_var = self.variable("prime", "ssm", init_discrete)
            if self.is_mutable_collection("prime"):
                ssm_var.value = init_discrete()
            self.ssm = ssm_var.value

            # RNN Cache
            self.x_k_1 = self.variable(
                "cache", "cache_x_k", np.zeros, (self.N,), np.complex64
            )

    def __call__(self, u):
        # This is identical to SSM Layer
        if not self.decode:
            # CNN Mode
            return causal_convolution(u, self.K) + self.D * u
        else:
            # RNN Mode
            x_k, y_s = scan_SSM(*self.ssm, u[:, np.newaxis], self.x_k_1.value)
            if self.is_mutable_collection("cache"):
                self.x_k_1.value = x_k
            return y_s.reshape(-1).real + self.D * u
S4Layer = cloneLayer(S4Layer)모델은 HiPPO DPLR 초기화 함수를 계산해서 초기화합니다.
# Factory for constant initializer in Flax
def init(x):
    def _init(key, shape):
        assert shape == x.shape
        return x

    return _init
def hippo_initializer(N):
Lambda, P, B, _ = make_DPLR_HiPPO(N)
return init(Lambda.real), init(Lambda.imag), init(P), init(B)샘플링과 캐시
RNN 구현을 이용해 모델에서 샘플을 뽑을 수 있습니다. 샘플링 코드는 다음과 같습니다. RNN 상태를 기억하려고 캐시를 계속 유지한다는 점에 주목하세요.
def sample(model, params, prime, cache, x, start, end, rng):
    def loop(i, cur):
        x, rng, cache = cur
        r, rng = jax.random.split(rng)
        out, vars = model.apply(
            {"params": params, "prime": prime, "cache": cache},
            x[:, np.arange(1, 2) * i],
            mutable=["cache"],
        )

        def update(x, out):
            p = jax.random.categorical(r, out[0])
            x = x.at[i + 1, 0].set(p)
            return x

        x = jax.vmap(update)(x, out)
        return x, rng, vars["cache"].unfreeze()

    return jax.lax.fori_loop(start, end, jax.jit(loop), (x, rng, cache))[0]
이를 쓰기 좋은 꼴로 만들기 위해, 먼저 S4 층마다 RNN의 이산화된 버전을 미리 계산해 둡니다. 이 일은 “prime”이라는 변수 컬렉션으로 합니다.
def init_recurrence(model, params, init_x, rng):
    variables = model.init(rng, init_x)
    vars = {
        "params": params,
        "cache": variables["cache"].unfreeze(),
        "prime": variables["prime"].unfreeze(),
    }
    print("[*] Priming")
    _, prime_vars = model.apply(vars, init_x, mutable=["prime"])
    return vars["params"], prime_vars["prime"], vars["cache"]
이 모두를 합치면 모델에서 바로 샘플을 뽑을 수 있습니다.
def sample_checkpoint(path, model, length, rng):
    from flax.training import checkpoints

    start = np.zeros((1, length, 1), dtype=int)

    print("[*] Initializing from checkpoint %s" % path)
    state = checkpoints.restore_checkpoint(path, None)
    assert "params" in state
    params, prime, cache = init_recurrence(model, state["params"], start, rng)
    print("[*] Sampling output")
    return sample(model, params, prime, cache, start, 0, length - 1, rng)
실험: MNIST
이제 모델이 생겼으니 MNIST 실험 몇 가지로 시험해 볼 수 있습니다. 이 실험들에서는 MNIST 이미지를 일렬로 펴서, 각 이미지를 그냥 픽셀의 시퀀스로 다룹니다.
처음 돌린 실험은 MNIST 분류였습니다. 이론상 어려운 문제는 아니지만, MNIST를 일렬 시퀀스 분류 과제로 다루는 것은 좀 이상하긴 합니다. 그래도 실제로는 에 층 4개짜리 모델이 곧바로 99% 가까이까지 올라가는 것 같습니다.
시각적으로 더 흥미로운 과제는 픽셀 시퀀스 전체를 예측해 MNIST 숫자를 생성하는 것입니다! 여기서는 픽셀 시퀀스를 모델에 그냥 넣고, 언어 모델링처럼 다음 픽셀을 예측하게 합니다. 조금 손을 보니 크기 512에 층 6개(파라미터 약 400만 개)인 모델로 이 과제에서 NLL 0.36까지 내려갈 수 있었습니다.
이 과제에서 보통 쓰는 지표는 차원당 비트 로, MNIST에서는 밑이 2인 NLL입니다. 손실 0.36은 약 0.52 BPD이며, PapersWithCode 기준으로 최고 성능입니다.
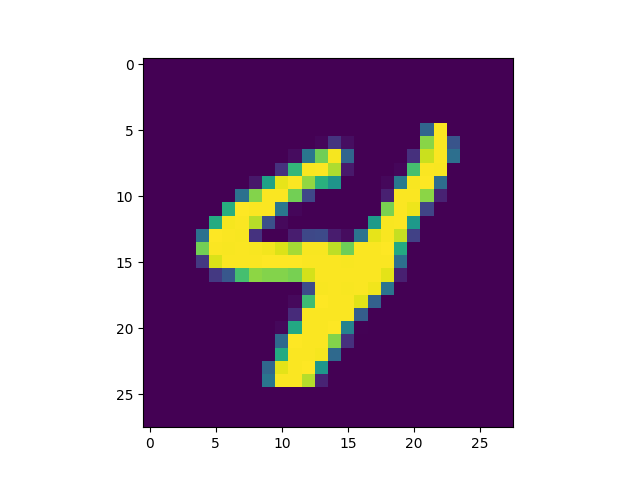
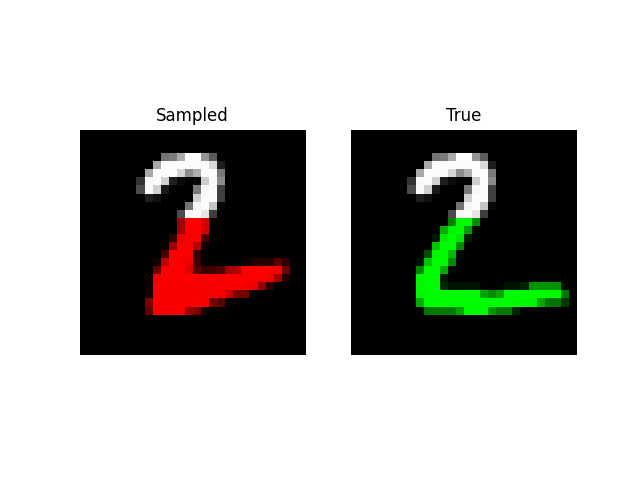
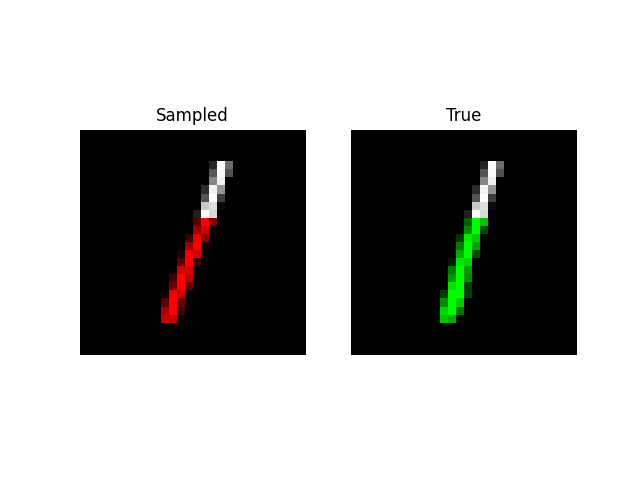
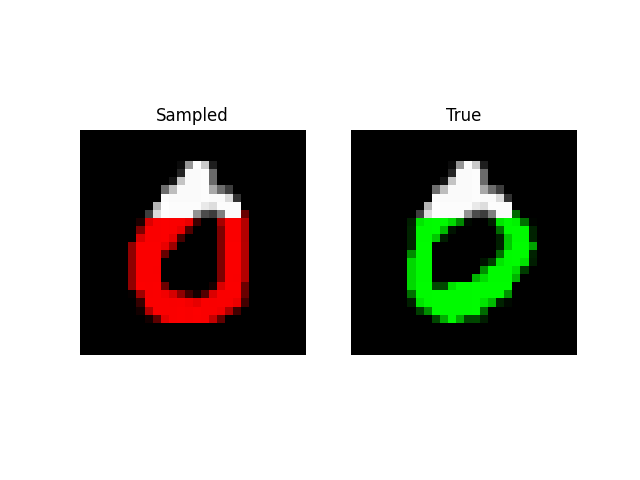
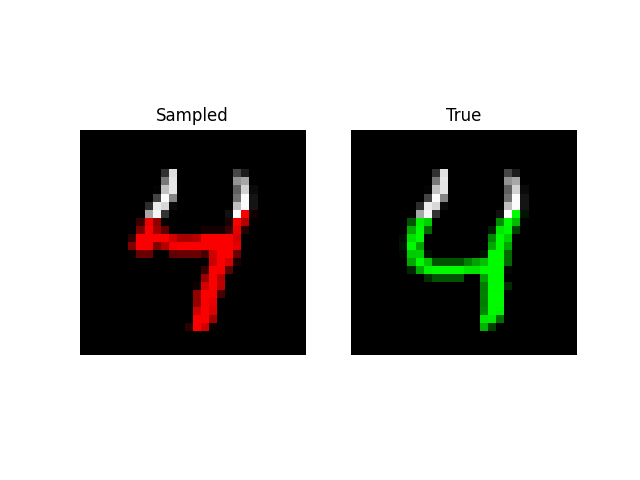
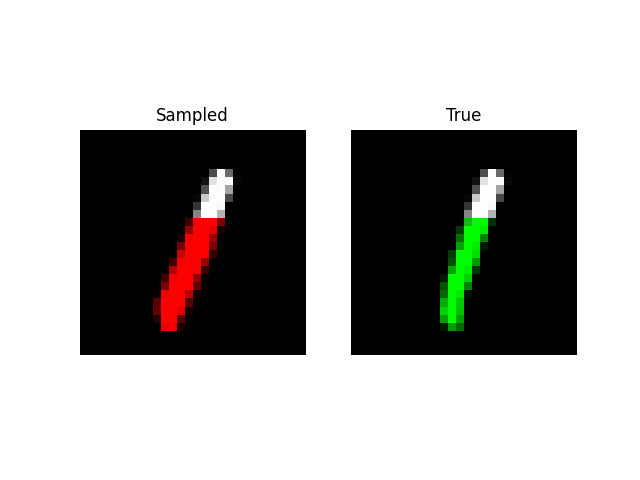
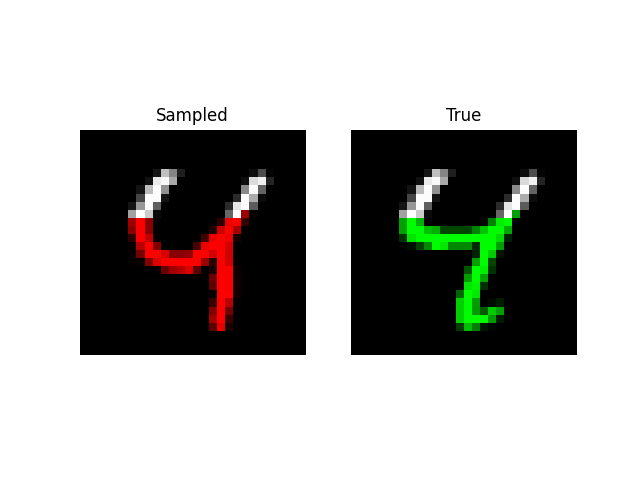
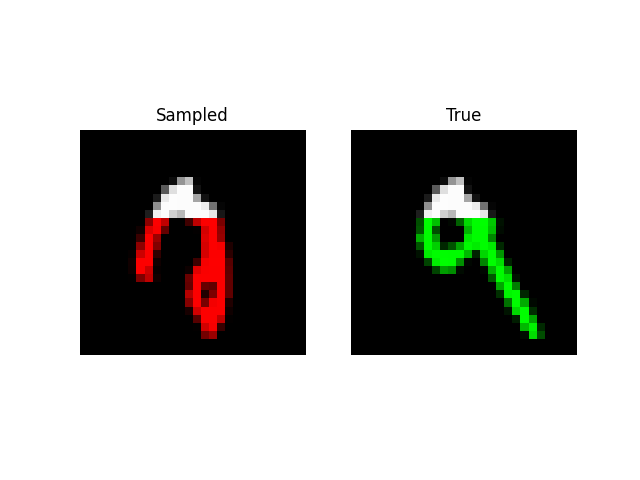
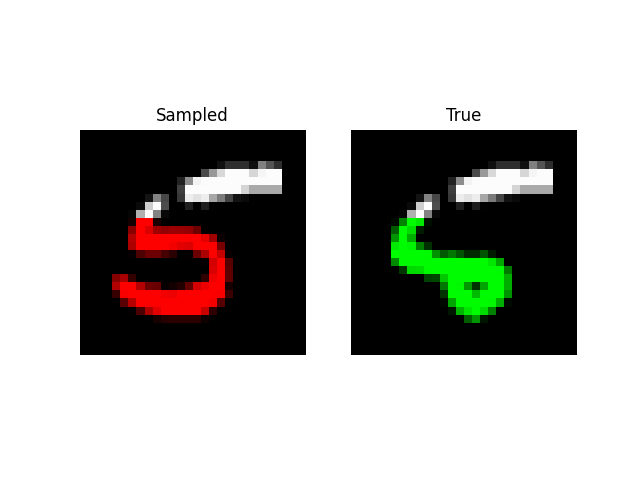
앞부분을 주고 이어 그리게 할 수도 있습니다. 앞쪽 300개 픽셀을 주고 나머지 이미지를 완성하게 하는 것입니다. 왼쪽이 S4, 오른쪽이 실제 이미지입니다.
def sample_image_prefix(
    params,
    model,
    # length,
    rng,
    dataloader,
    prefix=300,
    # bsz=32,
    imshape=(28, 28),
    n_batches=None,
    save=True,
):
    """Sample a grayscale image represented as intensities in [0, 255]"""
    import matplotlib.pyplot as plt
    import numpy as onp

    # from .data import Datasets
    # BATCH = bsz
    # start = np.zeros((BATCH, length), dtype=int)
    # start = np.zeros((BATCH, length, 1), dtype=int)
    start = np.array(next(iter(dataloader))[0].numpy())
    start = np.zeros_like(start)
    # params, prime, cache = init_recurrence(model, params, start[:, :-1], rng)
    params, prime, cache = init_recurrence(model, params, start, rng)

    BATCH = start.shape[0]
    START = prefix
    LENGTH = start.shape[1]
    assert LENGTH == onp.prod(imshape)

    # _, dataloader, _, _, _ = Datasets["mnist"](bsz=BATCH)
    it = iter(dataloader)
    for j, im in enumerate(it):
        if n_batches is not None and j >= n_batches:
            break

        image = im[0].numpy()
        image = np.pad(
            image[:, :-1, :], [(0, 0), (1, 0), (0, 0)], constant_values=0
        )
        cur = onp.array(image)
        # cur[:, START + 1 :, 0] = 0
        # cur = np.pad(cur[:, :-1, 0], [(0, 0), (1, 0)], constant_values=256)
        cur = np.array(cur[:, :])

        # Cache the first `start` inputs.
        out, vars = model.apply(
            {"params": params, "prime": prime, "cache": cache},
            cur[:, np.arange(0, START)],
            mutable=["cache"],
        )
        cache = vars["cache"].unfreeze()
        out = sample(model, params, prime, cache, cur, START, LENGTH - 1, rng)

        # Visualization
        out = out.reshape(BATCH, *imshape)
        final = onp.zeros((BATCH, *imshape, 3))
        final2 = onp.zeros((BATCH, *imshape, 3))
        final[:, :, :, 0] = out
        f = final.reshape(BATCH, LENGTH, 3)
        i = image.reshape(BATCH, LENGTH)
        f[:, :START, 1] = i[:, :START]
        f[:, :START, 2] = i[:, :START]
        f = final2.reshape(BATCH, LENGTH, 3)
        f[:, :, 1] = i
        f[:, :START, 0] = i[:, :START]
        f[:, :START, 2] = i[:, :START]
        if save:
            for k in range(BATCH):
                fig, (ax1, ax2) = plt.subplots(ncols=2)
                ax1.set_title("Sampled")
                ax1.imshow(final[k] / 256.0)
                ax2.set_title("True")
                ax1.axis("off")
                ax2.axis("off")
                ax2.imshow(final2[k] / 256.0)
                fig.savefig("im%d.%d.png" % (j, k))
                plt.close()
                print(f"Sampled batch {j} image {k}")
    return final, final2
실험: QuickDraw
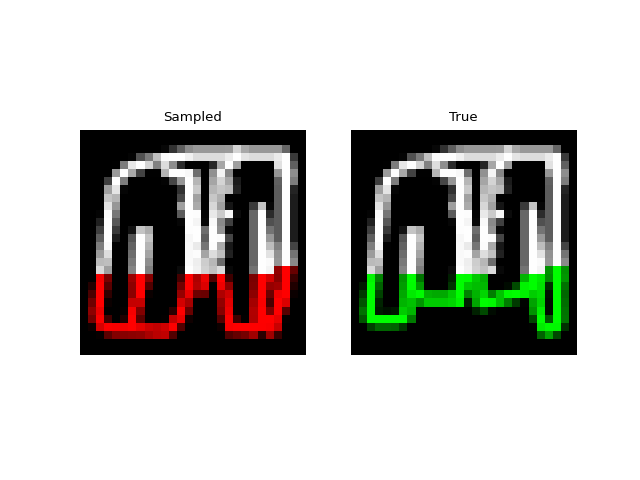
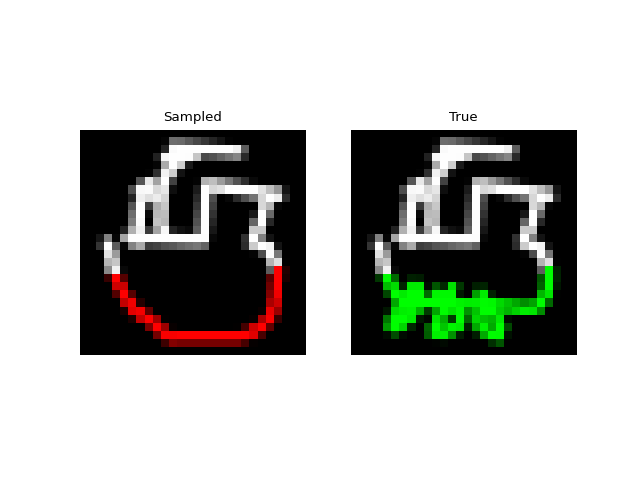
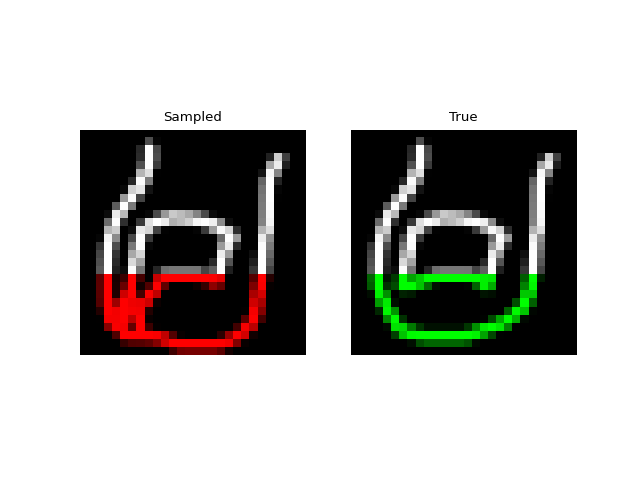
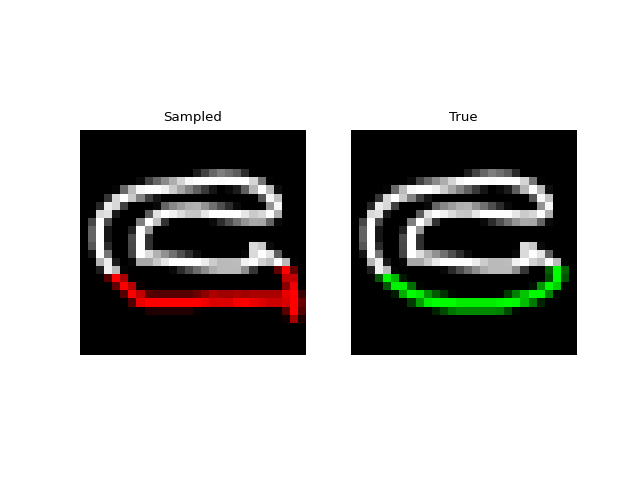
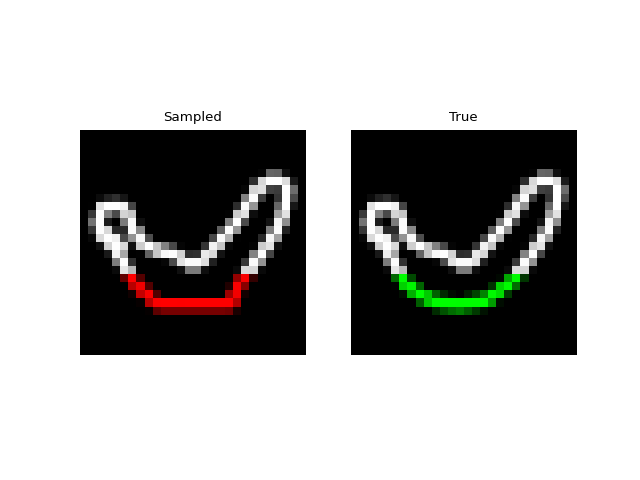
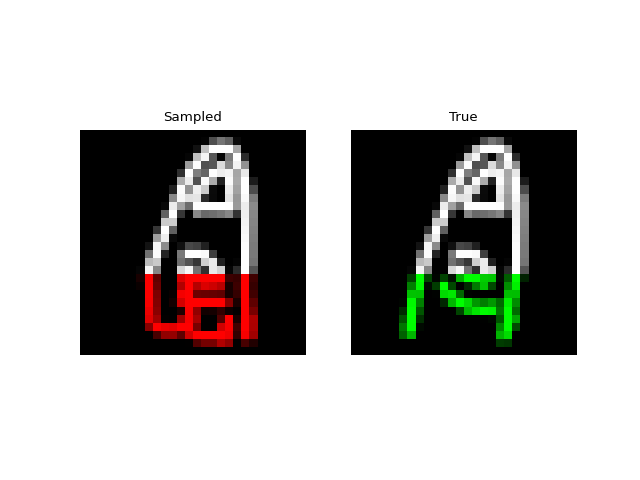
다음으로는 그림을 생성하도록 모델을 학습해 보았습니다. 여기에는 QuickDraw 데이터셋을 썼습니다. 이 데이터셋에는 MNIST 크기로 줄인 버전이 있어서 위와 거의 같은 모델을 쓸 수 있습니다. 다만 데이터셋이 훨씬 크고(이미지 500만 장) 더 복잡합니다. 에 층 4개짜리 모델로 1 에포크만 학습했습니다. 그런데도 꽤 그럴듯한 완성 그림을 만들어 냈습니다. 아래는 픽셀 500개를 주고 이어 그리게 한 샘플입니다.
실험: 숫자 말소리
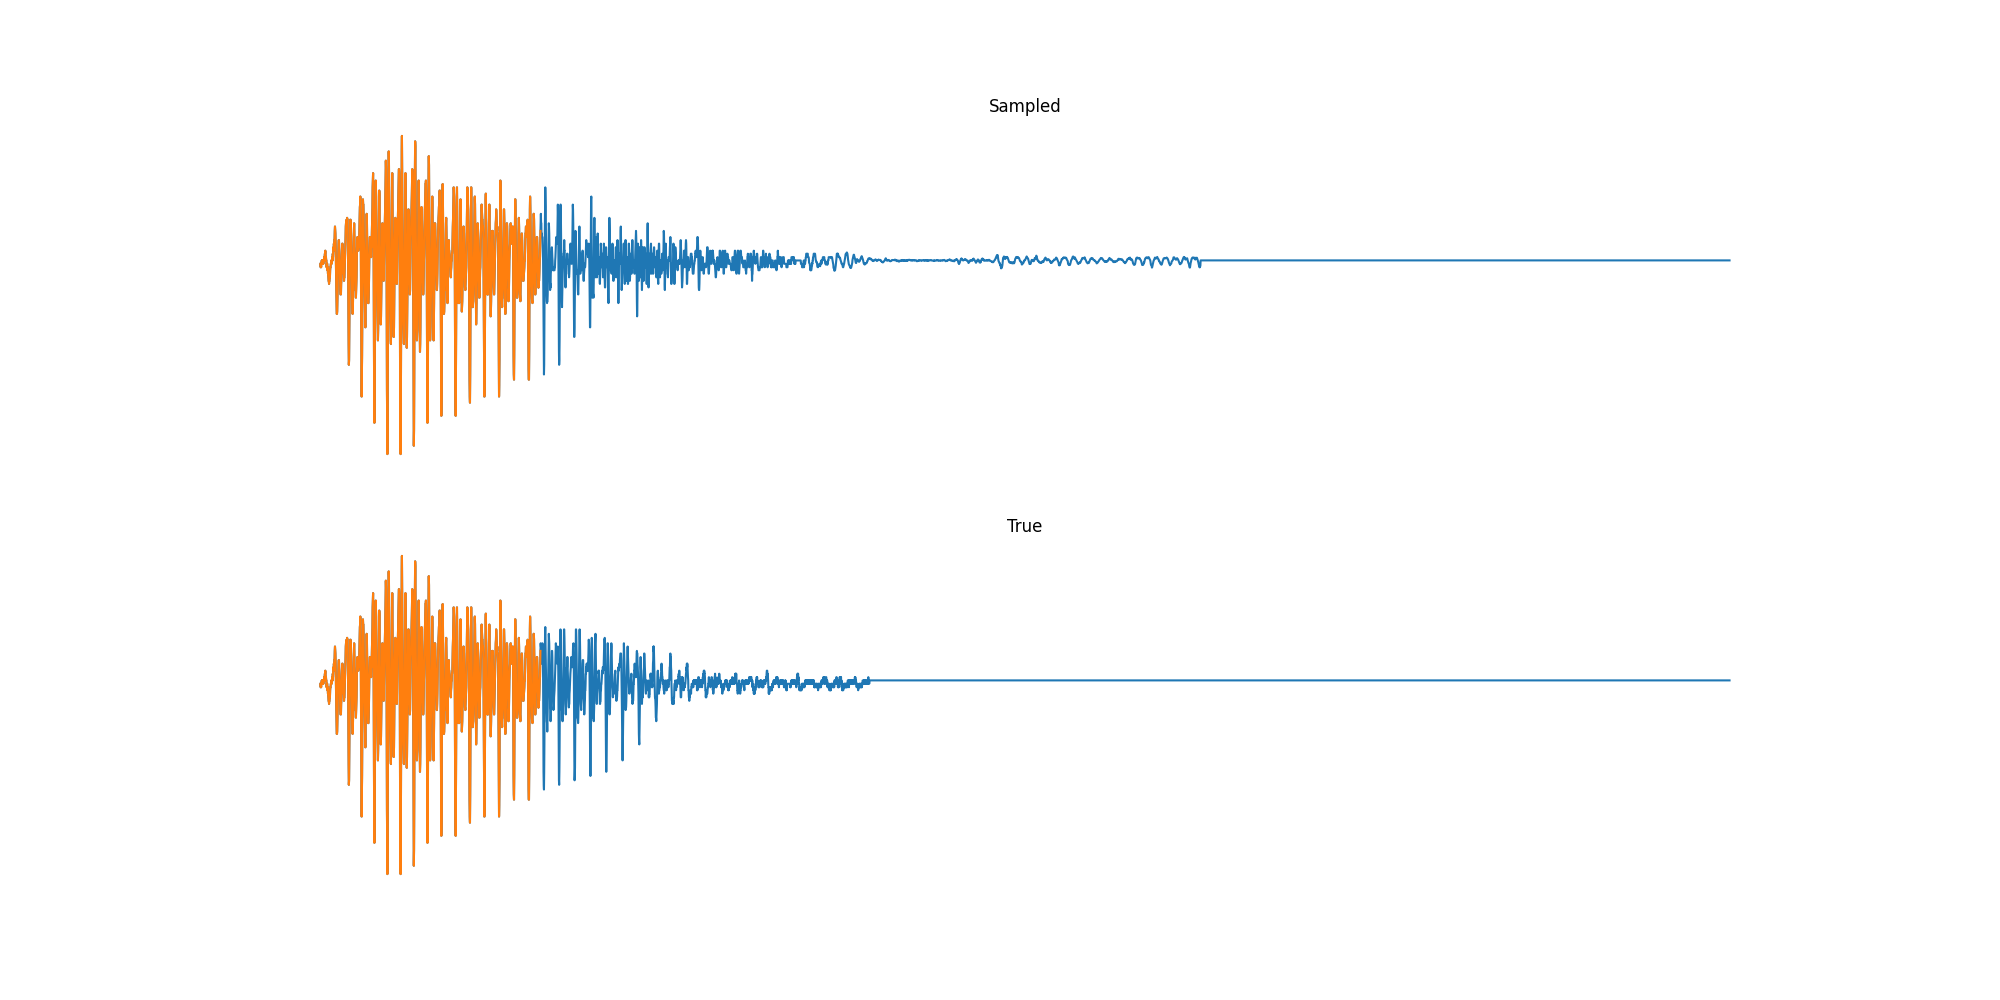
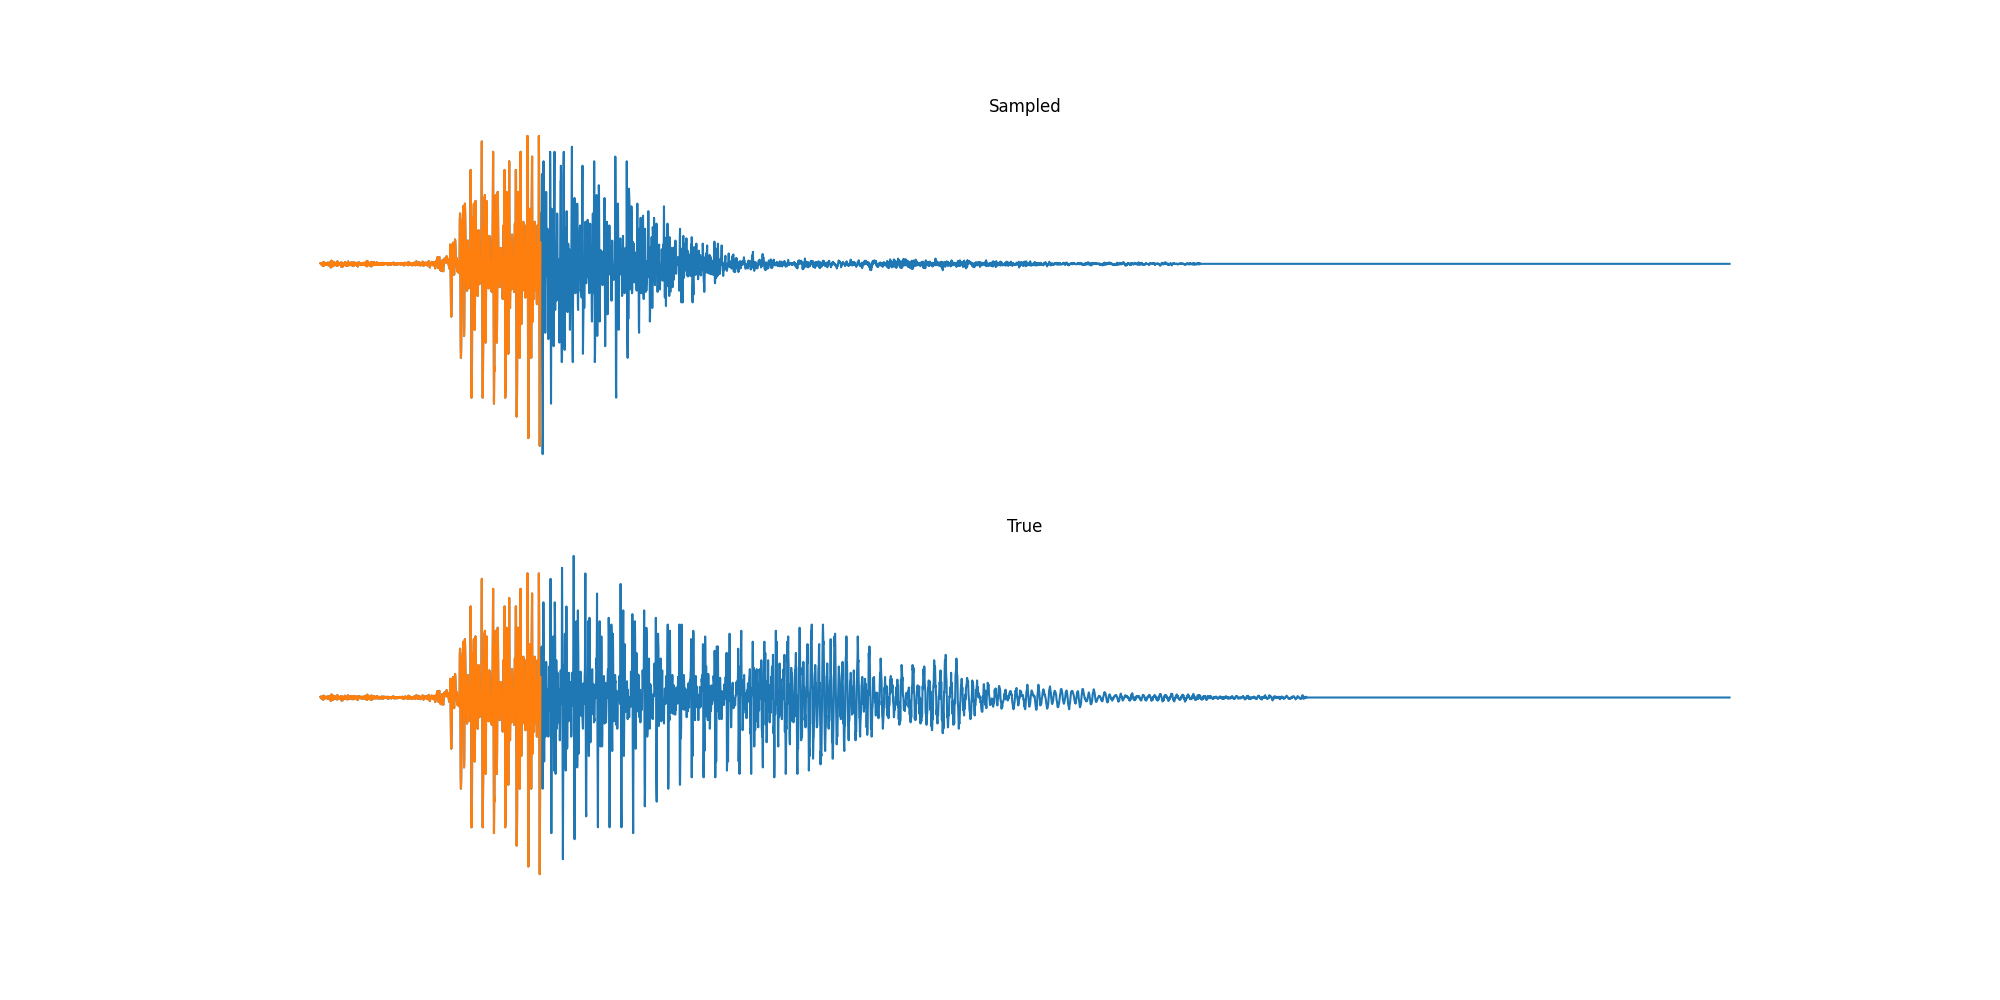
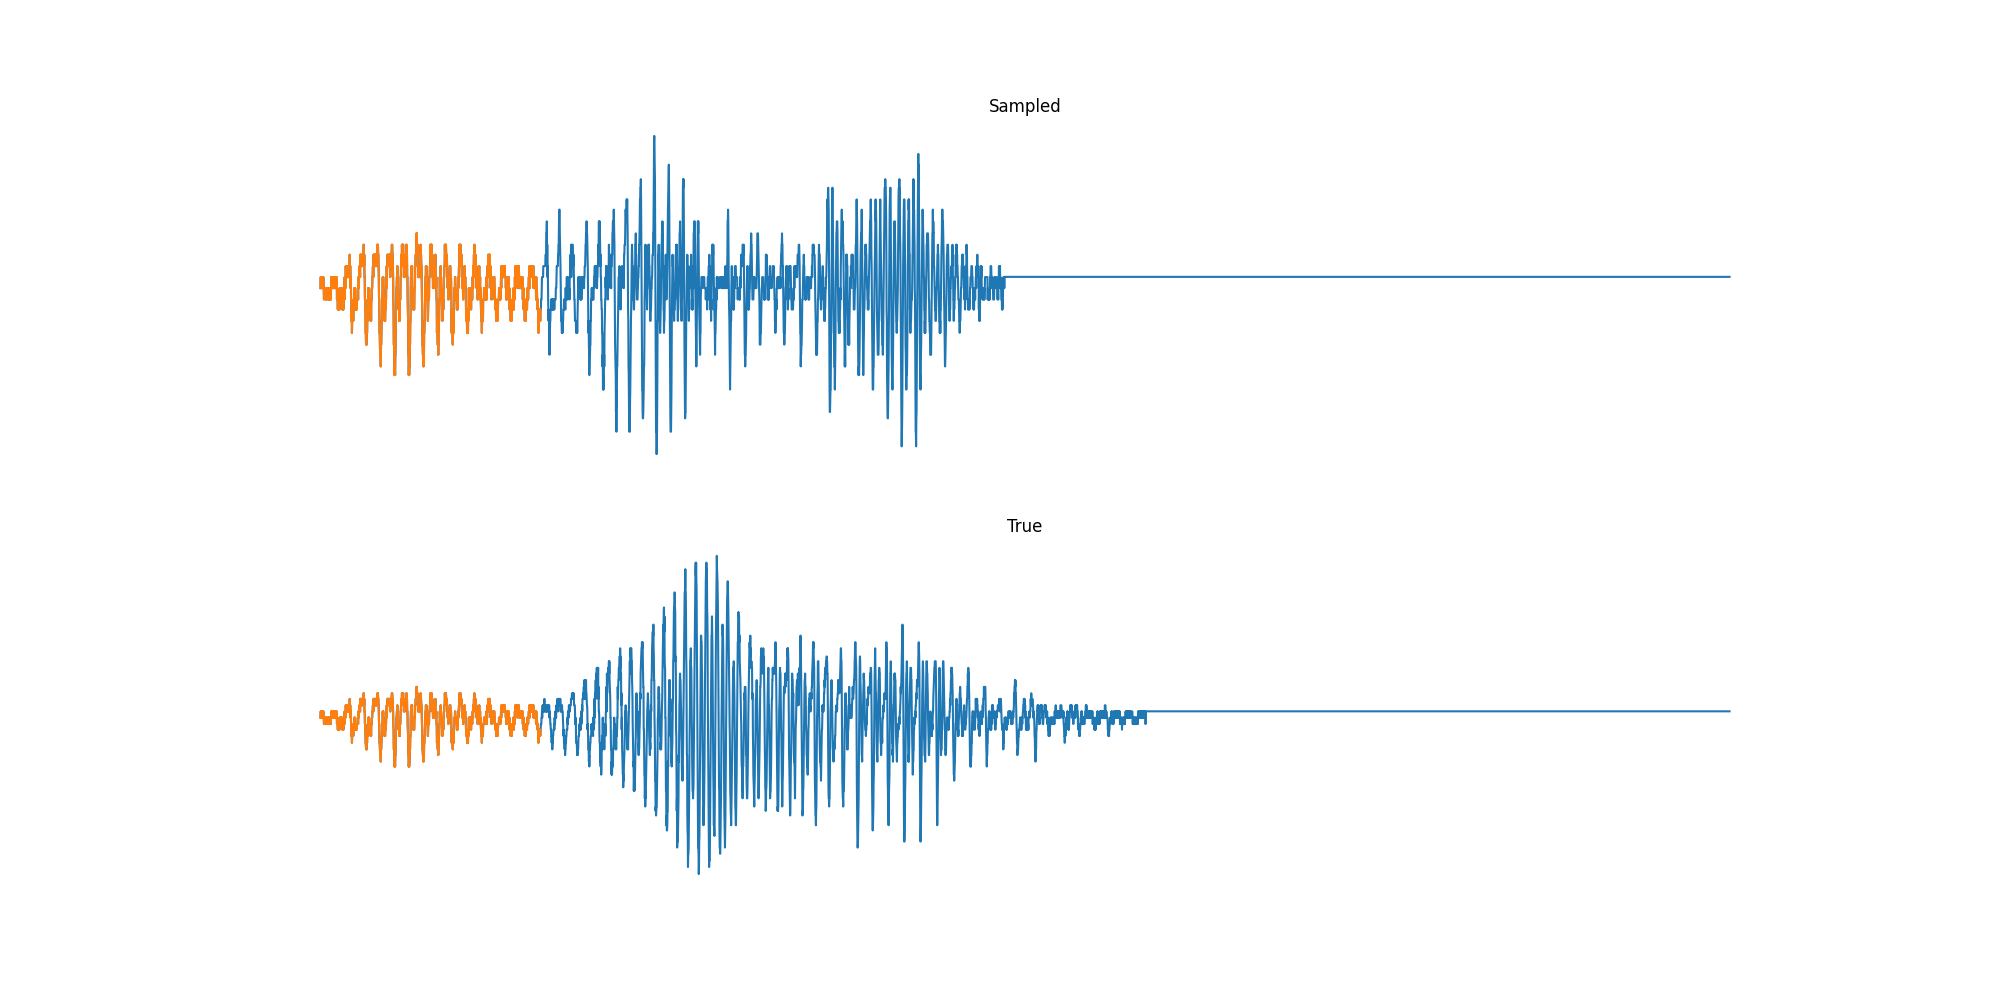
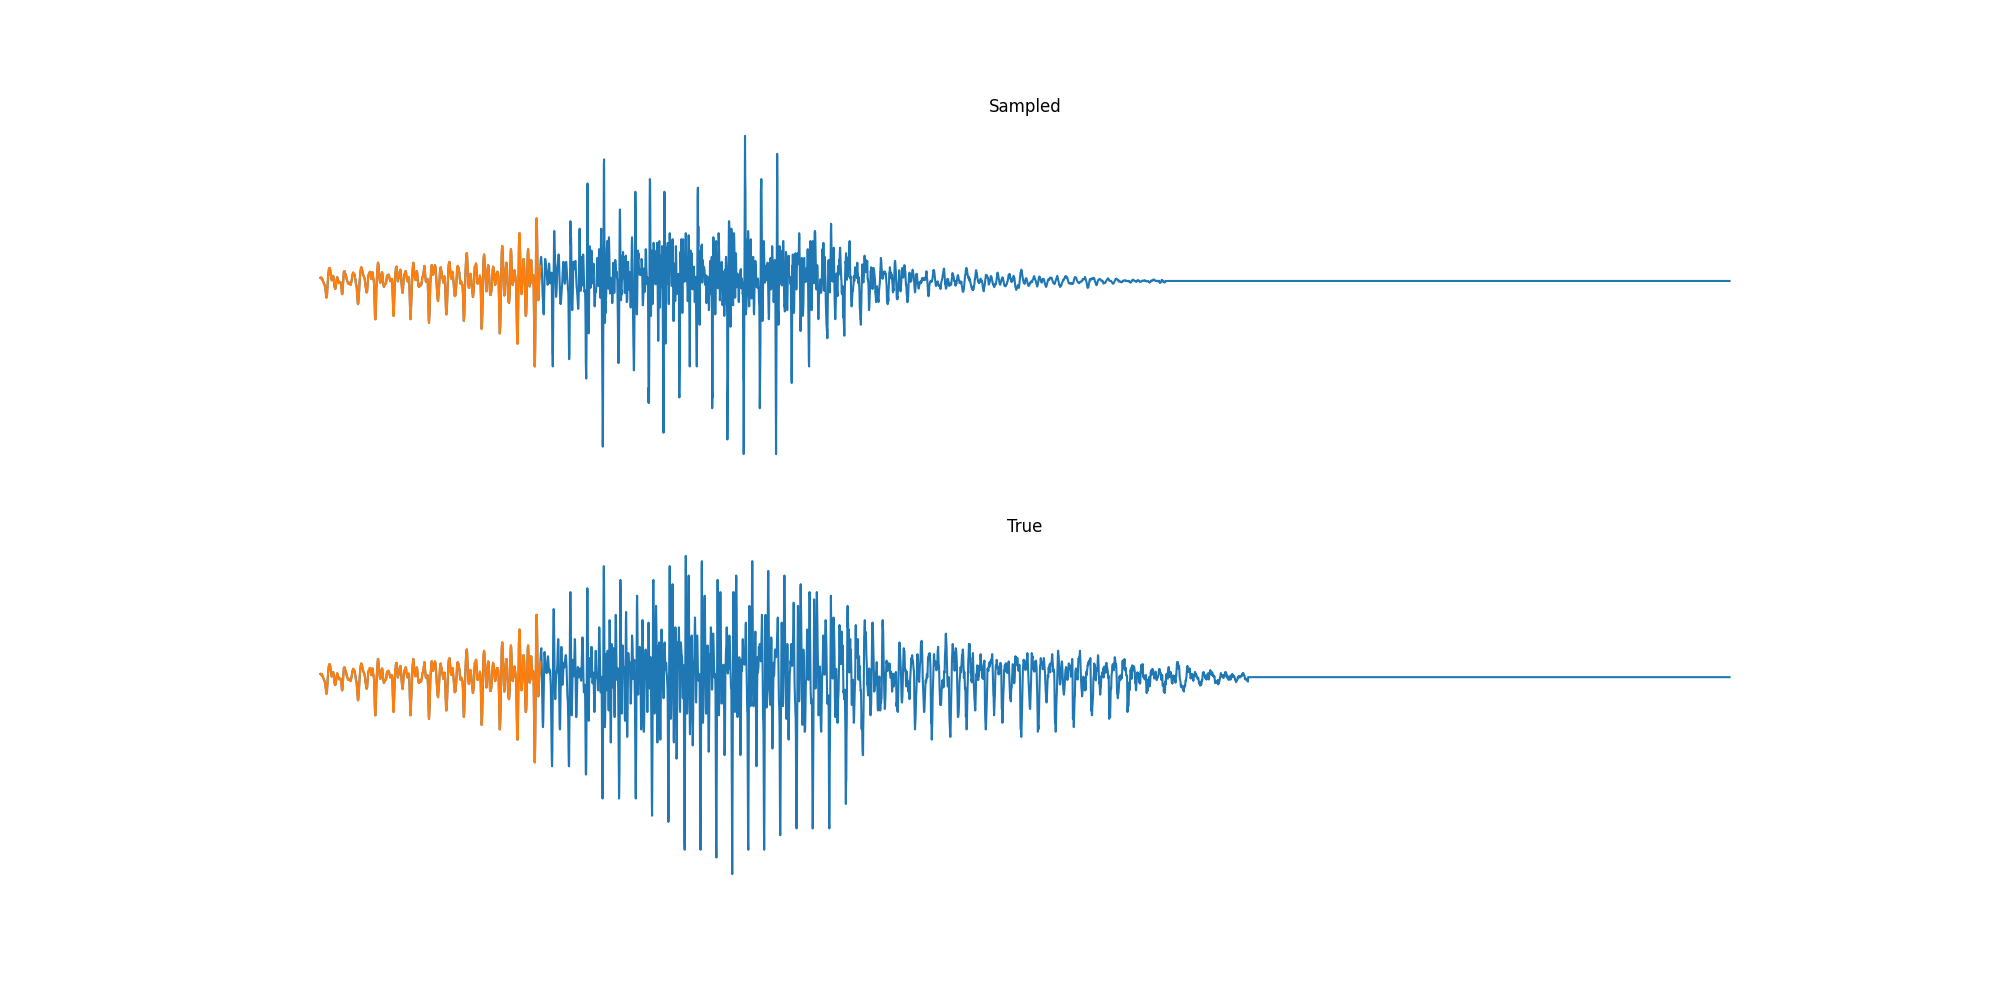
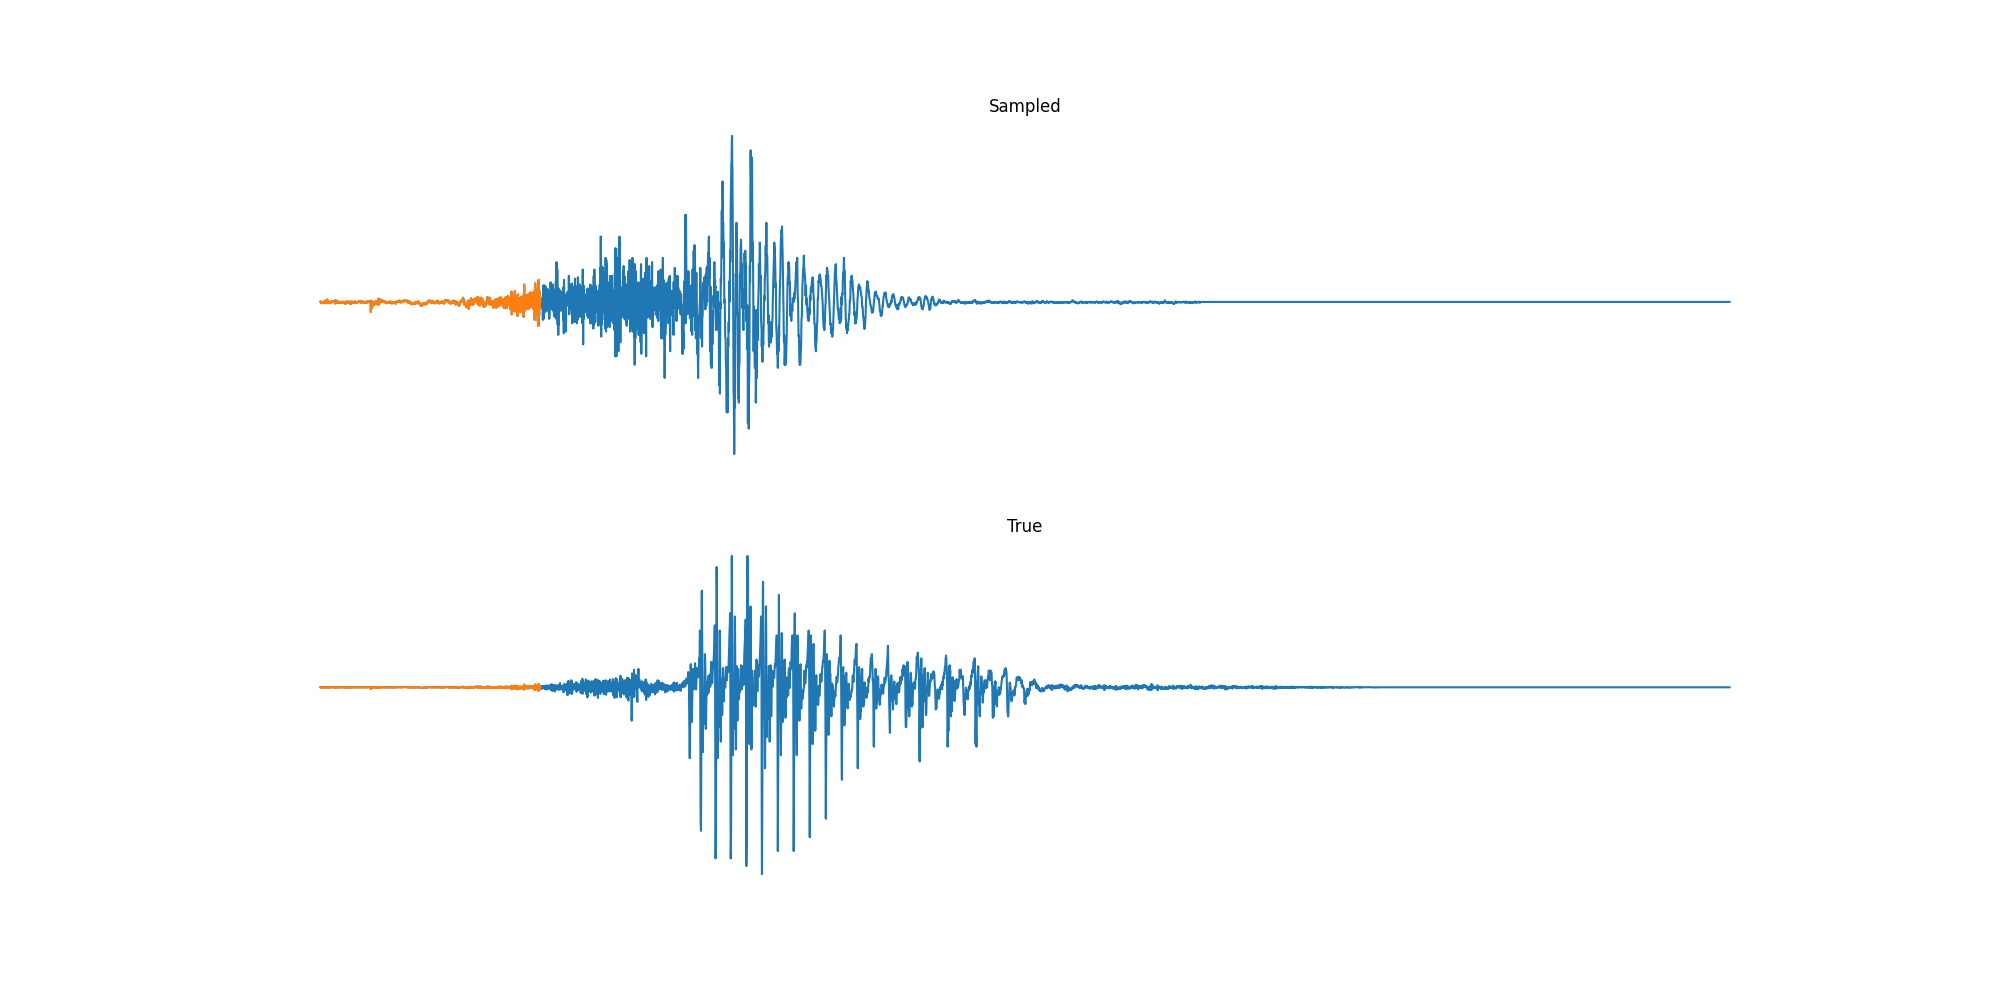
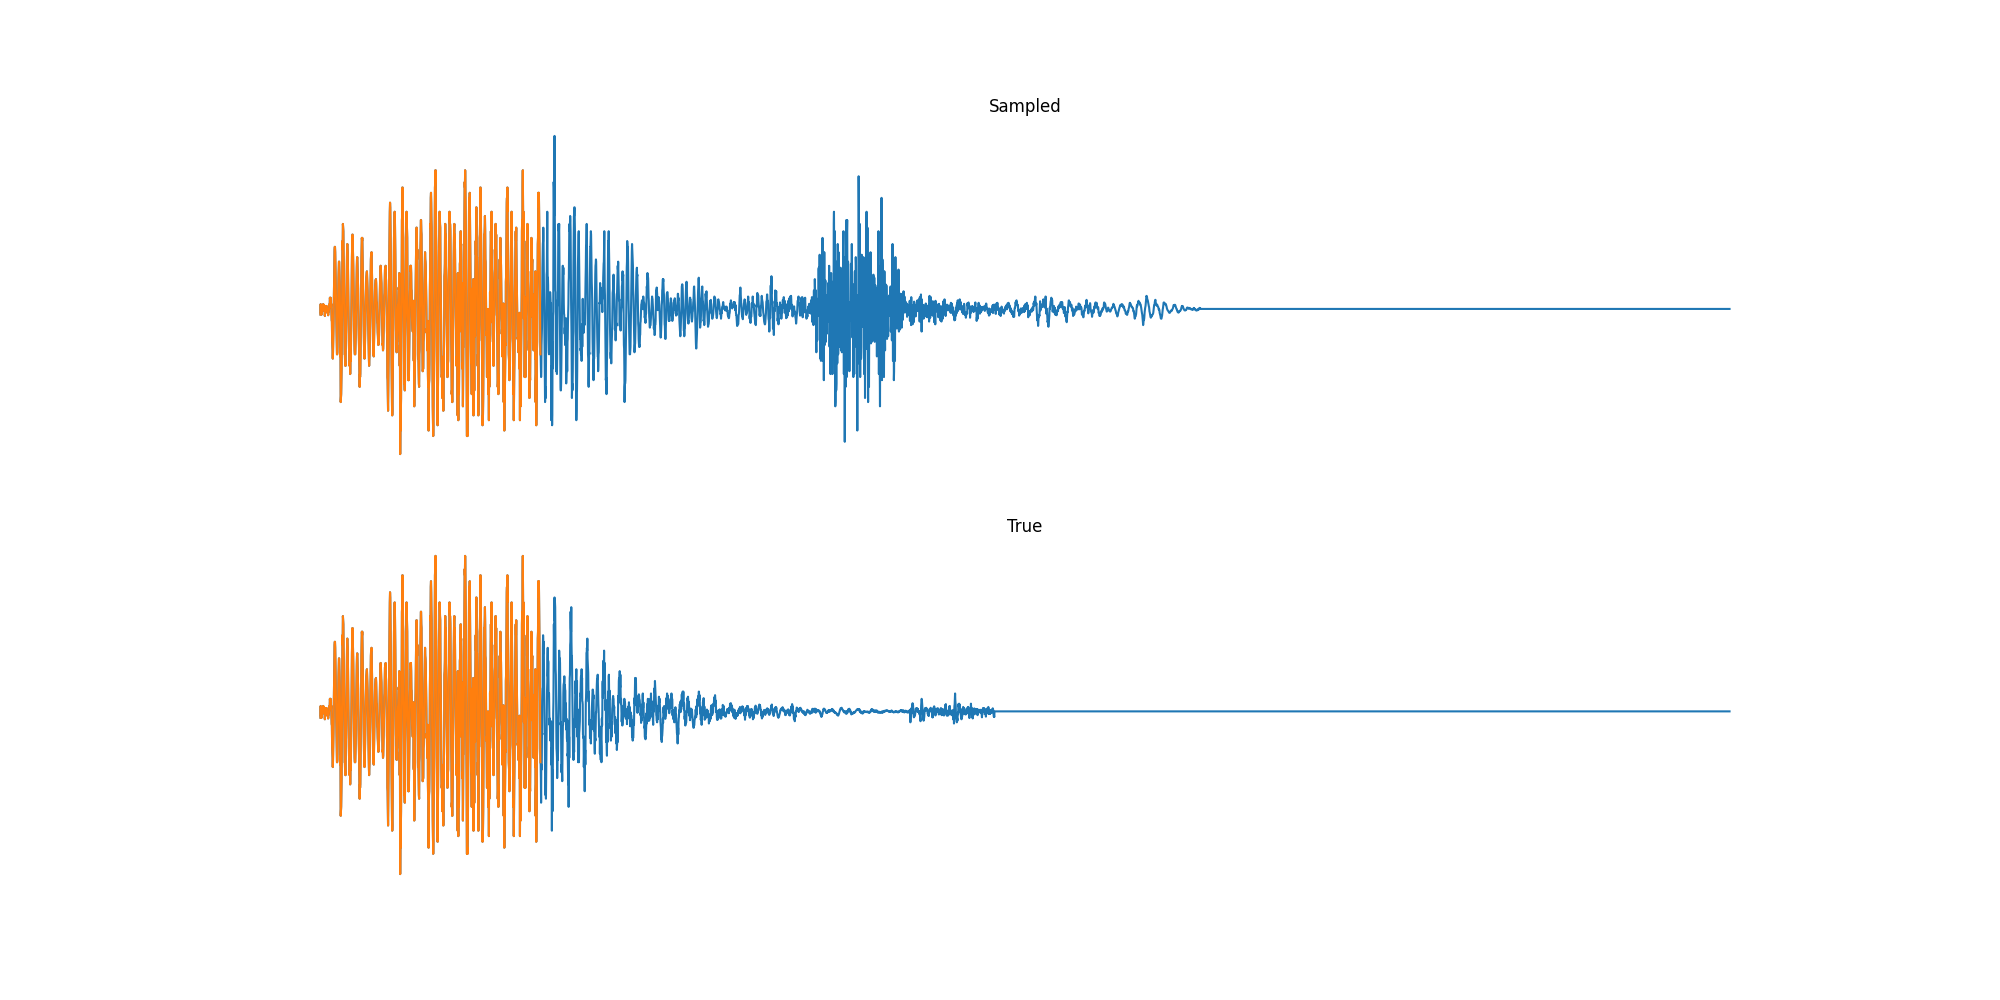
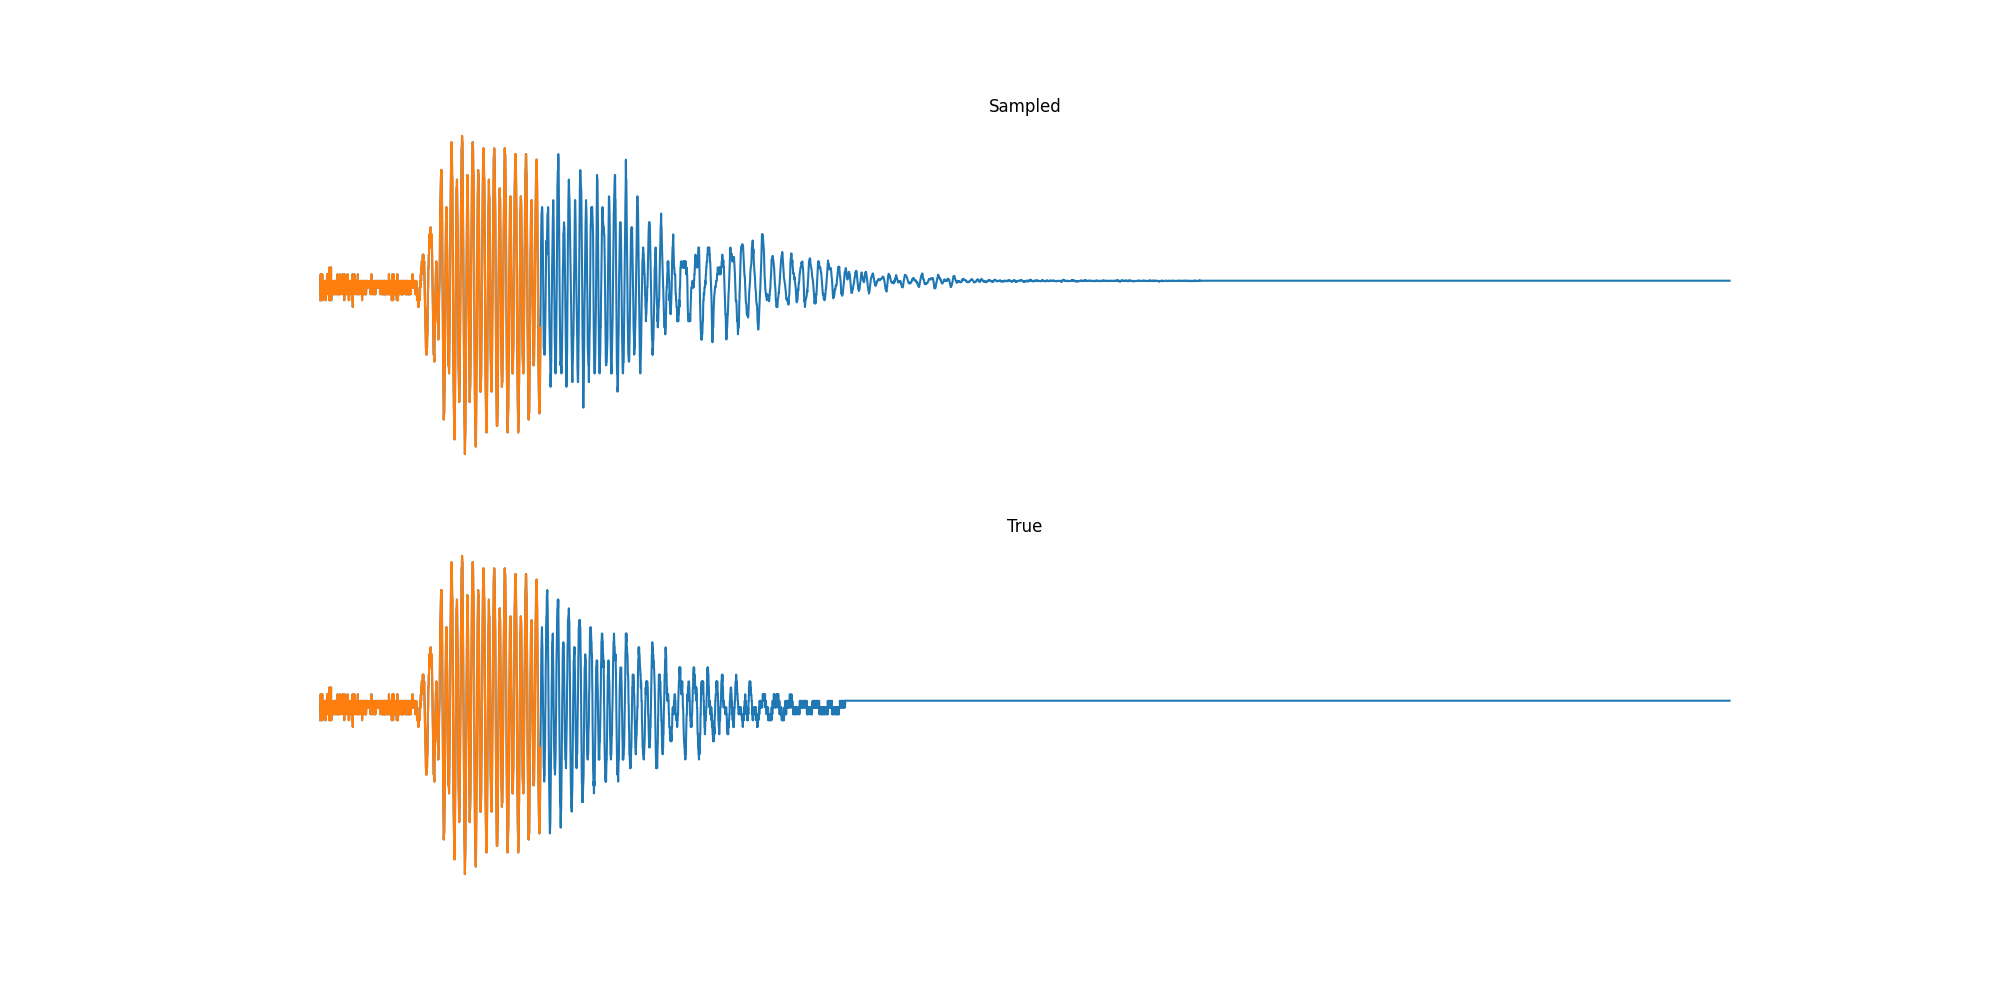
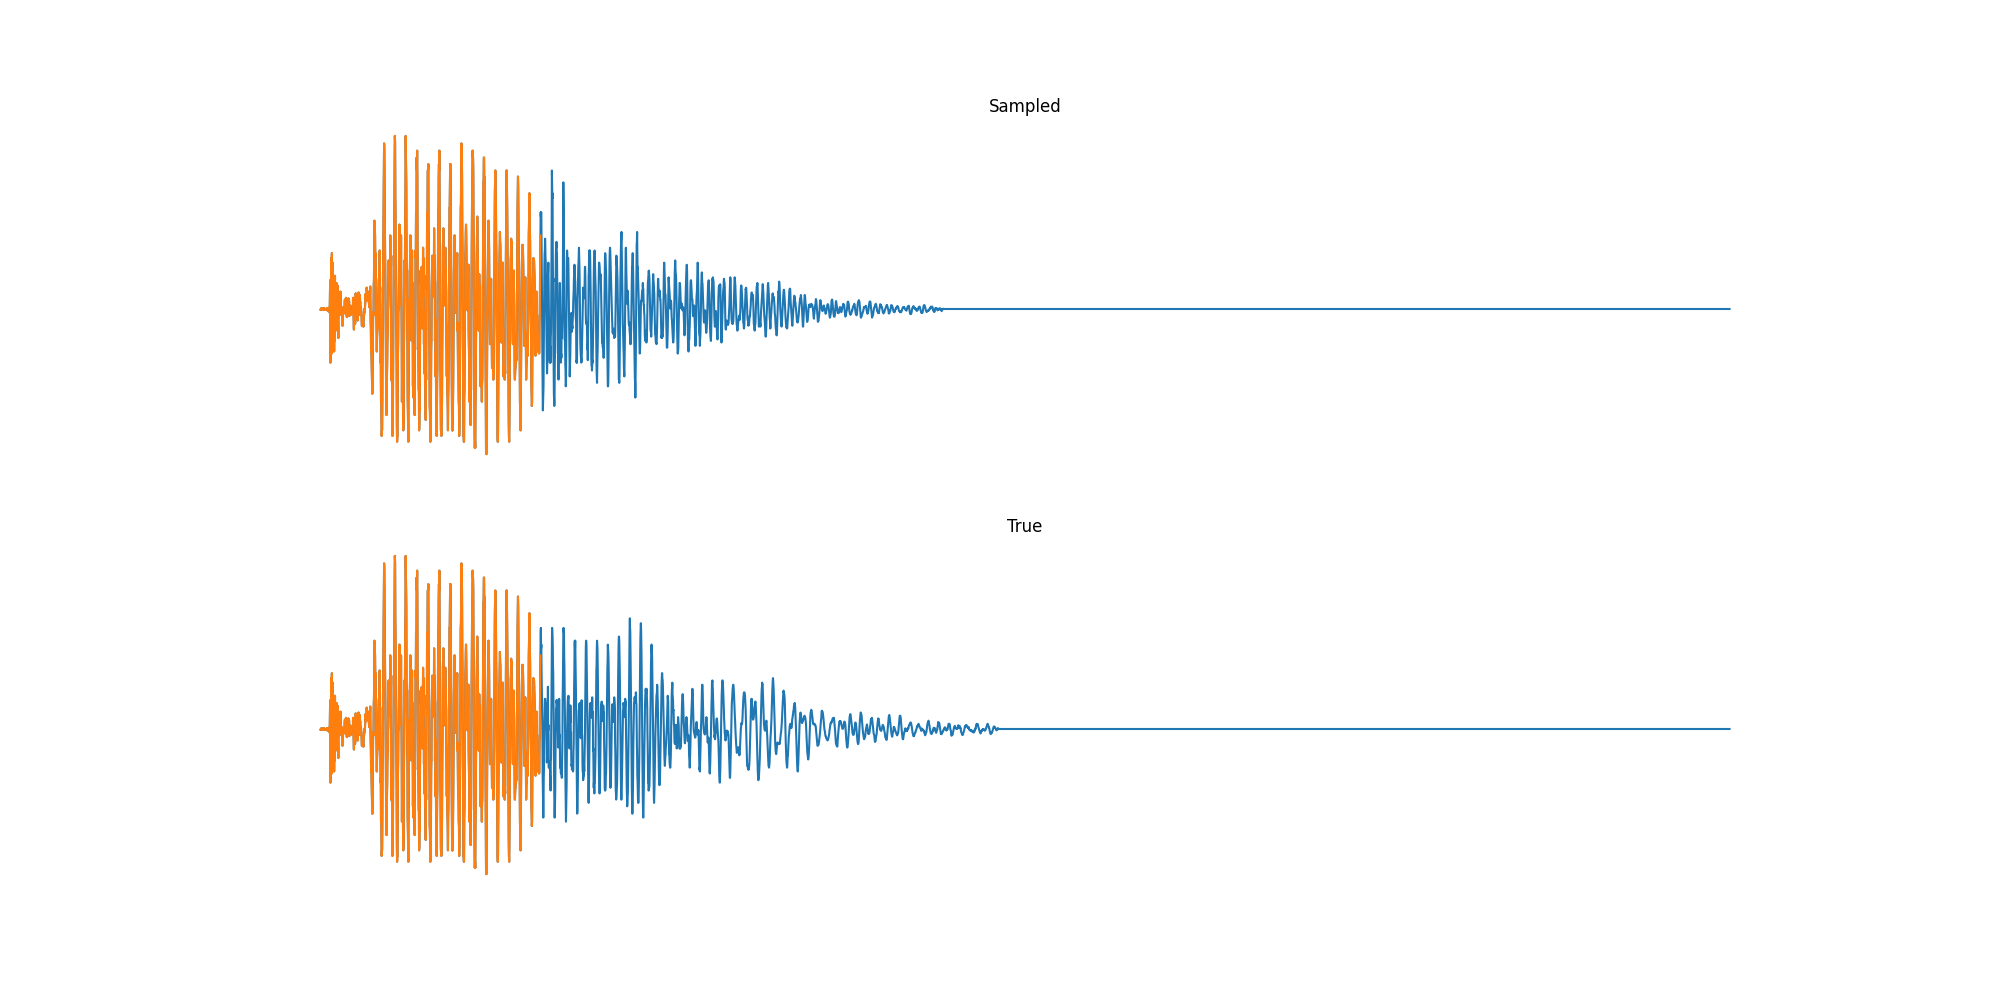
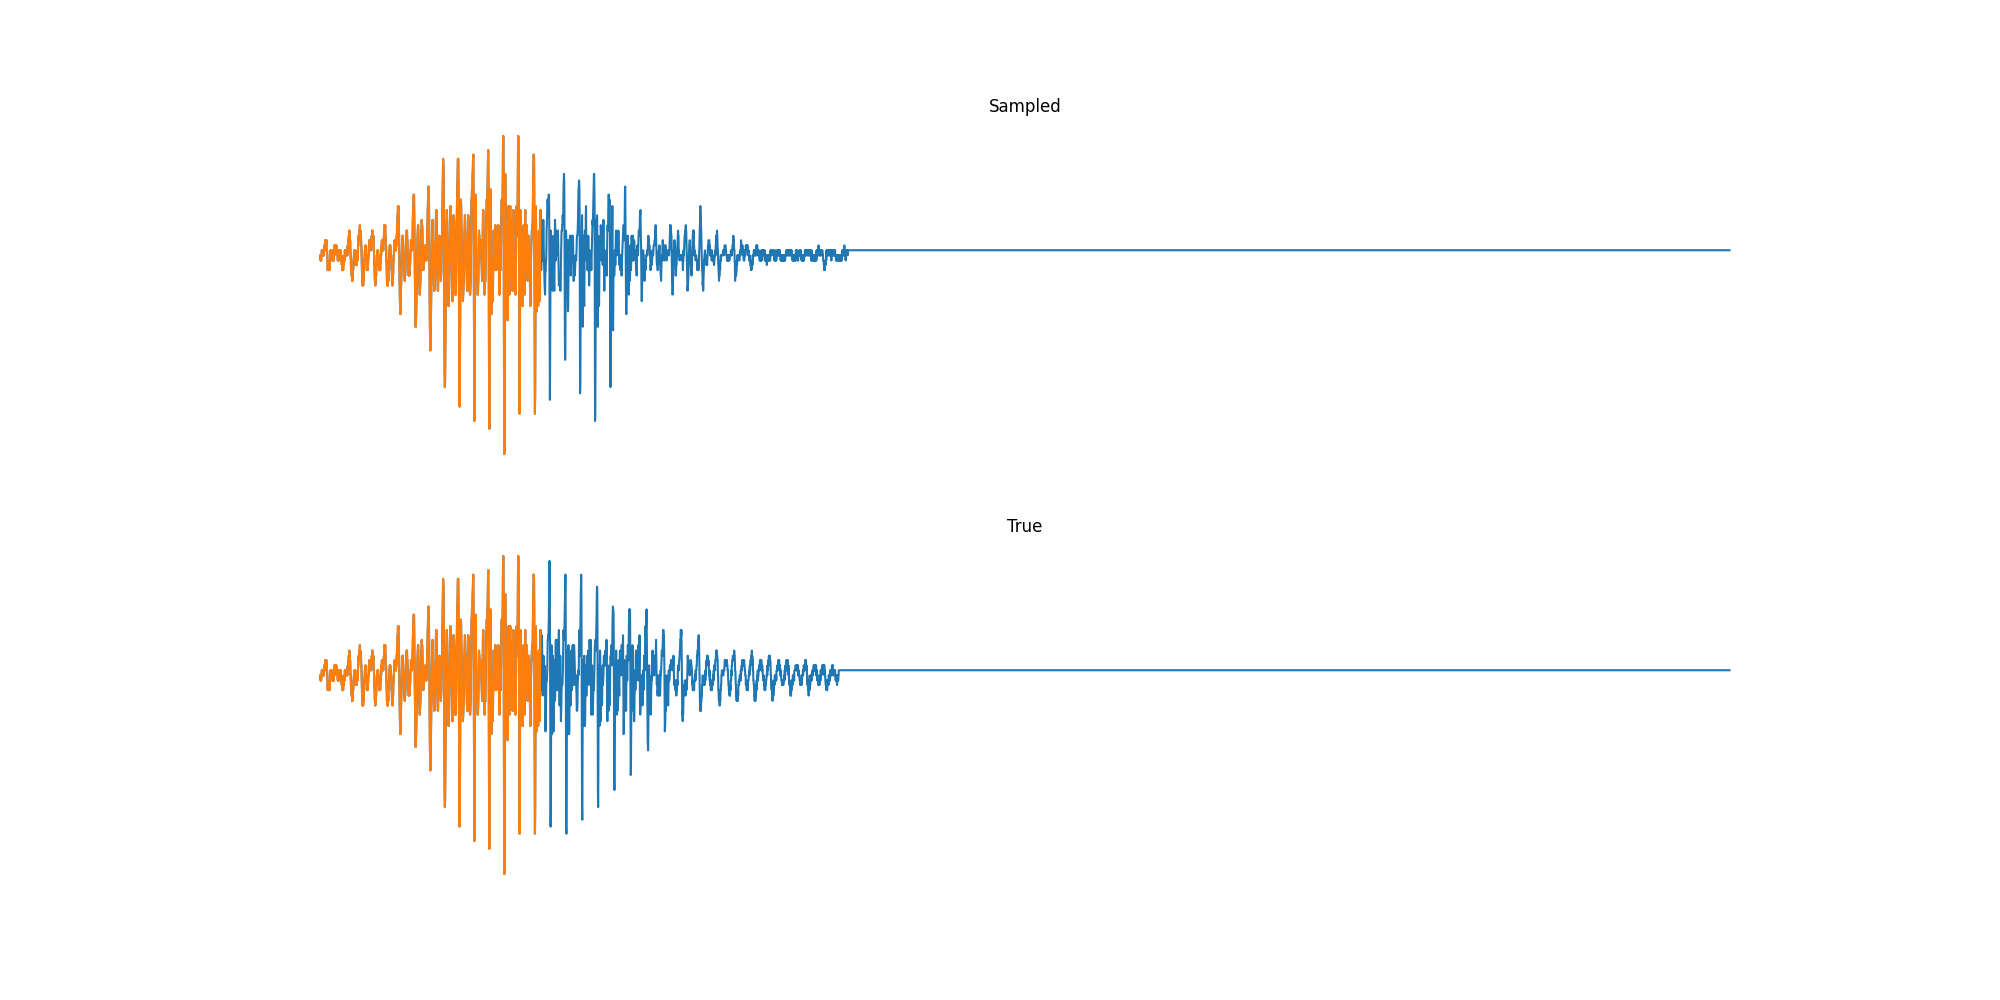
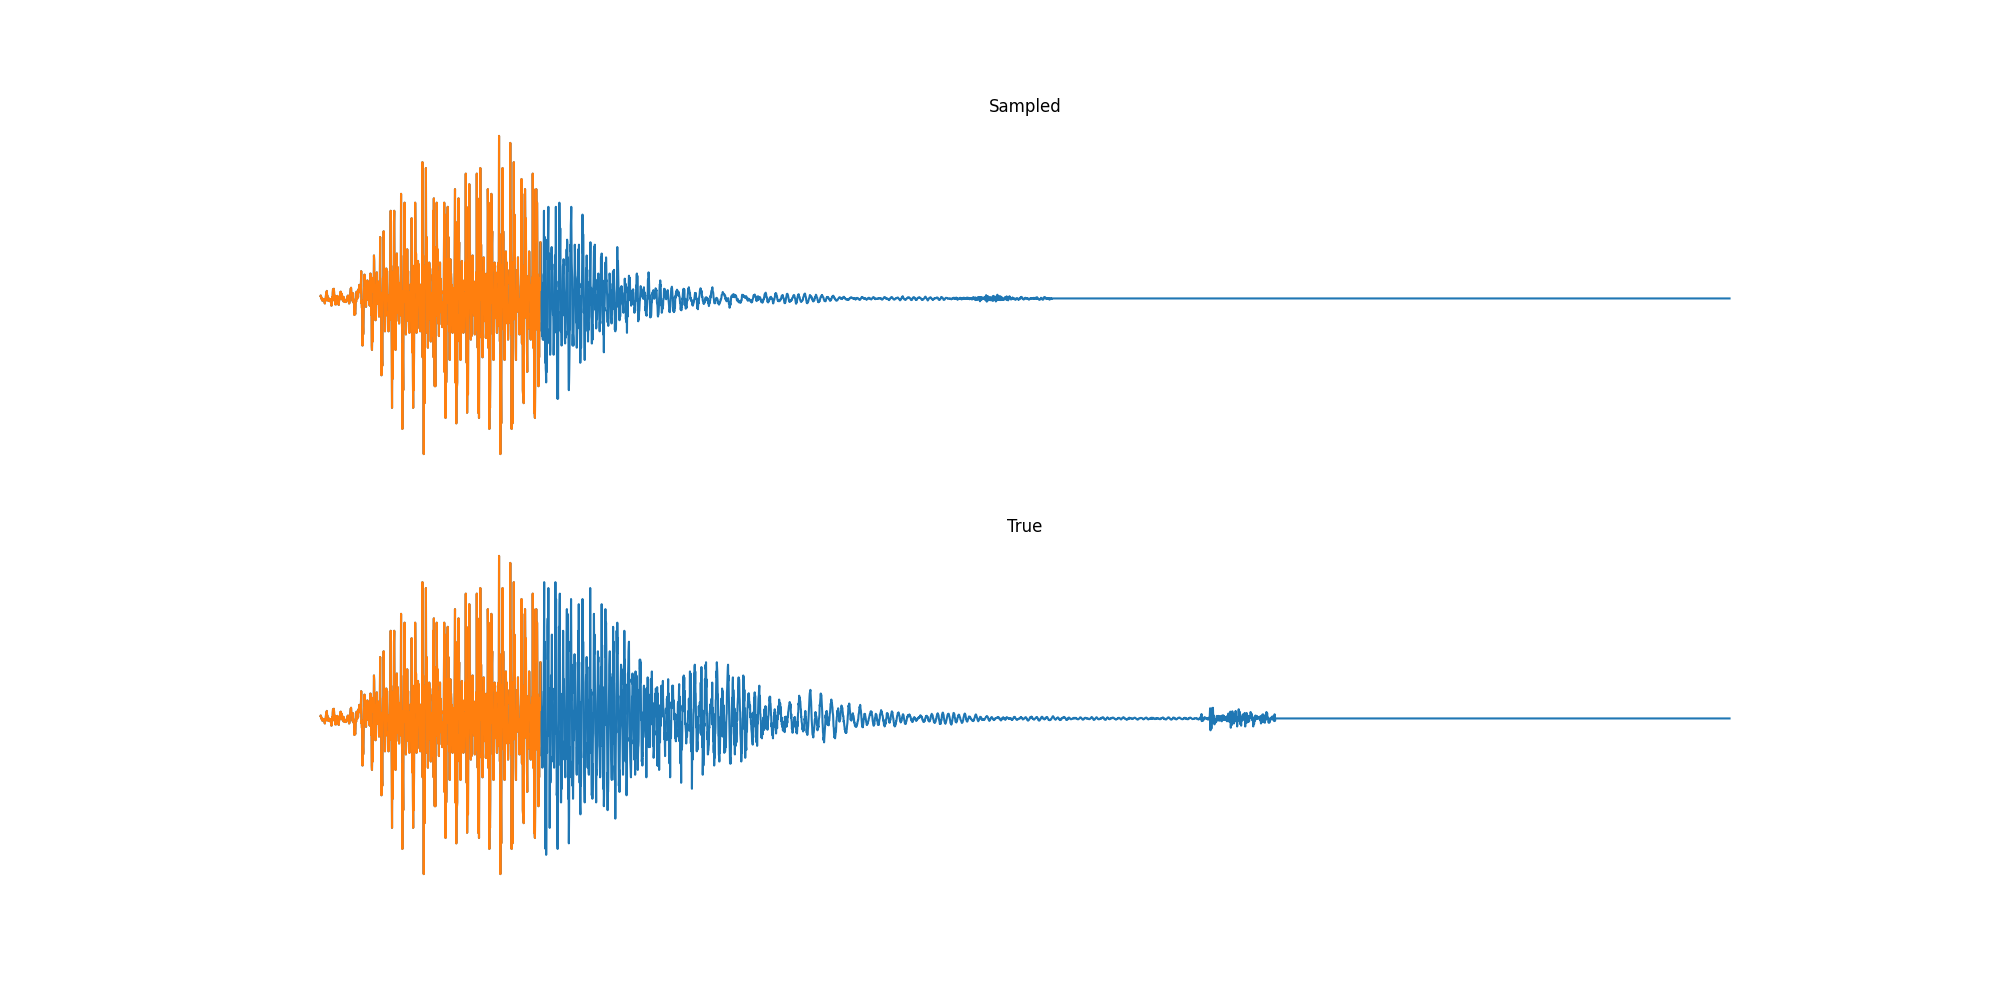
마지막으로 음파를 직접 모델링해 보았습니다. 여기에는 여러 화자가 숫자를 읽은 소리를 모은, MNIST 비슷한 데이터셋인 Free Spoken Digits Datasets를 썼습니다. 먼저 분류 모델을 학습했더니, 날것의 음파만으로 정확도에 이를 수 있었습니다. 다음으로 음파를 직접 만들어 내는 생성 모델을 학습했습니다. 로 하니 모델이 데이터를 꽤 잘 잡아내는 것 같았습니다. 이 데이터셋에는 예제가 3000개 정도밖에 없지만, 모델은 (잘된 것만 골라 보면) 꽤 괜찮은 이어지는 소리를 만들어 냅니다. 이 시퀀스들은 8kHz 샘플링 속도에서 길이가 6400단계이고, 뮤 법칙 인코딩으로 256개 클래스로 이산화했다는 점도 알아 두세요.
저희의 전체 코드베이스에는 생성과 분류 모델을 학습하기 위한 예제와 기반 코드가 더 많이 들어 있습니다.
맺음말
이 글을 정리하면서 이 분야의 앞으로의 연구에 대해 많은 생각이 떠올랐습니다. 한 가지 분명한 결론은, 먼 거리를 다루는 모델은 음향 모델링부터 유전체 서열, 궤적까지(저희가 함께 몸담은 자연어 처리는 말할 것도 없고) 앞으로 온갖 곳에 쓰일 수 있다는 것입니다. 또 하나는 선형 모델이 여기서 이렇게 효과적일 수 있다는 놀라움인데, 이 덕분에 여러 효율적인 기법의 길도 열립니다. 마지막으로 실용적인 측면에서, JAX의 변환 기능 덕분에 이렇게 복잡한 모델을 아주 간결하게(약 200줄) 구현하면서도 효율과 성능은 비슷하게 낼 수 있다는 점이 정말 좋았습니다!
이 글을 정리하는 데 큰 도움을 준 논문 저자 앨버트 구와 커런 고얼에게 감사드리며, 두 사람의 논문과 코드베이스를 다시 한번 소개합니다. 기여해 준 안킷 굽타, 에킨 아퀴레크, 친성 장, 네이선 얀, 쥔슝 왕에게도 감사드립니다. 이 글에 도움이 되는 의견을 준 코너 버셀리노와 로럴 오어에게도 고마운 마음을 전합니다.
사샤와 시드 드림
변경 기록
- v3
- 앨버트가 전체를 크게 손봤습니다.
- HiPPO 계산의 버그를 고쳤습니다.
- S4의 모든 파라미터를 학습하도록 했습니다.
- 학습률과 초기화 문제를 고쳤습니다.
- v2
- RNN 디코딩을 더했습니다.
- 말소리 예제를 더했습니다.
- v1: 처음 버전
라이선스 고지
원문은 MIT 라이선스로 공개되어 있습니다. 아래는 원문 저장소(srush/annotated-s4)의 저작권 표시와 허가 문구 전문입니다.
Copyright (c) 2023 Sasha Rush
Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the "Software"), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions:
The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software.
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.