Stella Biderman 외: 회전 임베딩: 상대 위치의 혁명Stella Biderman et al.: Rotary Embeddings: A Relative Revolution
토큰 임베딩을 복소수로 보고 위치를 회전으로 걸어 절대 위치와 상대 위치 방식을 하나로 묶는 회전 위치 임베딩(RoPE)을 직관, 유도, 구현 코드, GPT-NeoX와 Mesh Transformer JAX 실험, 실행 시간까지 차례로 살펴본 EleutherAI의 글Rotary Positional Embedding (RoPE) is a new type of position encoding that unifies absolute and relative approaches. We put it to the test.
Contents목차
번역문 · 원저자: Stella Biderman, Sid Black, Charles Foster, Leo Gao, Eric Hallahan, Horace He, Ben Wang, Phil Wang (EleutherAI) · 원문: Rotary Embeddings: A Relative Revolution · 원문 라이선스: CC BY 4.0. 원문을 한국어로 옮긴 것 말고는 내용을 바꾸지 않았습니다. 원문 글쓴이들이 만든 그림은 글과 같은 CC BY 4.0을 따르므로 실었습니다.
원문: 「Rotary Embeddings: A Relative Revolution」, Stella Biderman, Sid Black, Charles Foster, Leo Gao, Eric Hallahan, Horace He, Ben Wang, Phil Wang, EleutherAI 블로그, https://blog.eleuther.ai/rotary-embeddings/, 2021년 4월 20일 게시. 이 글은 원문을 한국어로 옮긴 번역문입니다.
라이선스: 원문 사이트 바닥글에 “웹사이트는 CC BY 4.0 라이선스를 따른다”고 적혀 있습니다. 이 번역도 원저작자를 밝히고 CC BY 4.0 조건에 따라 싣습니다. 원문의 파장판 그림은 마우스로 정육면체를 끌어 돌려 볼 수 있는 대화형 3D 그림이라, 이 글에는 한 장면을 그림 파일로 저장해 실었고 움직이는 모습은 원문에서 볼 수 있습니다. 코드는 원문 그대로 두었습니다.
회전 위치 임베딩은 절대 위치 방식과 상대 위치 방식을 하나로 묶는 새로운 위치 인코딩입니다. 저희가 직접 시험해 보았습니다.
요약
회전 위치 임베딩(Rotary Positional Embedding, RoPE)은 절대 위치 방식과 상대 위치 방식을 하나로 묶는 새로운 위치 인코딩입니다. 올해 초 쑤젠린이 몇 편의 블로그 글 [12, 13]과 새 프리프린트 [14]에서 내놓은 방법으로, 중국 NLP 커뮤니티 일부에서는 이미 큰 관심을 모았습니다. 이 글은 저희가 이해한 대로 이 방법을 차근차근 설명해, 더 넓은 학계에 알리려는 것입니다. 일반 셀프 어텐션, 선형 셀프 어텐션, 국소 셀프 어텐션을 비롯한 여러 설정에서 시험해 본 결과, RoPE는 트랜스포머에 위치 정보를 넣는 지금까지의 모든 방법과 비슷하거나 더 나았습니다.
무엇이 문제일까요?
Vaswani 등(2017) [16] 이후로 트랜스포머에 위치 정보를 인코딩하는 방식이 많이 나왔습니다. 어떤 분야에 셀프 어텐션을 쓸 때, 위치 인코딩을 고르는 일은 대개 단순함, 유연함, 효율 사이에서 무엇을 내줄지 정하는 일입니다. 예를 들어 학습된 절대 위치 인코딩은 아주 단순하지만, 일반화가 잘 되지 않을 수 있습니다. 또 짧은 문장과 구를 한 컨텍스트에 모아 담고 문장을 여러 컨텍스트에 걸쳐 나누는 흔한 관행 [1, 3, 9, 15] 때문에, 그 위치값이 늘 뚜렷한 의미를 갖는 것도 아닙니다.
기존 방법의 또 다른 큰 한계는 효율적인 트랜스포머와 함께 쓸 수 없다는 점입니다. T5의 상대 위치 편향 [10] 같은 방법은 위치들 사이의 어텐션 행렬 전체를 만들어야 하는데, FAVOR+ [2] 같은 커널화 방식을 비롯해 소프트맥스 어텐션을 대신하는 효율적인 방식 다수에서는 그렇게 할 수 없습니다.
원리가 분명하고, 구현하기 쉽고, 두루 쓸 수 있는 상대 위치 인코딩, 그러니까 일반 어텐션과 “효율적인” 어텐션 모두에서 작동하는 방법이 있다면 아주 반가운 일입니다. 회전 위치 임베딩은 바로 이런 필요를 채우려고 설계되었습니다.
해법은 무엇일까요?
이 절에서는 회전 위치 임베딩을 소개하고 유도합니다. 먼저 직관을 이야기한 다음, 전체 유도 과정을 보여 드리겠습니다.
직관
항목 와 그 위치 에 대한 위치 인코딩 함수 을 찾고 싶다고 합시다. 조건은 이렇습니다. 위치 과 에 있는 두 항목 와 에 대해, 과 의 내적이 와 의 값, 그리고 둘의 상대 위치 에만 좌우되어야 합니다. 발상으로 보면 커널 트릭과 닮았습니다. 커널이 특정한 성질을 갖도록 하는 특징 사상을 찾는 것이기 때문입니다. 여기서 열쇠가 되는 정보는 유클리드 벡터 내적의 기하학적 정의입니다.
쉽게 말해 두 벡터의 내적은 각 벡터의 크기와 두 벡터 사이의 각도로 정해집니다. 이 점을 떠올리면 RoPE의 직관은 이렇습니다. 토큰 임베딩을 복소수로 나타내고, 위치는 그 복소수에 적용하는 순수한 회전으로 나타낼 수 있다는 것입니다. 쿼리와 키를 같은 만큼 옮기면, 곧 절대 위치는 바꾸되 상대 위치는 그대로 두면, 유도 과정에서 보겠지만 두 표현이 똑같은 방식으로 추가로 회전합니다. 그래서 둘 사이의 각도는 그대로이고, 내적도 그대로입니다. 회전의 이런 성질을 이용하면, 셀프 어텐션에 쓰는 내적이 우리가 바라는 성질을 갖게 됩니다. 상대 위치 정보는 지키고 절대 위치는 버리는 성질입니다.
아래는 RoPE의 핵심 발상을 보여 주는 예입니다. 더 엄밀한 유도는 다음 절에서 하겠습니다. 을 최대 시퀀스 길이라 할 때, 인 임의의 을 하나 고릅니다. 와 를 원소별로, 를 원소 번호로 놓고 보면 RoPE는 다음과 같이 볼 수 있습니다.
눈으로 보는 직관
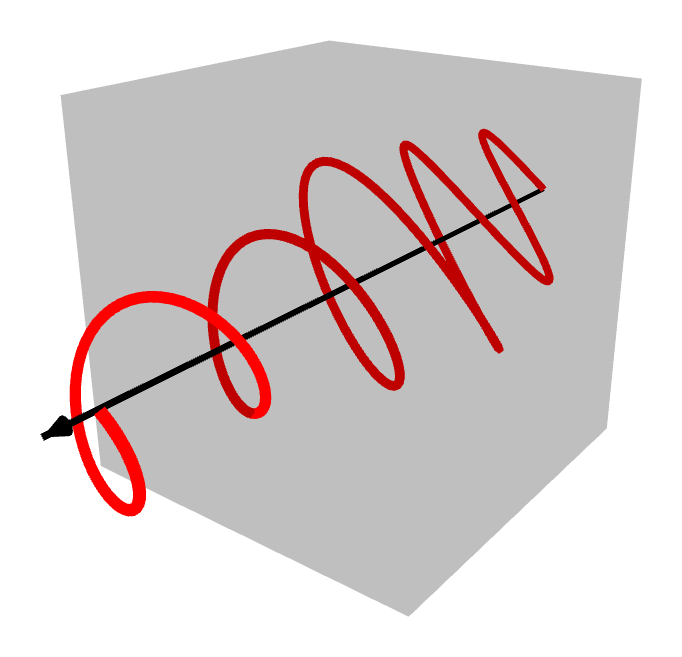
1/4 파장판은 전자기파의 편광 상태를 바꿀 수 있습니다. (원문에서는 이 그림을 직접 움직여 볼 수 있습니다. 정육면체를 끌어 보세요!)
이 변환에서 상대 위치가 어떻게 보존되는지 알아보려면, 고전 전기역학의 비슷한 상황을 떠올려 볼 수 있습니다.
선형 편광된 전자기파를 45도 각도로 놓인 1/4 파장판에 통과시킨다고 상상해 봅시다. 파장판은 들어온 파동이 나아가는 동안 한 주축 방향의 위상만 어긋나게 합니다. 파동이 파장판을 빠져나올 때면 편광은 더는 선형이 아닙니다. 1/4 주기만큼 위상이 어긋나 원 편광이 된 것입니다.
파동이 파장판을 지나가는 모습을 보면, 파동의 크기가 보존된다는 것을 알 수 있습니다. 또 상대 위치가 이어지는 시간 단계 사이의 각도로 어떻게 인코딩될 수 있는지도 더 잘 보입니다. 시간 단계 사이의 각도가 일정하고, 따라서 진행 축을 따라 나아간 거리도 일정합니다. 이는 변조된 파동에서 위치 정보가 진폭과 직교해야 한다는 뜻입니다.
유도
절대 위치 정보에서 출발하겠습니다. 토큰마다 시퀀스 안 어디에 있는지는 알고 있습니다. 그런데 내적은(따라서 어텐션은) 절대 위치 정보를 보존하지 않습니다. 그래서 위치 정보를 임베딩의 절대 위치에 담아 두면 상당한 정보를 잃게 됩니다. 반면 내적은 상대 위치를 보존합니다. 따라서 절대 위치 정보를, 상대 위치 정보만 활용하는 방식으로 토큰 임베딩에 인코딩할 수 있다면, 그 정보는 어텐션 함수를 거쳐도 남게 됩니다.
머신러닝에서는 흔히 실수만 다루지만, 회전 임베딩에서는 공간의 기저 체로 복소수를 쓰는 편이 수학적으로 더 편합니다. 늘 쓰던 대신, 쿼리 벡터와 키 벡터의 이웃한 두 원소를 복소수 하나로 보아 에서 작업하겠습니다. 구체적으로, 를 차원 실수 벡터로 보는 대신 로 봅니다. 곧 보겠지만, 이렇게 바꿔 놓으면 회전 임베딩을 이야기하기가 쉬워집니다. 가 홀수이면 가짜 좌표 하나를 덧붙여 짝이 맞게 하면 됩니다. 아니면 그냥 를 1 늘려도 됩니다.
와 를 각각 쿼리 벡터와 키 벡터라 하고, 과 을 해당 토큰의 절대 위치라 합시다. 은 위치 에 있는 토큰 임베딩 를 받아, 상대 위치 정보를 (어떤 식으로든) 담은 새 임베딩을 내놓는 함수라 합시다. 우리 목표는 이 일을 하는 “좋은” 함수 를 찾는 것입니다. 위치 정보를 인코딩하고 나면, 내적을 다음과 같이 계산해야 합니다.
여기서 은 보통의 어텐션 식에서 소프트맥스에 들어가기 전의 로짓을 나타냅니다. 이 세 함수를 지수 형태로 쓰면 다음과 같습니다.
내적을 계산해 대응하는 성분끼리 같다고 놓으면 다음을 얻습니다.
을 대입하고 초기 조건 를 적용하면 다음이 나옵니다.
위 식은 모든 에 대해 성립하므로, 는 의 값과 상관이 없습니다. 그래서 로 놓을 수 있습니다. 마찬가지로 이라 쓰면 다음을 얻습니다.
이는 모든 에 대해 라는 뜻입니다. 그러므로 를 로 분해할 수 있습니다. 인 경우를 살펴보면 다음을 알 수 있습니다.
우변이 에 좌우되지 않으므로 좌변도 그래야 하고, 따라서 는 등차수열입니다. 초기값을 , 로 놓으면 가 됩니다.
이 조각들을 모두 맞추면 회전 위치 임베딩의 최종 식을 얻습니다.
도 마찬가지입니다. 컴퓨터는 복소수보다 실수와 행렬을 더 좋아하는 편이므로, 이 식을 다음 행렬 식으로 바꿔 두면 편합니다.
여기서 이고, 은 블록 대각 회전 행렬, 는 학습된 쿼리 가중치, 은 번째 토큰의 임베딩입니다. 이번에도 에 대해 같은 꼴의 식이 있습니다.
여러 차원으로 넓히기
RoPE는 비교적 쉽게 다차원으로 넓힐 수 있습니다. 2차원을 나타내려면 서로 독립인 1차원 회전 임베딩 두 개를 쓰면 됩니다. 구현할 때는 와 를 각각 반으로 나누고, 다음과 같이 조각별로 회전을 적용하면 됩니다.
이 식은 더 나아가 차원이 몇 개인 데이터로도 넓힐 수 있습니다. 이런 다차원 상대 인코딩을 쓰면, 예를 들어 Music Transformer [4]의 상대 타이밍 임베딩과 상대 음높이 임베딩 같은 것을 훨씬 간단하게 구현할 수 있습니다. 더 일반적으로 말하면, RoPE처럼 첫 원리에서 출발한 위치 코드 덕분에 포착할 수 있게 될 불변성이 꽤 많을 수 있다고 저희는 생각합니다.
「Attention is All You Need」에 나온 사인파 임베딩과는 무엇이 다를까요?
EleutherAI의 많은 사람이 이 방법을 처음 보고 보인 반응이 “사인파 임베딩과 뭐가 다르지?”였습니다. 그래서 이 비교는 짚고 넘어갈 만하다고 생각합니다. 회전 임베딩은 두 가지 점에서 사인파 임베딩과 다릅니다.
- 사인파 임베딩은 좌표 하나하나에 따로 적용되지만, 회전 임베딩은 좌표를 둘씩 짝지어 섞습니다.
- 사인파 임베딩은 나 항을 더하지만, 회전 임베딩은 곱하는 인자를 씁니다.
좋습니다, 그럼 실제로는 어떨까요?
쑤젠린의 원래 블로그 글 [12, 13]을 읽고 나서, 저희는 이렇게 첫 원리에서 출발한 위치 인코딩이 기존 방법들과 견주어 얼마나 잘 버틸지 궁금했습니다. 트랜스포머 구조를 개선했다고 주장하는 논문은 엄청나게 많이 나왔지만, 여러 코드베이스와 작업에 걸쳐 고르게 잘 일반화되는 방법은 아주 드뭅니다. 그런데 저희가 시험해 본 모든 구조에서 회전 위치 임베딩은 다른 위치 기법과 같거나 더 나은 성능을 냈습니다.
구현
회전 위치 임베딩을 순진하게 구현하면 앞에서 본 블록 대각 행렬 형태를 쓰게 됩니다. 실제로 그렇게 구현하면 매우 비효율적이고, 더 최적화된 형태를 쉽게 구할 수 있습니다. RoPE의 원래 구현은 roformer와 bert4keras에 있습니다.
그 밖에 저희도 x-transformers, GPT-Neo, GPT-NeoX, Mesh Transformer JAX에 회전 위치 임베딩을 구현했습니다. 아래는 이 코드베이스들에서 가져온 PyTorch 구현과 JAX 구현입니다.
GPT-NeoX (PyTorch)
import torch


class Rotary(torch.nn.Module):
    def __init__(self, dim, base=10000):
        super().__init__()
        inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2).float() / dim))
        self.register_buffer("inv_freq", inv_freq)
        self.seq_len_cached = None
        self.cos_cached = None
        self.sin_cached = None

    def forward(self, x, seq_dim=1):
        seq_len = x.shape[seq_dim]
        if seq_len != self.seq_len_cached:
            self.seq_len_cached = seq_len
            t = torch.arange(x.shape[seq_dim], device=x.device).type_as(self.inv_freq)
            freqs = torch.einsum("i,j->ij", t, self.inv_freq)
            emb = torch.cat((freqs, freqs), dim=-1).to(x.device)
            self.cos_cached = emb.cos()[:, None, None, :]
            self.sin_cached = emb.sin()[:, None, None, :]
        return self.cos_cached, self.sin_cached


# rotary pos emb helpers:

def rotate_half(x):
    x1, x2 = x[..., : x.shape[-1] // 2], x[..., x.shape[-1] // 2 :]
    return torch.cat(
        (-x2, x1), dim=x1.ndim - 1
    )  # dim=-1 triggers a bug in torch < 1.8.0


@torch.jit.script
def apply_rotary_pos_emb(q, k, cos, sin):
    return (q * cos) + (rotate_half(q) * sin), (k * cos) + (rotate_half(k) * sin)
참고: GPT-NeoX에서는 메모리를 많이 쓰는 전치 연산을 피하려고, Megatron을 따라 쿼리와 키를 [seq, batch, heads, hdim] 배치로 둡니다. 흔히 쓰는 [batch, seq, heads, hdim] 배치에서 쓰려면 코드를 고쳐야 합니다.
Mesh Transformer JAX (JAX)
import jax.numpy as jnp
import numpy as np
from einops import rearrange, repeat


def fixed_pos_embedding(x, seq_dim=0):
    dim = x.shape[-1]
    inv_freq = 1.0 / (10000 ** (np.arange(0, dim, 2) / dim))

    sinusoid_inp = np.einsum("i , j -> i j", np.arange(x.shape[seq_dim]), inv_freq)

    return np.sin(sinusoid_inp), np.cos(sinusoid_inp)


def rotate_every_two(x):
    x1 = x[:, :, ::2]
    x2 = x[:, :, 1::2]

    x = jnp.stack((-x2, x1), axis=-1)

    return rearrange(x, "... d j -> ... (d j)")


def apply_rotary_pos_emb(x, sincos):
    sin, cos = map(lambda t: repeat(t, "b n -> b (n j)", j=2)[:, None, :], sincos)
    return (x * cos) + (rotate_every_two(x) * sin)
참고: Mesh Transformer JAX에서는 쿼리와 키를 [seq, n_head, d_head] 배치로 둡니다(배치 차원이 없습니다).
실험
회전 임베딩은 여러 종류의 어텐션에서 효과가 있었습니다.
전역 어텐션에서 다른 위치 인코딩과 비교
저희는 GPT-NeoX 코드베이스로, 회전 임베딩을 GPT-3 [1]에서 쓴 학습된 절대 위치 임베딩, 그리고 T5 [10]에서 쓴 학습된 상대 위치 임베딩(이하 RPE)과 비교했습니다. 비교에는 파라미터 1억 2,500만 개짜리 모델을 썼고, 하이퍼파라미터는 [1]에 나온 같은 크기 모델과 똑같이 맞췄습니다. 모델은 온라인 텍스트를 크고 다양하게 모은 데이터셋인 OpenWebText2로 학습했습니다. 처리량은 아주 조금 줄었을 뿐인데, 학습 곡선과 검증 곡선이 더 빨리 수렴했고 전체 검증 손실도 더 낮았습니다.
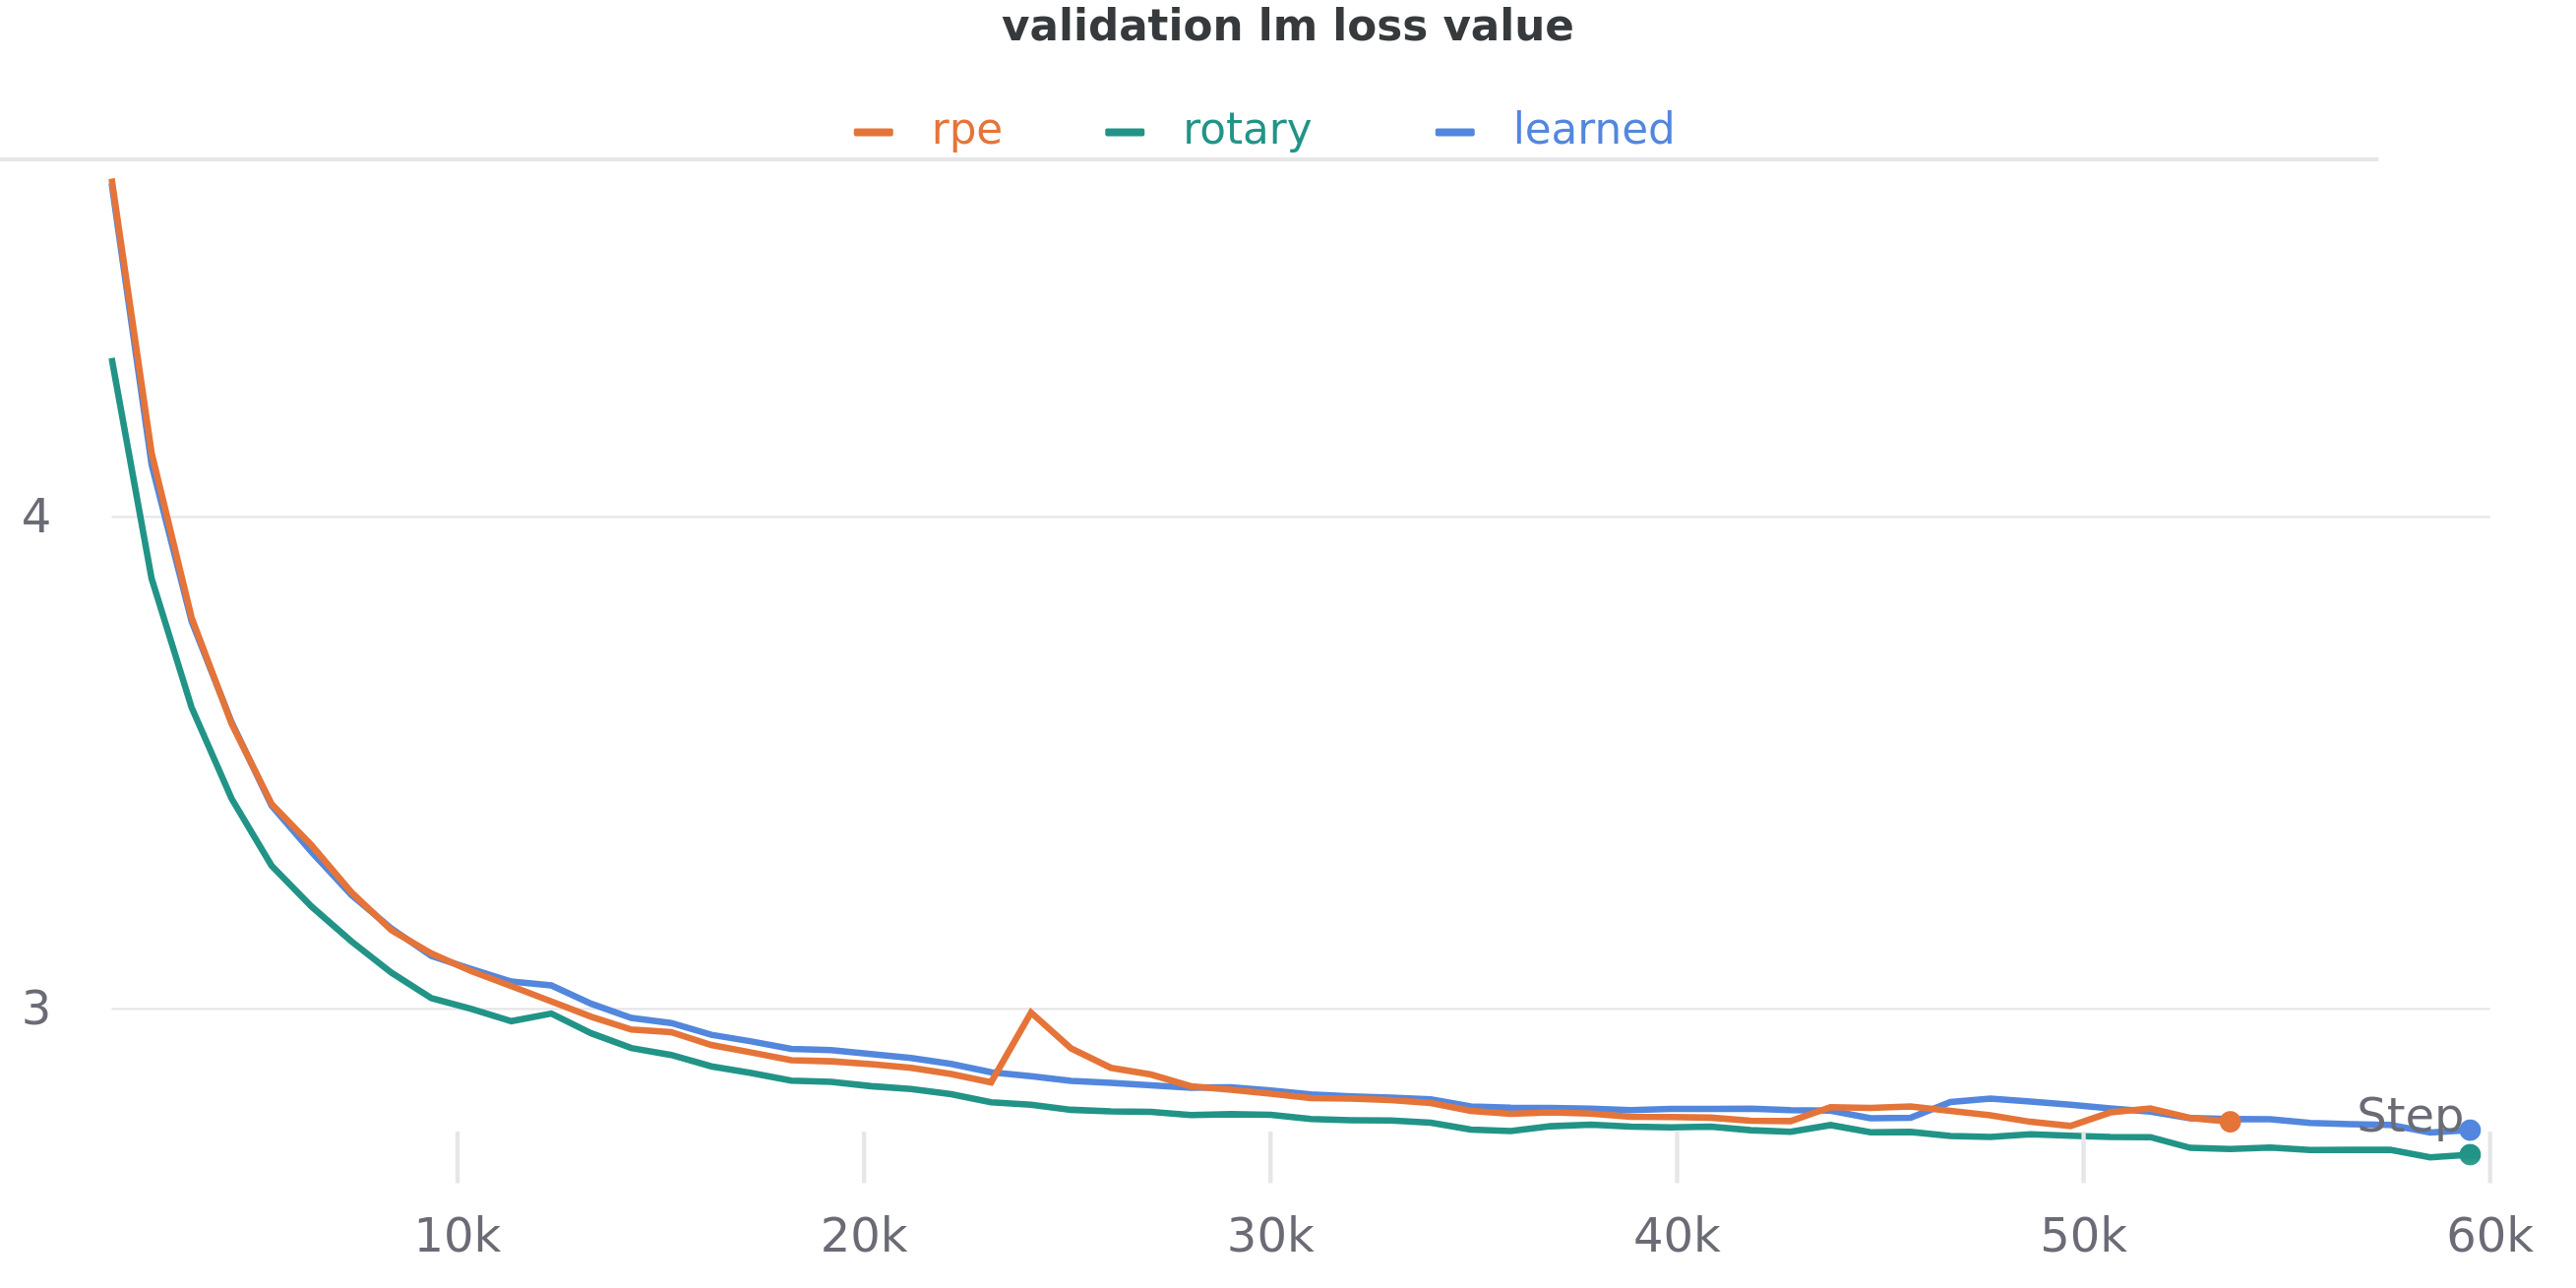
GPT-NeoX에서 파라미터 1억 5,000만 개짜리 모델로 잰 OWT2 검증 손실
| 종류 | OWT2 손실 | OWT2 퍼플렉서티 |
|---|---|---|
| 학습된 절대 위치 | 2.809 | 16.59 |
| T5 RPE | 2.801 | 16.46 |
| 회전 | 2.759 | 15.78 |
5만 5,000 단계(약 300억 토큰)에서 OWT2 검증 세트로 잰 최종 검증 손실과 퍼플렉서티
파라미터 10억 개 이상인 모델
mesh-transformer-jax 코드베이스와 파라미터 14억 개짜리 모델로, 학습된 절대 위치 임베딩과 T5 RPE를 기준선 삼아 더 큰 규모의 실험도 했습니다. 하이퍼파라미터는 GPT-3의 13억 파라미터 모델과 비슷하게 잡았고, 데이터셋은 The Pile [3]을 썼습니다. 학습된 절대 위치 임베딩과 비교하면 앞의 실험처럼 수렴 속도가 빨라졌고(약 30%), T5 상대 위치 인코딩과 비교해도 그보다 작지만 여전히 개선(10~20%)이 있었습니다. 파라미터 10억 개 규모에서도 이 방법이 통한다는 것을 보여 줍니다. 자세한 내용은 여기를 보세요.
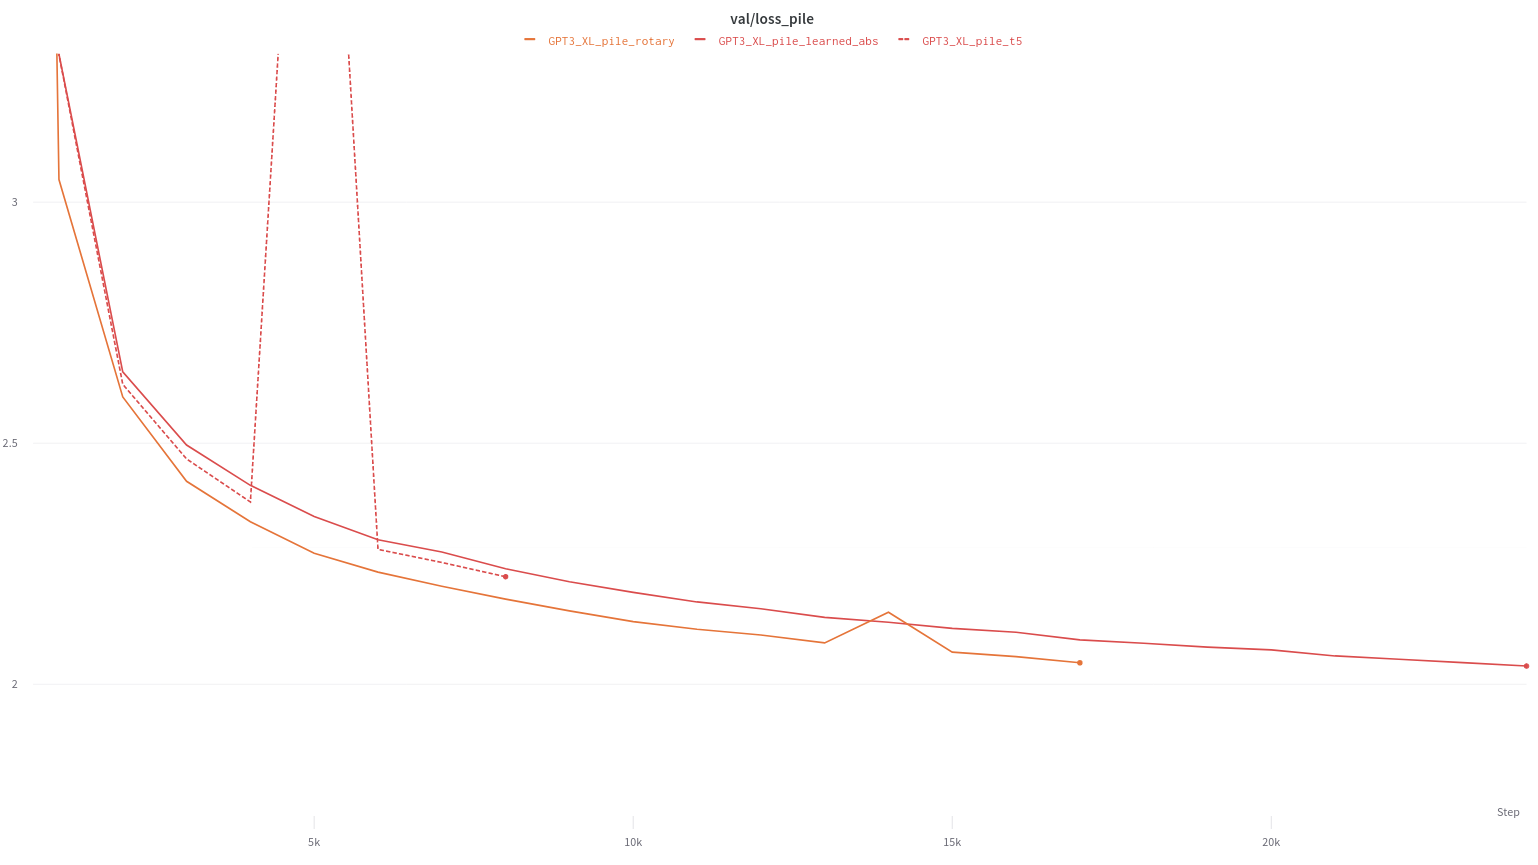
파라미터 15억 개짜리 모델로 잰 Pile 검증 손실
| 종류 | Pile 손실 | Pile 퍼플렉서티 |
|---|---|---|
| 학습된 절대 위치 | 2.240 | 9.393 |
| T5 RPE | 2.223 | 9.234 |
| 회전 | 2.173 | 8.784 |
8,000 단계(약 80억 토큰)에서 Pile 검증 세트로 잰 최종 검증 손실과 퍼플렉서티
Performer에서 학습된 절대 위치 임베딩과 비교
Performer [2]는 시퀀스 길이에 대해 제곱으로 늘어나는 병목을 피하도록 설계된 대안 어텐션 메커니즘의 한 예입니다. 저희는 enwik8에서 Performer를 작은 규모로 시험했습니다. 층 8개, 차원 512, 헤드 8개인 글자 단위 트랜스포머입니다. 시험 결과, Performer에 회전 임베딩을 넣으면 검증 손실이 확연히 줄고 수렴도 빨라졌습니다. 이 개선만으로 효율적인 어텐션과 제곱 어텐션 사이의 격차가 메워지지는 않지만, 이 정도로 큰 개선이라면 Performer 같은 메커니즘이 더 매력적이 됩니다.
더 작은 규모의 시험에서는 RoPE를 Shaw 등의 상대 위치 방법 [11], TUPE [5], 위치 주입 어텐션(position-infused attention) [8] 같은 다른 대안과도 맞붙여 보았는데, 모든 비교에서 좋은 결과를 얻었습니다.
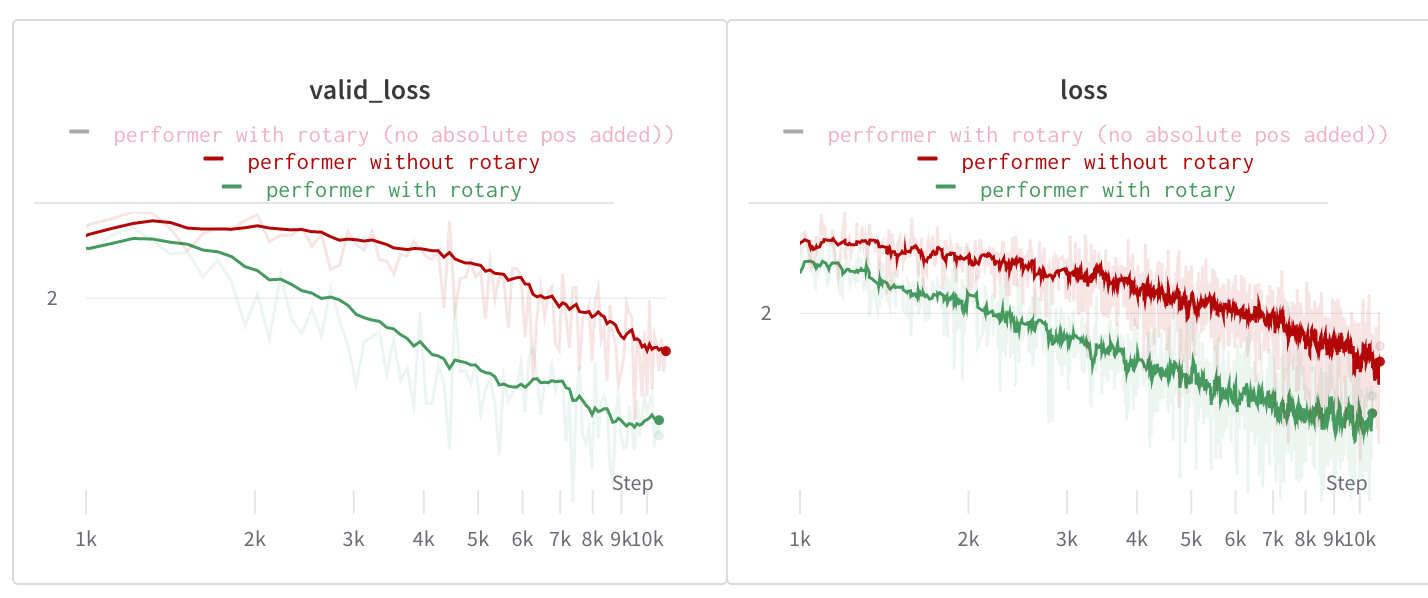
Performer로 잰 enwik8 검증 손실과 학습 손실
실행 시간
대체로 회전 임베딩의 실행 시간 비용은 무시할 만한 수준이었습니다. 위 구현으로 회전 임베딩을 아무 최적화 없이 적용하면, 덧셈식 위치 임베딩을 적용할 때보다 4~5배쯤 비용이 듭니다. Torchscript 같은 융합 최적화기를 더하면, 실행 시간을 덧셈식 위치 임베딩의 2~2.5배 정도로 줄일 수 있습니다. 구체적으로, 모양이 인 쿼리 텐서와 키 텐서에 회전 임베딩을 적용하는 데는 5.3밀리초가 걸리고, 덧셈식 위치 임베딩을 적용하는 데는 2.1밀리초가 걸립니다.
다만 표준 위치 임베딩과 달리 회전 임베딩은 층마다 적용해야 합니다. 큰 트랜스포머 모델은 대개 행렬 곱셈이 시간을 거의 다 차지하므로, 전체 부담은 여전히 무시할 만한 수준이었습니다. 융합을 쓰면 여러 크기의 트랜스포머에서 회전 임베딩이 더하는 부담은 1~3%였습니다.
마무리
회전 임베딩을 쓰면 상대 어텐션을 간단하고 효율적으로 구현할 수 있습니다. 이 방법이 앞으로 어떤 연구에 영감을 줄지 기대됩니다. 서로 다른 종류의 셀프 어텐션 사이에서도 탄탄하게 이어지는, 트랜스포머 구조의 단순한 개선은 무척 드뭅니다 [6].
인용 정보
RoPE 방법론을 인용하려면 다음을 써 주세요.
@article{rope-paper,
  title={RoFormer: Enhanced Transformer with Rotary Position Embedding},
  author={Su, Jianlin and Lu, Yu and Pan, Shengfeng and Wen, Bo and Liu, Yunfeng},
  journal={arXiv preprint arXiv:2104.09864},
  year={2021}
}
이 블로그 글을 인용하려면 다음을 써 주세요.
@misc{rope-eleutherai,
  title = {Rotary Embeddings: A Relative Revolution},
  author = {Biderman, Stella and Black, Sid and Foster, Charles and Gao, Leo and Hallahan, Eric and He, Horace and Wang, Ben and Wang, Phil},
  howpublished = \url{blog.eleuther.ai/},
  year = {2021}
}
참고 문헌
[1] Tom B Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language Models are Few-Shot Learners. arXiv preprint arXiv:2005.14165, 2020.
[2] Krzysztof Choromanski, Valerii Likhosherstov, David Dohan, Xingyou Song, Andreea Gane, Tamas Sarlos, Peter Hawkins, Jared Davis, Afroz Mohiuddin, Lukasz Kaiser, et al. Rethinking Attention with Performers. arXiv preprint arXiv:2009.14794, 2020.
[3] Leo Gao, Stella Biderman, Sid Black, Laurence Golding, Travis Hoppe, Charles Foster, Jason Phang, Horace He, Anish Thite, Noa Nabeshima, et al. The Pile: An 800GB Dataset of Diverse Text for Language Modeling. arXiv preprint arXiv:2101.00027, 2021.
[4] Cheng-Zhi Anna Huang, Ashish Vaswani, Jakob Uszkoreit, Noam Shazeer, Ian Simon, Curtis Hawthorne, Andrew M Dai, Matthew D Hoffman, Monica Dinculescu, and Douglas Eck. Music Transformer. arXiv preprint arXiv:1809.04281, 2018.
[5] Guolin Ke, Di He, and Tie-Yan Liu. Rethinking Positional Encoding in Language Pre-training. arXiv preprint arXiv:2006.15595, 2020.
[6] Sharan Narang, Hyung Won Chung, Yi Tay, William Fedus, Thibault Fevry, Michael Matena, Karishma Malkan, Noah Fiedel, Noam Shazeer, Zhenzhong Lan, et al. Do Transformer Modifications Transfer Across Implementations and Applications? arXiv preprint arXiv:2102.11972, 2021.
[7] Deepak Narayanan, Mohammad Shoeybi, Jared Casper, Patrick LeGresley, Mostofa Patwary, Vijay Korthikanti, Dmitri Vainbrand, Prethvi Kashinkunti, Julie Bernauer, Bryan Catanzaro, et al. Efficient Large-Scale Language Model Training on GPU Clusters. arXiv preprint arXiv:2104.04473, 2021.
[8] Ofir Press, Noah A Smith, and Mike Lewis. Shortformer: Better Language Modeling using Shorter Inputs. arXiv preprint arXiv:2012.15832, 2020.
[9] Alec Radford, Jong Wook Kim, Chris Hallacy, Aditya Ramesh, Gabriel Goh, Sandhini Agarwal, Girish Sastry, Amanda Askell, Pamela Mishkin, Jack Clark, et al. Learning Transferable Visual Models From Natural Language Supervision. arXiv preprint arXiv:2103.00020, 2021.
[10] Colin Raffel, Noam Shazeer, Adam Roberts, Katherine Lee, Sharan Narang, Michael Matena, Yanqi Zhou, Wei Li, and Peter J Liu. Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. arXiv preprint arXiv:1910.10683, 2019.
[11] Peter Shaw, Jakob Uszkoreit, and Ashish Vaswani. Self-Attention with Relative Position Representations. arXiv preprint arXiv:1803.02155, 2018.
[12] Jianlin Su. 让研究人员绞尽脑汁的 Transformer 位置编码(연구자들의 머리를 쥐어짜게 한 트랜스포머 위치 인코딩). https://kexue.fm/archives/8130, 2021. [Online; accessed 18-April-2021].
[13] Jianlin Su. Transformer 升级之路:2、博采众长的旋转式位置编码(트랜스포머 업그레이드의 길 2: 여러 장점을 두루 취한 회전식 위치 인코딩). https://kexue.fm/archives/8265, 2021. [Online; accessed 18-April-2021].
[14] Jianlin Su, Yu Lu, Shengfeng Pan, Bo Wen, and Yunfeng Liu. RoFormer: Enhanced Transformer with Rotary Position Embedding. arXiv preprint arXiv:2104.09864, 2021.
[15] Hao Tan and Mohit Bansal. Vokenization: Improving Language Understanding with Contextualized, Visual-Grounded Supervision. arXiv preprint arXiv:2010.06775, 2020.
[16] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Lukasz Kaiser, and Illia Polosukhin. Attention Is All You Need. arXiv preprint arXiv:1706.03762, 2017.