Chris Olah 외: 줌 인: 회로 입문Chris Olah et al.: Zoom In: An Introduction to Circuits
뉴런 사이의 연결을 들여다보면 신경망의 가중치 안에서 의미 있는 알고리즘을 찾을 수 있다는 주장을, 특징, 회로, 보편성이라는 세 가지 추측 주장으로 풀어 쓴 Distill 회로 스레드의 첫 글By studying the connections between neurons, we can find meaningful algorithms in the weights of neural networks.
Contents목차
- 목차
- 들어가며
- 세 가지 추측 주장
- 주장 1: 특징
- 예 1: 곡선 검출기
- 논거 1: 특징 시각화
- 논거 2: 데이터셋 예시
- 논거 3: 합성 예시
- 논거 4: 결합 튜닝
- 논거 5: 특징 구현 (회로 기반 논거)
- 논거 6: 특징 사용 (회로 기반 논거)
- 논거 7: 손으로 쓴 회로 (회로 기반 논거)
- 예 2: 고저 주파수 검출기
- 예 3: 자세에 불변인 개 머리 검출기
- 다의적 뉴런
- 주장 2: 회로
- 회로 1: 곡선 검출기
- 회로 2: 방향이 있는 개 머리 검출
- 회로 3: 중첩된 자동차
- 회로 모티프
- 주장 3: 보편성
- 곡선 검출기
- AlexNet
- InceptionV1
- VGG19
- ResNetV2-50
- 고저 주파수 검출기
- AlexNet
- InceptionV1
- VGG19
- ResNetV2-50
- 자연과학으로서의 해석 가능성
- 맺음말
- 용어집
- 저자 기여
- 지난 경위
- 감사의 글
- 참고문헌
- 수정과 정정, 재사용, 인용
- 각주
번역문 · 원저자: Chris Olah, Nick Cammarata, Ludwig Schubert, Gabriel Goh, Michael Petrov, Shan Carter · 원문: Zoom In: An Introduction to Circuits · 원문 라이선스: CC BY 4.0. 원문을 한국어로 옮긴 것 말고는 내용을 바꾸지 않았습니다. 원문 글쓴이가 만든 그림과 도식은 글과 같은 CC BY 4.0을 따르므로 그대로 실었습니다. 다른 곳에서 가져온 그림 가운데 『Micrographia』 사진(퍼블릭 도메인)과 활성화 아틀라스 그림(CC BY 4.0)은 함께 실었고, 가져온 그림 아래에는 출처와 라이선스를 달았습니다. DeepDream 이미지와 Schwann 책 사진, 이렇게 2개는 다시 실어도 된다는 라이선스를 확인하지 못해 싣지 않고 설명만 남겼으니 원문에서 보세요.
원문: 「Zoom In: An Introduction to Circuits」, Chris Olah, Nick Cammarata, Ludwig Schubert, Gabriel Goh, Michael Petrov, Shan Carter, Distill, https://distill.pub/2020/circuits/zoom-in, 2020년 3월 10일 게시. 이 글은 원문을 한국어로 옮긴 번역문입니다.
라이선스: 원문 하단의 “Reuse” 항목에 따르면 글과 도식은 Creative Commons Attribution CC-BY 4.0이고, 다른 곳에서 가져온 그림은 이 라이선스에 속하지 않으며 캡션에 “Figure from …” 표기로 알아볼 수 있다고 합니다. 도식 가운데 원문에서 SVG로 그린 것은 원문 페이지에 보이는 모습을 그대로 캡처해 실었습니다. 싣지 못한 그림 자리에는 [그림] 표시와 설명만 두었습니다.
이 글은 신경망의 내부 작동을 파고드는 초청 단문과 비평을 모으는 실험적 형식인 회로 스레드의 일부입니다.
목차
들어가며 / 세 가지 추측 주장 / 주장 1: 특징 (예 1: 곡선 검출기, 예 2: 고저 주파수 검출기, 예 3: 자세에 불변인 개 머리 검출기, 다의적 뉴런) / 주장 2: 회로 (회로 1: 곡선 검출기, 회로 2: 방향이 있는 개 머리 검출, 회로 3: 중첩된 자동차, 회로 모티프) / 주장 3: 보편성 / 자연과학으로서의 해석 가능성 / 맺음말 / 용어집
들어가며
과학사의 중요한 전환점 가운데 많은 수는 과학이 “줌 인”한 순간이었습니다. 그런 순간에는 세상을 새로운 수준의 세부로 볼 수 있게 해 주는 시각화나 도구가 개발되고, 그 렌즈로 세상을 연구하는 새로운 과학 분야가 생겨납니다.
예를 들어 현미경은 세포를 보게 해 주어 세포생물학으로 이어졌습니다. 과학은 줌 인했습니다. X선 결정학을 비롯한 여러 기법은 DNA를 보게 해 주어 분자 혁명으로 이어졌습니다. 과학은 줌 인했습니다. 원자 이론. 아원자 입자. 신경과학. 과학은 줌 인했습니다.
이런 전환은 정밀도가 높아진 것만이 아니라, 과학적 탐구의 대상이 무엇인가가 질적으로 바뀐 것이었습니다. 예를 들어 세포생물학은 동물학을 더 꼼꼼히 한 것이 아닙니다. 우리가 이해할 수 있는 범위를 크게 바꿔 놓는 새로운 종류의 탐구입니다.
잘 알려진 사례들은 아주 큰 규모에서 일어난 일이지만, 작은 연구 공동체가 자기 주제를 더 세밀한 수준에서 연구할 수 있게 되었음을 깨닫는 정도의 소박한 전환일 수도 있습니다.
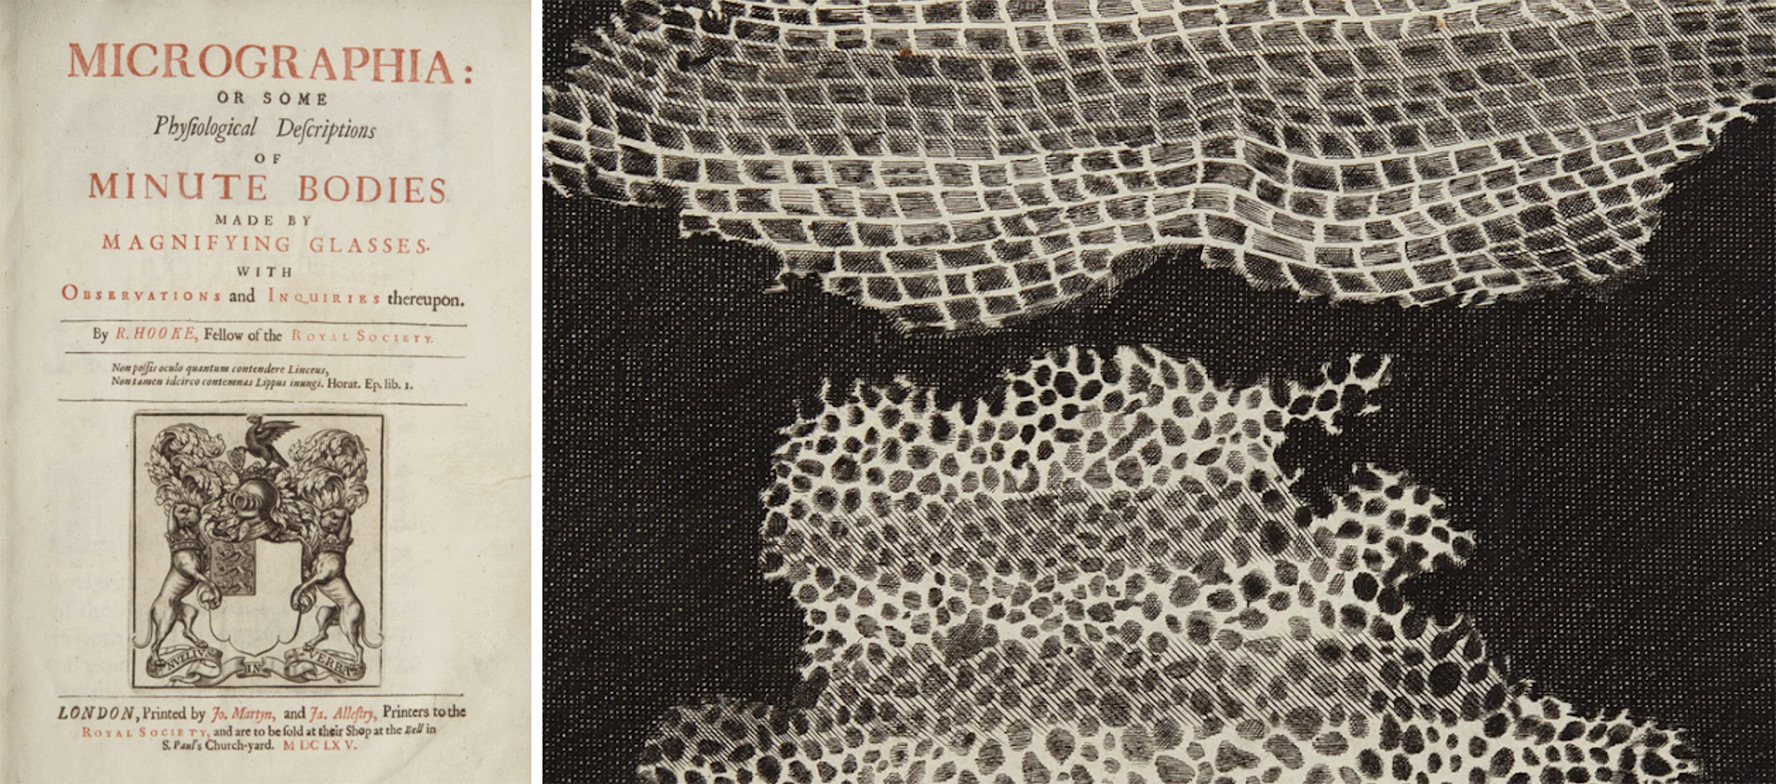
Hooke의 『Micrographia』[1]는 현미경으로 본 풍부한 미시 세계를 보여 주었고, 세포의 첫 발견도 담고 있습니다. 그림은 웨일스 국립도서관에서 가져온 것입니다.
그림 출처: Robert Hooke, 『Micrographia』(1665)의 웨일스 국립도서관 소장본 사진(속표지, Schem. XI), 퍼블릭 도메인. 원문 글쓴이가 가져다 쓴 그림입니다.


초기 현미경이 세포와 미생물의 새로운 세계를 암시했듯, 인공 신경망의 시각화는 우리 모델 안에 있는 풍부한 내면 세계의 솔깃한 단서와 단편을 드러내 왔습니다(예: [2–13]). 그래서 이런 의문이 생겼습니다. 딥러닝도 그와 비슷한, 다만 더 소박한 전환점에 있는 것은 아닐까?
해석 가능성 연구 대부분은 신경망 전체의 행동에 대한 단순한 설명을 주려고 합니다. 그런데 신경과학이나 세포생물학에서 영감을 받은 접근, 곧 줌 인하는 접근을 취하면 어떨까요? 개별 뉴런, 심지어 개별 가중치까지 진지한 조사의 대상으로 삼으면 어떨까요? 모든 뉴런과 그 연결을 수천 시간 들여 추적할 각오를 한다면 어떨까요? 신경망의 어떤 모습이 나타날까요?
신경망을 블랙박스로 보는 흔한 그림과 달리, 우리는 이 규모에서 신경망이 얼마나 다가가기 쉬운지 알고 놀랐습니다. 뉴런이 이해할 수 있어 보이는 것(처음에는 알 수 없어 보이던 뉴런까지 포함해서)에 그치지 않고, 뉴런 사이 연결의 “회로”가 세상에 관한 사실에 해당하는 의미 있는 알고리즘처럼 보입니다. 곡선들로부터 원 검출기가 조립되는 것을 지켜볼 수 있습니다. 눈, 주둥이, 털, 혀로부터 개의 머리가 조립되는 것을 볼 수 있습니다. 바퀴와 창문으로 자동차가 구성되는 방식을 관찰할 수 있습니다. 심지어 단순한 논리를 구현하는 회로도 찾을 수 있습니다. 신경망이 높은 수준의 시각적 특징들에 대해 AND, OR, XOR를 구현하는 경우입니다.
지난 몇 년 동안 현대 신경망 안에 풍부한 내부 특징의 세계가 있음을 시사하는 놀라운 시각화들([2–14])과 분석들([15–18])을 많이 보았습니다. 원문에는 여기에 이 분야에 큰 관심을 불러일으킨 DeepDream[7] 이미지가 실려 있지만, 그림의 라이선스가 분명하지 않아 이 번역에는 싣지 않았습니다.
이 입문 글은 우리 생각의 큰 그림과, 이 연구 노선에서 쓸모 있다고 느낀 몇 가지 작업 원칙을 개괄합니다. 앞으로 나올 글들에서 우리와 협력자들은 이 내면 세계를 자세히 탐구한 내용을 발표할 것입니다.
하지만 사실 우리는 비전 모델 하나를 이해하는 일의 겉면만 긁었을 뿐입니다. 이 질문들이 마음에 와닿는다면, Distill 슬랙에서 열리는 열린 과학 협업인 회로 프로젝트에 우리와 협력자들과 함께하셔도 좋습니다.
세 가지 추측 주장
현대 세포 이론에 가까운 것을 처음으로 내놓은 사례 가운데 하나는 1839년 Theodor Schwann의 세 가지 주장이었습니다. Schwann 세포라는 이름으로 들어 보았을 그 사람입니다.
[그림] 세포에 관한 Schwann의 주장
- 주장 1. 세포는 생물의 구조, 생리, 조직의 단위이다.
- 주장 2. 세포는 별개의 개체로서의 존재와 생물체를 이루는 구성 요소로서의 존재라는 이중의 존재를 지닌다.
- 주장 3. 세포는 결정이 생기는 것과 비슷한 자유 세포 형성으로 만들어진다.
Schwann의 주장을 이렇게 번역하거나 요약한 것은 많은 생물학 교재에서 볼 수 있지만, 이 번역의 원래 출처는 확인하지 못했습니다. Schwann 책의 이미지는 Deutsches Textarchiv에서 가져온 것입니다.
이 주장들 가운데 앞의 둘은 아마 익숙할 것이고, 현대 세포 이론에도 남아 있습니다. 셋째는 아마 낯설 텐데, 끔찍하게 틀린 것으로 드러났기 때문입니다.
참이라고 믿을 만한 것의 강한 형태를 분명하게 밝혀 두는 데에는, 그것이 Schwann의 셋째 주장처럼 틀린 것일 수 있더라도 큰 가치가 있다고 우리는 믿습니다. 이런 취지에서 신경망에 관한 세 가지 주장을 내놓습니다. 이 주장들은 신경망의 본성에 관한 경험적 주장이면서, 신경망을 어떻게 이해하는 것이 유용한가에 관한 규범적 주장이기도 합니다.
[그림] 신경망에 관한 세 가지 추측 주장
- 주장 1: 특징. 특징은 신경망의 기본 단위입니다. 특징은 방향에 해당합니다.1 이런 특징은 엄밀하게 연구하고 이해할 수 있습니다.
- 주장 2: 회로. 특징은 가중치로 연결되어 회로를 이룹니다.2 이런 회로 또한 엄밀하게 연구하고 이해할 수 있습니다.
- 주장 3: 보편성. 비슷한 특징과 회로가 모델과 과제를 가로질러 형성됩니다.
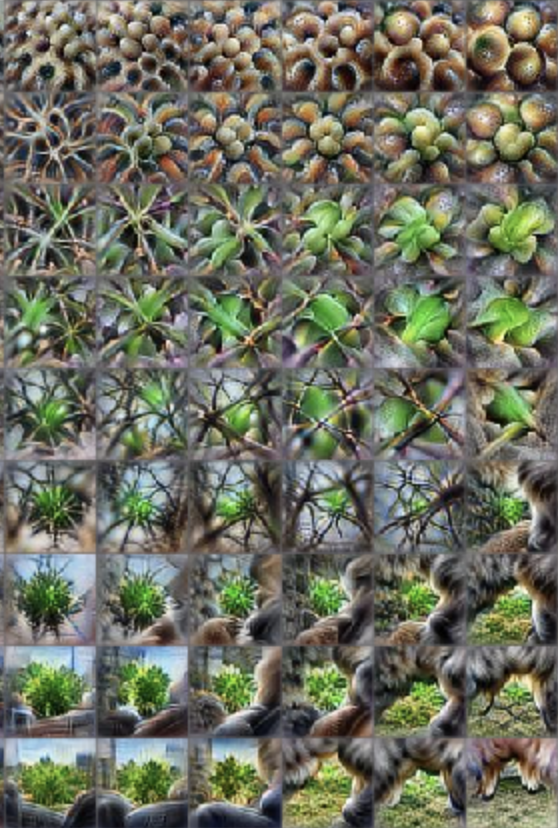
왼쪽: 신경망 특징이 나타낼 수 있는 공간의 일부를 시각화한 활성화 아틀라스 [13].
그림 출처: Shan Carter 외, 「Activation Atlas」, Distill, 2019, CC BY 4.0. 원문 글쓴이가 가져다 쓴 그림입니다.
이 주장들은 일부러 추측의 형태로 썼습니다. 또한 전혀 새로운 주장도 아닙니다. 아래에서 더 깊이 논의하겠지만 (1)과 (3)에 가까운 주장은 이전에도 제기된 적이 있습니다.
하지만 이 주장들이 참이라면 새로운 “줌 인” 해석 가능성 분야의 토대가 될 수 있으므로, 우리는 이것이 고려할 만한 중요한 주장이라고 믿습니다. 다음 절들에서 하나씩 논의하고, 이 주장들이 참일 수 있다고 믿게 된 증거 가운데 일부를 제시하겠습니다.
주장 1: 특징
특징은 신경망의 기본 단위입니다. 특징은 방향에 해당합니다. 이런 특징은 엄밀하게 연구하고 이해할 수 있습니다.
우리는 신경망이 의미 있고 이해할 수 있는 특징들로 이루어져 있다고 믿습니다. 앞쪽 층에는 가장자리나 곡선 검출기 같은 특징이 있고, 뒤쪽 층에는 축 처진 귀 검출기나 바퀴 검출기 같은 특징이 있습니다. 이것이 사실인지를 두고 학계의 의견은 갈립니다. 많은 연구자는 의미 있는 뉴런의 존재를 거의 당연한 사실로 여기고(이를 연구한 작은 문헌도 있습니다)[2, 4, 15–19], 다른 많은 연구자는 의미 있는 잠재 변수를 추적하는 듯 보였던 뉴런의 과거 사례가 잘못 본 것이라고 깊이 회의합니다[20–24].3
그럼에도 개별 뉴런을 수천 시간 연구한 끝에, 우리는 대개의 경우 뉴런(또는 경우에 따라 뉴런 활성화의 벡터 공간에 있는 다른 방향)을 이해할 수 있다고 믿게 되었습니다.
물론 이해할 수 있다는 말이 단순하거나 쉽게 이해된다는 뜻은 아닙니다. 많은 뉴런은 처음에는 수수께끼 같고, 어떤 특징이 있을지에 대한 우리의 선험적 짐작을 따르지 않습니다! 하지만 우리 경험으로는 이런 뉴런 뒤에도 대개 단순한 설명이 있고, 실제로는 아주 자연스러운 일을 하고 있습니다. 예를 들어 우리는 처음에 고저 주파수 검출기(아래에서 논의)가 무엇인지 혼란스러웠지만, 돌아보면 단순하고 우아합니다.
이 입문 글은 우리가 보기에 핵심을 잘 보여 주는 몇 가지 예만 개괄합니다. 하지만 이 글 뒤에는 개별 특징을 꼼꼼하게 규명하는 깊이 있는 글과, 우리가 존재한다고 이해한 모든 특징을 훑는 폭넓은 개관이 이어질 것입니다. 지금은 예를 InceptionV1[26]에서 가져오지만, 이 주장들이 일반적으로 성립한다고 믿으며 마지막 보편성 절에서 다른 모델도 논의하겠습니다.
우리가 맞든 틀리든, 의미 있는 특징에 관한 이 질문은 학계가 풀어야 할 중요한 문제라고 우리는 믿습니다. 이해할 수 있어 보이는 특징을 구체적으로 꼼꼼하게 탐구한 몇 가지 사례를 소개하면 논의가 진전되기를 바랍니다.
예 1: 곡선 검출기
곡선 검출 뉴런은 우리가 꼼꼼히 살펴본 사소하지 않은 모든 비전 모델에서 발견됩니다. 이 유닛이 흥미로운 까닭은, 학계가 존재한다고 널리 동의하는 특징(예: 가장자리 검출기)과 상당한 회의가 있는 특징(예: 귀, 자동차, 얼굴 같은 고수준 특징) 사이의 경계에 걸쳐 있기 때문입니다.
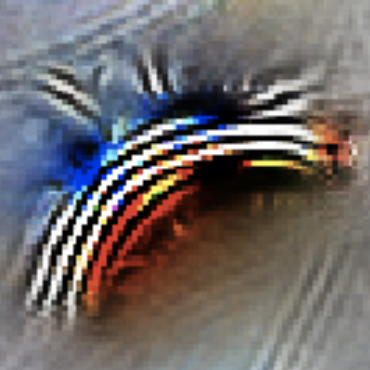
우리는 InceptionV1의 앞쪽 층인 mixed3b에 있는 곡선 검출기에 집중하겠습니다. 이 유닛들은 반지름이 60픽셀쯤 되는 곡선과 경계에 반응합니다. 또한 곡선 경계를 따라 있는 수직선에도 약간 더 흥분하고, 곡선 양쪽이 서로 다른 색이기를 선호합니다.
곡선 검출기는 유닛의 가족 단위로 발견되며, 가족의 각 구성원은 같은 곡선 특징을 서로 다른 방향에서 검출합니다. 이들이 함께 모든 방향 범위를 아우릅니다.
곡선 검출기를 겉보기에 비슷한 다른 유닛과 구별하는 것이 중요합니다. 특히 곡선을 이용해 곡선으로 된 하위 구성 요소(예: 원, 나선, S자 곡선, 모래시계 모양, 3차원 곡률 등)를 검출하는 유닛이 많이 있습니다. 직선이나 날카로운 모서리 같은 곡선 관련 모양에 반응하는 유닛도 있습니다. 우리는 이런 유닛을 곡선 검출기로 보지 않습니다.
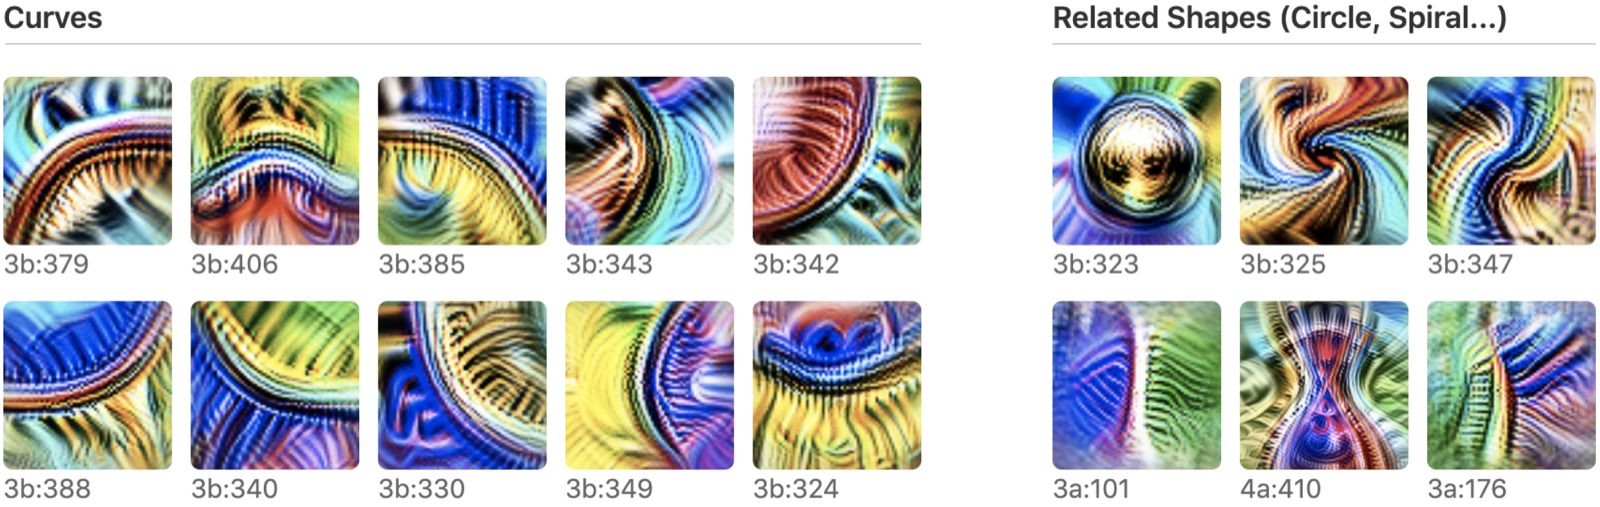
곡선 검출기의 예.
그런데 이 “곡선 검출기”는 정말 곡선을 검출하고 있을까요? 나중에 글 하나를 통째로 들여 이 점을 깊이 탐구할 예정이지만, 요약하면 증거가 상당히 강하다고 우리는 봅니다.
우리는 아래에 정리한 일곱 가지 논거를 제시합니다. 이 논거 중 곡선에만 해당하는 것은 없다는 점을 짚어 둘 만합니다. 다른 특징을 검증할 때도 쓸 수 있는 유용하고 일반적인 도구 상자입니다. 이 논거 가운데 몇 가지, 곧 데이터셋 예시, 합성 예시, 튜닝 곡선은 시각 신경과학의 고전적 방법입니다(예: [27]). 마지막 세 논거는 회로에 기반하며, 다음 절에서 논의하겠습니다.
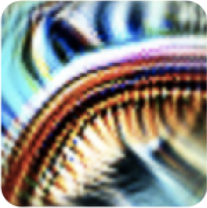
논거 1: 특징 시각화
곡선 검출기가 발화하도록 입력을 최적화하면 어김없이 곡선이 만들어집니다. 결과 이미지에 있는 모든 것은 뉴런이 더 발화하도록 추가된 것이므로 이는 인과 관계를 확립합니다. 특징 시각화에 대해서는 여기에서 더 알아볼 수 있습니다.
논거 2: 데이터셋 예시
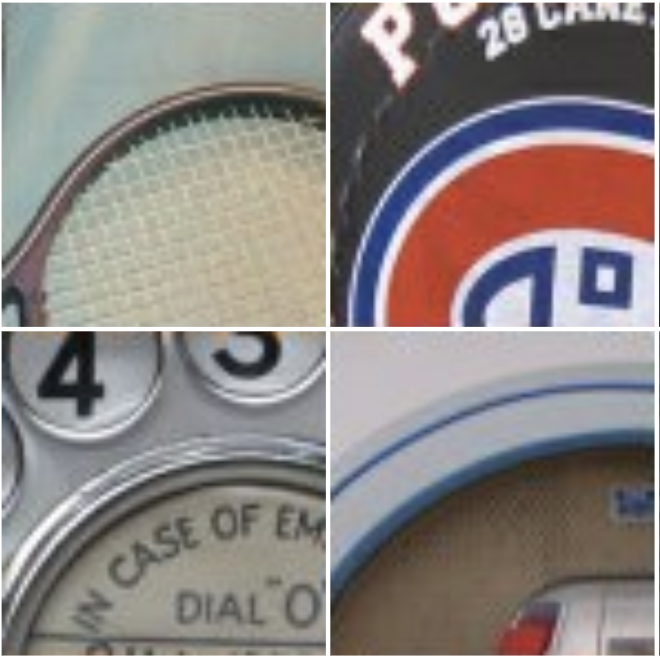
이 뉴런들을 강하게 발화시키는 ImageNet 이미지는 어김없이 예상한 방향의 곡선입니다. 중간 정도로 발화시키는 이미지는 대체로 덜 완전한 곡선이거나 방향이 어긋난 곡선입니다.
논거 3: 합성 예시
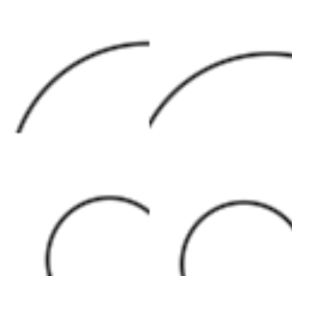
곡선 검출기는 방향, 곡률, 배경을 달리해 만든 여러 합성 곡선 이미지에 기대한 대로 반응합니다. 기대한 방향 근처에서만 발화하고, 직선이나 날카로운 모서리에는 강하게 발화하지 않습니다.
논거 4: 결합 튜닝
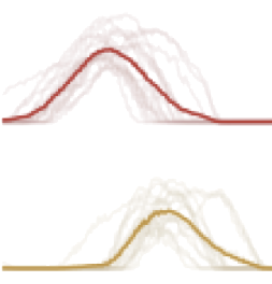
뉴런을 발화시키는 데이터셋 예시를 회전시키면 그 뉴런은 점차 발화를 멈추고 다음 방향의 곡선 검출기가 발화하기 시작합니다. 이는 이들이 같은 것을 회전시킨 버전을 검출하고 있음을 보여 줍니다. 이들은 함께 가능한 방향 360도 전체를 덮습니다.
논거 5: 특징 구현 (회로 기반 논거)
곡선 검출기를 만드는 회로를 보면 가중치에서 곡선 검출 알고리즘을 읽어 낼 수 있습니다. 또한 우리가 역할을 이해하지 못하는 더 작은 가중치가 많이 있기는 하지만, 발화의 두 번째 대안 원인을 시사하는 것은 보이지 않습니다.
논거 6: 특징 사용 (회로 기반 논거)
곡선 검출기의 하류 클라이언트는 곡선을 자연스럽게 수반하는 특징(예: 원, 3차원 곡률, 나선…)입니다. 이 클라이언트들은 곡선 검출기를 기대한 방식으로 사용합니다.
논거 7: 손으로 쓴 회로 (회로 기반 논거)
곡선 검출기가 어떻게 구현되는지에 대한 이해를 바탕으로, 모든 가중치를 손으로 설정해 곡선 검출을 클린룸 방식으로 다시 구현할 수 있습니다. 이 가중치는 이해할 수 있는 곡선 검출 알고리즘이며 원래의 곡선 검출기를 상당 부분 흉내 냅니다.
위의 논거들이 곡선 검출기가 다른 종류의 자극에 발화하는 드문 이차적 경우가 있을 가능성을 완전히 배제하지는 못합니다. 그러나 (1) 곡선이 이 뉴런들을 발화시키고, (2) 각 유닛이 서로 다른 각도 방향의 곡선에 반응하며, (3) 이들을 발화시키는 다른 자극이 있더라도 그런 자극은 드물거나 활성화가 더 약하다는 점은 확립하는 듯합니다. 더 일반적으로, 이 논거들은 신경과학에서 쓰이는 것으로 우리가 이해하는 증거 기준을 충족하는 듯합니다. 신경과학에는 이런 주장을 어떻게 평가할지에 관한 확립된 전통과 제도적 지식이 있습니다.
이 논거들은 모두 곡선 검출기와 곡선 검출 회로에 관한 뒤의 글들에서 자세히 탐구하겠습니다.
예 2: 고저 주파수 검출기
곡선 검출기는 직관적인 유형의 특징입니다. 선험적으로 신경망에 있으리라고 짐작할 만한 종류의 특징입니다. 이런 것이 있다면 우리가 이해할 수 있다는 것은 놀랍지 않습니다. 그렇다면 직관적이지 않은 특징은 어떨까요? 그것도 이해할 수 있을까요? 우리는 그렇다고 믿습니다.
고저 주파수 검출기는 덜 직관적인 유형의 특징의 예입니다. 초기 비전에서 발견되며, 무엇을 하는지 이해하고 나면 아주 단순합니다. 수용 영역의 한쪽에서는 저주파 패턴을, 반대쪽에서는 고주파 패턴을 찾습니다. 곡선 검출기와 마찬가지로 고저 주파수 검출기도 같은 것을 서로 다른 방향에서 찾는 특징의 가족으로 발견됩니다.
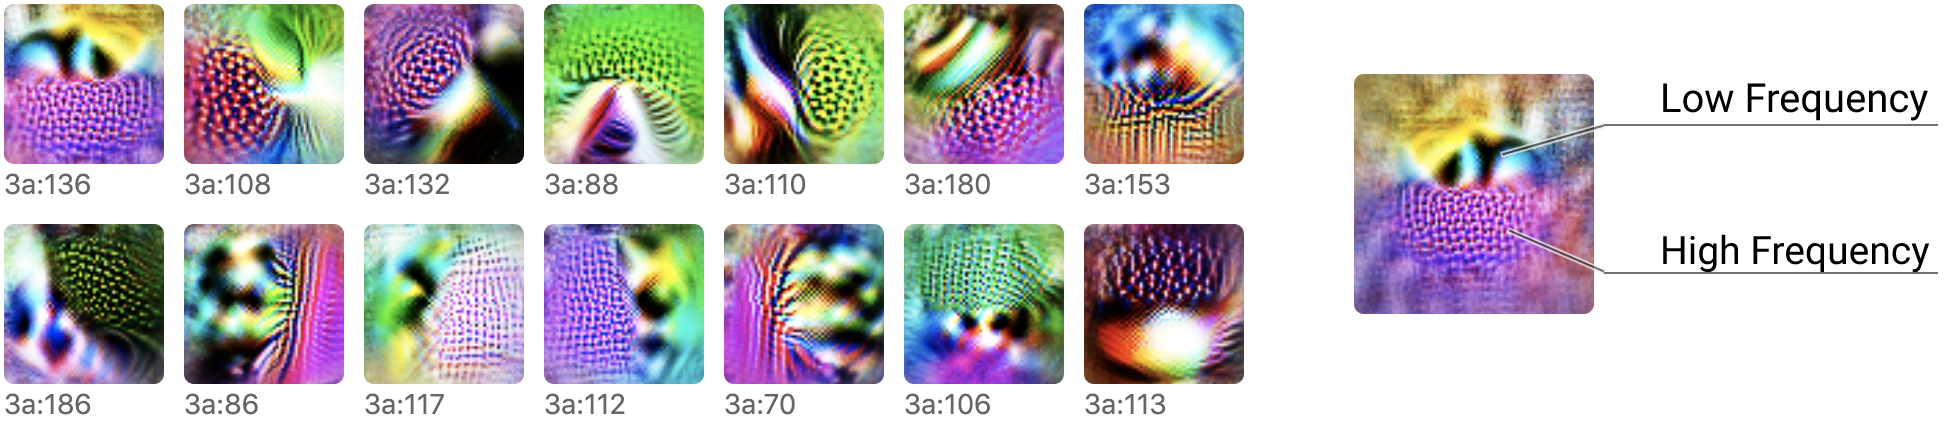
고저 주파수 검출기의 예.
고저 주파수 검출기는 신경망에 왜 쓸모가 있을까요? 특히 배경의 초점이 나가 있을 때 물체의 경계를 검출하는 여러 휴리스틱 가운데 하나인 듯합니다. 이후의 글에서 이것이 정교한 경계 검출기를 만드는 데 어떻게 쓰이는지 탐구하겠습니다.
(일부 연구자가 해석 가능성에 거는 희망 하나는, 모델을 이해하면 세상을 생각하는 더 나은 추상 개념을 우리가 배울 수 있으리라는 것입니다[28]. 고저 주파수 검출기는 아마 이 점에서 작은 성공 사례일 것입니다. 우리가 미리 예상하지 못한, 자연스럽고 쓸모 있는 시각적 특징이니까요.)
곡선 뉴런을 조사하는 데 쓴 일곱 기법은 모두 약간 손봐서 고저 주파수 뉴런을 연구하는 데에도 쓸 수 있습니다. 예를 들어 합성 고저 주파수 예시를 렌더링하는 식입니다. 이번에도 이 논거들이 합쳐져, 이것이 정말로 고저 주파수 대비 검출기의 가족이라는 생각을 강하게 뒷받침한다고 우리는 믿습니다.
예 3: 자세에 불변인 개 머리 검출기
곡선 검출기와 고저 주파수 검출기는 둘 다 InceptionV1의 앞쪽 층에서 발견되는 저수준 시각 특징입니다. 더 복잡한 고수준 특징은 어떨까요?
자세에 불변인 개 검출기라고 우리가 믿는 이 유닛을 생각해 봅시다. 다른 뉴런과 마찬가지로 특징 시각화를 만들고 데이터셋 예시를 모을 수 있습니다. 특징 시각화를 보면 기하 구조가… 불가능하지만 이 뉴런이 무엇을 찾는지는 매우 잘 알려 주며, 데이터셋 예시가 그것을 뒷받침합니다.
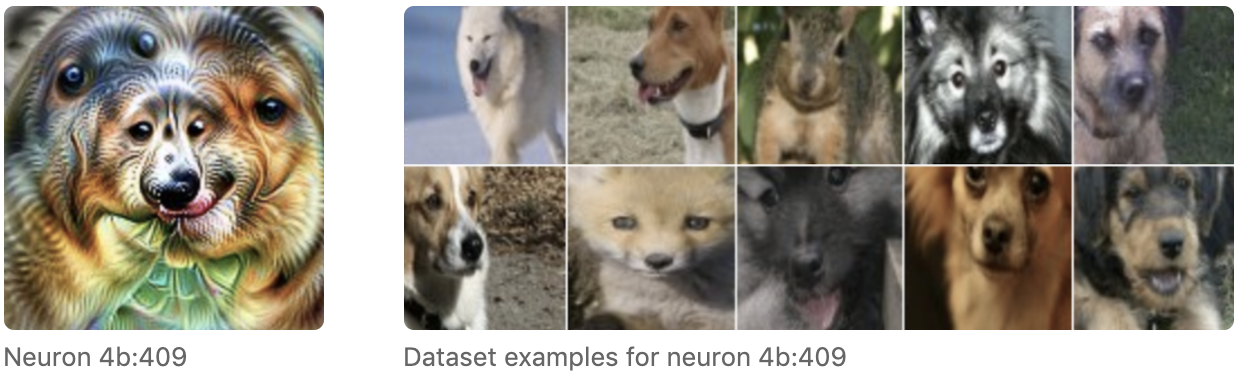
자세에 불변인 개 검출기 뉴런의 특징 시각화와 데이터셋 예시.
특징 시각화와 데이터셋 예시만으로도 이미 상당히 강한 논거라는 점은 짚어 둘 만합니다. 특징 시각화는 인과 관계를 확립하고, 데이터셋 예시는 뉴런이 실제로 쓰이는 방식과 이 뉴런이 반응하는 두 번째 자극이 있는지를 시험합니다. 그러나 뉴런을 분석하는 우리의 다른 접근을 다시 모두 동원할 수도 있습니다. 예를 들어 3D 모델을 써서 여러 각도에서 본 합성 개 머리 이미지를 만들 수 있습니다.
동시에, 지금까지 강조한 접근 가운데 일부는 이렇게 더 높은 수준의 추상적 특징에는 노력이 아주 많이 듭니다. 다행히 곧 더 논의할 우리의 회로 기반 논거는 계속 적용하기 쉽고, 많은 노력 없이도 고수준 특징을 이해하고 시험하는 아주 강력한 도구를 줍니다.
다의적 뉴런
이 글이 지나치게 장밋빛 그림을 주고 있을지도 모릅니다. 진지하게 조사하기만 하면 모든 뉴런이 사람이 이해할 수 있는 좋은 개념을 내놓는 것일까요?
안타깝게도 그렇지 않습니다. 신경망에는 서로 무관한 여러 입력에 반응하는 “다의적 뉴런”이 자주 들어 있습니다. 예를 들어 InceptionV1에는 고양이 얼굴, 자동차 앞부분, 고양이 다리에 반응하는 뉴런이 하나 있습니다.
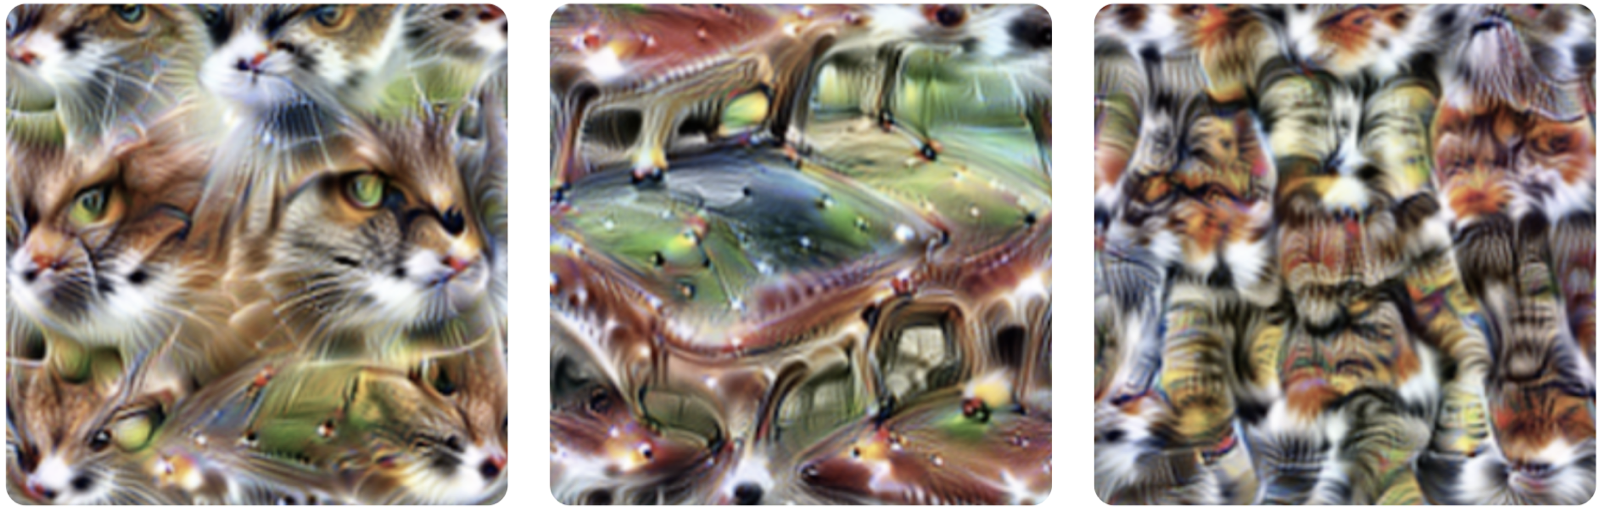
4e:55는 고양이 얼굴, 자동차 앞부분, 고양이 다리에 반응하는 다의적 뉴런입니다. 특징 시각화 [4]에서 더 자세히 논의했습니다.
분명히 해 두자면, 이 뉴런은 자동차와 고양이 얼굴의 어떤 공통점에 반응하는 것이 아닙니다. 특징 시각화는 이 뉴런이 고양이의 눈과 수염, 털북숭이 다리, 자동차의 번쩍이는 앞부분을 찾고 있음을 보여 줍니다. 미묘한 공통 특징을 찾는 것이 아닙니다.
우리는 이런 특징도 연구할 수 있습니다. 발화하는 경우를 하나하나 규명하고 어느 정도까지는 이 특징의 회로도 추론할 수 있습니다. 그렇더라도 다의적 뉴런은 회로 의제에 큰 도전이며 신경망을 추론하는 우리 능력을 크게 제한합니다.4
다의적 뉴런을 풀어낼 수 있기를 우리는 바랍니다. 예컨대 신경망을 “펼쳐서” 다의적 뉴런을 순수한 특징으로 바꾸거나, 애초에 다의성이 나타나지 않도록 신경망을 훈련하는 방법이 있을 수 있습니다. 이는 본질적으로 표현 풀기(disentangling representations) 문헌에서 연구하는 문제이지만, 현재 그 문헌은 생성 모델의 잠재 공간에 있는, 이미 알려진 특징에 초점을 맞추는 경향이 있습니다.
자연스럽게 떠오르는 질문 하나는 다의적 뉴런이 왜 생기는가입니다. 다음 절에서, 다의적 뉴런은 우리가 “중첩”이라고 부르는 현상에서 비롯되는 듯하다는 점을 보겠습니다. 회로가 하나의 특징을 여러 뉴런에 흩뿌리는 현상이며, 아마 가진 뉴런의 수가 한정되어 있으니 더 많은 특징을 채워 넣으려는 것이겠지요.
주장 2: 회로
특징은 가중치로 연결되어 회로를 이룹니다. 이런 회로 또한 엄밀하게 연구하고 이해할 수 있습니다.
우리 신경망의 모든 뉴런은 이전 층 뉴런의 선형 결합에 ReLU를 씌운 것입니다. 두 층의 특징을 모두 이해할 수 있다면, 둘 사이의 연결도 이해할 수 있어야 하지 않을까요? 이를 탐구하려면 회로를 연구하는 것이 도움이 됩니다. 회로는 촘촘히 연결된 특징들의 집합과 그 사이의 가중치로 이루어진 신경망의 부분 그래프입니다.
놀라운 점은 이 회로들이 연구 대상으로서 얼마나 다루기 쉽고 의미 있어 보이는가입니다. 들여다보기 시작했을 때 우리는 상당히 지저분한 것을 발견하리라 예상했습니다. 대신 대칭이 있는 아름답고 풍부한 구조를 종종 발견했습니다. 이 가중치가 어떤 특징들을 이어 주는지 알고 나면, 신경망의 부동소수점 가중치 하나하나가 의미를 갖게 됩니다! 가중치에서 의미 있는 알고리즘을 그대로 읽어 낼 수 있습니다.
몇 가지 예를 살펴봅시다.
회로 1: 곡선 검출기
앞 절에서 우리는 서로 다른 각도 방향의 곡선을 검출하는 유닛 가족인 곡선 검출기를 논의했습니다. 이 절에서는 곡선 검출기가 앞쪽 특징들로부터 어떻게 구현되고 모델의 나머지 부분과 어떻게 연결되는지 탐구합니다.
곡선 검출기는 주로 앞쪽의 덜 정교한 곡선 검출기와 선 검출기로부터 구현됩니다. 이 곡선 검출기들은 다음 층에서 3차원 기하와 복잡한 모양 검출기를 만드는 데 쓰입니다. 물론 다른 특징으로 가는 작은 연결이 길게 꼬리를 이루고 있지만, 주된 이야기는 이것인 듯합니다.
이 입문에서는 앞쪽의 곡선 검출기와 완전한 곡선 검출기 사이의 상호작용에 집중하겠습니다.
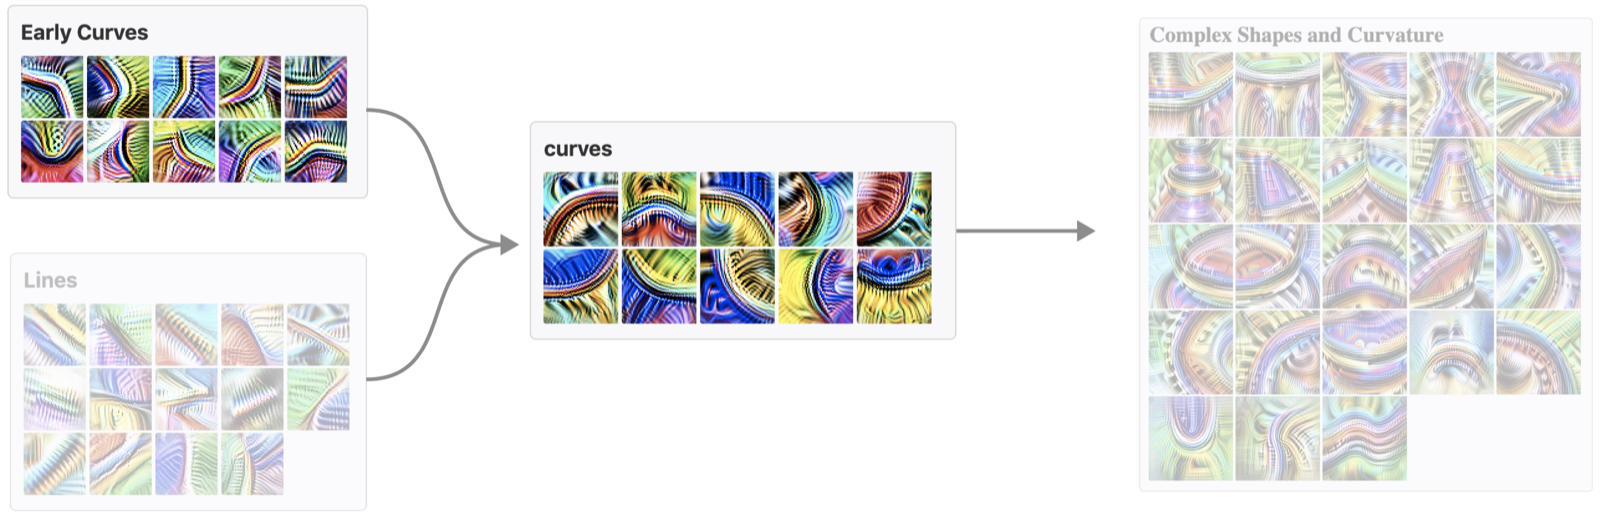
앞쪽 곡선 검출기에서 완전한 곡선 검출기로 이어지는 회로.
앞쪽 곡선 검출기 하나가 같은 방향의 더 정교한 곡선 검출기에 어떻게 연결되는지에 더 집중해 봅시다.
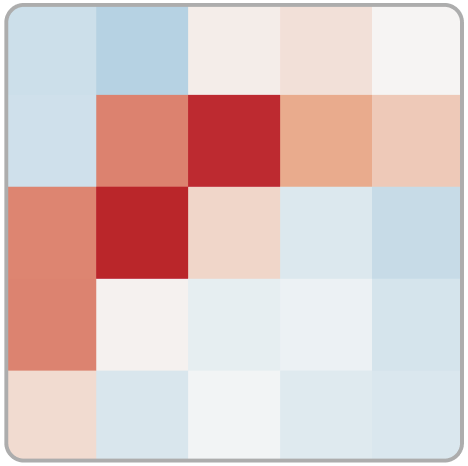
이 경우 우리 모델은 5x5 합성곱을 구현하고 있으므로, 이 두 뉴런을 잇는 가중치는 양수일 수도 음수일 수도 있는 5x5 가중치 집합입니다.5
양의 가중치는 앞쪽 뉴런이 그 위치에서 발화하면 뒤쪽 뉴런을 흥분시킨다는 뜻입니다. 반대로 음의 가중치는 뒤쪽 뉴런을 억제한다는 뜻입니다.
우리가 보는 것은 곡선 검출기의 모양으로 배열된 강한 양의 가중치입니다. 이는 곡선을 따라 있는 각 지점에서 우리 곡선 검출기가 앞쪽 곡선 검출기를 써서 “접선 곡선”을 찾고 있다는 뜻으로 볼 수 있습니다.
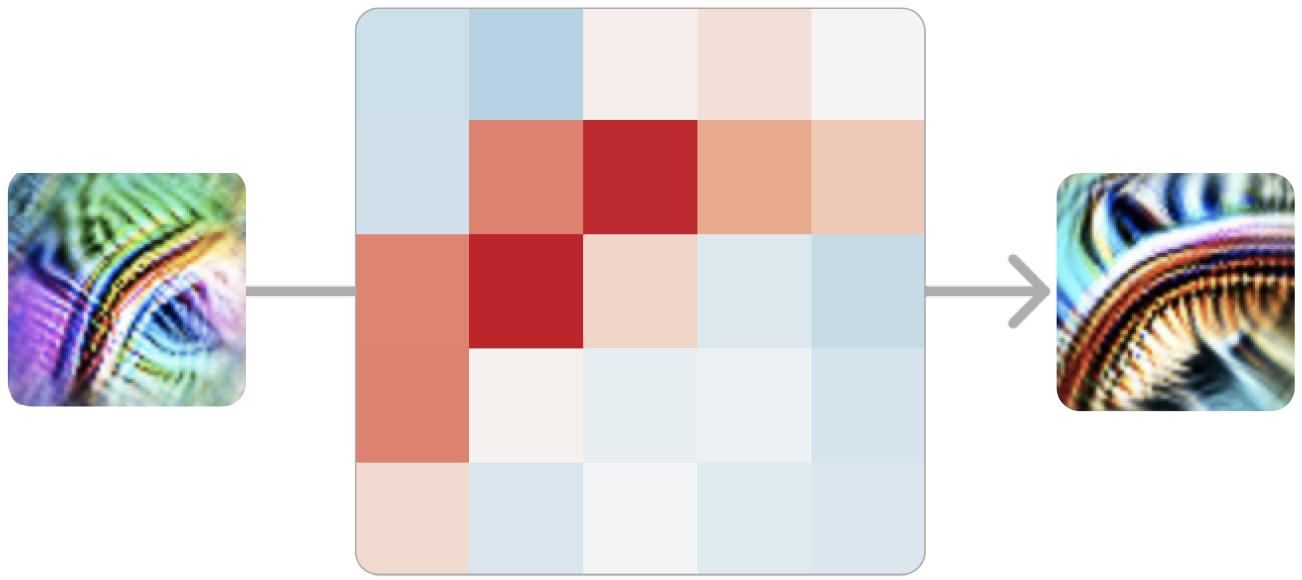
같은 방향의 앞쪽 곡선 검출기와 뒤쪽 곡선 검출기 사이의 원시 가중치는, 작은 음수 또는 0의 가중치에 둘러싸인 양의 가중치로 된 곡선입니다.
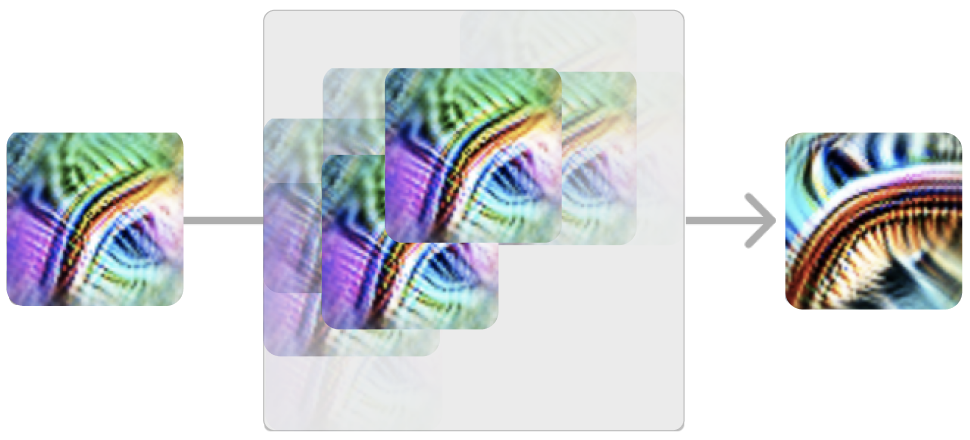
이는 곡선을 따라 있는 각 지점에서 “접선 곡선”을 찾는 것으로 해석할 수 있습니다.
이는 비슷한 방향에 있는 앞쪽과 완전한 곡선 검출기의 모든 쌍에서 성립합니다. 곡선을 따라 있는 모든 지점에서 비슷한 방향의 곡선을 검출합니다. 마찬가지로 반대 방향의 곡선은 곡선을 따라 있는 모든 지점에서 억제적입니다.
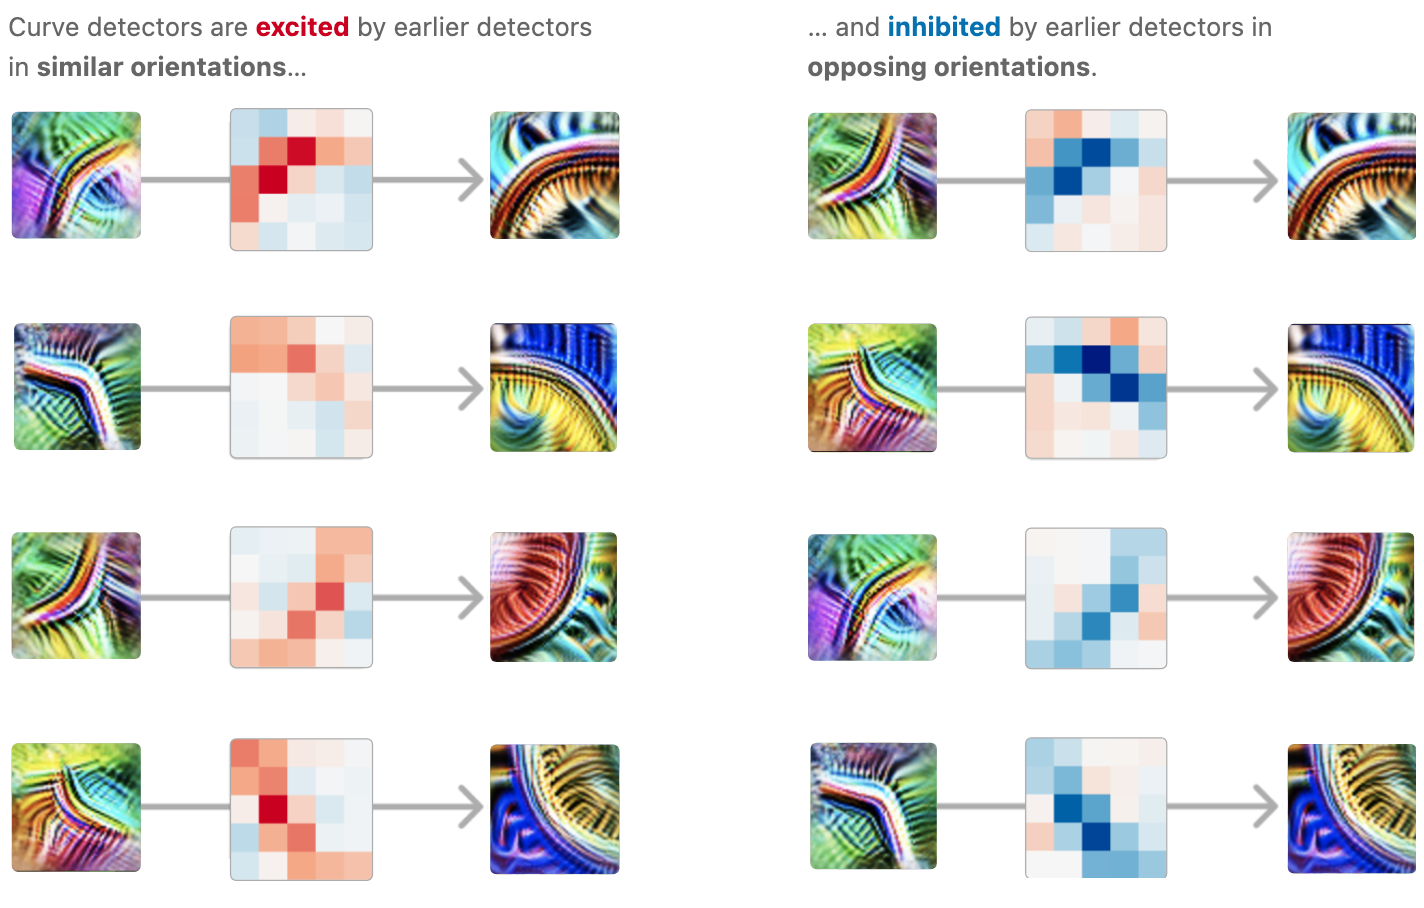
곡선 검출기는 비슷한 방향의 앞쪽 검출기에 의해 흥분하고… 반대 방향의 앞쪽 검출기에 의해 억제됩니다.
여기서 잠시 생각해 볼 만한 것은, 우리가 신경망 가중치를 보고 있는데 그것이 의미가 있다는 점입니다.
그리고 더 가까이 볼수록 구조가 더 풍부해집니다. 예를 들어 앞쪽 곡선 검출기와 완전한 곡선 검출기가 비슷하지만 정확히 같지는 않은 방향이면, 더 정렬된 쪽의 곡선 면에서 양의 가중치가 더 강한 것을 종종 볼 수 있습니다.
곡선 검출기의 방향에 따라 가중치가 회전한다는 점도 눈여겨볼 만합니다. 문제의 대칭이 가중치의 대칭으로 반영됩니다. 이 현상이 나타나는 회로를 “등변 회로”라고 부르며, 나중 글에서 깊이 논의하겠습니다.
회로 2: 방향이 있는 개 머리 검출
곡선 검출기 회로는 저수준 회로이며 두 층에만 걸쳐 있습니다. 이 절에서는 네 층에 걸친 고수준 회로를 논의합니다. 이 회로에서는 신경망이 정교한 불변성을 어떻게 구현하는지도 배울 수 있습니다.
ImageNet 모델이 해야 하는 일의 큰 부분은 서로 다른 동물을 구분하는 것임을 기억하세요. 특히 개 백 종을 서로 구분해야 합니다! 그러니 머리를 포함해 개와 관련된 특징을 인식하는 데 전념하는 뉴런이 많이 생기는 것은 놀랍지 않습니다.
이 “개 인식” 시스템 안에서 특히 흥미롭다고 느낀 회로 하나는, 왼쪽을 향한 개 머리와 오른쪽을 향한 개 머리를 처리하는 뉴런들의 모임입니다. 세 층에 걸쳐 신경망은 서로 거울상인 두 경로를 유지하며, 왼쪽과 오른쪽을 향한 대응하는 유닛을 검출합니다. 각 단계에서 이 경로들은 서로를 억제하려 하며 대비를 선명하게 만듭니다. 마지막에는 두 경로 모두에 반응하는 불변 뉴런을 만듭니다.
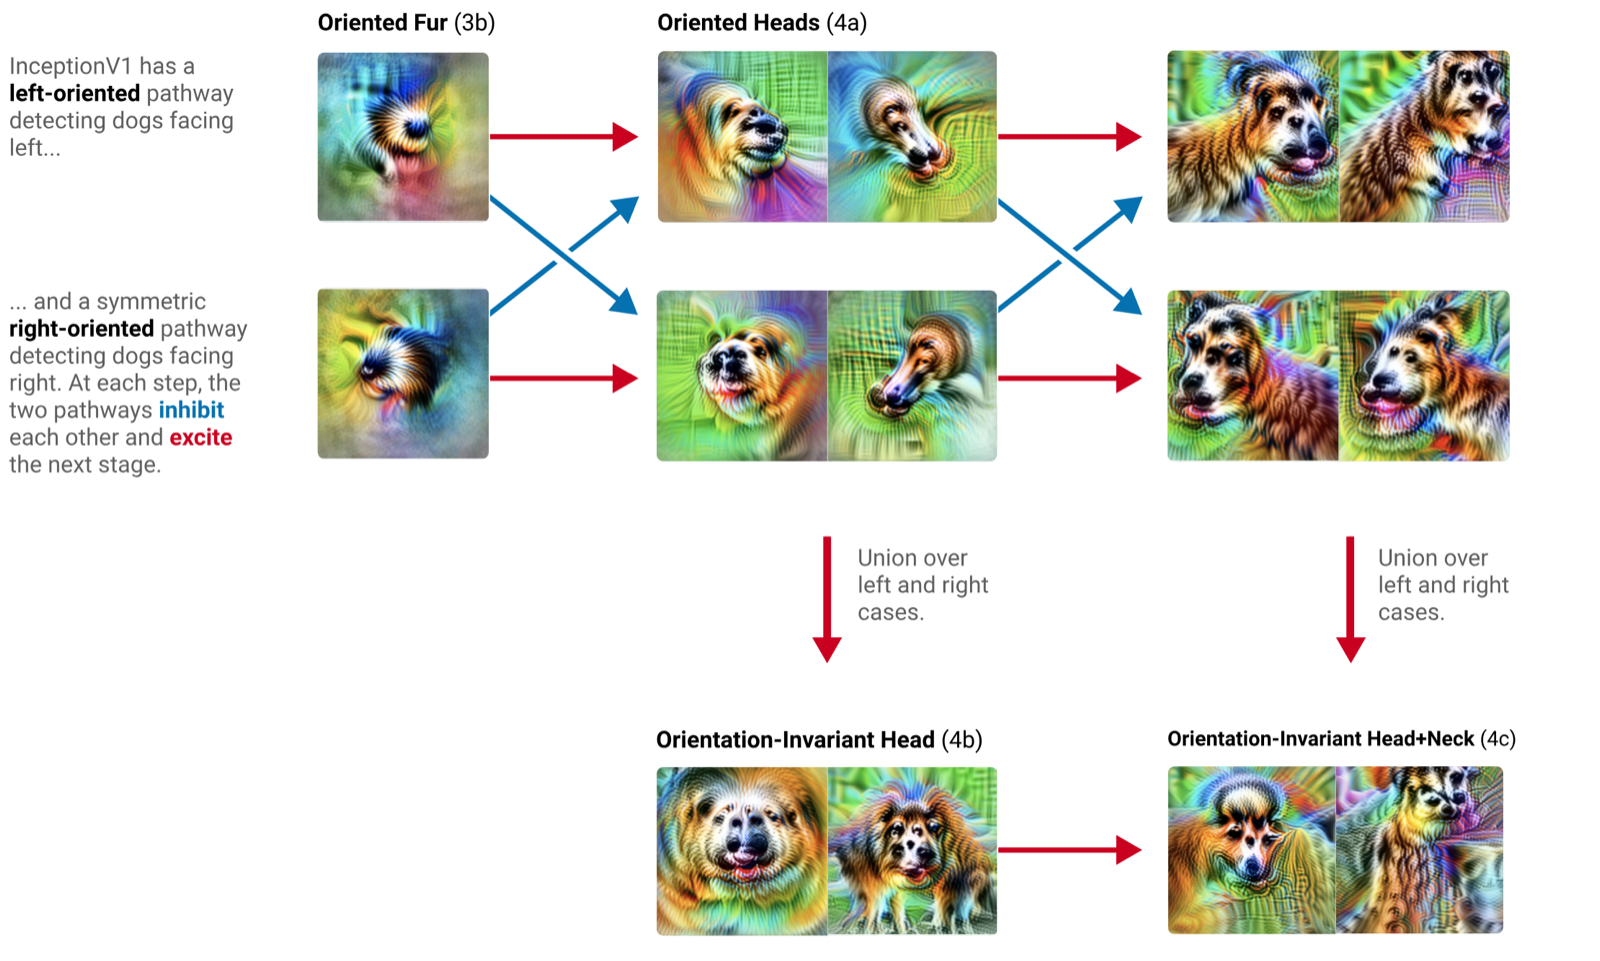
왼쪽과 오른쪽을 향한 개 머리 경로가 서로 억제하며 마지막에 불변 뉴런으로 합쳐지는 회로.
우리는 이 패턴을 “경우 합치기”라고 부릅니다. 신경망은 두 경우(왼쪽과 오른쪽)를 따로 검출한 다음 그 둘의 합집합을 취해 불변인 “다면적” 유닛[29]을 만듭니다. 두 경로가 서로를 억제하므로 이 회로에는 사실 XOR 비슷한 성질도 있다는 점에 주목하세요.
이 회로가 눈길을 끄는 까닭은 신경망이 훨씬 덜 정교한 방식을 쓸 수도 있었기 때문입니다. 눈, 털, 주둥이가 어디에 있는지는 별로 신경 쓰지 않고 그것들이 뒤섞여 있는지만 찾아서 불변 뉴런을 쉽게 만들 수도 있었습니다. 그런데 신경망은 왼쪽과 오른쪽 경우를 갈라서 따로 처리하도록 배웠습니다. 경사 하강법이 이렇게 하는 법을 배울 수 있다는 점에 우리는 다소 놀랐습니다!6
하지만 회로에 대한 이 요약은 실제로 일어나는 일의 겉면만 긁은 것입니다. 뉴런 사이의 연결은 모두 합성곱이므로, 입력 뉴런이 다음 뉴런을 어디에서 흥분시키는지도 볼 수 있습니다. 모델은 대체로 낙관적으로 바랐던 대로 하고 있습니다. 예를 들어 “목이 달린 머리” 유닛들을 봅시다. 머리는 올바른 쪽에서만 검출됩니다.
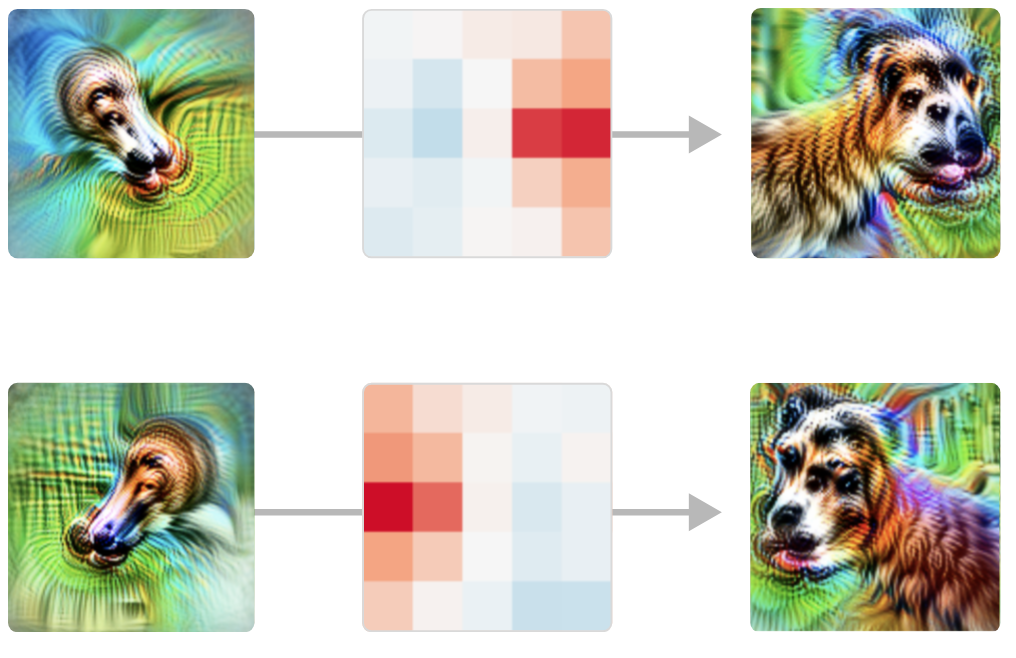
“목이 달린 머리” 유닛에서 머리는 올바른 쪽에서만 검출됩니다.
합치기 단계도 자세히 들여다볼 만합니다. 신경망은 두 방향의 머리에 무차별적으로 반응하지 않습니다. 흥분 영역은 방향에 따라 중심에서 서로 다른 쪽으로 뻗어, 주둥이들이 같은 점으로 모일 수 있게 합니다.
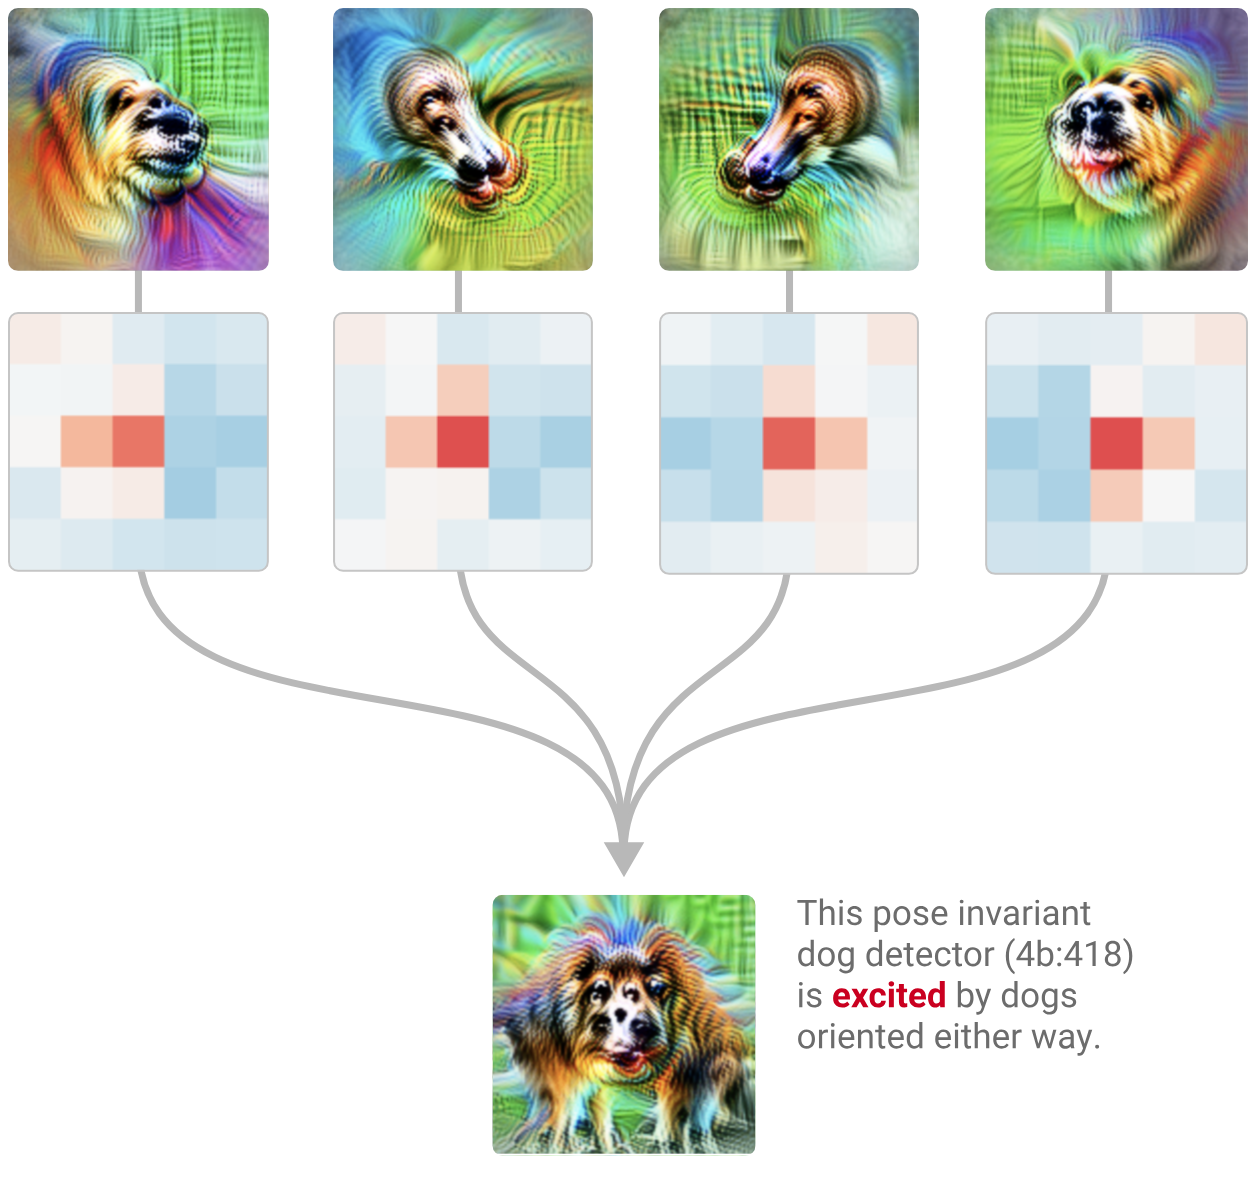
합치기 단계에서 방향에 따라 흥분 영역이 중심에서 서로 다른 쪽으로 뻗는 모습.
이 회로에 대해서는 할 이야기가 훨씬 많아서, 나중 글에서 다시 돌아와 깊이 분석할 계획입니다. 가중치를 편집해 이 회로에 대한 우리의 이론을 시험하는 일도 포함됩니다.
회로 3: 중첩된 자동차
InceptionV1의 중후반 층인 mixed4c에는 자동차를 검출하는 뉴런이 있습니다. 앞 층의 특징을 이용해 합성곱 창의 아래쪽에서는 바퀴를, 위쪽에서는 창문을 찾습니다.
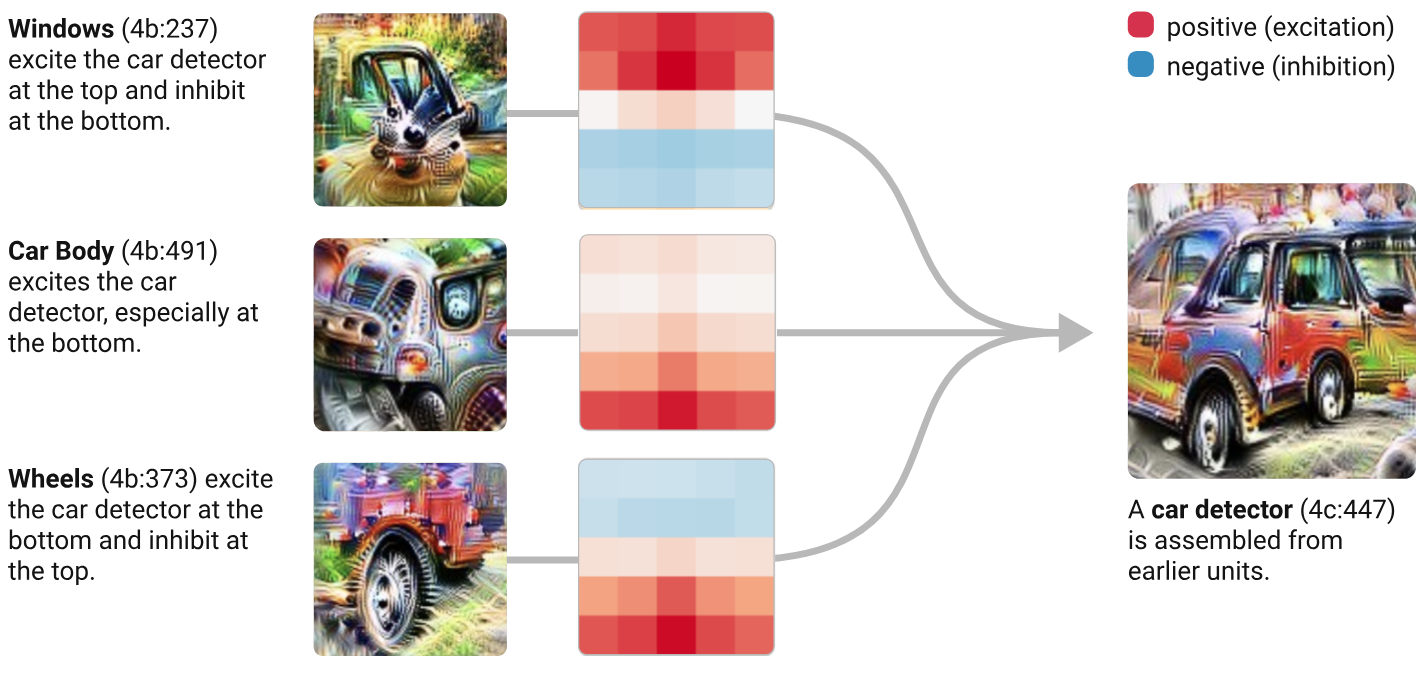
바퀴(아래쪽)와 창문(위쪽)으로부터 자동차 검출기가 만들어지는 회로.
그런데 모델은 놀라운 일을 합니다. 다음 층에서 또 하나의 순수한 자동차 검출기를 만드는 대신, 자동차 특징을 주로 다른 일, 특히 개 검출을 하는 듯한 여러 뉴런에 퍼뜨립니다.
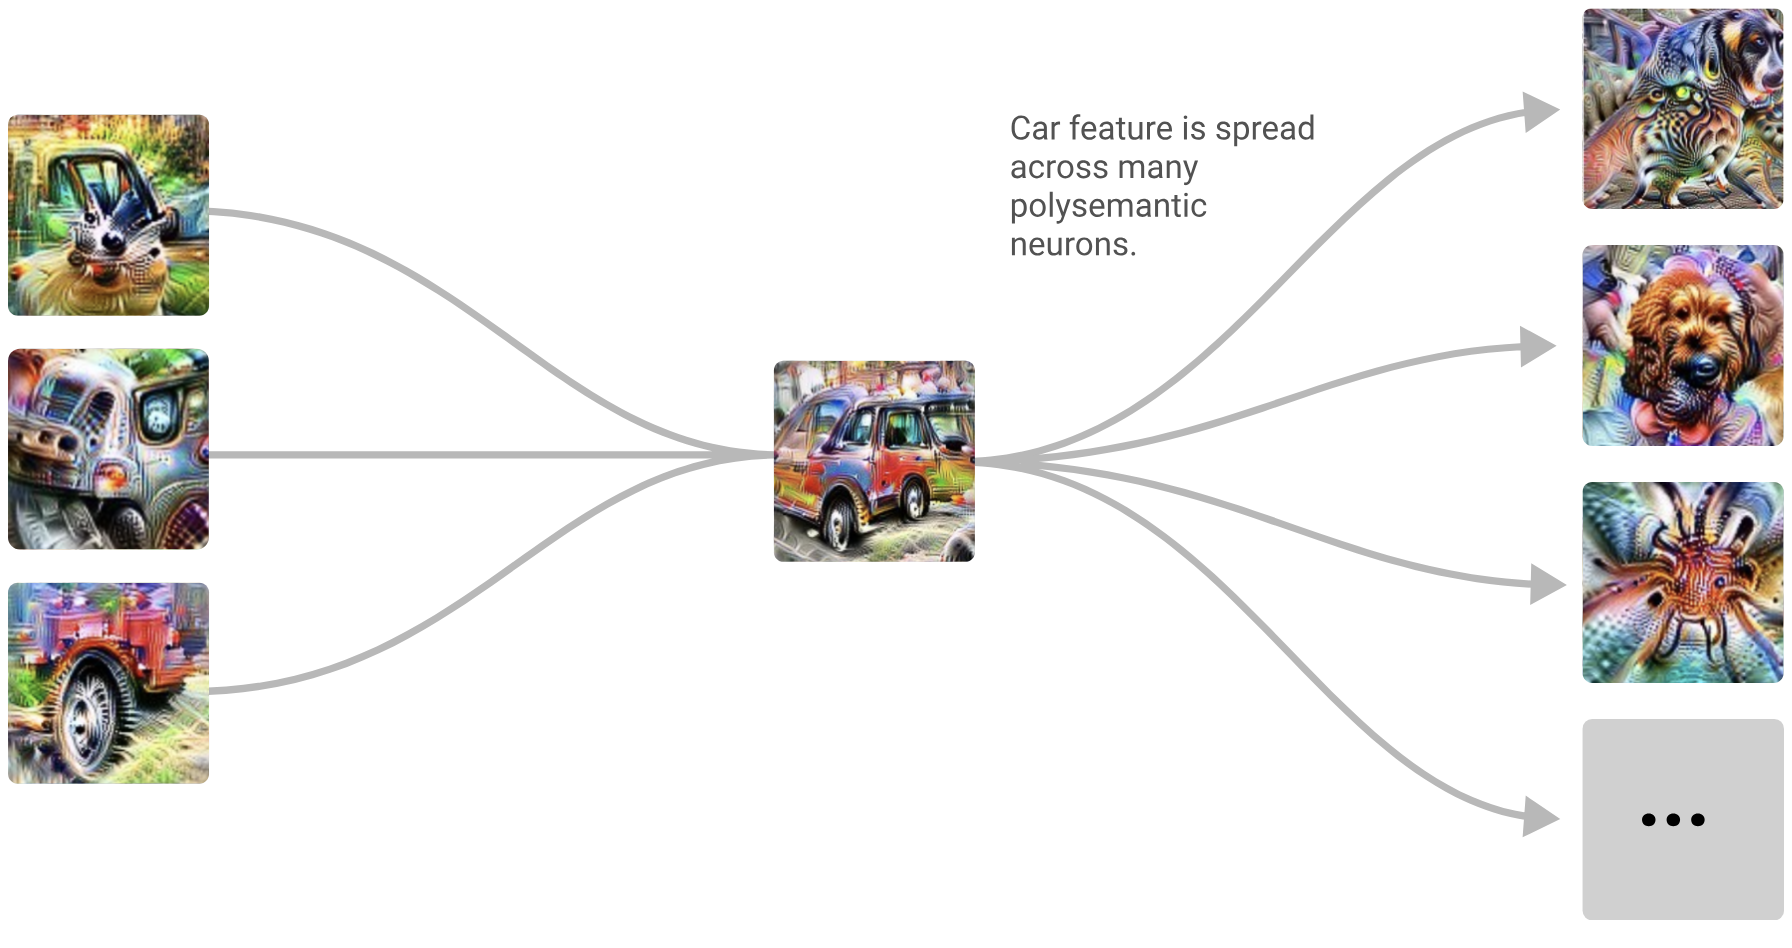
자동차 특징이 개 검출기를 비롯한 여러 뉴런에 퍼져 있는 회로.
이 회로는 다의적 뉴런이 어떤 의미에서 의도적임을 시사합니다. 어떤 이유로 모델 안에서 자동차와 개를 검출하는 과정이 깊이 얽혀 있어서 다의적 뉴런을 피하기 어려웠던 세상을 상상할 수도 있을 것입니다. 그러나 여기서 보는 것은, 모델이 “순수한 뉴런”을 가지고 있다가 그것을 다른 특징과 뒤섞었다는 점입니다.
우리는 이 현상을 중첩이라고 부릅니다.
모델은 왜 그런 일을 할까요? 중첩 덕에 모델이 더 적은 뉴런을 쓰고, 뉴런을 더 중요한 과제에 아낄 수 있다고 우리는 믿습니다. 자동차와 개가 함께 나오지 않는 한, 모델은 나중 층에서 개 특징을 정확히 되살릴 수 있으므로 뉴런을 따로 쓰지 않고도 그 특징을 저장할 수 있습니다.7
회로 모티프
InceptionV1과 다른 모델의 회로를 연구하면서, 우리는 같은 추상적 패턴이 되풀이되는 것을 보았습니다. 곡선 검출기에서 본 등변성. 자세에 불변인 개 머리 검출기에서 본 경우 합치기. 자동차 검출기에서 본 중첩.
생물학에서 회로 모티프[30]는 전사 네트워크나 생물학적 신경망 같은 복잡한 그래프에서 되풀이되는 패턴입니다. 모티프 하나를 이해하면 그 모티프가 나타나는 모든 그래프에 대해 연구자가 지렛대를 얻을 수 있으므로 유용합니다.
모티프 연구가 인공 신경망의 회로를 이해하는 데 중요해질 가능성이 꽤 높다고 우리는 생각합니다. 길게 보면 개별 회로를 연구하는 것보다 더 중요할 수도 있습니다. 동시에 모티프 연구는 먼저 잘 이해된 회로의 탄탄한 토대를 쌓은 뒤에 하는 편이 잘 풀리리라고 예상합니다.
주장 3: 보편성
비슷한 특징과 회로가 모델과 과제를 가로질러 형성됩니다.
자연 이미지로 훈련한 비전 모델의 첫 층이 Gabor 필터를 학습한다는 것은 널리 받아들여지는 사실입니다. 뒤쪽 층에 의미 있는 특징이 있음을 받아들인다면, 첫 층 너머의 층에서도 같은 특징이 형성된다는 것이 정말 놀라운 일일까요? 그리고 여러 층에 비슷한 특징이 있다고 믿게 되면, 그것들이 같은 방식으로 연결된다는 것이 자연스럽지 않을까요?
특징의 보편성(“수렴 학습”)은 전에도 제기된 바 있습니다. 서로 다른 신경망이 상관관계가 높은 뉴런을 발달시킬 수 있다는[31] 선행 연구와, 은닉층에서 비슷한 표현을 학습한다는[32, 33] 선행 연구가 있습니다. 이 연구들은 시사하는 바가 크지만, 비슷한 특징이 형성되는 데에는 다른 설명이 가능합니다. 예컨대 털 질감 검출기와 정교한 개 몸통 검출기처럼 본질적으로 다른 두 특징이 상관관계가 높을 수 있습니다. 의미 있는 특징에 회의적인 관점을 취하면 결정적이지 않아 보입니다.
이상적으로는 몇몇 특징을 규명한 다음, 상관된 특징만이 아니라 바로 그 특징들이 여러 모델에서 형성되고 있음을 엄밀하게 보이고 싶을 것입니다. 그리고 비슷한 회로가 형성된다는 것을 더 확립하려면, 여러 모델의 여러 층에 걸쳐 비슷한 특징을 찾아내고 각 모델에서 같은 가중치 구조가 형성됨을 보여야 할 것입니다.
안타깝게도 오늘 우리가 제시할 수 있는 증거는 일화적인 것뿐입니다. 특징과 회로를 비교 연구하는 데 아직 충분히 투자하지 않아 확신 있는 답을 줄 수 없습니다. 그렇더라도 몇 가지 저수준 특징은 다양한 비전 모델 구조(AlexNet, InceptionV1, InceptionV3, 잔차 신경망 포함)와, ImageNet 대신 Places365로 훈련한 모델에서 형성되는 듯하다는 것을 관찰했습니다. 또 ImageNet으로 처음부터 훈련한 평범한 합성곱 신경망에서도 이 특징이 반복해서 형성되는 것을 관찰했습니다.
곡선 검출기
AlexNet
Krizhevsky 외[34].
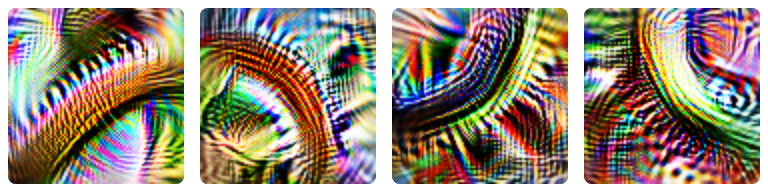
네 개 유닛의 특징 시각화(각각 OpenAI Microscope로 연결).
InceptionV1
Szegedy 외[26].
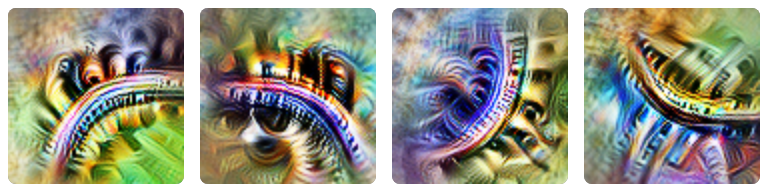
네 개 유닛의 특징 시각화(각각 OpenAI Microscope로 연결).
VGG19
Simonyan 외[35].
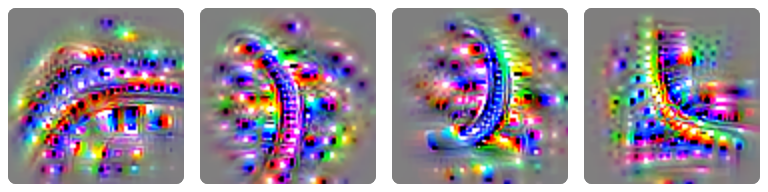
네 개 유닛의 특징 시각화(각각 OpenAI Microscope로 연결).
ResNetV2-50
He 외[36].
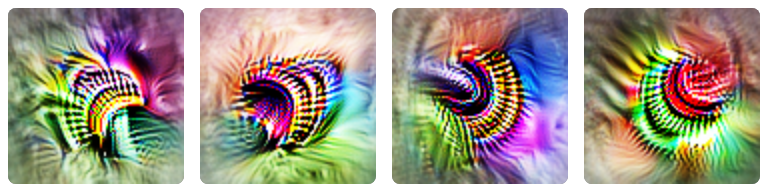
네 개 유닛의 특징 시각화(각각 OpenAI Microscope로 연결).
고저 주파수 검출기
AlexNet
Krizhevsky 외[34].
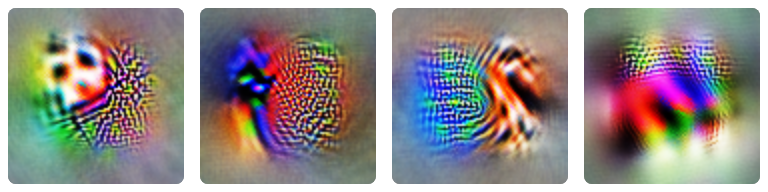
네 개 유닛의 특징 시각화(각각 OpenAI Microscope로 연결).
InceptionV1
Szegedy 외[26].
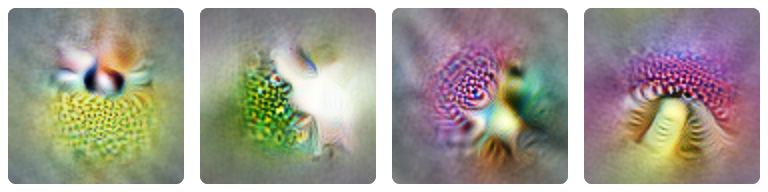
네 개 유닛의 특징 시각화(각각 OpenAI Microscope로 연결).
VGG19
Simonyan 외[35].
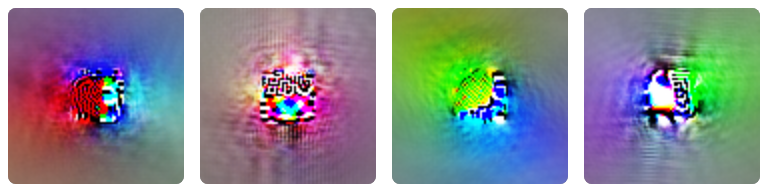
네 개 유닛의 특징 시각화(각각 OpenAI Microscope로 연결).
ResNetV2-50
He 외[36].
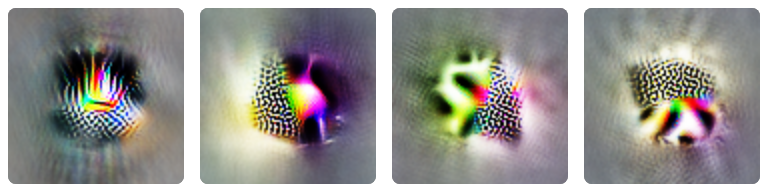
네 개 유닛의 특징 시각화(각각 OpenAI Microscope로 연결).
이런 결과를 보고 우리는 보편성 가설이 아마 참일 것이라고 짐작하게 되었습니다. 다만 일부 저수준 비전 특징에서 보이는 겉보기 보편성이 예외인지 원칙인지 이해하려면 더 많은 연구가 필요할 것입니다.
보편성 가설이 신경망에서 폭넓게 참으로 밝혀진다면, 이런 추측을 해 보고 싶어질 것입니다. 생물학적 신경망도 비슷한 특징을 학습하지 않을까? 신경과학과 딥러닝의 접점에서 일하는 연구자들은 인공 비전 모델의 유닛이 생물학적 뉴런을 모델링하는 데 쓸모 있을 수 있음을 이미 보였습니다[37–39]. 또 우리가 인공 신경망에서 발견한 특징 일부, 예컨대 곡선 검출기는 생물학적 신경망에도 존재한다고 여겨집니다(예: [40, 41]). 이는 낙관할 만한 큰 근거로 보입니다.8
회로 연구에 초점을 맞추면, 보편성이 정말 필요할까요? 앞의 두 주장과 달리 이 주장이 거짓으로 드러나도 회로 연구에 치명적이지는 않을 것입니다. 하지만 이 주장은 어떤 연구가 의미 있는가를 크게 좌우합니다. 우리는 회로를 “딥러닝의 세포생물학”으로 소개했습니다. 그런데 종마다 세포 소기관과 단백질이 전혀 다른 세상을 상상해 보세요. 그래도 세포 일반을 연구하는 것이 의미 있을까요, 아니면 특히 중요한 몇몇 종의 세포를 좁게 연구하는 데 그칠까요? 마찬가지로 동물 종마다 해부 구조가 전혀 무관한 세상에서 해부학을 연구한다고 상상해 봅시다. 사람과 몇몇 가축 말고 다른 것을 진지하게 연구할까요?
같은 이치로, 보편성 가설은 어떤 형태의 회로 연구가 의미 있는지를 정합니다. 가장 강한 의미에서 참이라면 모델들에 걸쳐 관찰하고 목록으로 만드는 일종의 “시각 특징 주기율표”를 상상할 수 있습니다. 반대로 대체로 거짓이라면 사회적으로 특히 중요한 소수의 모델에 집중하고, 그 모델들이 해마다 바뀌지 않기를 바라야 할 것입니다. 일부 교훈은 모델 사이에 전이되지만 나머지는 처음부터 배워야 하는 중간 세계도 있을 수 있습니다.
자연과학으로서의 해석 가능성
Thomas Kuhn의 『과학혁명의 구조』[42]는 과학의 역사와 사회학에 관한 고전입니다. 이 책에서 Kuhn은 과학 공동체에 패러다임이 있는 “정상 과학”과, 패러다임이 아예 없었거나 위기로 약해져서 없는 “비상 과학”을 구분합니다. “비상 과학”은 바람직한 상태가 아니라는 점을 짚어 둘 만합니다. 연구자들이 생산적이기 어려운 시기입니다.
패러다임 이전 분야에 대한 Kuhn의 묘사는 오늘날의 해석 가능성과 섬뜩할 만큼 닮은 듯합니다.9
연구 대상이 무엇인지, 그에 답하려면 어떤 방법을 써야 하는지, 연구 결과를 어떻게 평가할지에 합의가 없습니다. Ian Goodfellow와의 최근 인터뷰를 인용하면 이렇습니다. “해석 가능성에 대해서는 우리가 올바른 정의조차 갖고 있지 않다고 생각합니다.”[43]
패러다임 이전 분야에 있다는 것의 특히 어려운 점 하나는, 해석 가능성 연구를 어떻게 평가할지에 대한 공유된 감각이 없다는 것입니다. 이웃 분야의 기준을 빌려 이 문제를 다루자는 흔한 제안이 둘 있습니다. 일부 연구자, 특히 딥러닝 배경이 있는 연구자는 해석 가능성 방법이 얼마나 효과적인지 평가할 수 있는 “해석 가능성 벤치마크”를 원합니다. HCI 배경이 있는 다른 연구자들은 사용자 연구로 해석 가능성 방법을 평가하고 싶어 할 것입니다.
그러나 해석 가능성은 세 번째 패러다임, 곧 자연과학에서도 빌릴 수 있습니다. 이 관점에서 신경망은 경험적 조사의 대상이며, 생물학의 생물체와 비슷할 수도 있습니다. 이런 연구는 주어진 신경망에 대한 경험적 주장을 하려 하고, 그 주장은 반증 가능성이라는 기준으로 평가받을 수 있습니다.
해석 가능성과 시각화 연구를 이런 식으로 평가하는 모습을 왜 더 자주 보지 못할까요?10
특히 이런 틀을 채택하는 인접 머신러닝 연구가 이렇게 많은데도 말입니다! 한 가지 이유는 신경망 전체의 행동에 대해 확실하게 참인 진술을 하기가 매우 어렵다는 점일 것입니다. 신경망은 믿기 어려울 만큼 복잡한 대상입니다. 신경망에 대한 흥미로운 경험적 진술이 정확히 무엇일지 형식화하기도 어렵습니다. 그래서 우리는 참인 진술을 알아 가고 있는지보다 해석 가능성 방법이 쓸모 있는지를 겨냥한 평가 기준을 흔히 얻게 됩니다.
회로는 엄밀한 경험적 조사가 가능한 신경망의 아주 작은 부분 그래프에 초점을 맞춤으로써 이 어려움을 비껴갑니다. 이 진술들은 확실히 반증 가능합니다. 예를 들어 회로를 이해했다면 가중치를 편집했을 때 무엇이 바뀔지 예측할 수 있어야 합니다. 실제로 충분히 작은 회로라면 그 행동에 대한 진술은 수학적 추론의 문제가 됩니다. 물론 이런 엄밀함의 대가는 회로에 관한 진술이 모델 전체의 행동에 관한 진술보다 훨씬 범위가 작다는 것입니다. 하지만 충분히 노력하면 모델 행동에 관한 진술을 회로에 관한 진술들로 쪼갤 수 있을 듯합니다. 그렇다면 회로는 해석 가능성의 인식론적 토대 역할을 할 수 있을지 모릅니다.
맺음말
현미경이 중요한 과학 기구라는 것은 당연하게 여겨집니다. 사실상 과학의 상징이니까요. 그러나 늘 그랬던 것은 아니고, 현미경은 처음에 과학 도구로 곧바로 자리 잡지 못했습니다. 사실 약 오십 년 동안 방치되었던 듯합니다. 전환점은 Robert Hooke가 『Micrographia』[1]를 출간했을 때였습니다. 현미경으로 본 것들을 그린 그림 모음으로, 세포의 첫 그림도 담겨 있었습니다.
해석 가능성 학계에는 우리가 그다지 진지하게 받아들여지지 않는다는 불안이 있다고 우리는 느낍니다. 이 연구가 너무 질적이라는 것. 과학적이지 않다는 것. 그러나 현미경과 세포생물학의 교훈은 어쩌면 이것이 예상된 일이라는 점입니다. 세포의 발견은 질적인 연구 결과였습니다. 그래도 그것이 세상을 바꾸는 데 걸림돌이 되지 않았습니다.
이 글은 신경망의 내부 작동을 파고드는 열린 과학 협업의 짧은 글과 논평 모음인 회로 스레드의 일부입니다. 다음 글: InceptionV1 초기 비전 개관
용어집
이 글은 새 용어를 몇 가지 도입하고 흔하지 않은 용어도 씁니다. 도움이 되도록 다음 용어집을 제공합니다.
회로: 신경망의 부분 그래프. 노드는 뉴런이나 방향(뉴런의 선형 결합)에 해당합니다. 두 노드가 인접한 층에 있으면 둘 사이에 간선이 있습니다. 간선의 가중치는 그 뉴런들 사이의 가중치입니다(노드가 선형 결합이면 n₁ W n₂ᵀ 같은 것). 합성곱 층에서는 가중치가 층의 서로 다른 상대 위치에 대한 가중치를 나타내는 2차원 행렬입니다.
회로 모티프: 회로에서 발견되는, 되풀이되는 추상적 패턴. 등변성이나 경우 합치기가 그 예입니다. 시스템 생물학에서 회로 모티프를 쓰는 데서 영감을 받았습니다[30].
클라이언트 뉴런 또는 클라이언트 특징(Client Neuron or Client Feature): 뒤쪽 층에서 특정한 앞쪽 뉴런에 의존하는 뉴런. 예를 들어 원 검출기는 곡선 검출기의 클라이언트입니다.
방향: 한 층에 있는 뉴런의 선형 결합. 같은 말로, 한 층의 표현에 있는 벡터. 방향은 개별 뉴런(벡터 공간의 기저 방향)일 수 있습니다. 대상으로서의 방향에 대한 직관은 『해석 가능성의 구성 요소』[44](특히 “신경망은 무엇을 보는가?” 절)와 활성화 아틀라스[13]를 보세요.
하류 / 상류(Downstream / Upstream): 각각 뒤쪽 층에 / 앞쪽 층에 있다는 뜻.
등변성: 회로 맥락의 등변성(예: 등변 특징, 등변 회로)은 등변성에 관한 회로 글을 보세요. 수학의 더 일반적인 등변성 개념은 위키백과 등변 사상 문서를 보세요.
가족: 한 층에서 같은 것의 작은 변형을 검출하는 특징의 집합. 예를 들어 곡선 검출기는 서로 다른 방향의 곡선을 검출하는 가족으로 존재합니다.
특징: 입력의 스칼라 함수. 이 글에서 신경망 특징은 방향이고, 흔히 개별 뉴런일 뿐입니다. 신경망의 이런 특징이 대개 엄밀하게 연구할 수 있는 의미 있는 특징이라고 우리는 주장합니다(주장 1).
의미 있는 특징: 곡선의 존재나 축 처진 귀처럼 말로 설명할 수 있는 입력의 성질에 진짜로 반응하는 특징. 의미 있는 특징도 잡음이 있거나 불완전할 수 있습니다.
다의적 특징: 고양이/자동차 뉴런처럼 서로 무관한 여러 잠재 변수에 반응하는 특징. 여러 경우에 반응하는 “다면적 특징”의 특수한 경우로 볼 수 있지만, 자세에 불변인 개 머리 같은 “진짜” 다면적 특징과 다의적 뉴런을 모두 포함합니다. 순수와 대비됩니다.
순수 특징: 단 하나의 잠재 변수에만 반응하는 특징. 다의적과 대비됩니다.
보편 특징: 서로 다른 모델과 과제에서 믿을 만하게 형성되는 특징.
표현: 한 층의 모든 뉴런의 활성화가 이루는 벡터 공간으로, (뉴런 1의 활성화, 뉴런 2의 활성화, …) 꼴의 벡터를 가집니다. 표현은 그 층에 존재하는 모든 특징의 모음으로 생각할 수 있습니다. 비전 모델의 표현에 대한 직관은 활성화 아틀라스[13]를 보세요.
저자 기여
글쓰기: 이 글의 본문은 주로 Christopher Olah가 썼고, Clarity 팀 전체의 연구와 생각을 폭넓게 가져왔습니다. Nick Cammarata는 틀을 잡는 데 깊이 관여했고 최종 본문을 고쳤습니다.
연구: 이 글은 신경망이 특징을 어떻게 구현하는가에 대한 여러 사람의 연구에서 발전한 주제들을 풀어 쓴 것입니다. Chris는 2018년에 뉴런의 구현 메커니즘을 가중치 측면에서 이해하려는 첫 시도를 시작했고, 이 연구 노선을 가능하게 한 여러 도구를 개발했습니다. 이 작업은 Gabriel Goh가 이어받았는데, 지금 우리가 모티프라고 부르는 것 가운데 처음 것(전문화를 위해 음의 가중치를 쓰는 것)을 발견했고, 여러 뉴런 뒤의 메커니즘도 기술했습니다. 이 시점에 Nick Cammarata가 이 연구 노선을 넘겨받아 훨씬 크고 깊은 회로를 규명하고, 기계적으로 이해한 뉴런의 수를 크게 늘렸으며, 곡선 검출기에 대한 상세하고 엄밀한 규명을 수행했습니다. Nick은 시스템 생물학과의 연결도 도입했습니다. Ludwig Schubert는 고저 주파수 검출기를 상세히 분석했습니다. Chris는 내내 연구 조언과 멘토링을 했습니다.
인프라: Michael Petrov, Shan Carter, Ludwig, Nick은 우리 연구를 가능하게 한 여러 인프라 도구를 만들었습니다.
지난 경위
이 입문 글의 아이디어는 2019년 VISxAI에서 Chris Olah의 기조 강연으로 먼저 발표되었습니다. MILA, Vector Institute, Redwood Center for Neuroscience, 비공개 워크숍에서도 비공식적으로 발표되었습니다.
감사의 글
InceptionV1을 이해하려는 우리 작업은 모두 Alex Mordvintsev에게 빚지고 있습니다. 그의 초기 비전 모델 탐구가 우리가 지금도 따르는 길을 열었습니다. 우리 작업과 신경과학의 잠재적 연결에 대해 깊이 논의해 준 Nick Barry와 Sophia Sanborn에게, 그리고 Kuhn의 “패러다임 이전 과학”과 해석 가능성이라는 분야의 현재 상태 사이의 유사성을 지적해 준 Tom McGrath에게 깊이 감사합니다. Brice Menard의 세심한 의견과 비판도 이 글을 다듬는 데 매우 소중했습니다. Nick과 Sophia의 깊은 논의에 더해, 특히 우리 작업의 방법론적 약점에 관해 힘들게 얻은 교훈을 나눠 준 신경과학계의 관심에도 전반적으로 고마움을 느낍니다. 특히 2019년에 튜닝 곡선을 쓰지 말라고, 그리고 뉴런 가족의 중요성을 짚어 준 Brian Wandell에게 감사하며, 덕분에 우리 작업이 훨씬 탄탄해졌다고 생각합니다. 또한 Mareike Grotheer, Natalia Bilenko, Bruno Olshausen, Michael Eickenberg, Charles Frye, Philip Sabes, Paul Merolla, James Redd, Thong-Wei Koh, Ivan Alvarez의 의견과 지지에도 깊이 감사합니다. 우리는 신경과학계에서 배울 것이 많다고 생각하며 앞으로도 계속 배우게 되어 기쁩니다.
회로 작업의 특권 하나는 Distill 슬랙의 #circuits 채널에서 이루어진 열린 협업과 피드백이었습니다. Stefan Sietzen, Shahab Bakhtiari, Flora Liu에게서 받은 상세한 피드백에 특히 고마움을 느낍니다(Stefan은 이 아이디어 가운데 많은 것을 더 발전시켰고, 이 스레드의 앞으로 나올 글에서 그의 작업을 보게 되어 기쁩니다!). 이 글의 메타 과학과 틀 문제에 대해 많은 분의 의견에서 큰 도움을 받았으며, 특히 Arvind Satyanarayan, Miles Brundage, Amanda Askell, Aaron Courville, Martin Wattenberg의 의견에 감사합니다. 등변성에 대해 매우 유용한 의견을 준 Taco Cohen, Tess Smidt, Sara Sabour에게 감사합니다. 시스템 생물학과 회로 모티프에 대해 유익한 대화와 참고 문헌을 준 Nikita Obidin, Nick Barry, Chelsea Voss에게 감사합니다(Nikita와 Nick이 처음 Nick Cammarata에게 회로 모티프를 소개했습니다). 마지막으로 OpenAI의 제도적 지원과, Dario Amodei, Daniela Amodei, Jonathan Uesato, Laura Ball, Katarina Slama, Alethea Power, Jacob Hilton, Jacob Steinhardt, Tom Brown, Preetum Nakkiran, Ilya Sutskever, Ryan Lowe, Erin McCloskey, Eli Chen, Fred Hohman, Jason Yosinski, Pallavi Koppol, Reiichrio Nakano, Sam McCandlish, Daniel Dewey, Anna Goldie, Jochen Görtler, Hendrik Strobelt, Ravi Chunduru, Tom White, Roger Grosse, David Duvenaud, Daniel Burkhardt, Janelle Tam, Jeff Clune, Christian Szegedy, Alec Radford, Alex Ray, Evan Hubinger, Scott Gray, Augustus Odena, Mikhial Pavlov, Daniel Filan, Jascha Sohl-Dickstein, Kris Sankaran을 포함해 여러 기관의 동료와 친구들의 지지와 의견에 깊이 감사합니다.
참고문헌
- Hooke, R., 1666. 『Micrographia: or Some Physiological Descriptions of Minute Bodies Made by Magnifying Glasses. With Observations and Inquiries Thereupon』. The Royal Society.
- Karpathy, A., Johnson, J. and Fei-Fei, L., 2015. 「Visualizing and understanding recurrent networks」. arXiv:1506.02078.
- Erhan, D., Bengio, Y., Courville, A. and Vincent, P., 2009. 「Visualizing higher-layer features of a deep network」. University of Montreal, Vol 1341, pp. 3.
- Olah, C., Mordvintsev, A. and Schubert, L., 2017. 「Feature Visualization」. Distill.
- Simonyan, K., Vedaldi, A. and Zisserman, A., 2013. 「Deep inside convolutional networks: Visualising image classification models and saliency maps」. arXiv:1312.6034.
- Nguyen, A., Yosinski, J. and Clune, J., 2015. 「Deep neural networks are easily fooled: High confidence predictions for unrecognizable images」. CVPR, pp. 427–436.
- Mordvintsev, A., Olah, C. and Tyka, M., 2015. 「Inceptionism: Going deeper into neural networks」. Google Research Blog.
- Nguyen, A., Clune, J., Bengio, Y., Dosovitskiy, A. and Yosinski, J., 2016. 「Plug & play generative networks: Conditional iterative generation of images in latent space」. arXiv:1612.00005.
- Zeiler, M.D. and Fergus, R., 2014. 「Visualizing and understanding convolutional networks」. ECCV, pp. 818–833.
- Fong, R. and Vedaldi, A., 2017. 「Interpretable Explanations of Black Boxes by Meaningful Perturbation」. arXiv:1704.03296.
- Kindermans, P., Schutt, K.T., Alber, M., Muller, K. and Dahne, S., 2017. 「PatternNet and PatternLRP–Improving the interpretability of neural networks」. arXiv:1705.05598.
- Reif, E., Yuan, A., Wattenberg, M., Viegas, F.B., Coenen, A., Pearce, A. and Kim, B., 2019. 「Visualizing and Measuring the Geometry of BERT」. NeurIPS, pp. 8592–8600.
- Carter, S., Armstrong, Z., Schubert, L., Johnson, I. and Olah, C., 2019. 「Activation atlas」. Distill, Vol 4(3), pp. e15.
- Hohman, F., Park, H., Robinson, C. and Chau, D.H.P., 2019. 「Summit: Scaling Deep Learning Interpretability by Visualizing Activation and Attribution Summarizations」. IEEE TVCG, Vol 26(1), pp. 1096–1106.
- Mikolov, T., Sutskever, I., Chen, K., Corrado, G.S. and Dean, J., 2013. 「Distributed representations of words and phrases and their compositionality」. NeurIPS, pp. 3111–3119.
- Radford, A., Jozefowicz, R. and Sutskever, I., 2017. 「Learning to generate reviews and discovering sentiment」. arXiv:1704.01444.
- Zhou, B., Khosla, A., Lapedriza, A., Oliva, A. and Torralba, A., 2014. 「Object detectors emerge in deep scene cnns」. arXiv:1412.6856.
- Bau, D., Zhou, B., Khosla, A., Oliva, A. and Torralba, A., 2017. 「Network Dissection: Quantifying Interpretability of Deep Visual Representations」. CVPR.
- Donnelly, J. and Roegiest, A., 2019. 「On Interpretability and Feature Representations: An Analysis of the Sentiment Neuron」. ECIR, pp. 795–802.
- Jo, J. and Bengio, Y., 2017. 「Measuring the tendency of CNNs to Learn Surface Statistical Regularities」. arXiv:1711.11561.
- Geirhos, R., Rubisch, P., Michaelis, C., Bethge, M., Wichmann, F.A. and Brendel, W., 2018. 「ImageNet-trained CNNs are biased towards texture; increasing shape bias improves accuracy and robustness」. arXiv:1811.12231.
- Brendel, W. and Bethge, M., 2019. 「Approximating cnns with bag-of-local-features models works surprisingly well on imagenet」. arXiv:1904.00760.
- Ilyas, A., Santurkar, S., Tsipras, D., Engstrom, L., Tran, B. and Madry, A., 2019. 「Adversarial examples are not bugs, they are features」. NeurIPS, pp. 125–136.
- Morcos, A.S., Barrett, D.G., Rabinowitz, N.C. and Botvinick, M., 2018. 「On the importance of single directions for generalization」. arXiv:1803.06959.
- LeCun, Y., Bengio, Y. and Hinton, G., 2015. 「Deep learning」. Nature, Vol 521(7553), pp. 436–444.
- Szegedy, C., Liu, W., Jia, Y., Sermanet, P., Reed, S., Anguelov, D., Erhan, D., Vanhoucke, V., Rabinovich, A. and others, 2015. 「Going deeper with convolutions」. arXiv:1409.4842.
- Hubel, D.H. and Wiesel, T.N., 1962. 「Receptive fields, binocular interaction and functional architecture in the cat’s visual cortex」. The Journal of physiology, Vol 160(1), pp. 106–154.
- Carter, S. and Nielsen, M., 2017. 「Using Artificial Intelligence to Augment Human Intelligence」. Distill.
- Nguyen, A., Yosinski, J. and Clune, J., 2016. 「Multifaceted feature visualization: Uncovering the different types of features learned by each neuron in deep neural networks」. arXiv:1602.03616.
- Alon, U., 2019. 『An introduction to systems biology: design principles of biological circuits』. CRC press.
- Li, Y., Yosinski, J., Clune, J., Lipson, H. and Hopcroft, J.E., 2015. 「Convergent learning: Do different neural networks learn the same representations?」. FE@NIPS, pp. 196–212.
- Raghu, M., Gilmer, J., Yosinski, J. and Sohl-Dickstein, J., 2017. 「SVCCA: Singular Vector Canonical Correlation Analysis for Deep Learning Dynamics and Interpretability」. NeurIPS 30, pp. 6078–6087.
- Kornblith, S., Norouzi, M., Lee, H. and Hinton, G., 2019. 「Similarity of neural network representations revisited」. arXiv:1905.00414.
- Krizhevsky, A., Sutskever, I. and Hinton, G.E., 2012. 「ImageNet Classification with Deep Convolutional Neural Networks」. NeurIPS 25, pp. 1097–1105.
- Simonyan, K. and Zisserman, A., 2014. 「Very Deep Convolutional Networks for Large-Scale Image Recognition」. CoRR, abs/1409.1556.
- He, K., Zhang, X., Ren, S. and Sun, J., 2015. 「Deep Residual Learning for Image Recognition」. CoRR, abs/1512.03385.
- Yamins, D.L., Hong, H., Cadieu, C.F., Solomon, E.A., Seibert, D. and DiCarlo, J.J., 2014. 「Performance-optimized hierarchical models predict neural responses in higher visual cortex」. PNAS, Vol 111(23), pp. 8619–8624.
- Güçlü, U. and van Gerven, M.A., 2015. 「Deep neural networks reveal a gradient in the complexity of neural representations across the ventral stream」. Journal of Neuroscience, Vol 35(27), pp. 10005–10014.
- Eickenberg, M., Gramfort, A., Varoquaux, G. and Thirion, B., 2017. 「Seeing it all: Convolutional network layers map the function of the human visual system」. NeuroImage, Vol 152, pp. 184–194.
- Jiang, R., Li, M. and Tang, S., 2019. 「Discrete neural clusters encode orientation, curvature and corners in macaque V4」. bioRxiv.
- Pasupathy, A. and Connor, C.E., 2001. 「Shape representation in area V4: position-specific tuning for boundary conformation」. Journal of neurophysiology, Vol 86(5), pp. 2505–2519.
- Kuhn, T.S., 1962. 『The structure of scientific revolutions』. University of Chicago press.
- Goodfellow, I. and Fridman, L., 2019. 「Ian Goodfellow: Generative Adversarial Networks」. Artificial Intelligence Podcast.
- Olah, C., Satyanarayan, A., Johnson, I., Carter, S., Schubert, L., Ye, K. and Mordvintsev, A., 2018. 「The Building Blocks of Interpretability」. Distill.
수정과 정정, 재사용, 인용
실수를 발견했거나 고칠 점을 제안하려면 GitHub에 이슈를 만들어 주세요.
글과 도식은 별도 표기가 없으면 Creative Commons Attribution CC-BY 4.0이고 원본은 GitHub에 공개되어 있습니다. 다른 곳에서 가져온 그림은 이 라이선스에 속하지 않으며, 캡션에 적힌 “Figure from …” 표기로 알아볼 수 있습니다.
학술적 맥락에서 출처를 밝히려면 이 글을 다음과 같이 인용해 주세요: Olah, et al., “Zoom In: An Introduction to Circuits”, Distill, 2020. DOI: 10.23915/distill.00024.001
각주
-
“방향”은 한 층에 있는 뉴런의 선형 결합을 뜻합니다. 주어진 층의 뉴런 활성화가 이루는 벡터 공간에서의 방향 벡터라고 생각해도 됩니다. 개별 뉴런을 이야기하는 것이 가장 유용할 때가 많지만, 특히 뉴런이 “다의적”일 때처럼 다른 결합으로 신경망을 분석하는 편이 더 유용한 경우도 있음을 보게 될 것입니다. (자세한 정의는 용어집의 방향을 보세요.) ↩
-
“회로”는 신경망의 계산 부분 그래프입니다. 특징들의 집합과, 원래 신경망에서 그 특징들 사이를 잇는 가중 간선으로 이루어집니다. 우리가 연구하는 회로는 아주 작은 경우가 많아서(예를 들어 특징이 열두 개 미만) 크기가 훨씬 큰 회로도 가능하지만 작은 것을 주로 다룹니다. (자세한 정의는 용어집의 회로를 보세요.) ↩
-
의미 있는 특징을 둘러싼 학계의 의견 불일치는 정확히 짚기 어렵고 문헌에도 일부만 드러나 있습니다. 딥러닝의 기초적인 서술은 신경망이 의미 있는 특징의 위계를 검출한다고 설명하는 경우가 많고[25], 여러 분야에서 의미 있어 보이는 특징을 보여 주는 논문이 여러 편 나왔습니다[2, 4, 15–18]. 동시에 신경망이 주로 또는 오로지 질감, 국소 구조, 눈에 보이지 않는 패턴에 집중한다고 시사하는 회의적인 병렬 문헌이 발전했고[20–23], 의미 있는 특징이 있더라도 해석할 수 없는 특징보다 덜 중요하며[24], 해석 가능해 보이는 뉴런이 잘못 이해되고 있을 수 있다고 합니다[19]. 이런 논문 다수가 매우 미묘한 견해를 표현하지만 늘 그렇게 이해되어 온 것은 아닙니다. 이런 견해의 강한 버전을 받아들이는 언론 기사가 여러 편 쓰였고, 신경망이 질감 이상은 아무것도 이해하지 못한다는 믿음이 꽤 흔하다는 것을 일화로 알고 있습니다. 끝으로 사람들은 자기 견해를 정확히 표현하는 데 어려움을 겪는 경우가 많은데, “대상과 높은 상관관계가 있는 질감 검출기”와 “대상 검출기”의 미묘한 차이를 표현할 분명한 언어가 없기 때문입니다. ↩
-
다의적 뉴런이 왜 그렇게 어려울까요? 의미가 다섯 개인 뉴런 하나가 의미가 다섯 개인 다른 뉴런과 연결되면, 사실상 개별로 따질 수 없는 연결이 25개가 됩니다. ↩
-
이 글에서 논의하는 뉴런 다수는 곡선 검출기를 포함해, 채널 수를 작은 병목으로 줄이는 1x1 합성곱 뒤에 3x3 또는 5x5 합성곱이 오는 구조의 InceptionV1 가지에 있습니다. 이 글에서 제시하는 가중치는 1x1 합성곱과 더 큰 합성곱의 가중치를 곱해 푼 버전입니다. 이를 하나의 낮은 랭크 가중치 행렬로 보는 것이 유용할 때가 많다고 생각하지만, 엄밀하게는 ReLU 비선형성 하나를 무시하게 됩니다. ↩
-
분명히 해 두자면, 머리의 구성 요소가 왼쪽 및 오른쪽 경로를 거치지 않고 이후의 머리 검출기에 영향을 주는 더 직접적인 경로도 있습니다. ↩
-
근본적으로 이는 고차원 공간의 기하가 가진 성질입니다. 이런 공간에는 직교 벡터가 n개뿐이지만 거의 직교인 벡터는 지수적으로 많이 있습니다. ↩
-
특히 흥미로운 가능성 하나는, 인공 신경망이 이전에 알려지지 않았지만 나중에 생물에서 발견되는 특징을 예측할 수 있는 경우일 것입니다. (우리가 이야기해 본 일부 신경과학자는 고저 주파수 검출기가 그 후보일 수 있다고 했습니다.) 그런 예측이 가능하다면 보편성 가설에 대한 매우 강력한 증거가 될 것입니다. ↩
-
우리는 DeepMind의 Tom McGrath과의 대화에서 Kuhn의 연구와 이 연결을 알게 되었습니다. ↩
-
분명히 해 두자면, 특히 이전의 해석 가능성 연구에서 이런 자연과학적 접근을 취하는 연구자들이 있습니다. 지금은 덜 흔해 보일 뿐입니다. ↩