Quentin Anthony 외: 트랜스포머 수학 101Quentin Anthony et al.: Transformer Math 101
트랜스포머 학습에 드는 계산량 6PD, 파라미터와 데이터셋 크기의 균형, 추론과 학습에 필요한 메모리(가중치, 옵티마이저 상태, 그래디언트, 활성값), 그리고 ZeRO와 3D 병렬화를 썼을 때의 메모리 어림식까지 한자리에 모은 EleutherAI의 글We present basic math related to computation and memory usage for transformers
Contents목차
번역문 · 원저자: Quentin Anthony, Stella Biderman, Hailey Schoelkopf (EleutherAI) · 원문: Transformer Math 101 · 원문 라이선스: CC BY 4.0. 원문을 한국어로 옮긴 것 말고는 내용을 바꾸지 않았습니다. 원문 그림 6개 중 원문 글쓴이들이 직접 측정해 그린 그래프 1개는 글과 같은 CC BY 4.0을 따르므로 실었습니다. 나머지 5개는 다른 논문이나 자료에서 가져온 그림으로 보이는데 이 글에서 쓸 수 있는지 확인하지 못해 싣지 않았고, 그 자리에는 설명만 남겼습니다. 이 5개는 원문에서 볼 수 있습니다.
원문: 「Transformer Math 101」, Quentin Anthony, Stella Biderman, Hailey Schoelkopf, EleutherAI 블로그, https://blog.eleuther.ai/transformer-math/, 2023년 4월 18일 게시. 이 글은 원문을 한국어로 옮긴 번역문입니다.
라이선스: 원문 사이트 바닥글에 “웹사이트는 CC BY 4.0 라이선스를 따른다”고 적혀 있습니다. 이 번역도 원저작자를 밝히고 CC BY 4.0 조건에 따라 싣습니다. 수식 안의 영어 이름(Model Memory 같은 것)도 원문대로 두었습니다.
트랜스포머의 계산량과 메모리 사용량에 관한 기본 수학을 소개합니다.
들어가며
트랜스포머 언어 모델에 관한 기본적이고 중요한 정보 가운데 상당수는 꽤 간단하게 계산할 수 있습니다. 아쉽게도 그 계산식이 NLP 커뮤니티에 널리 알려져 있지 않습니다. 이 문서의 목적은 그 식들을, 식이 어디서 나왔고 왜 중요한지에 관한 지식과 함께 한데 모으는 것입니다.
참고: 이 글은 주로 학습 비용을 다루며, 학습 비용은 VRAM을 어떻게 따지느냐가 좌우합니다. 지연 시간에 초점을 맞춰 추론 비용을 비슷하게 다룬 글이 궁금하다면 Kipply가 쓴 이 훌륭한 블로그 글을 보세요.
계산 요구량
트랜스포머 모델을 학습하는 비용을 나타내는 기본 식은 다음과 같습니다.
여기서
- 는 트랜스포머 모델을 학습하는 데 필요한 계산량으로, 전체 부동소수점 연산 수입니다.
-
- 는 하드웨어 구성 전체의 총 처리량()으로, 단위는 FLOPs입니다.
- 는 모델 학습에 쓴 시간으로, 단위는 초입니다.
- 는 트랜스포머 모델의 파라미터 수입니다.
- 는 데이터셋 크기로, 단위는 토큰입니다.
이 식들은 OpenAI의 스케일링 법칙 논문과 DeepMind의 스케일링 법칙 논문에서 제안되고 실험으로 검증되었습니다. 더 자세한 내용은 각 논문을 보세요.
여기서 잠깐 옆길로 새서 의 단위를 이야기해 볼 만합니다. 는 전체 계산량을 재는 값이지만, 여러 단위로 잴 수 있습니다. 예를 들면 다음과 같습니다.
- FLOP-초. 단위는 입니다.
- GPU-시간. 단위는 입니다.
- 스케일링 법칙 논문들은 흔히 페타플롭-일 단위, 곧 전체 부동소수점 연산 회 단위로 값을 보고합니다.
염두에 두면 좋은 구분 하나는 (실제 FLOPs)라는 개념입니다. GPU 가속기 백서는 보통 이론상 FLOPs를 내세우지만, 실제로는 결코 그 값에 이르지 못합니다(분산 환경에서는 더더욱 그렇습니다!). 분산 학습 환경에서 흔히 보고되는 값 몇 가지는 아래 계산 비용 절에 적어 두었습니다.
이 글에서는 LLM 학습 비용을 다룬 이 멋진 블로그 글에서 쓴 것처럼, 비용 식을 처리량과 시간으로 나타낸 형태로 씁니다.
파라미터 수와 데이터셋 크기의 맞바꿈
엄밀히 말하면 트랜스포머는 원하는 만큼 많은 토큰으로 학습할 수 있습니다. 하지만 학습하는 토큰 수가 계산 비용과 최종 모델 성능 모두에 크게 영향을 줄 수 있어서, 알맞은 균형을 잡는 것이 중요합니다.
먼저 다들 알지만 말하지 않는 문제, “계산 최적” 언어 모델부터 이야기하겠습니다. 파라미터 수에 관한 지금의 통념을 만든 논문 속 모델 시리즈의 이름을 따서 흔히 “친칠라 스케일링 법칙”이라고 부르는데, 계산 최적 언어 모델은 파라미터 수와 데이터셋 크기가 근사식 를 만족하는 모델입니다. 이것이 최적인 의미는 아주 좁습니다. GPU 1,000개를 1시간 쓰는 것과 GPU 1개를 1,000시간 쓰는 것의 비용이 같은 자원 조건에서, 모델 학습에 드는 GPU-시간 비용을 최소로 하면서 성능을 최대로 끌어올리는 것이 목표라면 위 식을 쓰면 됩니다.
LLM을 2,000억 토큰보다 적게 학습하는 것은 권하지 않습니다. 많은 모델에서 그 정도가 “친칠라 최적”이긴 하지만, 그렇게 나온 모델은 대개 꽤 형편없습니다. 거의 모든 응용에서, 쓰임새에 맞는 추론 비용이 어느 정도인지 먼저 정하고, 그 추론 비용을 넘지 않는 가장 큰 모델을 되도록 많은 토큰으로 학습하기를 권합니다.
계산 비용에 관한 엔지니어링 요점
트랜스포머의 계산 비용은 보통 GPU-시간이나 FLOP-초로 나타냅니다.
- GPT-NeoX는 일반 어텐션으로 A100 한 장당 150 TFLOP/s, Flash Attention으로 A100 한 장당 180 TFLOP/s를 냅니다. 이는 대규모에서 고도로 최적화된 다른 라이브러리들과 비슷한 수준입니다. 예를 들어 Megatron-DS는 A100 한 장당 137에서 163 TFLOP/s를 보고합니다.
- 일반적인 경험칙으로, A100 한 장당 대략 120 TFLOP/s는 늘 낼 수 있어야 합니다. A100 한 장당 115 TFLOP/s보다 낮게 나온다면 모델이나 하드웨어 구성 어딘가에 문제가 있을 가능성이 큽니다.
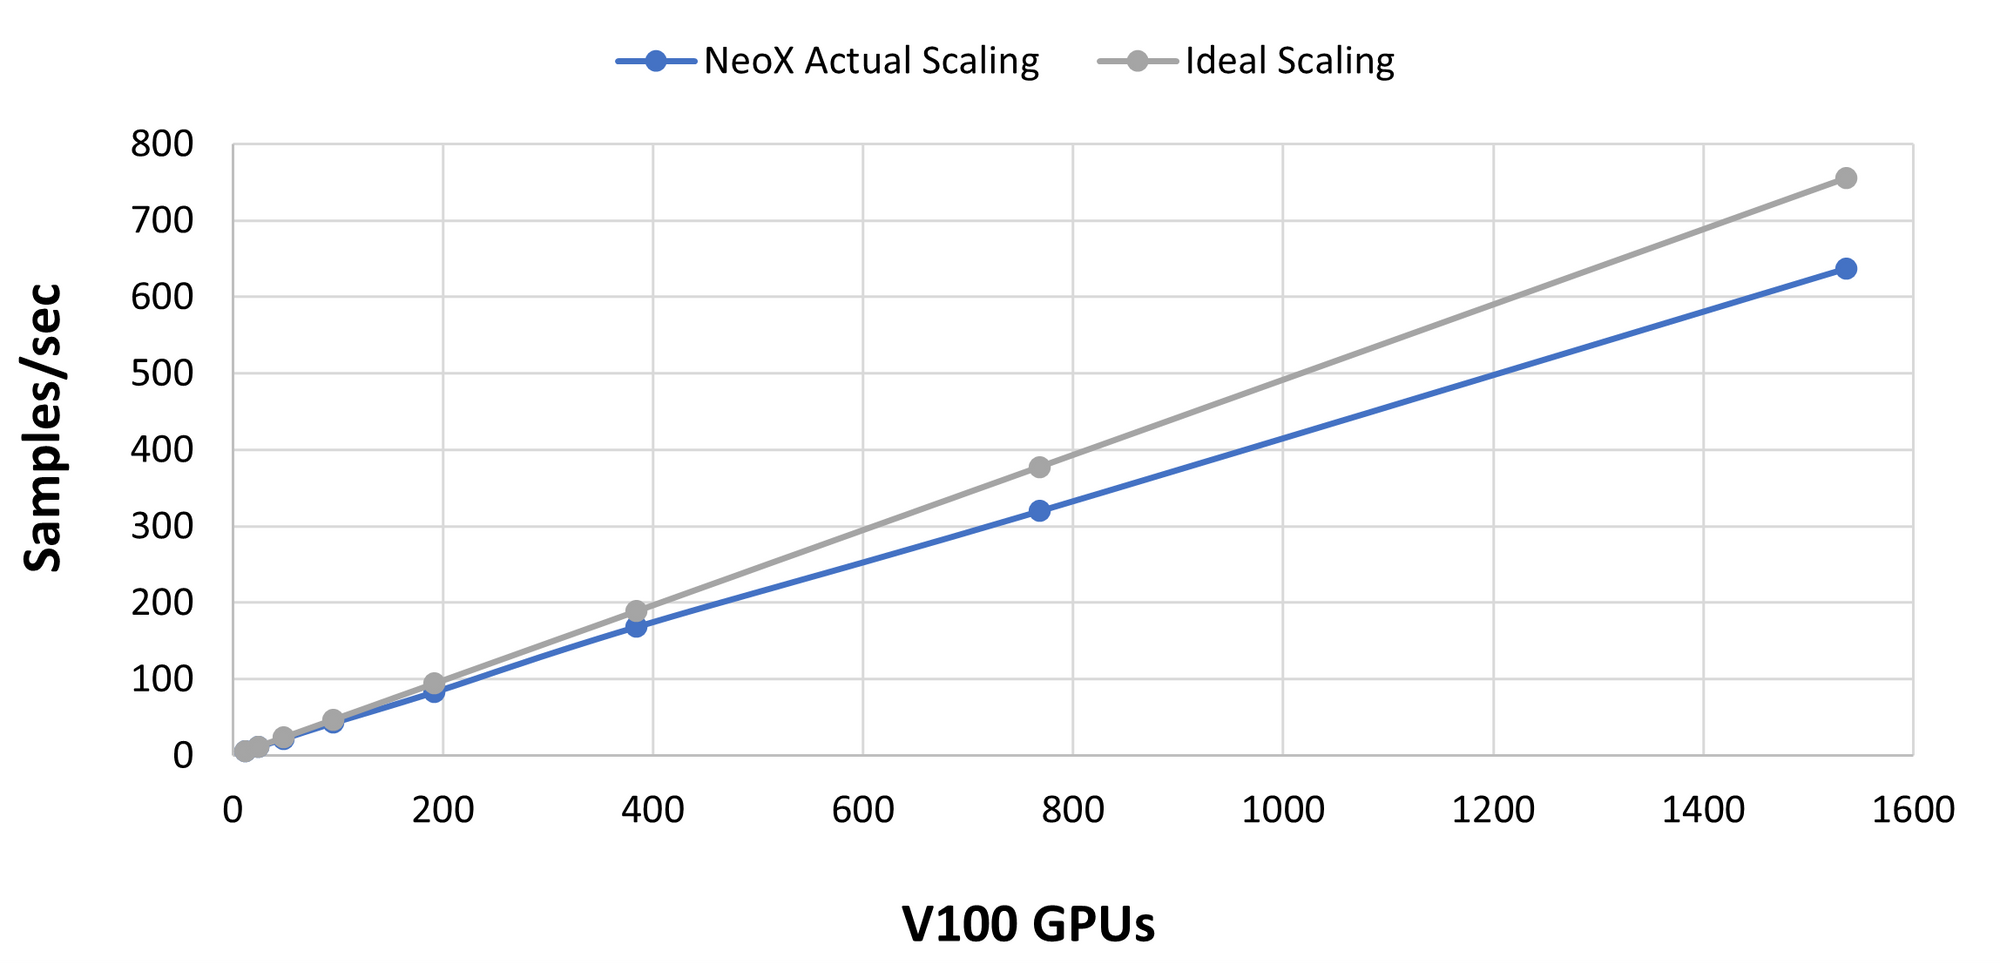
- InfiniBand 같은 고품질 인터커넥트를 쓰면, 데이터 병렬 차원에서 선형 또는 그에 가까운 확장을 얻을 수 있습니다(곧 데이터 병렬 정도를 늘리면 전체 처리량이 거의 선형으로 늘어나야 합니다). 아래는 Oak Ridge 국립연구소의 Summit 슈퍼컴퓨터에서 GPT-NeoX 라이브러리를 시험한 그래프입니다. x축은 V100 수이고, 이 글의 수치 예시는 대부분 A100 기준이라는 점에 유의하세요.
메모리 요구량
트랜스포머는 보통 파라미터 수로 나타낸 크기로 설명합니다. 하지만 주어진 계산 자원에 어떤 모델이 들어갈지 정하려면 모델이 바이트로 얼마만큼의 공간을 차지할지 알아야 합니다. 그래야 내 로컬 GPU에서 추론할 때 얼마나 큰 모델이 들어가는지, 또는 일정한 가속기 메모리 총량을 가진 클러스터에서 얼마나 큰 모델을 학습할 수 있는지 알 수 있습니다.
추론
모델 가중치
[그림: 여러 부동소수점 형식(fp32, fp16, bf16 등)이 부호, 지수, 가수에 각각 몇 비트를 쓰는지, 그래서 정밀도와 표현 범위가 어떻게 다른지 비교한 그림]
대부분의 트랜스포머는 fp16 + fp32나 bf16 + fp32 같은 혼합 정밀도로 학습합니다. 이렇게 하면 모델 학습에 필요한 메모리도, 추론에 필요한 메모리도 줄어듭니다. 언어 모델은 fp32에서 fp16으로, 심지어 int8로 바꾸어도 성능이 크게 떨어지지 않습니다. 이 숫자들은 파라미터 하나에 필요한 크기를 비트로 나타낸 것입니다. 1바이트는 8비트이므로, 이 숫자를 8로 나누면 파라미터 하나에 몇 바이트가 필요한지 알 수 있습니다.
- int8에서는
- fp16과 bf16에서는
- fp32에서는
추론에 드는 전체 메모리
모델 가중치를 저장하는 데 필요한 메모리 말고도, 실제로 순전파를 할 때 약간의 추가 오버헤드가 있습니다. 저희 경험으로는 이 오버헤드가 20% 이하이고, 내 GPU에 들어가는 가장 큰 모델이 무엇인지 정할 때는 대개 신경 쓰지 않아도 됩니다.
정리하면, “이 모델이 추론용으로 들어갈까”라는 질문에 대한 좋은 어림 답은 다음과 같습니다.
이 오버헤드가 어디서 오는지는 이 글에서 따지지 않고 당분간 다른 글이나 다른 곳에 맡기겠습니다. 이 글의 나머지에서는 모델 학습에 드는 메모리에 집중합니다. 추론에 필요한 계산을 더 알고 싶다면 추론을 깊이 다룬 이 환상적인 블로그 글을 보세요. 이제 학습으로 넘어갑시다!
학습
학습할 때는 모델 파라미터 말고도 옵티마이저 상태와 그래디언트를 장치 메모리에 저장해야 합니다. 그래서 “모델 X를 올리려면 메모리가 얼마나 필요한가”라고 물으면 곧바로 “학습이냐 추론이냐에 따라 다르다”는 답이 돌아옵니다. 학습에는 언제나 추론보다 메모리가 더 들고, 흔히 훨씬 더 많이 듭니다!
모델 파라미터
먼저, 모델은 순수 fp32나 순수 fp16으로 학습할 수 있습니다.
- 순수 fp32에서는
- 순수 fp16에서는
추론 절에서 다룬 흔한 모델 가중치 데이터 타입 말고도, 학습에서는 AMP 같은 혼합 정밀도 학습이 등장합니다. 이 기법은 수렴을 유지하면서 GPU 텐서 코어의 처리량을 최대로 끌어올리려는 것입니다. 요즘 딥러닝 학습에서 혼합 정밀도 학습을 자주 쓰는 까닭은 이렇습니다. 1) fp32 학습은 안정적이지만 메모리 오버헤드가 크고 NVIDIA GPU의 텐서 코어를 활용하지 못하며, 2) fp16 학습은 안정적이지만 수렴시키기 어렵습니다. 혼합 정밀도 학습에 관해 더 알고 싶다면 tunib-ai의 이 노트북을 읽어 보기를 권합니다. 혼합 정밀도에서는 모델의 fp16/bf16 버전과 fp32 버전을 모두 메모리에 저장해야 하므로, 다음이 필요합니다.
- 혼합 정밀도(fp16/bf16과 fp32)에서는
여기에 더해 크기가 인 모델 사본이 하나 더 필요한데, 이것은 옵티마이저 상태 안에 넣어 셉니다.
옵티마이저 상태
Adam은 마법 같지만, 메모리 면에서는 매우 비효율적입니다. 모델 파라미터와 그래디언트 파라미터의 사본을 갖고 있어야 할 뿐 아니라, 그래디언트 파라미터의 사본을 세 개 더 갖고 있어야 합니다. 따라서
- 일반 AdamW에서는
- 파라미터의 fp32 사본: 파라미터당 4바이트
- 모멘텀: 파라미터당 4바이트
- 분산: 파라미터당 4바이트
- bitsandbytes 같은 8비트 옵티마이저에서는
- 파라미터의 fp32 사본: 파라미터당 4바이트
- 모멘텀: 파라미터당 1바이트
- 분산: 파라미터당 1바이트
- 모멘텀을 쓰는 SGD 계열 옵티마이저에서는
- 파라미터의 fp32 사본: 파라미터당 4바이트
- 모멘텀: 파라미터당 4바이트
그래디언트
그래디언트는 fp32나 fp16으로 저장할 수 있습니다(그래디언트의 데이터 타입은 흔히 모델의 데이터 타입과 같습니다. 그래서 fp16 혼합 정밀도 학습에서는 그래디언트가 fp16으로 저장됩니다). 따라서 그래디언트가 메모리 오버헤드에 더하는 몫은 다음과 같습니다.
- fp32에서는
- fp16에서는
활성값과 배치 크기
요즘 GPU로 LLM을 학습할 때 병목은 보통 FLOPs가 아니라 메모리입니다. 그래서 활성값 재계산(체크포인팅)은 계산 비용을 더 들이는 대신 메모리 비용을 줄이는, 아주 인기 있는 방법입니다. 활성값 재계산(체크포인팅)은 특정 층의 활성값을 GPU 메모리에 저장하는 대신 다시 계산하는 방식으로 작동합니다. 메모리가 얼마나 줄어드는지는 어떤 층을 비울지 얼마나 골라서 정하느냐에 달려 있는데, Megatron의 선택적 재계산 방식은 아래 그림과 같습니다.
[그림: 모델 크기(22B, 175B, 530B, 1T)별로 파라미터·옵티마이저 상태 메모리와 활성값 메모리를 쌓은 막대로 기준선과 “present work”를 비교하고, A100-80GB의 용량을 빨간 점선으로 표시한 그래프. 선택적 활성값 재계산을 적용한 “present work” 막대는 활성값 몫이 크게 줄어 모두 점선 아래에 있다]
빨간 점선은 A100-80GB GPU의 메모리 용량을 나타내고, “present work”는 선택적 활성값 재계산을 적용한 뒤의 메모리 요구량을 나타냅니다. 자세한 내용과 아래 식의 유도는 Reducing Activation Recomputation in Large Transformer Models를 보세요.
트랜스포머 모델의 활성값을 저장하는 데 필요한 메모리를 나타내는 기본 식은 다음과 같습니다.
여기서
- 는 시퀀스 길이로, 단위는 토큰입니다.
- 는 GPU 한 장당 배치 크기입니다.
- 는 각 트랜스포머 층의 은닉 차원 크기입니다.
- 은 트랜스포머 모델의 층 수입니다.
- 는 트랜스포머 모델의 어텐션 헤드 수입니다.
- 는 사용하는 텐서 병렬화 정도입니다(쓰지 않으면 1).
- 시퀀스 병렬화는 쓰지 않는다고 가정합니다.
- 활성값은 fp16으로 저장한다고 가정합니다.
재계산 때문에 더 드는 계산량도 방법이 얼마나 선택적이냐에 달려 있지만, 그 상한은 순전파 한 번을 통째로 더 하는 것입니다. 따라서 순전파 비용은 다음과 같이 바뀝니다.
학습에 드는 전체 메모리
따라서 “이 모델이 학습용으로 들어갈까”라는 질문에 대한 좋은 어림 답은 다음과 같습니다.
분산 학습
샤딩 옵티마이저
옵티마이저의 막대한 메모리 오버헤드는 ZeRO나 FSDP 같은 샤딩 옵티마이저가 나온 주된 동기입니다. 이런 샤딩 전략은 옵티마이저 오버헤드를 배만큼 줄입니다. 그래서 어떤 모델 구성이 큰 규모에서는 들어가는데 작은 규모에서는 OOM(메모리 부족)이 날 수 있습니다. 샤딩 옵티마이저를 써서 학습할 때 필요한 메모리 오버헤드를 계산하려면, 아래 그림에 있는 식들을 넣어야 합니다. 샤딩 최적화를 계산한 몇 가지 예로 ZeRO 논문의 다음 그림을 보세요(, , 는 흔히 각각 ZeRO-1, ZeRO-2, ZeRO-3이라고 부릅니다. ZeRO-0은 흔히 “ZeRO를 끈 상태”를 뜻합니다).
[그림: ZeRO 논문의 그림. 기준선, ZeRO-1, ZeRO-2, ZeRO-3에서 GPU 0부터 N-1까지 각 GPU가 파라미터, 그래디언트, 옵티마이저 상태를 얼마나 들고 있는지 색 막대로 비교한다. 단계가 올라갈수록 GPU마다 남는 몫이 줄어든다]
[그림: 위 ZeRO 그림의 범례. 막대 색이 파라미터, 그래디언트, 옵티마이저 상태 가운데 무엇을 뜻하는지 보여 준다]
이 글의 용어로 나타내면 다음과 같습니다(혼합 정밀도와 Adam 옵티마이저를 쓴다고 가정합니다).
- ZeRO-1에서는
- ZeRO-2에서는
- ZeRO-3에서는
파이프라인 병렬화나 텐서 병렬화를 쓰지 않는 한 는 그냥 와 같습니다. 자세한 내용은 Sharded Optimizers + 3D Parallelism을 보세요.
ZeRO-3에는 라이브 파라미터라는 묶음이 생긴다는 점에 유의하세요. ZeRO-3에는 한 번에 GPU 메모리에 올라와 있는 파라미터 수를 조절하는 설정 옵션들(stage3_max_live_parameters, stage3_max_reuse_distance, stage3_prefetch_bucket_size, stage3_param_persistence_threshold)이 있기 때문입니다(값이 클수록 메모리를 더 쓰지만 통신은 덜 필요합니다). 이 파라미터들은 전체 GPU 메모리에 크게 영향을 줄 수 있습니다.
ZeRO는 ZeRO-R을 통해 활성값도 데이터 병렬 랭크들에 나눠 둘 수 있다는 점도 기억하세요. 그러면 도 텐서 병렬화 정도 로 나뉘게 됩니다. 자세한 내용은 관련 ZeRO 논문과 설정 옵션을 읽어 보세요(GPT-NeoX에서는 partition_activations 플래그입니다). 아주 큰 모델을 학습하고 있어서 활성값이 병목이 된다면, 통신 비용을 조금 더 들이는 대신 메모리 오버헤드를 줄이고 싶을 것입니다. ZeRO-R을 ZeRO-1과 함께 쓰는 예는 다음과 같습니다.
3D 병렬화
LLM의 병렬화에는 크게 세 가지 형태가 있습니다.
데이터 병렬화: 데이터를 모델의 복제본들(각 복제본은 모델 병렬화된 것일 수도 있습니다)에 나눠 줍니다.
파이프라인 병렬화 또는 텐서/모델 병렬화: 이 병렬화 방식들은 모델의 파라미터를 여러 GPU에 나눕니다. 이런 방식은 통신 오버헤드가 상당하지만, 메모리는 대략 다음만큼 줄어듭니다.
이 식이 근사인 까닭은 다음과 같습니다. (1) 파이프라인 병렬화는 활성값의 메모리 사용량을 줄여 주지 않습니다. (2) 파이프라인 병렬화에서는 모든 GPU가 처리 중인 모든 마이크로배치의 활성값을 저장해야 하는데, 큰 모델에서는 이것이 상당해집니다. (3) GPU는 병렬화 방식에 필요한 추가 통신 버퍼를 잠시 저장해야 합니다.
샤딩 옵티마이저와 3D 병렬화
ZeRO를 텐서 병렬화나 파이프라인 병렬화, 또는 둘 다와 함께 쓰면, 그 결과로 나오는 병렬화 전략은 다음과 같은 격자(메시)를 이룹니다.
[그림: GPU들을 데이터 병렬, 파이프라인 병렬, 텐서 병렬의 세 축으로 배치한 3D 병렬화 격자 그림]
중요한 여담으로, 데이터 병렬 정도는 학습의 전역 배치 크기를 계산할 때 꼭 필요합니다. 데이터 병렬 정도는 완전한 모델 복제본이 몇 개인지에 달려 있습니다.
파이프라인 병렬화와 텐서 병렬화는 ZeRO의 모든 단계와 함께 쓸 수 있습니다. 다만 파이프라인 병렬화를 ZeRO-2/3의 그래디언트 샤딩과 함께 쓰면 효율을 유지하기 어렵습니다(ZeRO-2는 그래디언트를 나누는데, 파이프라인 병렬화는 그래디언트를 누적하기 때문입니다. 파이프라인 일정을 신중하게 정하고 통신을 겹쳐서 효율을 유지할 수는 있지만, 그게 너무 어려워서 지금 DeepSpeed는 아예 막아 두었습니다: https://github.com/microsoft/DeepSpeed/blob/v0.10.1/deepspeed/runtime/pipe/engine.py#L71). 반면 텐서 병렬화는 ZeRO의 모든 단계와 서로 보완 관계입니다. 각 랭크에서 다음과 같이 움직이기 때문입니다.
- ZeRO-3은 다른 랭크들에서 층 전체의 파라미터를 모아 오고, 이제 로컬에 온전히 있는 층으로 전체 입력을 처리한 다음, 원격 랭크의 파라미터를 담느라 할당했던 메모리를 해제합니다.
- 텐서 병렬화는 로컬 입력에 필요한 원격 활성값을 다른 랭크들에서 모아 오고, 로컬에 있는 층 조각으로 입력의 일부를 처리한 다음, 다음 층의 활성값을 원격 랭크들에 보냅니다.
Eleuther의 작업 대부분에서 저희는 파이프라인 병렬화와 텐서 병렬화를 ZeRO-1과 함께 써서 학습합니다. 큰 규모에서 ZeRO-3은 저희 하드웨어에 비해 통신이 너무 많다고 보았기 때문에, 대신 노드 사이에는 파이프라인 병렬화를, 노드 안에서는 텐서 병렬화를 씁니다.
활성값 분할을 쓰는 전형적인 3D 병렬 ZeRO-1 실행에 대해 모든 것을 합치면 다음과 같습니다.
맺으며
EleutherAI 엔지니어들은 효율적인 모델 학습을 계획하고 분산 실행을 디버깅할 때 위와 같은 어림식을 자주 씁니다. 흔히 지나치기 쉬운 이런 구현 세부 사항을 조금이나마 분명히 해 드렸기를 바랍니다. 함께 이야기하고 싶거나 저희가 빠뜨린 것이 있다고 생각되면 contact@eleuther.ai로 의견을 보내 주세요. 기꺼이 듣겠습니다!
이 블로그 글을 인용하려면 다음을 써 주세요.
@misc{transformer-math-eleutherai,
  title = {Transformer Math 101},
  author = {Anthony, Quentin and Biderman, Stella and Schoelkopf, Hailey},
  howpublished = \url{blog.eleuther.ai/},
  year = {2023}
}