Nouamane Tazi 외: 울트라스케일 플레이북: GPU 클러스터에서 LLM 학습하기Nouamane Tazi et al.: The Ultra-Scale Playbook: Training LLMs on GPU Clusters
GPU 한 개에서 수천 개까지, 데이터·텐서·시퀀스·컨텍스트·파이프라인·전문가 병렬화와 ZeRO, 활성값 재계산, 통신과 계산 겹치기, 커널과 혼합 정밀도까지 LLM 학습을 늘리는 방법을 4,000번 넘는 실험과 함께 다룬 Hugging Face nanotron 팀의 책The ultimate guide to training LLM on large GPU Clusters
Contents목차
- 큰 그림
- 첫걸음: GPU 한 대로 학습하기
- 트랜스포머의 메모리 사용량
- 메모리 사용량 프로파일링
- 가중치, 그래디언트, 옵티마이저 상태의 메모리
- 활성값의 메모리
- 활성값 재계산
- 그래디언트 누적
- GPU 계산과 통신 프로파일링
- 데이터 병렬화
- 첫 번째 최적화: 그래디언트 동기화를 역전파와 겹치기
- 두 번째 최적화: 그래디언트 버킷 묶기(bucketing)
- 세 번째 최적화: 그래디언트 누적과의 상호작용
- 전역 배치 크기 다시 보기
- 지금까지의 여정
- Zero Redundancy Optimizer (ZeRO)
- 메모리 사용량 다시 보기
- ZeRO-1: 옵티마이저 상태 분할
- ZeRO-2: 그래디언트 분할 더하기
- ZeRO-3: 파라미터 분할 더하기(FSDP)
- 텐서 병렬화
- 트랜스포머 블록의 텐서 병렬화
- 시퀀스 병렬화
- 컨텍스트 병렬화
- 링 어텐션
- 지그재그 링 어텐션: 계산 균형을 맞춘 구현
- 파이프라인 병렬화
- 레이어를 여러 노드에 나누기: 전부 순전파, 전부 역전파
- 순전파 한 번, 역전파 한 번 방식과 Llama 3.1 방식
- 스테이지 교차 배치
- 제로 버블과 DualPipe
- 전문가 병렬화
- 5D 병렬화 한눈에 보기
- 적용 범위와 초점
- 한데 모아 정리하기
- 최적의 학습 구성 찾기
- 1단계: 학습 스텝 하나를 메모리에 올리기
- 2단계: 목표 전역 배치 크기 맞추기
- 3단계: 학습 처리량 최적화하기
- 수천 가지 구성 벤치마크하기
- 벤치마크에서 얻은 교훈
- GPU 깊이 들여다보기: 융합, 스레딩, 혼합
- GPU 입문
- 커널로 성능 높이기
- 메모리 병합
- 타일링
- 스레드 코어스닝
- 제어 분기 줄이기
- 융합 커널
- FlashAttention
- 혼합 정밀도 학습
- FP16과 BF16 학습
- FP8 사전 학습
- 결론
- 그래서, 다음은?
- 감사의 말
- 토론 페이지
- 참고 자료
- LLM 확장의 이정표가 된 논문
- 학습 프레임워크
- 디버깅
- 분산 기법
- 하드웨어
- 기타
- 부록
- A0: 병렬 프로그래밍 속성 강좌
- Broadcast
- Reduce와 AllReduce
- Gather와 AllGather
- Scatter와 ReduceScatter
- Ring AllReduce
- Barrier
- NCCL
- A1: 분산 학습 프로파일링
- 커널
- CPP 확장
- A2: LLM 학습의 전형적인 규모
- A3: 계산과 통신 겹치기의 수학
- 데이터 병렬화 통신 분석
- ZeRO-3(FSDP) 통신 분석
- TP 통신 분석
- PP 통신 분석
- 인용
- 각주
번역문 · 원저자: Nouamane Tazi, Ferdinand Mom, Haojun Zhao, Phuc Nguyen, Mohamed Mekkouri, Leandro von Werra, Thomas Wolf (Hugging Face nanotron 팀) · 원문: The Ultra-Scale Playbook: Training LLMs on GPU Clusters · 원문 라이선스: Apache License 2.0
라이선스: 원문 Space(nanotron/ultrascale-playbook)의 설정 파일 README.md 머리 칸에
license: apache-2.0이 적혀 있습니다. 2025년 8월 21일 커밋(c93890dd) 기준으로 저장소에 LICENSE 파일과 NOTICE 파일은 없어, 붙일 NOTICE 내용은 없습니다.원문을 번역하고 수정했습니다. Apache License 2.0 제4조에 따라 바꾼 점을 밝힙니다. 본문을 한국어로 옮겼고, 원문의 곁글을 곁주 상자로 바꿨습니다. 상호작용 그림은 원문 저장소의 코드를 옮겨 이 사이트에서 띄우고 화면 글자를 한국어로 바꿨습니다. 소리 파일은 원문 링크로 두었습니다. 수식, 코드, 링크는 원문 그대로입니다.
그림: 원문 저장소에 들어 있는 nanotron 팀의 그림과 상호작용 그림은 글과 같은 Apache License 2.0을 따르므로 그대로 실었습니다. 원문이 논문이나 다른 글에서 가져온 그림 16개는 원출처의 라이선스가 재사용을 허락하지 않거나 확인되지 않아 싣지 않았습니다. 그 자리에는 설명과 원출처를 남겼으니 그림은 원문에서 보세요.
최대 512개 GPU로 4,000번이 넘는 스케일링 실험을 돌려 처리량(점의 크기)과 GPU 활용률(점의 색)을 측정했습니다. 이 그림에서는 두 값 모두 모델 크기별로 정규화했다는 점에 유의하세요.
수천 개의 GPU가 완벽한 화음을 이루며 웅웅 돌아갑니다. 오늘날 가장 강력한 AI 모델을 학습시키려면 바로 이런 광경이 필요합니다. 얼마 전까지만 해도 일류 연구소만의 전유물이던, 컴퓨팅 파워의 교향곡이지요. 오픈 소스가 이 풍경을 바꿔 놓았지만, 완전히 바꾸지는 못했습니다. 물론 최신 Llama나 DeepSeek 모델은 내려받을 수 있고, 이들의 기술 보고서와 실험 보고서도 읽을 수 있습니다. 하지만 가장 어려운 부분, 곧 학습 코드와 이 거대한 시스템을 학습시키려고 GPU들을 조율하는 데 필요한 지식과 기법은 여전히 복잡함에 가려진 채, 서로 이어지지 않는 여러 논문과 대개 비공개인 코드베이스에 흩어져 있습니다.
이 오픈 소스 책은 바로 그 상황을 바꾸려고 나왔습니다. 기초부터 시작해서, 대규모 언어 모델의 학습을 GPU 한 개에서 수십, 수백, 나아가 수천 개로 확장하는 데 필요한 지식을 차근차근 안내하고, 이론은 실용적인 코드 예제와 재현 가능한 벤치마크로 보여 드리겠습니다.
이런 모델을 학습시키는 클러스터가 커지면서, GPU 활용률을 늘 높게 유지하려고 데이터 병렬화, 텐서 병렬화, 파이프라인 병렬화, 컨텍스트 병렬화, 그리고 ZeRO와 커널 융합 같은 여러 기법이 고안되었습니다. 이 기법들 덕분에 학습 시간이 크게 줄고, 값비싼 하드웨어를 가장 효율적으로 쓸 수 있습니다. 이런 분산 학습 기법은 처음 모델을 만들 때만 중요한 것이 아니라, 특화된 데이터로 큰 모델을 미세 조정할 때도 꼭 필요해졌습니다. 그렇게 미세 조정했을 때 가장 좋은 결과가 나오는 경우가 많기 때문입니다. 이 책에서는 이 모든 기법을 가장 단순한 것부터 가장 정교한 것까지 차례로 살펴보되, 각 방법이 어디서 나왔는지 이해할 수 있도록 하나의 이야기 흐름을 이어 가겠습니다.
독자 여러분이 요즘 LLM 아키텍처를 기본적으로 알고, 딥러닝 모델을 어떻게 학습시키는지 대강 안다고 가정하겠습니다. 분산 학습은 전반적으로 처음이어도 괜찮습니다. 필요하다면 모델 학습의 기초는 DeepLearning.ai의 훌륭한 강좌나 PyTorch 튜토리얼에서 찾아볼 수 있습니다. 이 책은 사전 학습용 데이터 처리를 다룬 저희의 이전 블로그 글(이른바 “FineWeb 블로그 글”)에 이은 3부작의 두 번째 편으로 볼 수 있습니다. 두 글을 모두 읽고 나면 요즘 고성능 LLM이 어떻게 만들어지는지 온전히 이해하는 데 필요한 핵심 지식은 거의 다 갖추게 되고, 레시피를 완성하는 데는 데이터 혼합과 아키텍처 선택에 관한 비법만 남게 됩니다(3부를 기대해 주세요…).
이 책은 크게 다음 세 가지 토대 위에 서 있습니다:
1. 이론과 개념의 짧은 소개: 코드와 실험으로 들어가기 전에, 각 방법이 큰 틀에서 어떻게 작동하는지, 장점과 한계는 무엇인지 먼저 이해하시면 좋겠습니다. 예를 들어 언어 모델의 어느 부분이 메모리를 잡아먹는지, 그리고 그 일이 학습 중 언제 일어나는지 배우게 됩니다. 또 모델을 병렬화해 메모리 제약을 피해 가는 방법과 GPU를 늘려 처리량을 높이는 방법도 배웁니다. 그러고 나면 트랜스포머 모델의 메모리 사용 내역을 계산하는 다음 위젯이 어떻게 작동하는지 이해하게 될 것입니다:
(이 위젯에서 무슨 일이 벌어지는지 전혀 모르겠어도 걱정하지 마세요. 그걸 알려 드리려고 저희가 여기 있으니까요!)
이 위젯은 이론상의 메모리 사용 내역을 보여 주지만, 실제 학습을 돌릴 때의 메모리 사용량을 예측하는 다음 도구도 만들어 두었습니다:
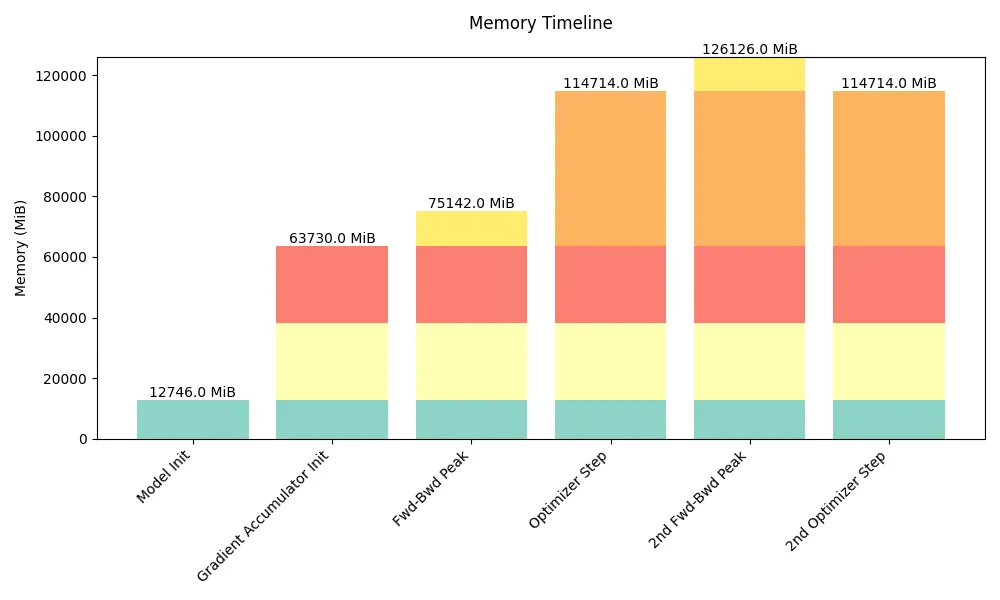
2. 명확한 코드 구현: 이론은 이론일 뿐이고, 무언가를 실제로 구현하다 보면 온갖 엣지 케이스와 중요한 세부 사항이 드러납니다. 그래서 가능한 곳마다 구현 참고 자료를 링크해 두었습니다. 경우에 따라 두 가지 코드를 참고합니다:
- Picotron 저장소는 교육용으로 만들어져서, 대개 개념 하나를 짧고 그 자체로 완결된 파일 하나에 구현합니다.
- 반면 프로덕션 수준의 코드를 보려면 Nanotron 구현을 참고하겠습니다. Nanotron은 Hugging Face에서 쓰는 프로덕션 학습 코드베이스입니다.
3. 실제 학습 효율 벤치마크: LLM 학습을 실제로 어떻게 확장할지는 사용하는 칩 종류, 인터커넥트 같은 인프라에 따라 달라지므로, 하나로 통일된 레시피를 드릴 수는 없습니다. 대신 여러 설정을 벤치마크하는 방법을 알려 드리겠습니다. 저희 클러스터에서 한 일이 바로 이것입니다. 가능한 여러 분산 학습 구성과 모델 크기를 훑어보려고 최대 512개 GPU로 4,100번이 넘는 분산 실험(테스트 실행까지 포함하면 16,000번 이상)을 돌렸습니다.
보시다시피 다룰 내용이 아주 많습니다. 분산 학습의 실전에 본격적으로 뛰어들기 전에, 이 책에서 다룰 과제들을 큰 틀에서 빠르게 훑어보겠습니다.
큰 그림
이 책에서 다루는 모든 기법은 다음 세 가지 핵심 과제 가운데 하나 이상을 해결하려는 것이며, 이 과제들은 앞으로도 계속 마주치게 됩니다.
- 메모리 사용량: 넘을 수 없는 한계입니다. 학습 스텝 하나가 메모리에 들어가지 않으면 학습을 진행할 수 없습니다.
- 계산 효율: 하드웨어가 대부분의 시간을 계산에 쓰게 하고 싶습니다. 그러려면 데이터를 옮기거나 다른 GPU가 일을 마치기를 기다리느라 쓰는 시간을 줄여야 합니다.
- 통신 오버헤드: 통신 오버헤드는 GPU를 놀게 만들므로 최대한 줄이고 싶습니다. 이를 위해 노드 내부(빠름) 대역폭과 노드 사이(더 느림) 대역폭을 최대한 잘 활용하고, 통신을 계산과 최대한 겹치려고 합니다.
예를 들어 재계산이나 텐서 병렬화를 쓰면 이 셋(계산, 통신, 메모리) 가운데 하나를 내주고 다른 하나를 얻을 수 있는데, 이런 경우를 여러 곳에서 보게 됩니다. 알맞은 균형을 찾는 것이 학습 규모를 키우는 열쇠입니다.
이 책은 다루는 범위가 넓어서, 길을 찾고 요점을 챙기는 데 도움이 되도록 치트시트를 만들었습니다. 이 거친 바다를 항해하는 동안 곁에 두세요!

첫걸음: GPU 한 대로 학습하기
🎧 원문의 팟캐스트 오디오: 듣기
읽는 동안 팟캐스트 같은 분위기를 더하고 싶다면, NotebookLM 진행자들이 이 책의 앞부분을 두고 나누는 이야기를 들으면서 읽어 보세요.
여러 GPU로 규모를 키우기 전에, 모델 학습의 가장 기초부터 빠르게 짚어 보겠습니다. GPU 한 대로 모델을 학습할 때는 보통 다음 세 단계를 거칩니다.
- 입력을 모델에 통과시켜 출력을 얻는 순전파
- 그래디언트를 계산하는 역전파
- 그래디언트로 파라미터를 갱신하는 최적화 스텝
대략 이런 모습입니다.
이 그림에서 윗줄의 상자들은 모델 안에 차례로 놓인 레이어로 볼 수 있습니다(맨 아랫줄도 마찬가지입니다). 분홍색 상자는 역전파 중에 계산되는 각 레이어의 그래디언트입니다.
배치 크기()는 모델 학습에서 중요한 하이퍼파라미터 가운데 하나로, 모델의 수렴과 처리량에 모두 영향을 줍니다.
작은 배치 크기는 학습 초반에 학습 지형을 빠르게 지나 최적의 학습 지점에 다다르는 데 도움이 될 수 있습니다. 하지만 학습이 더 진행된 뒤에도 배치 크기가 작으면 그래디언트에 잡음이 계속 끼어, 모델이 가장 좋은 최종 성능까지 수렴하지 못할 수 있습니다. 반대쪽 극단인 큰 배치 크기는 그래디언트를 매우 정확하게 추정해 주지만, 학습 토큰 하나하나를 덜 활용하는 경향이 있어 수렴이 느려지고 계산 자원을 낭비할 수도 있습니다. 이 주제를 일찍이 잘 다룬 글로는 OpenAI의 대규모 배치 학습 논문1이나 MiniMax-01 기술 보고서의 4.2절이 있습니다.
배치 크기는 주어진 텍스트 데이터셋을 학습하는 데 걸리는 시간에도 영향을 줍니다. 배치 크기가 작으면 같은 양의 샘플을 학습하는 데 옵티마이저 스텝이 더 많이 필요합니다. 옵티마이저 스텝은 (계산 시간 면에서) 비싸므로, 더 큰 배치 크기를 쓸 때보다 전체 학습 시간이 늘어납니다. 그렇긴 해도, 최적 배치 크기 근처에서는 모델 성능에 큰 영향 없이 배치 크기를 꽤 넓게 조절할 수 있는 경우가 많다는 점을 알아 두세요. 다시 말해 최적 배치 크기 근처에서는 최종 모델 성능이 정확한 배치 크기 값에 그다지 민감하지 않은 편입니다.
LLM 사전 학습 커뮤니티에서는 배치 크기를 보통 샘플 수가 아니라 토큰 수로 나타냅니다( = batch size tokens, 토큰 단위 배치 크기). 이렇게 하면 학습 수치가 학습에 쓴 정확한 입력 시퀀스 길이와 대체로 무관해집니다.
가장 단순한 경우, 곧 머신 한 대로 학습할 때는 샘플 단위의 와 를 모델 입력 시퀀스 길이()로 다음과 같이 계산할 수 있습니다.
여기서부터는 배치 크기 공식을 샘플 단위로 보여 드리지만, 시퀀스 길이를 곱하면 언제든 토큰 단위 값을 얻을 수 있습니다.
최근 LLM 학습에서 알맞은 배치 크기는 보통 배치당 토큰 400만에서 6,000만 개 정도입니다. 배치 크기와 학습 말뭉치 크기는 해마다 꾸준히 커져 왔습니다. Llama 1은 약 4M 토큰의 배치 크기로 1.4조 토큰을 학습했고, DeepSeek은 약 60M 토큰의 배치 크기로 14조 토큰을 학습했습니다.
모델 학습을 이렇게 큰 배치 크기로 키우면 첫 번째 난관에 부딪힙니다. 바로 메모리 부족 문제입니다. GPU 메모리가 목표 배치 크기의 배치 하나를 통째로 담을 만큼 넉넉하지 않으면 어떻게 해야 할까요?
먼저 애초에 무엇이 OOM 문제를 일으키는지 살펴보겠습니다. 그러면 모델 학습에 메모리가 얼마나 필요한지 쓸모 있는 직관을 얻을 수 있습니다.
트랜스포머의 메모리 사용량
신경망 모델을 학습할 때는 메모리에 여러 가지를 저장합니다.
- 모델 가중치
- 모델 그래디언트
- 옵티마이저 상태
- 그래디언트 계산에 필요한 활성값
참고
모델에 필요한 메모리를 정확히 계산할 수 있을 것 같지만, 정확한 계산을 어렵게 만드는 메모리 점유자가 몇 가지 더 있습니다.
- CUDA 커널은 보통 GPU 메모리를 1~2GB 차지합니다.
import torch; torch.ones((1, 1)).to("cuda")를 실행한 뒤nvidia-smi로 GPU 메모리를 확인하면 바로 알 수 있습니다.- 버퍼와 중간 결과에 쓰이는 메모리가 있고, 단편화 때문에 쓸 수 없는 메모리도 있습니다.
이 마지막 두 가지는 보통 작고 일정한 요인이므로 무시하겠습니다.
이 항목들은 텐서로 저장되며, 텐서는 형태와 정밀도가 저마다 다릅니다. 형태는 배치 크기, 시퀀스 길이, 모델의 은닉 차원, 어텐션 헤드 수, 어휘 크기, 그리고 뒤에서 보게 될 모델 샤딩 여부 같은 하이퍼파라미터로 정해집니다. 정밀도는 FP32, BF16, FP8 같은 형식을 말하며, 텐서의 값 하나를 저장하는 데 각각 4바이트, 2바이트, 1바이트가 필요합니다. 여러 정밀도와 그 장단점은 “혼합 정밀도 학습” 절에서 자세히 다룹니다. 지금은 형식마다 필요한 메모리가 다르고, 그 차이가 저장해야 할 항목들의 메모리 사용량에 영향을 준다는 점만 기억해 둡시다.
그렇다면 이 변수들로 메모리 사용량을 빠르게 알아내려면 어떻게 해야 할까요? 간단한 방법 하나는 경험적으로, 그냥 직접 재 보는 것입니다.
메모리 사용량 프로파일링
PyTorch 프로파일러를 쓰면 학습 내내 메모리가 어떻게 할당되는지 알 수 있습니다. 메모리 사용량은 고정된 값이 아니라 학습 중에, 그리고 학습 스텝 하나 안에서도 크게 달라진다는 것을 볼 수 있습니다.
첫 스텝이 이후 스텝들과 확연히 다르게 보이지만, 그 이야기를 하기 전에 한 스텝의 전반적인 구조부터 살펴보겠습니다. 먼저 순전파를 하는 동안 활성값이 빠르게 늘어납니다. 이어 역전파 동안 그래디언트가 쌓이고, 역전파가 진행되면서 그래디언트 계산에 쓰려고 저장해 둔 활성값이 차례로 지워집니다. 마지막으로 최적화를 수행하는데, 이때는 모든 그래디언트가 필요하며, 다음 순전파를 시작하기 전에 옵티마이저 상태를 갱신합니다.
앞서 말했듯이 첫 스텝은 모습이 다릅니다. 활성값이 빠르게 늘었다가 한동안 평평하게 머뭅니다. 왜 그럴까요? 첫 스텝에서는 PyTorch 캐싱 할당자가 준비 작업을 많이 합니다. 메모리 할당을 미리 마련해 두어 이후 스텝들이 빈 메모리 블록을 찾아다니지 않아도 되게 하고, 그 덕분에 이후 스텝이 빨라집니다(Zach의 블로그 참고). 첫 스텝이 지나면 옵티마이저 상태도 나타나는데, 이것이 이후 학습 스텝들의 메모리 사용량을 전반적으로 밀어 올립니다.
메모리를 처음으로 훑어봤으니, 이제 학습 규모를 키우는 일이 흔히 이 여러 항목(활성값, 파라미터, 그래디언트, 옵티마이저 상태)에 필요한 메모리를 GPU 메모리 한도 안에 두면서 계산 효율을 최대로 끌어올리는 문제가 된다는 점을 살펴보겠습니다.
가중치, 그래디언트, 옵티마이저 상태의 메모리
목록의 처음 세 항목인 모델 가중치, 그래디언트, 옵티마이저 상태부터 시작하겠습니다. 이것들에 필요한 메모리는 사실 꽤 쉽게 추정할 수 있습니다.
단순한 트랜스포머 LLM의 파라미터 수는 다음 공식으로 구합니다.
이 식에서 는 은닉 차원, 는 어휘 크기, 은 모델의 레이어 수입니다. 식을 보면 은닉 차원이 클 때 지배적인 항은 항임을 알 수 있습니다. 파라미터 규모를 키울 때 제곱으로 늘어나는 항은 이것 하나뿐이기 때문입니다.
파라미터와 그래디언트에 필요한 메모리는 파라미터 수에 파라미터당 바이트 수를 곱하기만 하면 나옵니다. 전통적인 전체 정밀도 학습에서는 파라미터와 그래디언트가 모두 4바이트씩 필요하고, 옵티마이저로 Adam을 쓰면 모멘텀과 분산을 저장해야 하므로 파라미터당 8바이트(각각 4바이트)가 더 듭니다. 정리하면 다음과 같습니다.
이제 더 낮은 정밀도를 쓰면 무엇이 달라지는지 보겠습니다. 안정성 때문에(이 책 뒤쪽의 혼합 정밀도 학습 절 참고) 학습 전체를 낮은 정밀도로 하지는 않고, 높은 정밀도와 낮은 정밀도를 섞는 “혼합 정밀도”를 쓰는 경우가 많습니다3. 요즘 혼합 정밀도 학습의 기본값은 대부분의 계산에 BF16을 쓰고(파라미터와 그래디언트마다 2바이트), 모델 가중치와 그래디언트의 복사본을 FP32로 하나 더 저장해 파라미터당 모두 12바이트를 쓰는 것입니다. 파라미터와 그래디언트 말고도 옵티마이저 상태를 저장해야 합니다. Adam 옵티마이저라면 모멘텀과 분산이 필요한데, 수치 안정성을 위해 보통 FP32로 저장하므로 각각 4바이트를 씁니다.
요약하면 다음과 같습니다.
참고
어떤 라이브러리는 그래디언트를 FP32로 저장하는데, 그러면 메모리가 만큼 더 필요합니다. 예를 들어 Nanotron이 이렇게 하는데, BF16은 작은 값에서 정보 손실이 있고 저희는 늘 안정성을 우선하기 때문입니다. 자세한 내용은 이 DeepSpeed 이슈를 보세요.
참고
파라미터의 FP32 복사본()을 문헌과 코드베이스에서는 “마스터 가중치”라고 부르기도 합니다.
흥미롭게도 혼합 정밀도 학습 자체는 메모리를 아껴 주지 않습니다. 세 구성 요소에 메모리를 다르게 나눌 뿐이고, 그래디언트를 FP32로 누적하면 오히려 전체 정밀도 학습보다 4바이트가 더 듭니다. 그래도 순전파와 역전파를 반정밀도로 계산하면 (1) GPU에서 최적화된 더 빠른 저정밀도 연산을 쓸 수 있고, (2) 순전파 동안 필요한 활성값 메모리가 줄어들기 때문에 여전히 유리합니다. 위 그래프에서 봤듯이 활성값은 메모리 사용량의 큰 부분을 차지합니다.
모델에 메모리가 대략 얼마나 필요한지 감을 잡아 보겠습니다(전체 정밀도와 혼합 정밀도의 총량은 같습니다).
| 모델 파라미터 수 | FP32 또는 BF16(FP32 그래디언트 누적 없음) | BF16(FP32 그래디언트 누적 사용) |
|---|---|---|
| 1B | 16 GB | 20 GB |
| 7B | 112 GB | 140 GB |
| 70B | 1120 GB | 1400 GB |
| 405B | 6480 GB | 8100 GB |
보다시피 7B(!)만 되어도 가중치, 그래디언트, 옵티마이저 상태에 필요한 메모리가 벌써 상당히 불어나 일반적인 GPU 메모리 크기(예: H100 GPU는 80GB)를 넘어섭니다.
하지만 지금은 GPU 한 대에 들어가는 모델에 머물면서, 메모리 예산을 크게 차지하는 마지막 항목인 활성값을 살펴보겠습니다.
활성값의 메모리
활성값에 필요한 메모리는 가중치, 그래디언트, 옵티마이저 상태보다 계산하기가 조금 더 복잡합니다. 한 가지 이유는 활성값이 모델 입력에 따라 달라지기 때문입니다. 애초에 역전파를 위해 왜 활성값을 저장해야 하는지 잘 모르겠다면 이 블로그 글로 빠르게 복습할 수 있습니다. 역전파가 어떻게 계산되는지 꼼꼼히 따져 보면, 혼합 정밀도에서 활성값에 필요한 전체 메모리를 추정할 수 있습니다. 결과는 다음 식과 같습니다.
여기서 은 레이어 수, 는 시퀀스 길이, 는 샘플 단위 배치 크기, 는 모델의 은닉 차원, 는 헤드 수입니다.
이 숫자들을 정확히 유도하는 과정은 재계산에 관한 NVIDIA의 원 논문4을 따라가 보면 됩니다. 요점은 트랜스포머 레이어 안의 연산과 연산 사이에 생기는 중간 활성값의 크기를 모두 세어 보는 것입니다.
여기서 흥미로운 점은 같은 모델이라도 메모리 사용량이 고정되어 있지 않다는 것입니다. 메모리 사용량은 배치 크기에는 선형으로, 시퀀스 길이에는 제곱으로 비례해 늘어납니다. 즉 배치 크기를 키우거나 더 긴 시퀀스로 학습할 때 폭발적으로 늘어나는 부분이 바로 활성값 메모리입니다. 이 식으로 여러 시퀀스 길이에서 메모리 사용량이 어떻게 달라지는지 볼 수 있습니다. 예를 들어 Llama 모델(bs=1)이라면 다음과 같습니다.
이 그래프들은 놀라운 사실을 보여 줍니다. 짧은 시퀀스(또는 작은 배치 크기)에서는 활성값의 메모리 사용량이 거의 무시할 만하지만, 2~4k 토큰 언저리부터는 상당한 메모리를 차지하기 시작합니다. 반면 파라미터, 그래디언트, 옵티마이저 상태의 메모리 사용량은 (뒤에서 다루겠지만) 시퀀스 길이와 배치 크기에 거의 영향을 받지 않습니다.
입력 토큰이 많으면(즉 배치 크기가 크거나 시퀀스가 길면) 활성값이 단연 가장 큰 메모리 부담이 됩니다.
이 “활성값 폭발”을 길들일 방법이 있을까요? 독자 여러분, 좋은 질문입니다!
이제 첫 번째 기법인 활성값 재계산을 설명할 차례입니다. 이 기법은 활성값의 메모리 점유량에 상한을 두는 데 도움이 되며, 오늘날 대형 모델 학습의 도구 상자에서 빼놓을 수 없는 도구입니다.
활성값 재계산
활성값 재계산은 그래디언트 체크포인팅 또는 재구체화라고도 부릅니다. 기본 발상은 순전파 중에 일부 활성값을 버려 메모리를 아끼고, 역전파 중에 계산을 조금 더 들여 그 활성값을 그때그때 다시 계산하는 것입니다. 재계산을 쓰지 않으면 학습 가능한 두 연산(예: 피드포워드, LayerNorm 등) 사이의 은닉 상태를 모두 저장해 두었다가 역전파에서 그래디언트를 계산할 때 씁니다. 재계산을 쓰면 보통 모델 구조의 몇몇 핵심 지점에서만 활성값을 저장하고, 나머지 활성값은 버렸다가 역전파 중에 가장 가까이 저장된 활성값에서 출발해 그때그때 다시 계산합니다. 요컨대 순전파의 일부를 한 번 더 수행해, 계산을 더 들이는 대신 메모리를 아끼는 것입니다. 대략 다음과 같습니다.
저장할 핵심 활성값을 고르는 전략은 몇 가지가 있습니다.
- 전체: 트랜스포머 모델의 레이어와 레이어 사이 경계마다 활성값을 체크포인트로 저장합니다. 각 레이어를 다시 순전파해야 해서 사실상 역전파 중에 순전파를 한 번 통째로 더 하는 셈이므로, 보통 “전체” 전략이라고 부릅니다. 메모리를 가장 많이 아끼지만 계산 면에서는 가장 비싼 전략입니다. 보통 계산 비용과 시간이 최대 30~40%까지 늘어나는데, 이는 매우 눈에 띄는 차이입니다.
- 선택적: 대개는 전체 전략보다 더 잘할 수 있습니다. 재계산 논문4의 저자들은 어떤 활성값이 가장 크게 늘어나면서 초당 부동소수점 연산 기준으로 재계산 비용은 가장 싼지 자세히 분석했습니다. 어텐션 계산이 바로 그런 부류로 밝혀졌으므로, 보통 어텐션 쪽 활성값은 버리고 비싼 피드포워드 계산을 체크포인트로 저장하는 데 집중할 수 있습니다. GPT-3(175B) 모델이라면 계산 비용 2.7%로 활성값 메모리를 70% 줄인다는 뜻입니다.
재계산 전략이 실제로 메모리 점유량을 얼마나 크게 줄일 수 있는지, 그리고 선택적 재계산이 메모리 절약과 재계산 비용 사이에서 어떻게 좋은 균형을 잡는지 보겠습니다.
여기서 또렷이 보이는 또 다른 경향은 작은 모델일수록 긴 시퀀스의 활성값이 차지하는 비중이 커서, 재계산의 효과가 더욱 두드러진다는 점입니다.
참고
학습 설정이 GPU/TPU/가속기를 얼마나 효율적으로 쓰는지 잴 때는 보통 재계산까지 포함해 전체 FLOPs(부동소수점 연산 횟수)를 계산하고, 이를 GPU/TPU/가속기의 이론상 최대 FLOPS(초당 부동소수점 연산 횟수)와 비교합니다. 학습 스텝의 FLOPs를 계산할 때 재계산을 포함하면 “하드웨어 FLOPs”라는 값이 나오는데, 이것이 가속기에서 실제로 수행된 연산 횟수입니다. 이 하드웨어 FLOPs를 학습 스텝에 걸린 시간(초)으로 나누면 실제로 달성한 FLOPS가 나옵니다. 그리고 달성한 FLOPS를 가속기의 최대 FLOPS로 나누면 하드웨어 FLOPs 활용률(hardware FLOPS utilization, HFU)이 됩니다.
하지만 결국 정말 중요한 것은 주어진 데이터셋으로 모델을 학습하는 데 걸리는 전체 시간입니다. 예를 들어 여러 GPU/TPU/가속기를 비교할 때, 어느 하나가 메모리가 넉넉해 재계산을 건너뛸 수 있어서 전체 연산을 덜 수행하는데도(하드웨어 FLOPs가 더 낮은데도) 더 빨리 학습한다면, 그 가속기는 불이익이 아니라 보상을 받아야 합니다. 그래서 대안으로 모델 FLOPs 활용률(model FLOPS utilization, MFU)이라는 값을 계산합니다. MFU는 HFU와 달리 모델의 순전파와 역전파에 필요한 연산만 세고, 측정하는 FLOPs에 재계산을 넣지 않습니다. 따라서 이 값은 학습 구현보다는 모델 자체를 더 잘 반영하는 지표입니다.
요즘 대부분의 학습 프레임워크는 FlashAttention을 씁니다(이 책 뒤쪽에서 자세히 다룹니다). FlashAttention은 어텐션 점수와 행렬을 저장하지 않고 역전파에서 다시 계산하는 방식으로, 활성값 재계산을 최적화 전략 안에 기본으로 품고 있습니다. 따라서 FlashAttention을 쓰는 사람 대부분은 이미 선택적 재계산을 쓰고 있는 셈입니다.
이제 이해했겠지만, 활성값 재계산은 재계산 때문에 FLOPS를 조금 늘리는 대신 메모리 접근 오버헤드를 크게 줄입니다.
이 트레이드오프는 GPU처럼 고속 메모리가 한정된 하드웨어에서 특히 유리합니다. 보통 메모리에 접근하는 것이 계산하는 것보다 느리기 때문입니다. 그래서 연산이 늘어나는데도 전체적으로는 메모리 점유량이 훨씬 줄어드는 데다 계산까지 더 빨라지는 경우가 많습니다.
재계산을 배웠으니, 이제 앞의 그래프들에서 본 활성값 메모리 사용량을 길들일 수 있습니다!
하지만 활성값은 여전히 배치 크기에 비례하고, 위 막대그래프의 프로파일은 모두 bs=1로 잰 것이어서, 배치 크기를 키우면 다시 문제가 될 수 있습니다. 다행히 도구 상자에는 우리를 구해 줄 두 번째 도구, 그래디언트 누적이 있습니다!
그래디언트 누적
그래디언트 누적은 메모리 폭발을 피하는 아주 간단한 방법으로, 배치를 마이크로배치로 쪼개는 것입니다. 그런 다음 마이크로배치마다 차례로 순전파와 역전파를 수행해 그래디언트를 계산하고, 이름 그대로 모든 마이크로배치의 그래디언트를 더한 뒤에 최적화를 수행합니다. 실제로는 결과가 그래디언트 누적 스텝 수와 무관하도록, 그래디언트의 합이 아니라 평균으로 최적화 스텝을 진행합니다.
순전파 한 번의 배치 크기를 마이크로배치 크기()라고 부르겠습니다. 옵티마이저 스텝과 스텝 사이의 전체 배치 크기는 전역 배치 크기()라고 하겠습니다. 순전파와 역전파를 여덟 번 할 때마다 옵티마이저 스텝을 한 번 수행한다면, 전역 배치 크기는 마이크로배치 크기의 여덟 배가 됩니다.
따라서 이제 전역 배치 크기라고 부르는 것은, 지금까지 편의상 그냥 배치 크기라고 불러 온 것과 같습니다(모호함을 피하려고 이제부터 용어를 더 정확히 씁니다).
그래디언트 누적을 쓰면 전역 배치 크기는 다음과 같이 계산할 수 있습니다.
그래디언트 누적을 쓰면 메모리 점유량은 그대로 둔 채 배치 크기를 사실상 무한대까지(그리고 그 너머로!) 늘릴 수 있습니다. 그래디언트 누적은 활성값 재계산과 함께 쓸 수도 있어서 메모리를 더 줄일 수 있습니다.
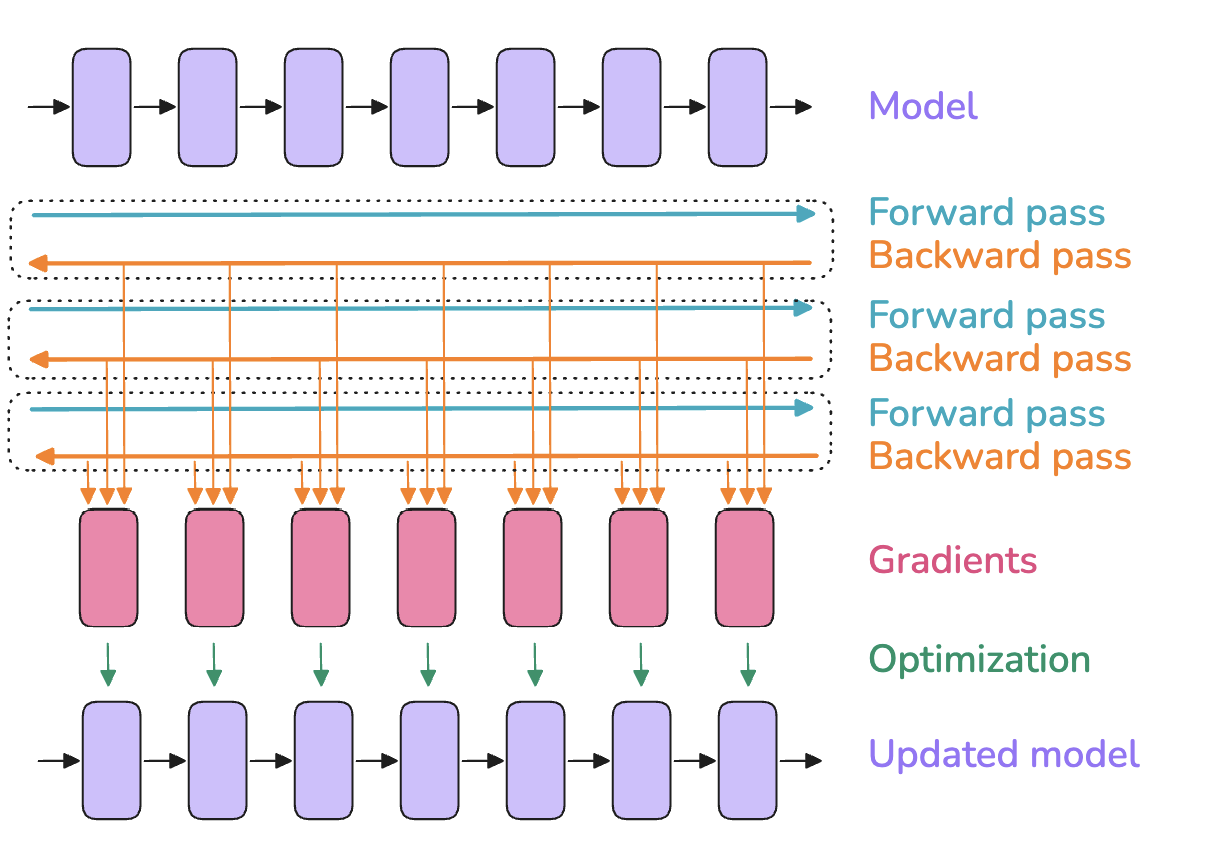
그래디언트 누적은 더 작은 마이크로배치를 차례로 처리해, 배치 크기에 비례해 늘어나는 활성값 메모리를 줄여 줍니다. 한 번에 마이크로배치 하나 분량의 활성값만 메모리에 두면 되므로 저장하는 활성값과 그래디언트가 줄고, 그만큼 전체 활성값 메모리 점유량을 줄이는 데 도움이 됩니다.
다만 단점도 있습니다. 그래디언트 누적은 최적화 스텝 하나마다 순전파와 역전파를 여러 번 연달아 해야 하므로, 계산 오버헤드가 늘고 학습이 느려집니다. 공짜 점심은 없습니다!
하지만 꼼꼼히 따라왔다면, 마이크로배치별 순전파와 역전파는 사실 병렬로 돌릴 수 있다는 점을 눈치챘을 것입니다. 이 순전파와 역전파들은 서로 독립적이며, 서로 다른 입력 샘플을 쓴다는 점만 다릅니다. 이제 학습을 GPU 여러 대로 넓혀 볼 때가 된 것 같습니다!
그 전에, 분산 학습 도구 상자에서 가장 쓸모 있는 도구 가운데 하나인 프로파일러를 짧게 둘러보면서 계산과 통신을 시각화하는 방법을 알아보겠습니다. 이 도구는 GPU 사이의 통신과 계산이 어떻게 일어나는지, 병목이 어디인지 이해하고 확인하는 데 큰 도움이 됩니다.
GPU 계산과 통신 프로파일링
PyTorch의 프로파일러를 쓰면 학습 중에 CPU와 GPU 양쪽에서 무슨 일이 일어나는지 정확히 추적하고 시각화할 수 있습니다. 프로파일러는 PyTorch에 기본으로 들어 있습니다. 사용법을 보겠습니다.
with torch.profiler.profile(
    activities=[
        torch.profiler.ProfilerActivity.CPU,
        torch.profiler.ProfilerActivity.CUDA,
    ],
    schedule=torch.profiler.schedule(wait=1, warmup=1, active=3),
    on_trace_ready=torch.profiler.tensorboard_trace_handler('./log/profile'),
    with_stack=True
) as prof:
    for step in range(steps):
        train_step()
        prof.step()
이 코드는 TensorBoard나 Chrome의 트레이스 뷰어로 시각화할 수 있는 트레이스를 만듭니다. 트레이스에는 다음이 나타납니다.
- GPU에 커널을 비동기로 런치하는 CPU 스레드
- 계산과 통신을 병렬로 처리하는 여러 CUDA 스트림
- 커널 실행 시간과 메모리 할당
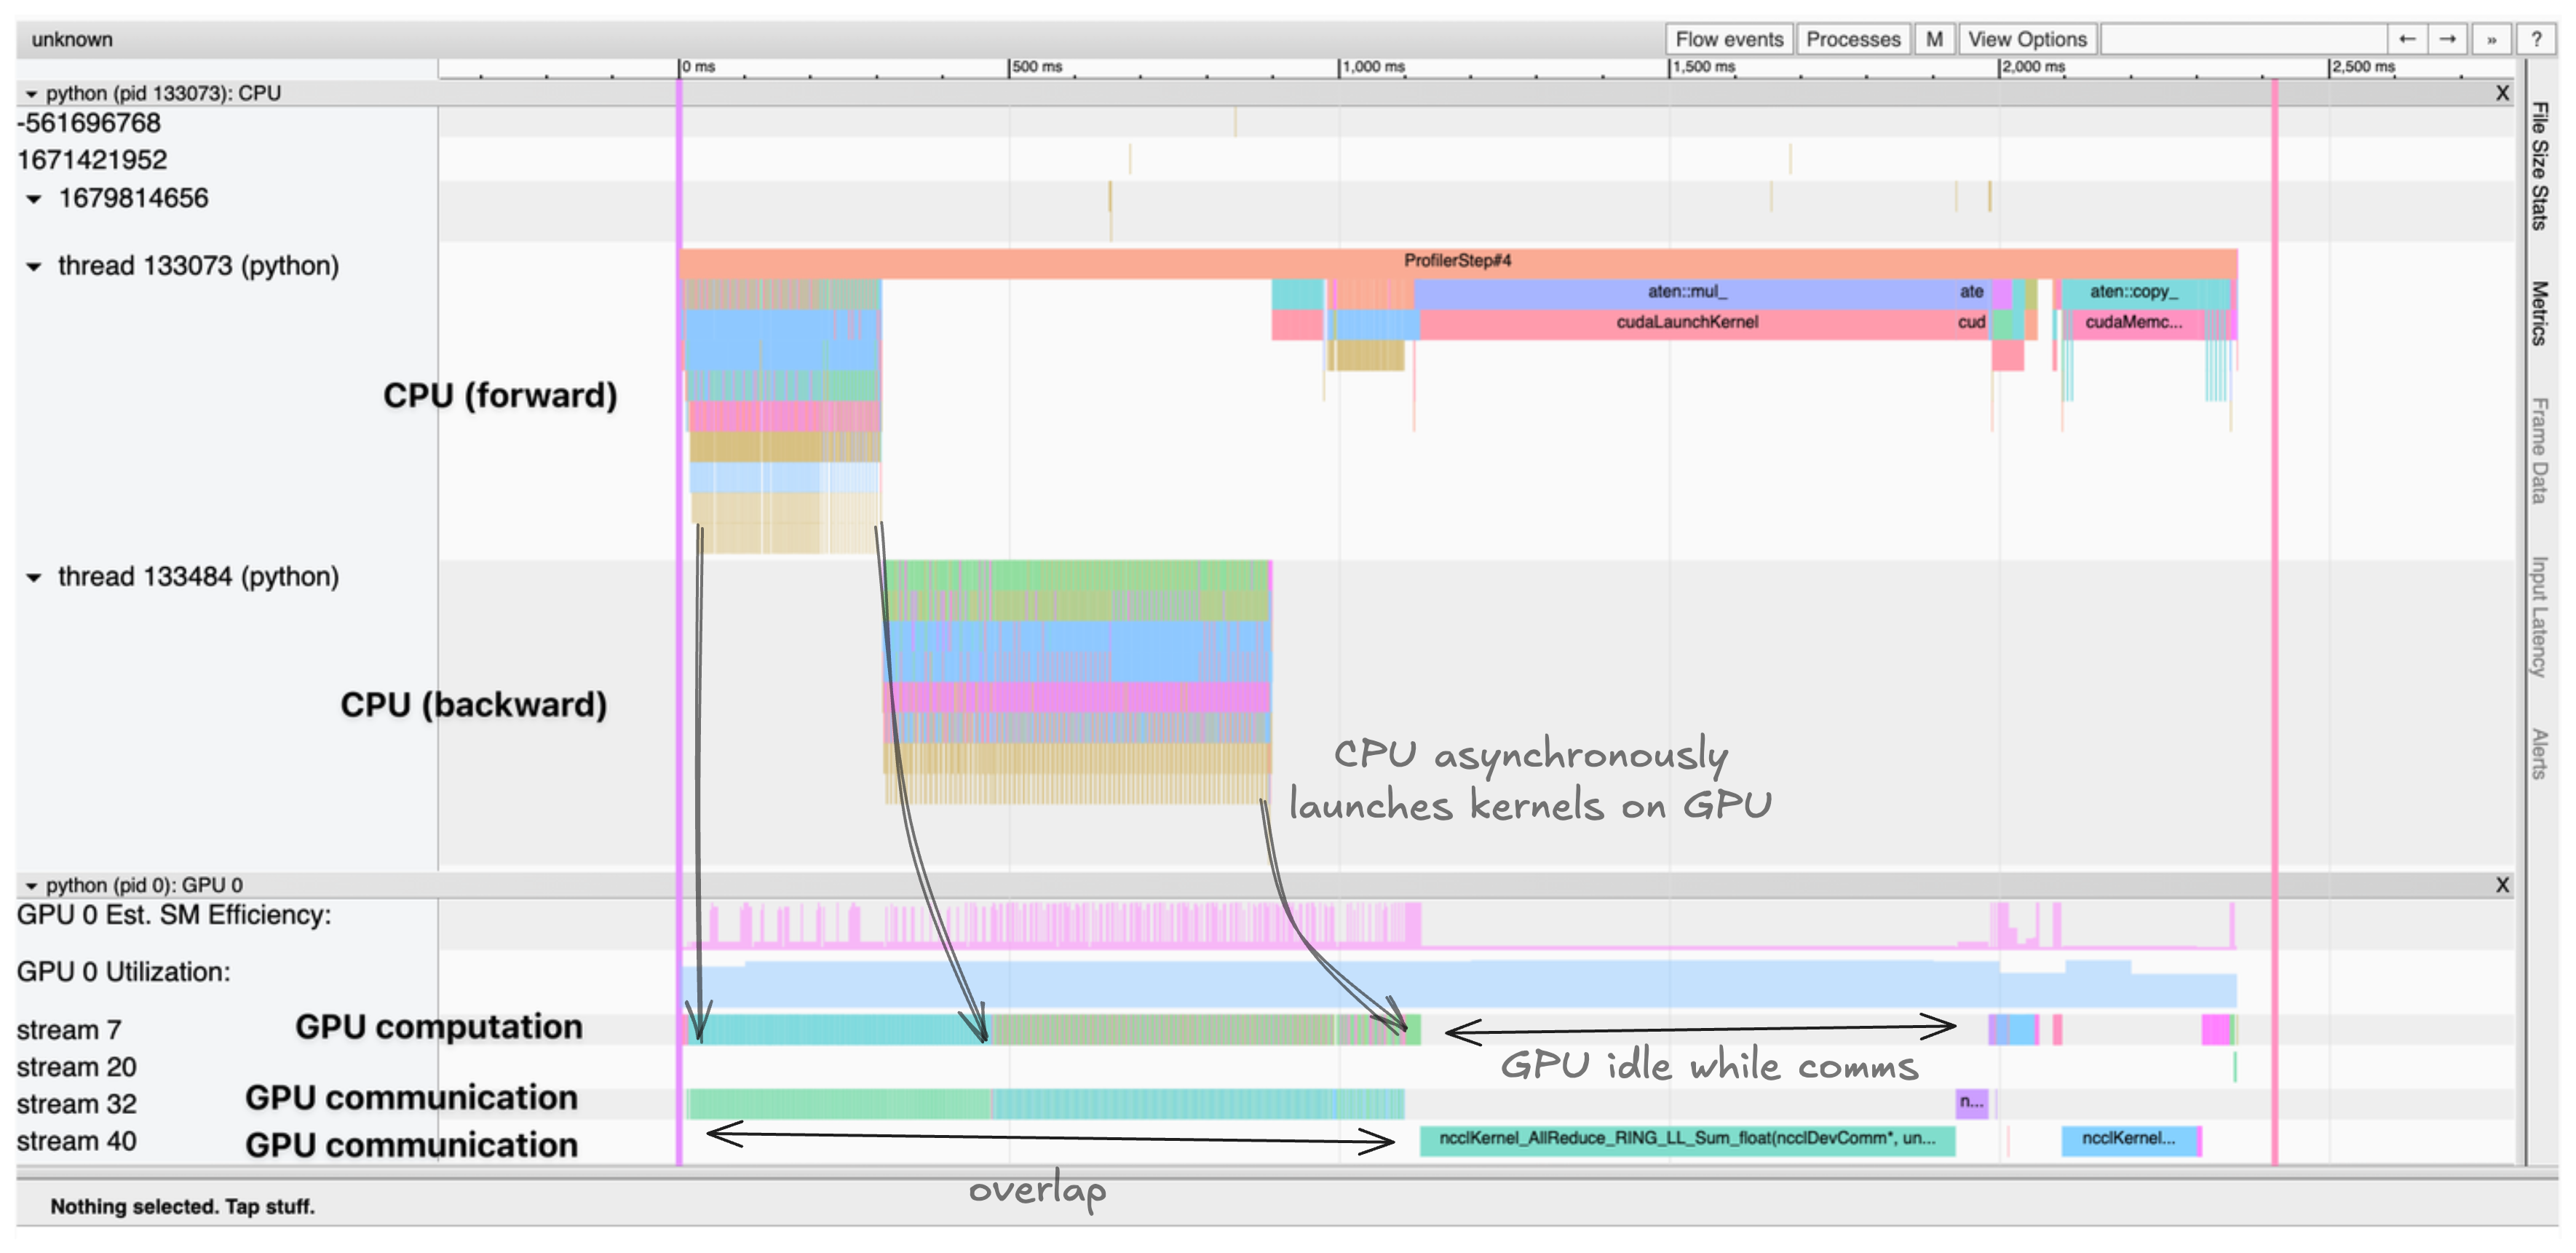
트레이스를 보면 다음과 같은 병목을 찾을 수 있습니다.
- 겹칠 수 있는데도 차례로 실행되는 계산과 통신
- 데이터 전송을 기다리는 GPU 유휴 시간
- CUDA 동기화와 CPU, GPU 사이의 메모리 이동
- GPU의 커널 런치 오버헤드
이런 패턴을 이해하는 것은 분산 학습 성능을 최적화하는 데 아주 중요합니다. 예를 들어 뒤에서 다루겠지만, 그래디언트 동기화가 역전파 계산과 제대로 겹치는지가 트레이스에 또렷이 드러납니다.
이제 GPU가 몇 대 달린 더 큰 워크스테이션을 마련해, 첫 번째 확장 기법인 데이터 병렬화를 살펴보겠습니다. 곧 보겠지만 데이터 병렬화는 그래디언트 누적을 병렬로 돌리는 버전일 뿐입니다.
데이터 병렬화
🎧 소리 파일(원문에서 듣기): 읽는 동안 팟캐스트 같은 분위기를 더하고 싶다면, NotebookLM 진행자들이 이 책의 다음 절들을 두고 나누는 이야기를 함께 들으며 읽어 보세요.
데이터 병렬화의 발상은 모델을 여러 GPU에 복제해 두고(이 복제본들을 “모델 인스턴스”라고 부릅니다), GPU마다 서로 다른 데이터 마이크로배치로 순전파와 역전파를 병렬로 돌리는 것입니다. 그래서 이름이 데이터 병렬화입니다. 간단한 학습 예제에서 데이터 병렬화를 이미 보셨을 수도 있지만, 이 절에서는 꽤 깊이 들어가니 대략적인 방식을 알고 계시더라도 계속 함께해 주세요.
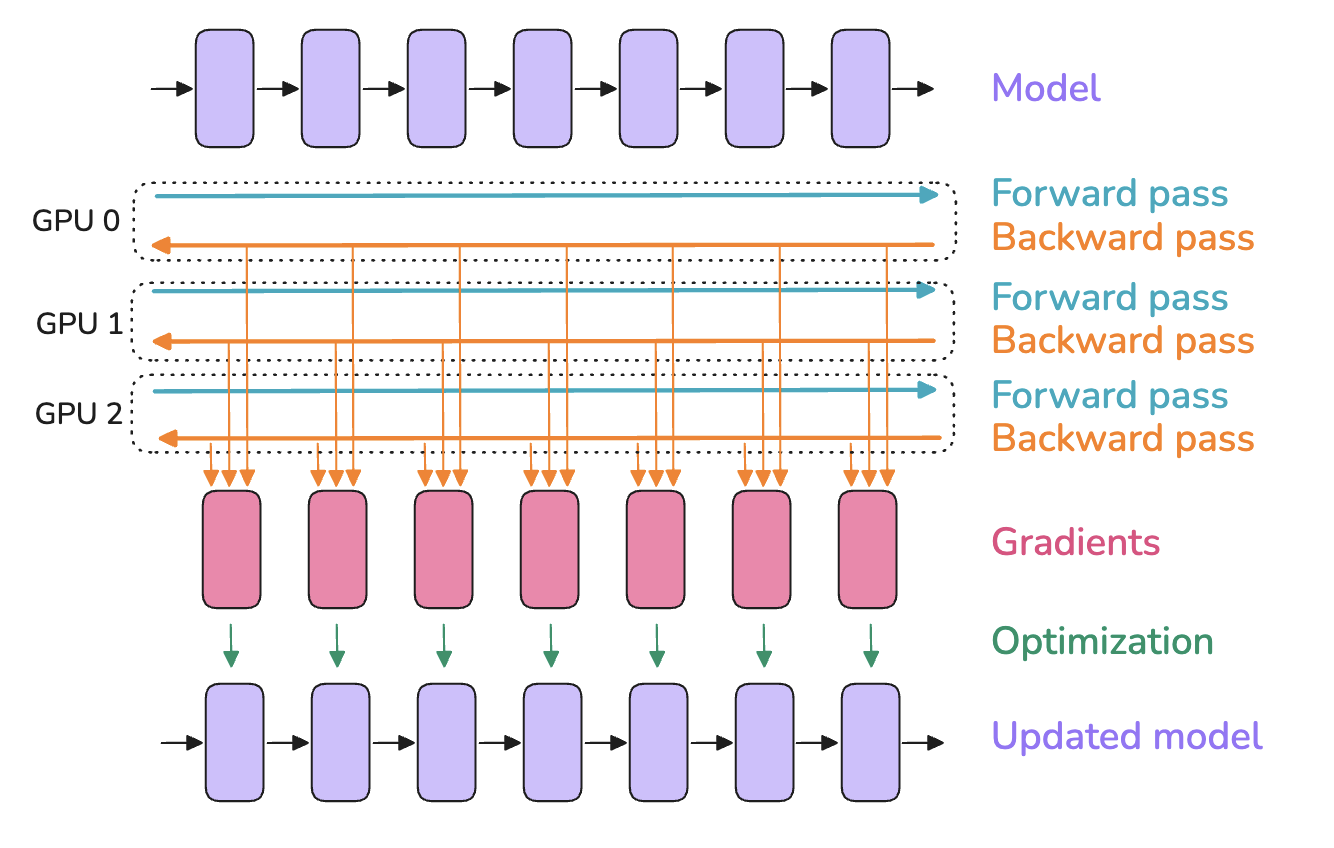
GPU마다 다른 마이크로배치를 쓰면 GPU마다 그래디언트도 달라집니다. 그래서 여러 GPU에 있는 모델 인스턴스를 같은 상태로 맞추기 위해, “AllReduce”라는 연산으로 모델 인스턴스들의 그래디언트를 평균 냅니다. 이 연산은 역전파 도중, 옵티마이저 스텝 전에 일어납니다.
여기서 첫 번째 “분산 통신” 프리미티브인 AllReduce가 등장합니다. AllReduce는 GPU 인스턴스와 노드 사이의 동기화와 통신을 맡습니다.
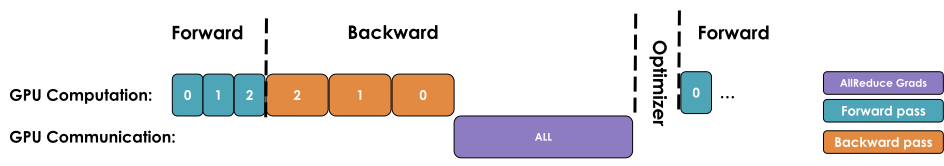
단순한 DP 구현이라면 역전파가 끝나 모든 그래디언트가 모일 때까지 기다렸다가, 모든 DP 랭크에 걸쳐 AllReduce를 실행해 그래디언트를 동기화합니다. 하지만 이렇게 계산 다음에 통신이 차례로 이어지는 방식은 절대 금물입니다. 위 그림처럼 통신하는 동안 GPU가 놀고 있으면 안 되기 때문입니다.
그 대신 가능할 때마다 통신을 계산과 겹쳐서 둘이 동시에 일어나게 해야 합니다.
단순한 첫 구현보다 훨씬 나아지게 해 주는 세 가지 최적화를 살펴보겠습니다.
첫 번째 최적화: 그래디언트 동기화를 역전파와 겹치기
방금 설명한 단순한 DP 방식의 가장 큰 단점은 역전파(계산)가 끝난 뒤 파라미터를 업데이트하기 전에 그래디언트 동기화(통신)를 기다려야 한다는 점입니다. 이 통신을 계산과 겹칠 수 있을까요? 답은 ‘그렇다’입니다!
위 그림에서 보듯, 한 레이어의 그래디언트(분홍색 상자)는 앞쪽 레이어들의 그래디언트(그 왼쪽의 분홍색 상자들)가 계산되기 전에도 모아서 합칠 수 있습니다. 예를 들어 마지막 레이어의 역전파가 끝나는 즉시(오른쪽 맨 끝 상자), 앞쪽 레이어들의 역전파 계산이 왼쪽으로 이어지는 동안 그 그래디언트를 벌써 모아서 합칠 수 있습니다.
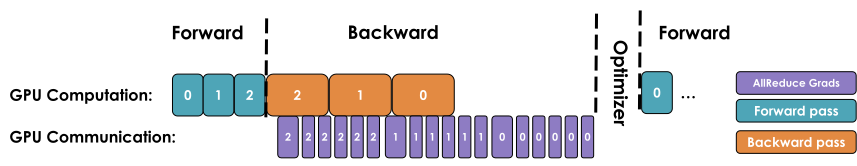
PyTorch에서는 파라미터마다 AllReduce 훅 함수를 붙여서 이렇게 할 수 있습니다. 그러면 다른 파라미터의 그래디언트가 아직 계산되는 동안에도, 어떤 파라미터의 그래디언트가 준비되는 즉시 그 파라미터의 AllReduce 연산이 시작됩니다. 이 방식은 AllReduce 연산 대부분을 그래디언트 계산과 겹쳐서 효율을 높입니다. 훅을 붙이는 간단한 함수는 다음과 같습니다.
def register_backward_hook(self, hook):
    """
    Registers a backward hook for all parameters of the model that
    require gradients.
    """
    for p in self.module.parameters():
        if p.requires_grad is True:
            p.register_post_accumulate_grad_hook(hook)
계산과 통신을 겹치면 모델 전체에서 그래디언트 동기화를 기다리는 시간이 줄어듭니다. 그래디언트 동기화가 같은 학습 스텝 안에서 역전파와 (적어도 일부는) 병렬로 일어날 수 있으므로 데이터 병렬화가 크게 빨라집니다. 동기화 겹치기를 적용한 단순한 DP의 전체 구현은 다음과 같습니다.
👉 Picotron의 겹치기를 적용한 단순 DP 구현 (펼치려면 클릭)
이것이 계산과 통신을 겹친다는 개념의 첫 예입니다. 겹치기는 확장 효율을 최대로 끌어올리는 데 꼭 필요한 기법으로, 이 책에서 여러 번 다시 다룹니다. 하지만 효율을 더 높일 수도 있습니다!
두 번째 최적화: 그래디언트 버킷 묶기
GPU 연산은 보통 작은 텐서에 연산을 여러 번 돌리기보다 큰 텐서에 한 번에 수행할 때 더 효율적입니다. 통신 연산도 마찬가지입니다. 그래서 그래디언트마다 AllReduce 연산을 따로 수행하는 대신, 그래디언트를 “버킷”으로 묶고 같은 버킷 안의 모든 그래디언트에 AllReduce를 한 번만 실행하면 이득입니다. 대체로 다음과 같은 모습입니다.
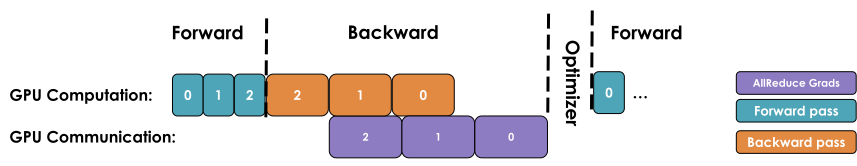
물건을 부치기 전에 상자에 담아 두는 것과 같다고 생각하면 됩니다. 작은 상자를 여러 개 보내는 것보다 큰 상자 몇 개를 보내는 편이 더 효율적입니다. 버킷마다 AllReduce 연산을 한 번씩만 수행하면 통신 오버헤드를 크게 줄이고 통신 연산을 빠르게 할 수 있습니다.
버킷 묶기를 적용한 구현 코드는 다음과 같습니다.
👉 Picotron의 버킷 DP 구현 (펼치려면 클릭)
세 번째 최적화: 그래디언트 누적과의 상호작용
마지막으로, 앞에서 보았듯이 그래디언트 누적은 optimizer.step()으로 파라미터를 업데이트하기 전에 순전파와 역전파를 여러 번 수행하는 방식입니다. 그래디언트 누적을 데이터 병렬화와 함께 쓸 때는 그래디언트를 언제 동기화할지 주의해야 합니다.
단순한 구현에서는 누적하는 동안 역전파가 끝날 때마다 AllReduce 연산이 자동으로 실행됩니다. 이는 최선이 아닙니다. 마지막 스텝 뒤에 Reduce를 한 번만 해도 효과는 같으면서 오버헤드는 줄어들기 때문입니다.
PyTorch에서는 보통 Reduce가 필요 없는 역전파에 그래디언트 동기화를 끄는 model.no_sync() 데코레이터를 붙여서 이 문제를 해결합니다.
📝 참고
통신 연산에서 불필요한 메모리 복사를 피하려면 텐서가 메모리에 연속으로 놓여 있어야 합니다. 이를 최적으로 처리하려고 활성값이나 모델 파라미터 크기만 한 연속 버퍼를 통신 전용으로 미리 할당해 두는 경우가 많습니다. 이렇게 하면 통신은 빨라지지만, 학습 중 최대 메모리 사용량을 어느 정도 끌어올리기도 합니다.
이제 이것이 전역 배치 크기에 어떤 의미인지 살펴보겠습니다.
전역 배치 크기 다시 보기
새로 더한 데이터 병렬화와 그래디언트 누적 파라미터를 넣어 배치 크기 식을 고쳐 쓸 수 있습니다.
여기서 는 그래디언트 누적 스텝 수이고, 는 데이터 병렬화에 쓰는 병렬 인스턴스 수입니다.
따라서 목표 전역 배치 크기가 정해져 있으면, 그래디언트 누적 스텝을 데이터 병렬 프로세스로 맞바꿔 학습을 빠르게 할 수 있습니다.
실제로는 그래디언트 누적()보다 데이터 병렬 크기()를 최대한 키우는 편입니다. 그래디언트 누적은 본질적으로 순차적이지만 데이터 병렬화는 본래 병렬이기 때문입니다. 그러다 데이터 병렬화만 늘려서는 목표 전역 배치 크기에 닿기 전에 GPU가 바닥나면, 그때 데이터 병렬화 위에 그래디언트 누적을 더합니다.
학습을 서로 다른 샘플에 나눠 맡길 수 있으니 병렬화의 첫 번째 차원을 얻은 셈이고, 그래서 이것을 1D 병렬화라고 합니다(앞으로 차원 네 개를 차례로 더 다룹니다).
지금까지의 여정
최적의 데이터 병렬 설정을 위한 대략적인 레시피로, 첫 1D 병렬 학습을 어떻게 구성하는지 빠르게 정리해 보겠습니다.
- 먼저 문헌을 참고하거나 모델 수렴을 측정하는 실험을 돌려, 토큰 단위로 가장 좋은 (전역) 배치 크기를 정합니다.
- 다음으로, 역시 문헌을 참고하거나 실험을 돌려 학습에 쓸 시퀀스 길이를 고릅니다. 대체로 2-8k 토큰이면 오늘날의 평가 벤치마크에서 안정적으로 잘 통합니다(여기서 학습 레시피까지 깊이 다루지는 않겠지만, 보통 팀들은 학습 막바지에 시퀀스 길이를 늘리면서 더 긴 컨텍스트의 데이터 샘플을 일부 섞어 요즘 수준의 긴 컨텍스트 크기에 도달합니다).
- 이제 배치 크기()를 압니다. GPU 한 개에서 메모리가 부족해질 때까지 로컬 배치 크기를 늘려 보면 최대 로컬 배치 크기()를 찾을 수 있습니다.
- 마지막으로, 목표 에 쓸 수 있는 GPU 수를 정합니다. 와 의 비율을 보면 원하는 에 필요한 나머지 그래디언트 누적 스텝 수를 알 수 있습니다.
그래디언트 누적 비율이 1보다 작다면(즉 GPU가 너무 많은, 그러니까 GPU 부자인 🤑 (!) 경우라면), GPU를 다 쓰지 않거나, 더 큰 를 시도하거나, 더 작은 가 학습을 빠르게 하는지 시험해 볼 수 있습니다. 마지막 경우에는 학습 속도를 높이려고 메모리에 들어가는 최대치보다 작은 를 쓰게 되므로, GPU 하나하나의 계산 효율보다 처리량을 우선하는 셈입니다.
구체적인 예를 볼 차례입니다. 최신 모델을 4M 토큰, 시퀀스 길이 4k로 학습하고 싶다고 합시다. 그러면 배치 크기는 1,024 샘플이 됩니다(가장 가까운 2의 거듭제곱을 고릅니다). GPU 한 개의 메모리에는 =2까지만 들어간다는 것을 확인했고, 학습에 쓸 수 있는 GPU가 128개 있다고 가정해 봅시다. 그러면 그래디언트 누적 스텝 4번으로 학습 스텝마다 1,024 샘플, 곧 4M 토큰이라는 목표를 채울 수 있습니다. 그런데 갑자기 GPU 512개를 쓸 수 있게 되면 어떨까요? =2를 유지하고 그래디언트 누적 스텝 수를 1로 두면 같은 를 얻으면서 학습은 더 빨라집니다!
📝 참고
GPU 512개 이상 규모에서는 쓰는 네트워크에 따라 통신 연산이 링 지연 시간(ring latency, 신호가 링을 한 바퀴 도는 데 걸리는 시간)에 묶이기 시작한다는 점을 기억해 두세요. 그러면 DP 통신을 더는 완전히 겹칠 수 없습니다. 계산 효율이 떨어지고 처리량도 타격을 받습니다. 이럴 때는 병렬화할 다른 차원을 찾아보기 시작해야 합니다.
데이터 병렬화는 AllReduce 그래디언트 동기화를 역전파 계산과 잘 겹쳐서 시간을 아껴 주지만, 규모가 커지면 이 이점이 무너지기 시작합니다. 왜일까요? GPU를 수백, 수천 개로 계속 늘리면 GPU 사이를 조율하는 오버헤드가 크게 늘고, 네트워크 요구량이 얻는 이점에 비해 지나치게 커지기 시작합니다. 그 결과 시스템에 GPU를 하나 더할 때마다 설정의 효율은 점점 떨어집니다.
몇 가지 벤치마크로 이런 현상을 실제로 확인할 수 있습니다.
그림에서 보듯 어느 한계를 넘으면 처리량은 꽤 크게 떨어지기 시작하지만, GPU당 메모리 사용량은 일정하게 유지되며 DP 랭크를 더해도 달라지지 않습니다.
데이터 병렬화는 학습을 더 많은 GPU로 확장하는 첫 번째 (간단한) 전략이었습니다. 이 기법은 그래디언트 누적처럼 동작하지만 마이크로배치의 순전파와 역전파를 병렬로 처리하므로 처리량이 늘어납니다.
그런데 눈치 빠른 독자라면 이미 알아채셨을 텐데, 이 방식은 적어도 입력 샘플 하나의 순전파(=1)는 GPU 메모리에 들어간다고 가정합니다. 늘 그렇지는 않습니다! 보다시피 큰 모델은 활성값 재계산을 켜도 GPU 한 개에 들어가지 않는 경우가 많습니다.
또한 데이터 병렬화는 일정 규모를 넘으면 통신 오버헤드가 발목을 잡기 시작한다는 것도 보았습니다. 이런 큰 모델이나 큰 배치 크기에 쓸 다른 방법은 없을까요? 다행히 몇 가지 해법이 있습니다. 일부 텐서를 CPU로 옮기거나, 가중치, 그래디언트, 옵티마이저 상태 텐서를 여러 GPU에 나눠 두는 방법입니다.
나누는 방법은 크게 병렬화(텐서 병렬화 TP, 컨텍스트 병렬화 CP, 파이프라인 병렬화 PP)와 샤딩(sharding, DeepSpeed ZeRO나 PyTorch FSDP) 두 가지입니다. 두 방식은 어느 정도 서로 직교하므로 실제로 함께 쓸 수도 있습니다!
샤딩 패러다임은 DP와 밀접하므로, ZeRO 방법을 살펴보며 샤딩부터 알아보겠습니다.
Zero Redundancy Optimizer (ZeRO)
이 절에서는 LLM 학습에서 메모리 중복을 줄이도록 설계된 메모리 최적화 기술인 DeepSpeed ZeRO를 소개합니다.
데이터 병렬화는 학습을 확장하는 효율적인 방법이지만, 옵티마이저 상태, 그래디언트, 파라미터를 DP 랭크마다 그대로 복제하면 메모리 중복이 상당해집니다. ZeRO는 옵티마이저 상태, 그래디언트, 파라미터를 데이터 병렬 차원을 따라 분할해 이 중복을 없애면서도, 계산은 여전히 전체 파라미터로 할 수 있게 해 줍니다. 이 때문에 DP 랭크 사이에 통신이 더 필요해지기도 하는데, 곧 보겠지만 이 통신은 완전히 겹칠 수 있을 때도 있고 없을 때도 있습니다!
이 방식은 세 가지 최적화 단계로 이루어집니다.
- ZeRO-1: 옵티마이저 상태 분할
- ZeRO-2: 옵티마이저 상태 + 그래디언트 분할
- ZeRO-3: 옵티마이저 상태 + 그래디언트 + 파라미터 분할
샤딩할 수 있는 목록에 활성값이 빠져 있다는 것을 눈치채셨을지도 모르겠습니다. 모델의 DP 복제본마다 다른 마이크로배치를 받으므로 DP 랭크마다 활성값도 다릅니다. 그러니 활성값은 중복되지 않고, 따라서 샤딩할 수도 없습니다!
ZeRO 단계별 분할로 메모리를 얼마나 아낄 수 있는지 자세히 살펴보겠습니다.
메모리 사용량 다시 보기
앞에서 일반적인 학습에서 옵티마이저 상태, 그래디언트, 파라미터가 차지하는 메모리를 다뤘습니다. 모델의 파라미터 수를 라고 부르겠습니다(앞에서는 이었지만, 여기서는 원래 ZeRO 논문5의 표기를 따릅니다). Adam 옵티마이저로 혼합 정밀도 학습(책 뒤쪽에서 더 다룹니다)을 할 때, 저장해야 하는 항목별 메모리 사용량은 다음과 같습니다.
- 모델 파라미터(반정밀도, 즉 BF16/FP16):
- 모델 그래디언트(반정밀도, 즉 BF16/FP16):
- FP32 모델 파라미터와 옵티마이저 상태:
- FP32 모델 그래디언트: (선택 사항, 그래디언트를 FP32로 누적하려는 경우에만 포함)
그래디언트를 FP32로 누적하지 않으면 전체 메모리 사용량은 이고, 누적하면 입니다. 간단히 하려고 당분간은 FP32 그래디언트 누적이 없는 경우만 보겠습니다.
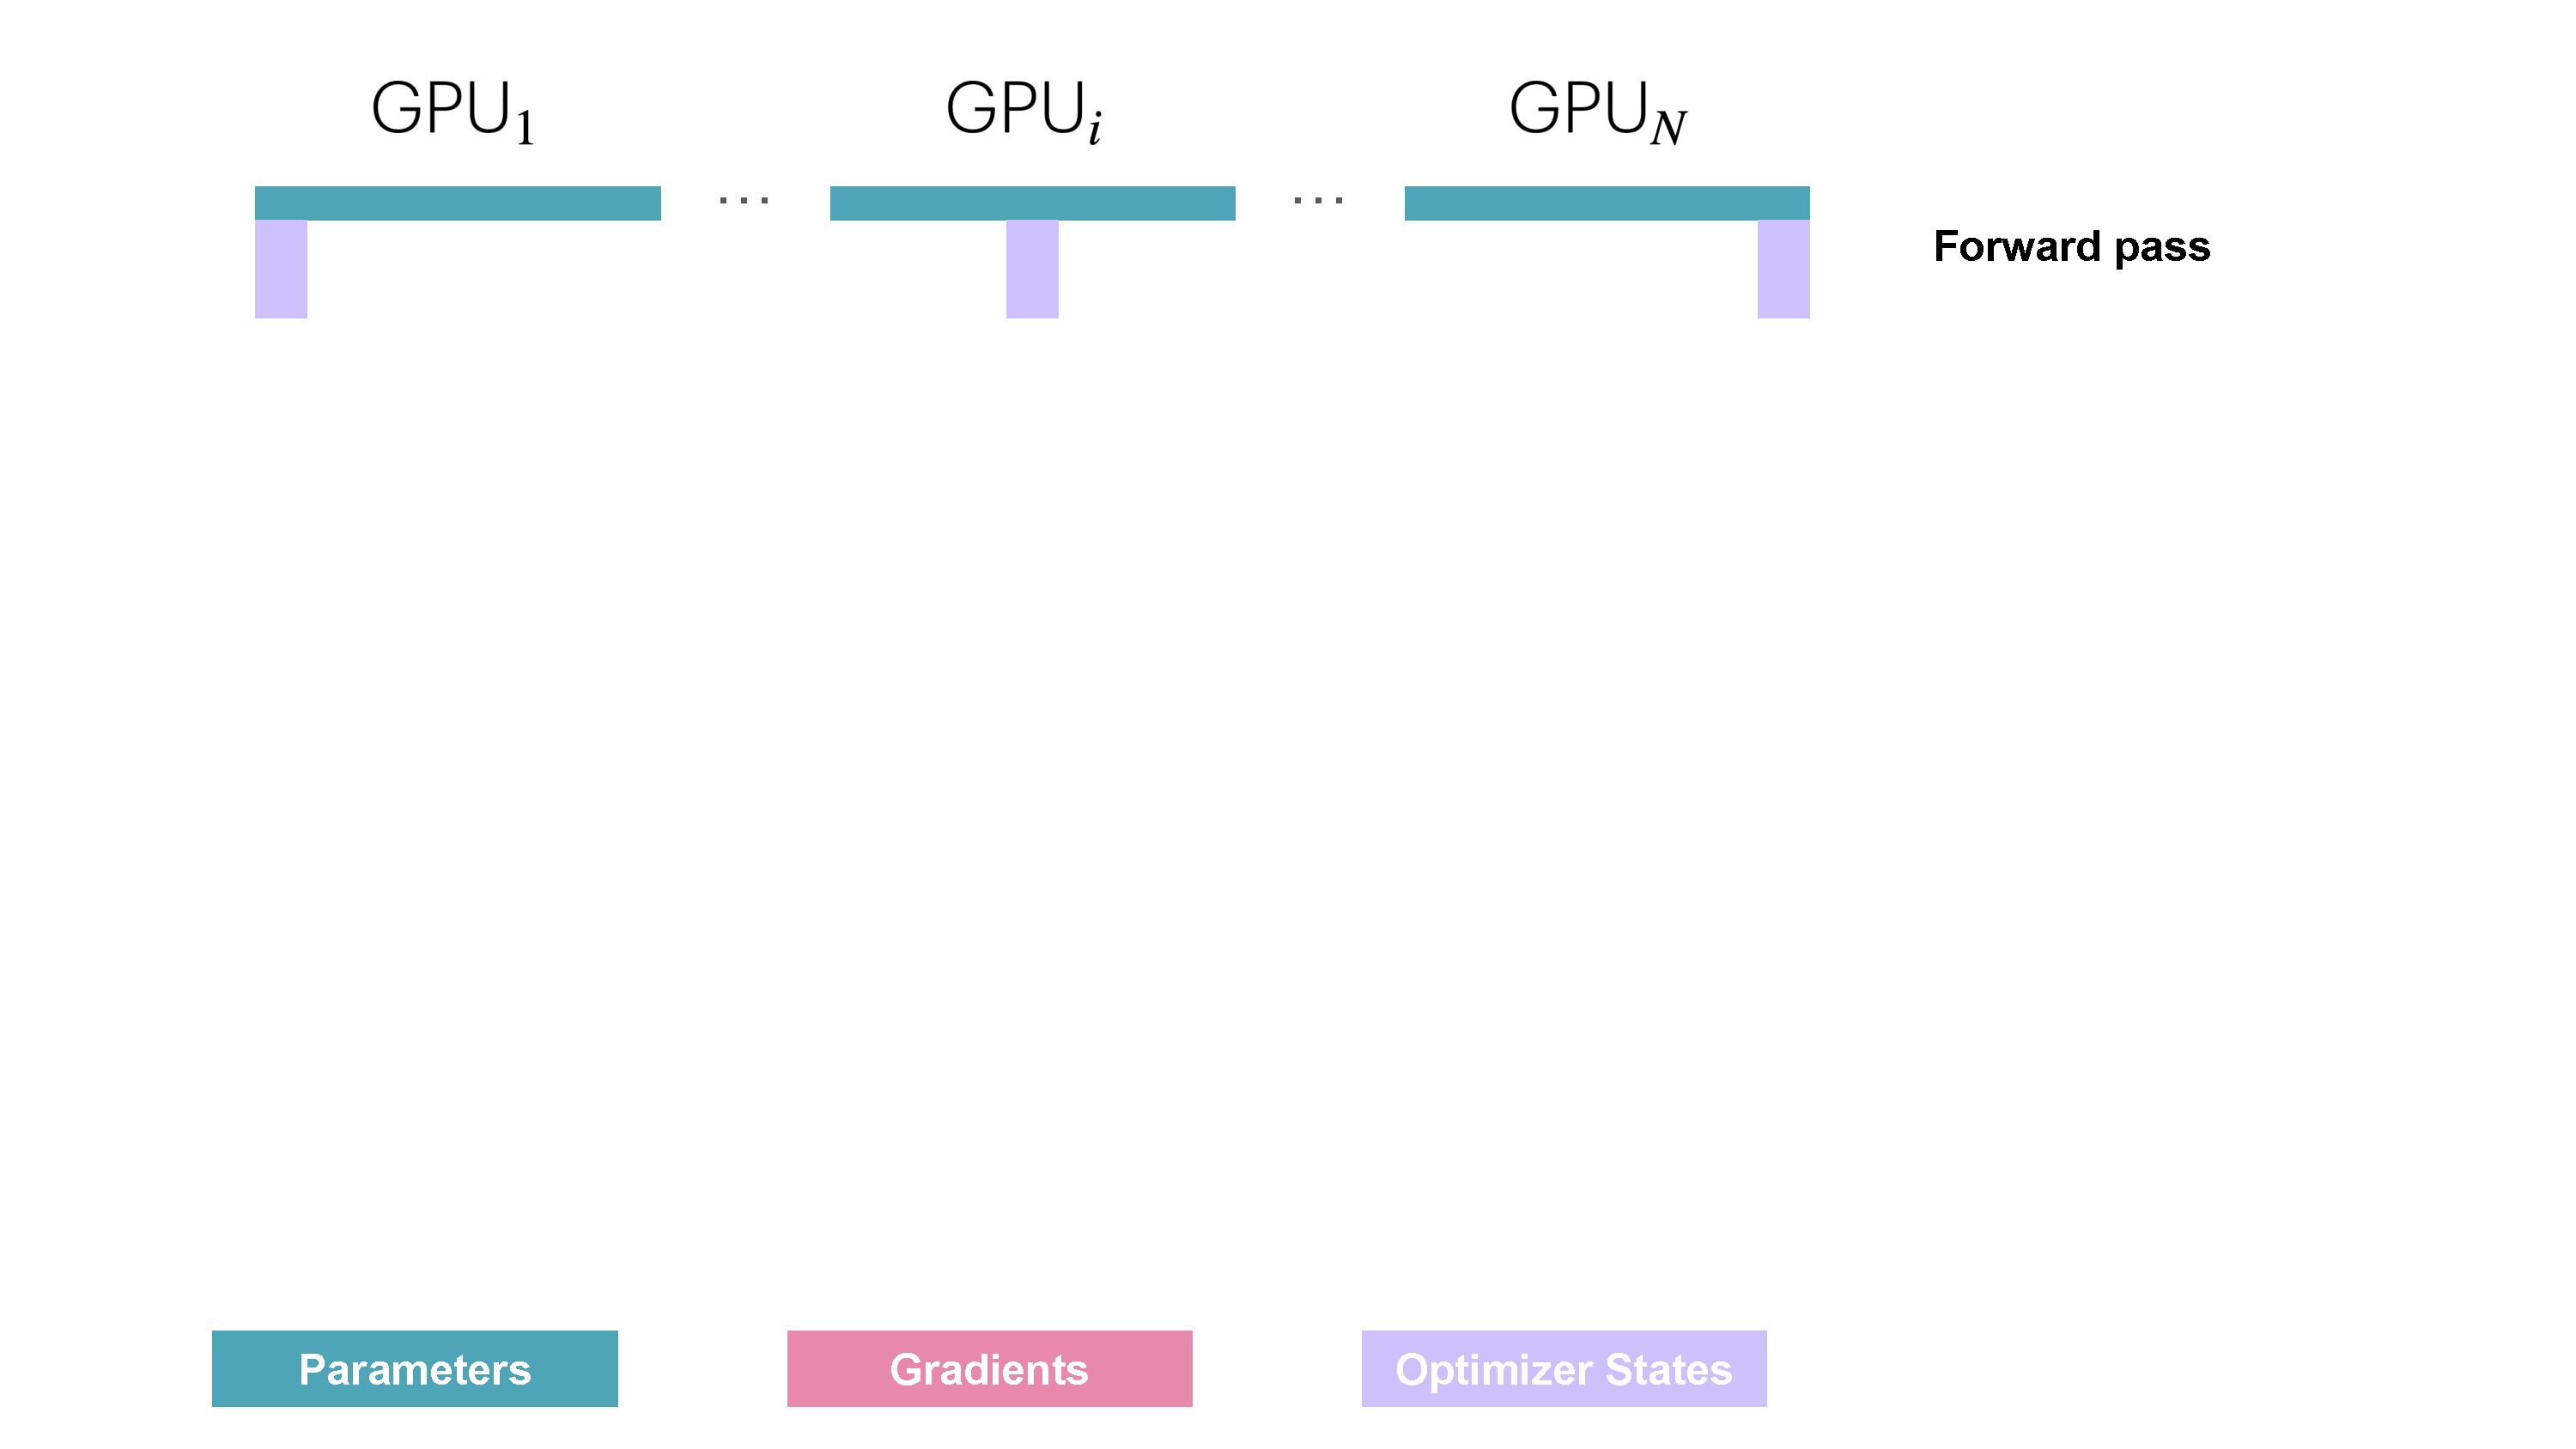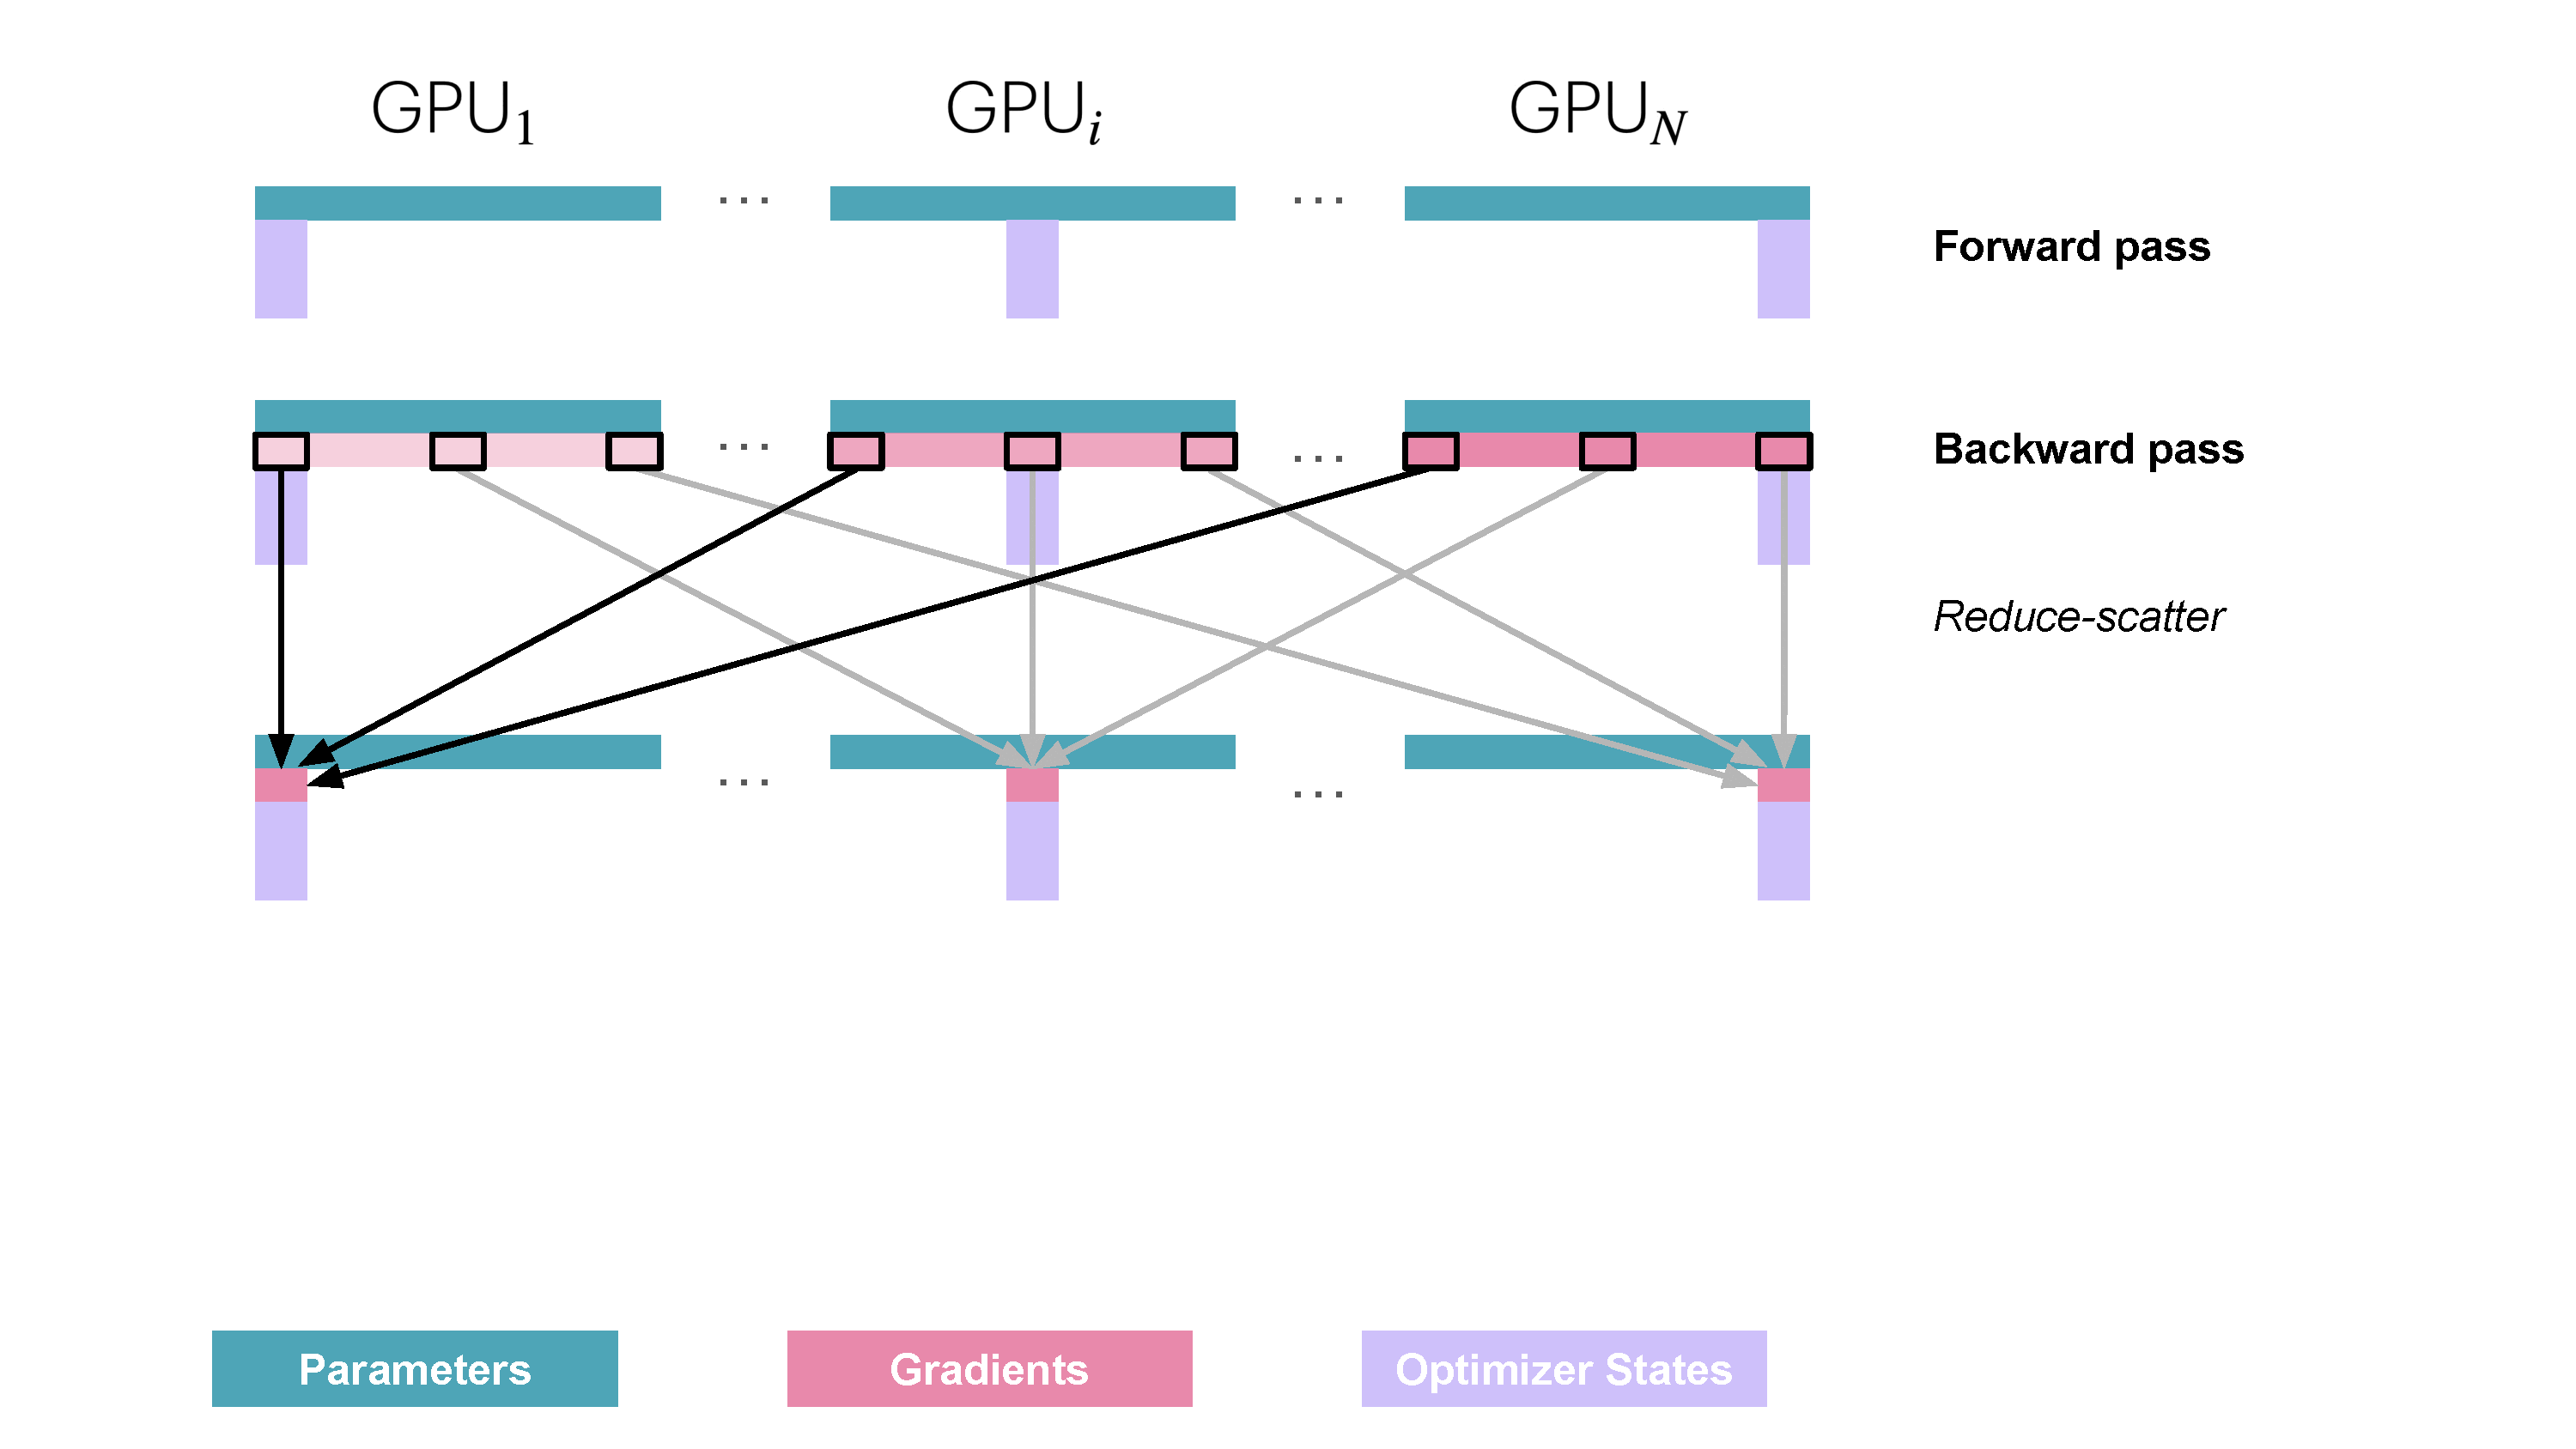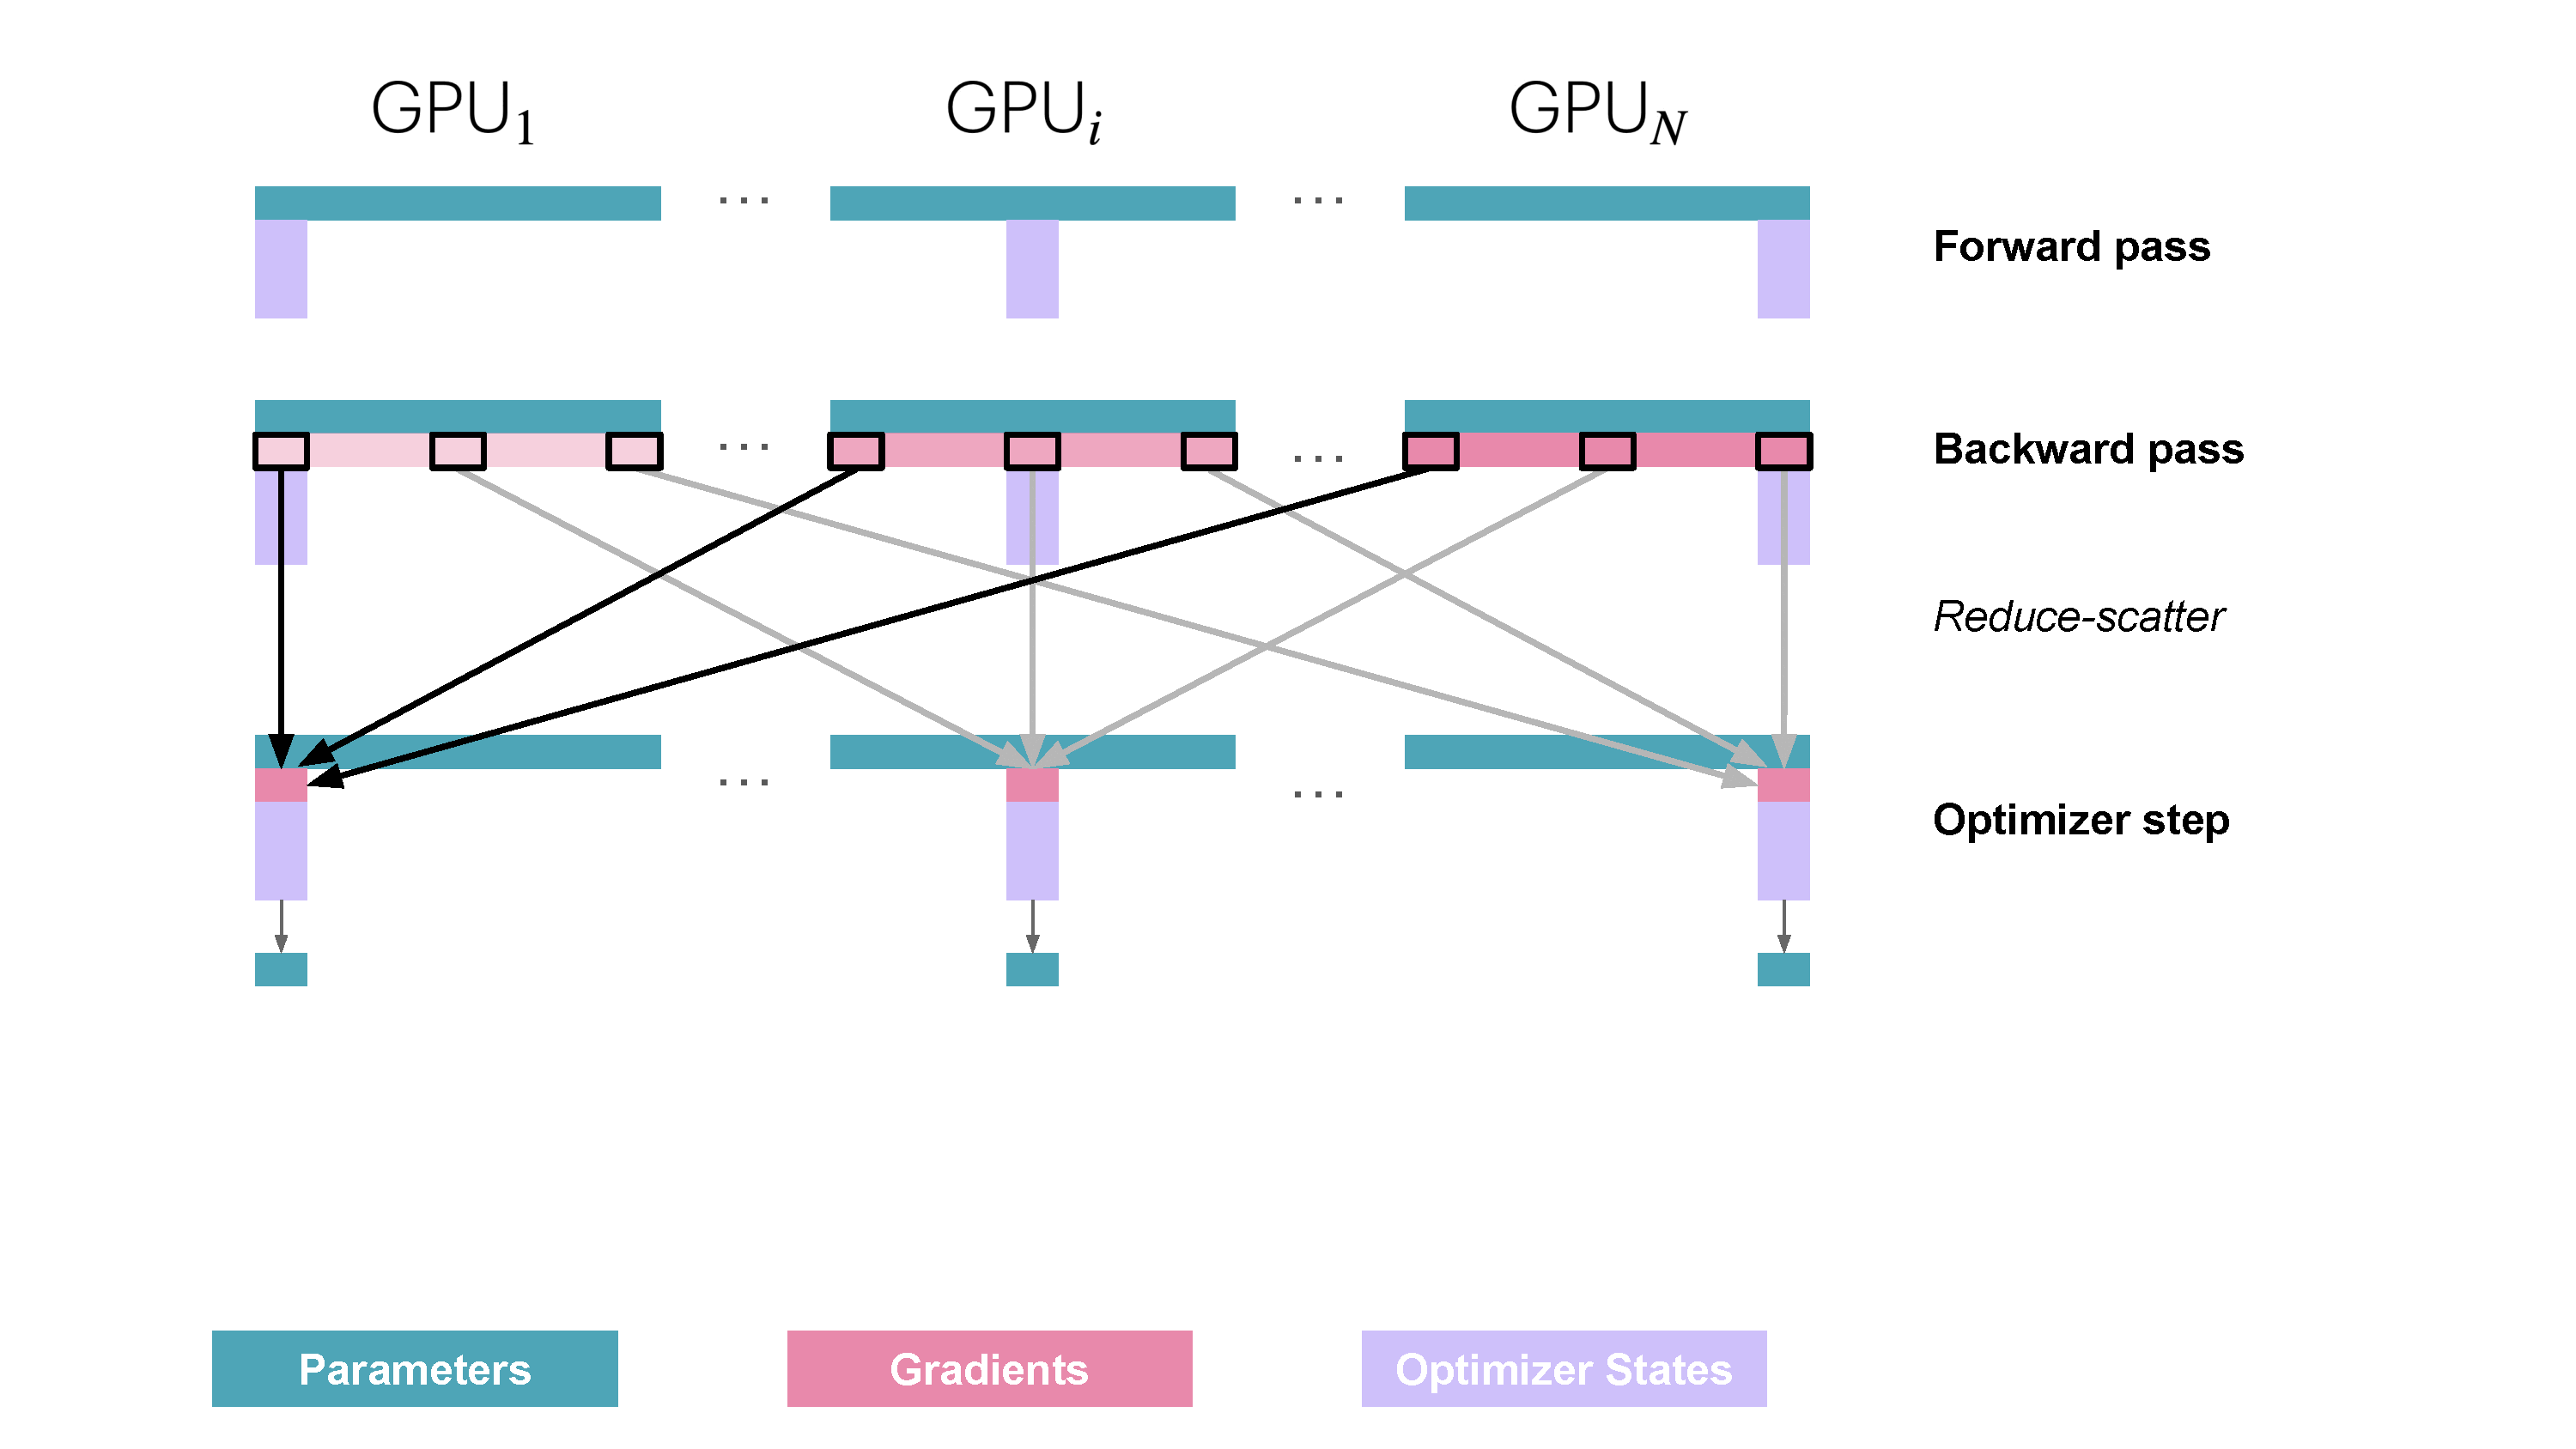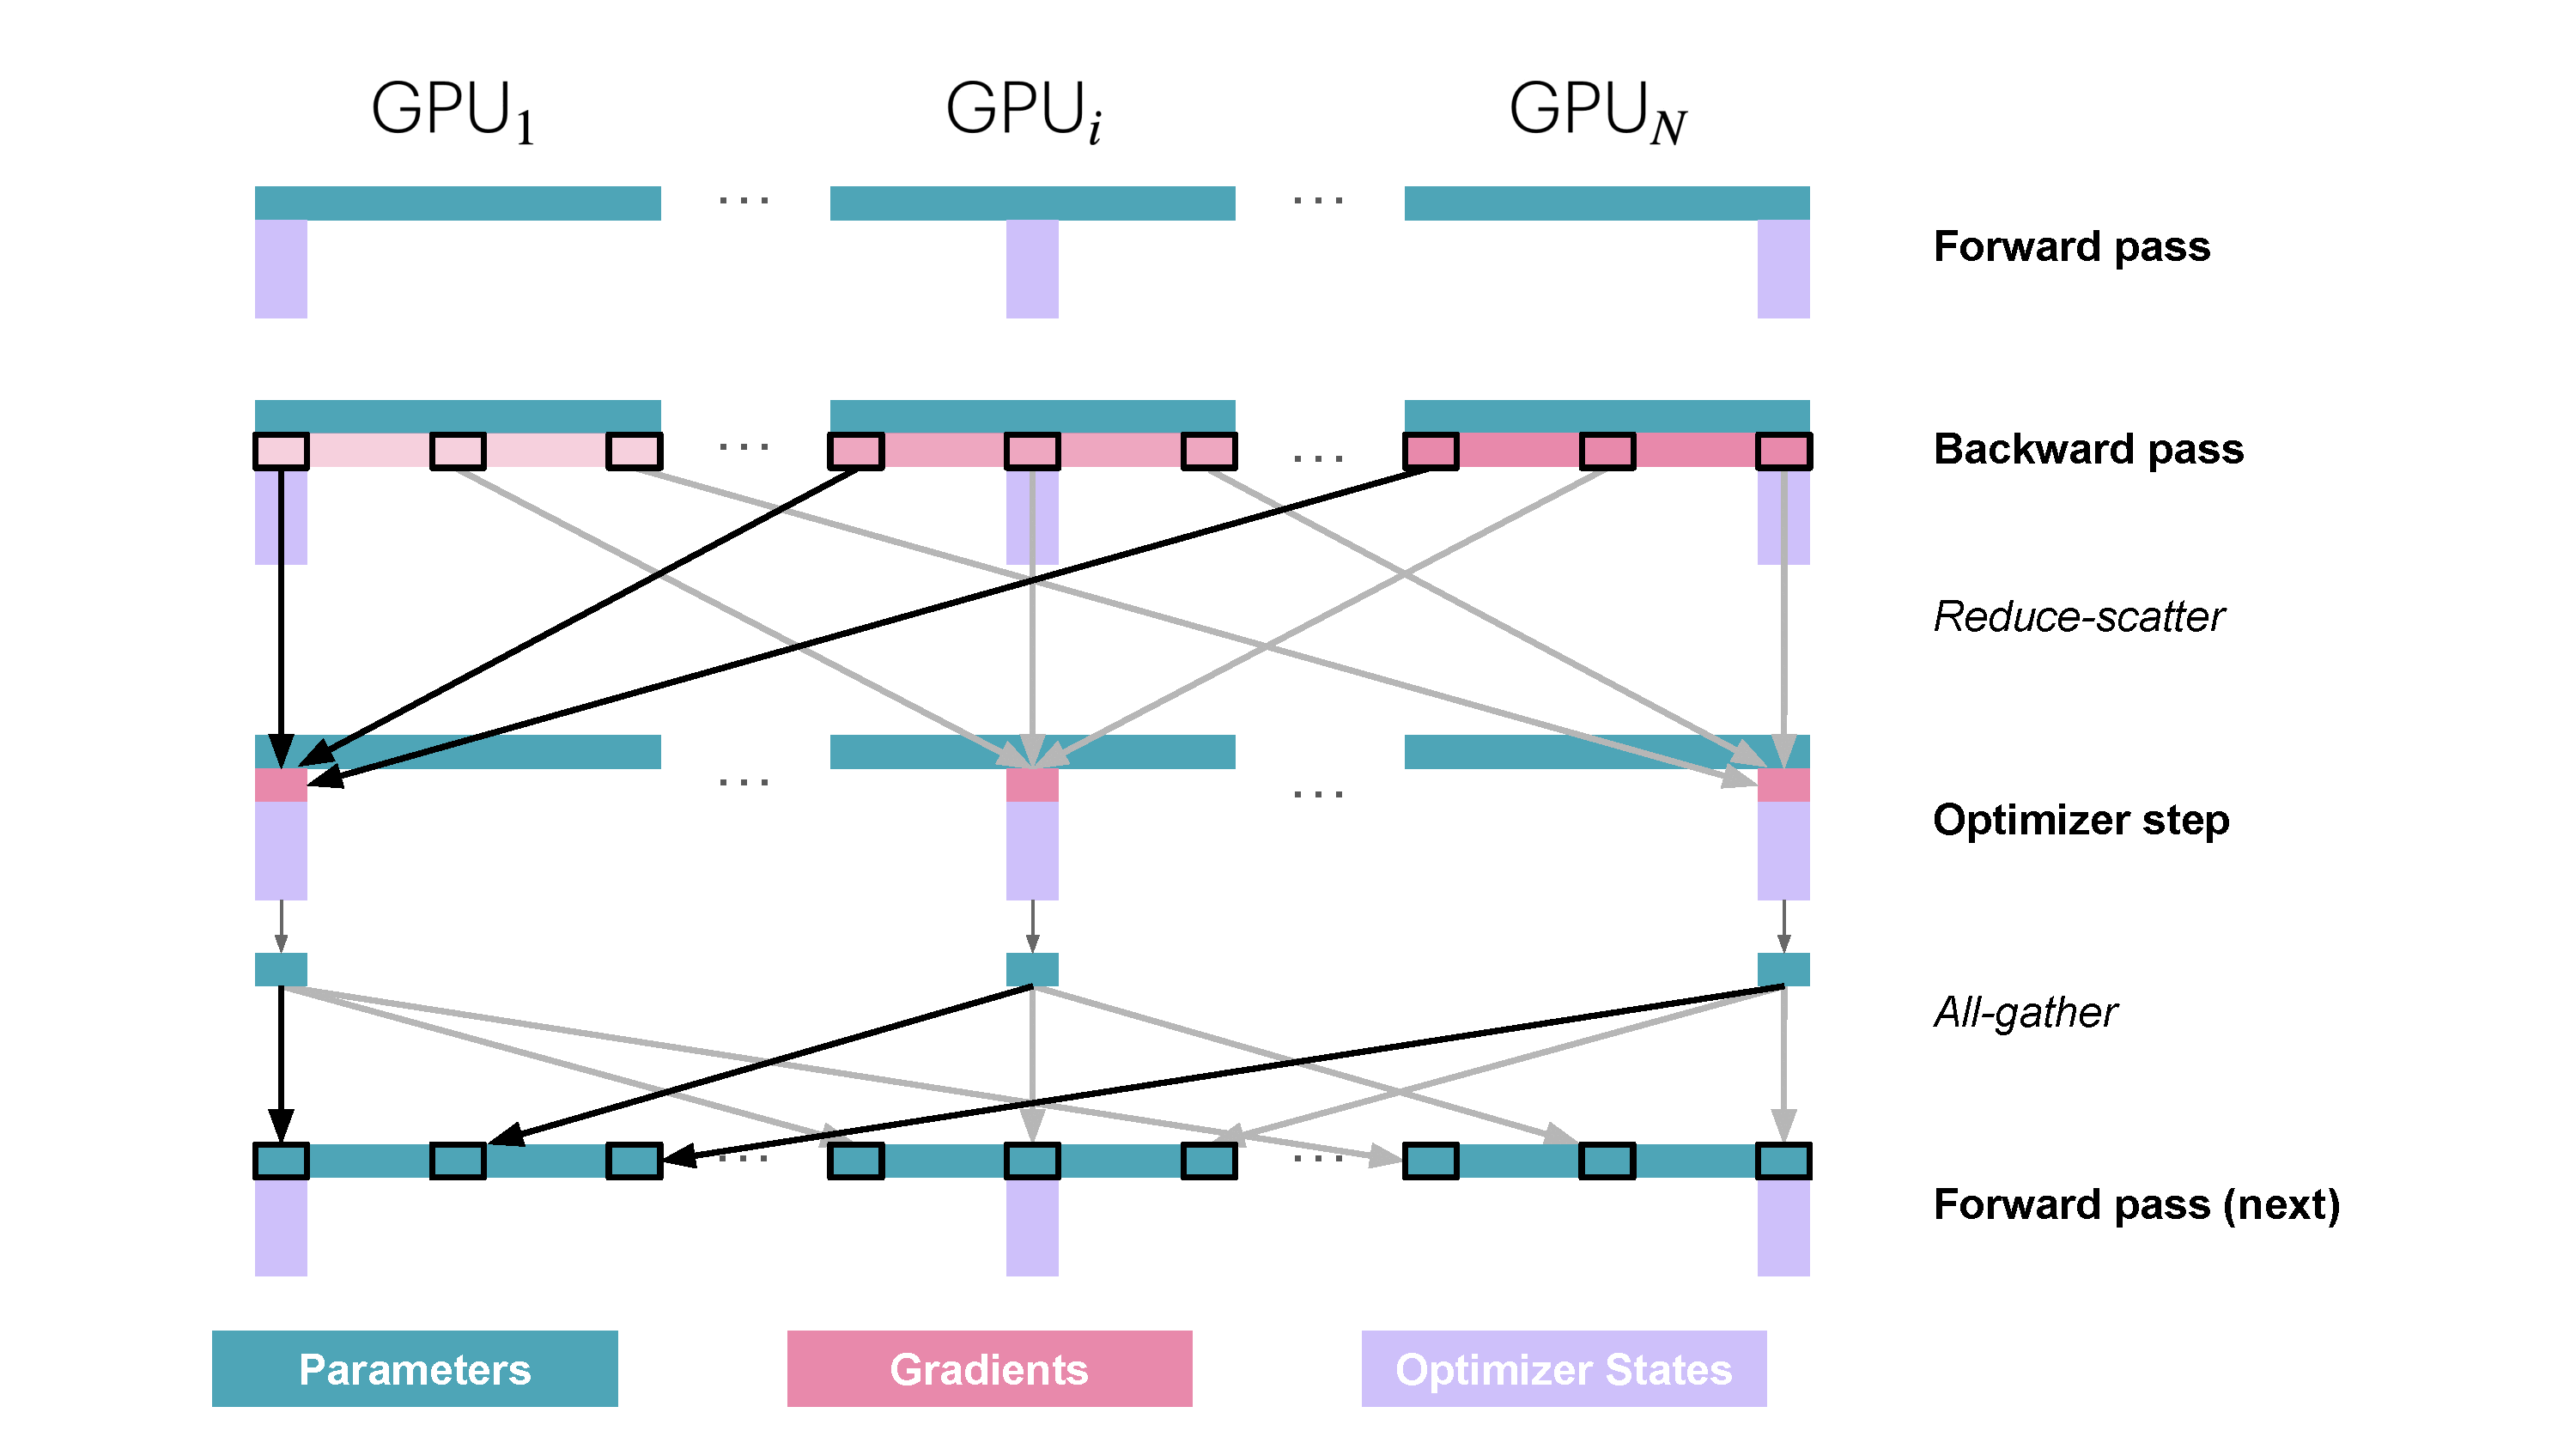
ZeRO의 발상은 이 객체들을 DP 랭크에 걸쳐 샤딩해, 각 노드가 항목의 한 조각만 저장하게 하는 것입니다. 이 조각들은 필요할 때, 필요한 경우에만 다시 합치므로 메모리 사용량이 데이터 병렬 차수 로 나뉩니다.
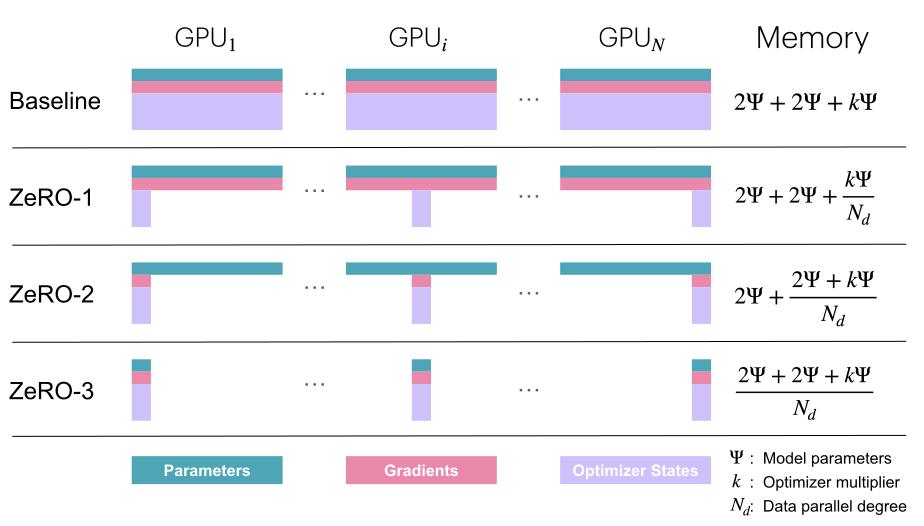
여기서 는 파라미터 수, 는 옵티마이저 상태의 메모리 배수(방금 보았듯 Adam이면 ), 는 DP 차수입니다.
ZeRO의 각 단계가 어떻게 동작하는지 살펴보며 이 식을 설명하겠습니다. ZeRO-1부터 시작합니다.
ZeRO-1: 옵티마이저 상태 분할
기본 DP에서는 모든 랭크가 역전파 뒤에 같은 그래디언트를 모으고, 똑같은 옵티마이저 스텝을 동시에 수행합니다. 중복되는 작업이 꽤 많아 보입니다. 이 중복을 피하면서 메모리 사용량도 함께 줄일 수 있을까요?
ZeRO-1에서는 옵티마이저 상태를 개의 같은 크기 조각으로 나눕니다. 여기서 는 DP 차수입니다. 따라서 DP 랭크에 흩어진 모델 복제본은 저마다 옵티마이저 상태의 만 관리하고, 최적화 스텝에서는 FP32 가중치의 만 업데이트합니다.
하지만 순전파에서는 복제본마다 모든 파라미터가 필요합니다. 그래서 옵티마이저 스텝 뒤에 AllGather(지금까지 만난 두 번째 집합 통신 프리미티브입니다!)를 하나 더 넣어, 모델 복제본마다 업데이트된 가중치 전체를 갖게 해야 합니다.
앞 그림에서 본 메모리 식 가 바로 이렇게 나옵니다! 학습 스텝 하나에서 일어나는 연산 순서를 정리하면 다음과 같습니다.
- 복제본마다 똑같은 BF16 파라미터 전체로, 하지만 복제본마다 다른 마이크로배치로 순전파를 수행합니다.
- 복제본마다 똑같은 전체 그래디언트로, 하지만 복제본마다 다른 마이크로배치로 역전파를 수행합니다.
- 그래디언트에 ReduceScatter를 수행합니다(또 다른 프리미티브로, 곧 설명합니다).
- 복제본마다 로컬 옵티마이저 상태(옵티마이저 상태의 뿐)로 옵티마이저 스텝을 수행해 업데이트된 FP32 파라미터 을 얻고, 이를 전체 BF16 파라미터의 로 변환할 수 있습니다.
- BF16 파라미터에 AllGather를 수행해 빠진 조각을 각 복제본에 돌려보냅니다. 이것은 ZeRO에서 새로 생긴 연산으로, 기본 DP에서는 쓰지 않습니다.
이 “ReduceScatter” 연산이 무엇이고 전체가 어떤 모습인지 궁금하실 테니, 아래 그림으로 좀 더 눈에 보이게 그려 보겠습니다. 순전파/역전파 한 주기의 모든 단계를 차례로 짚어 봅니다.
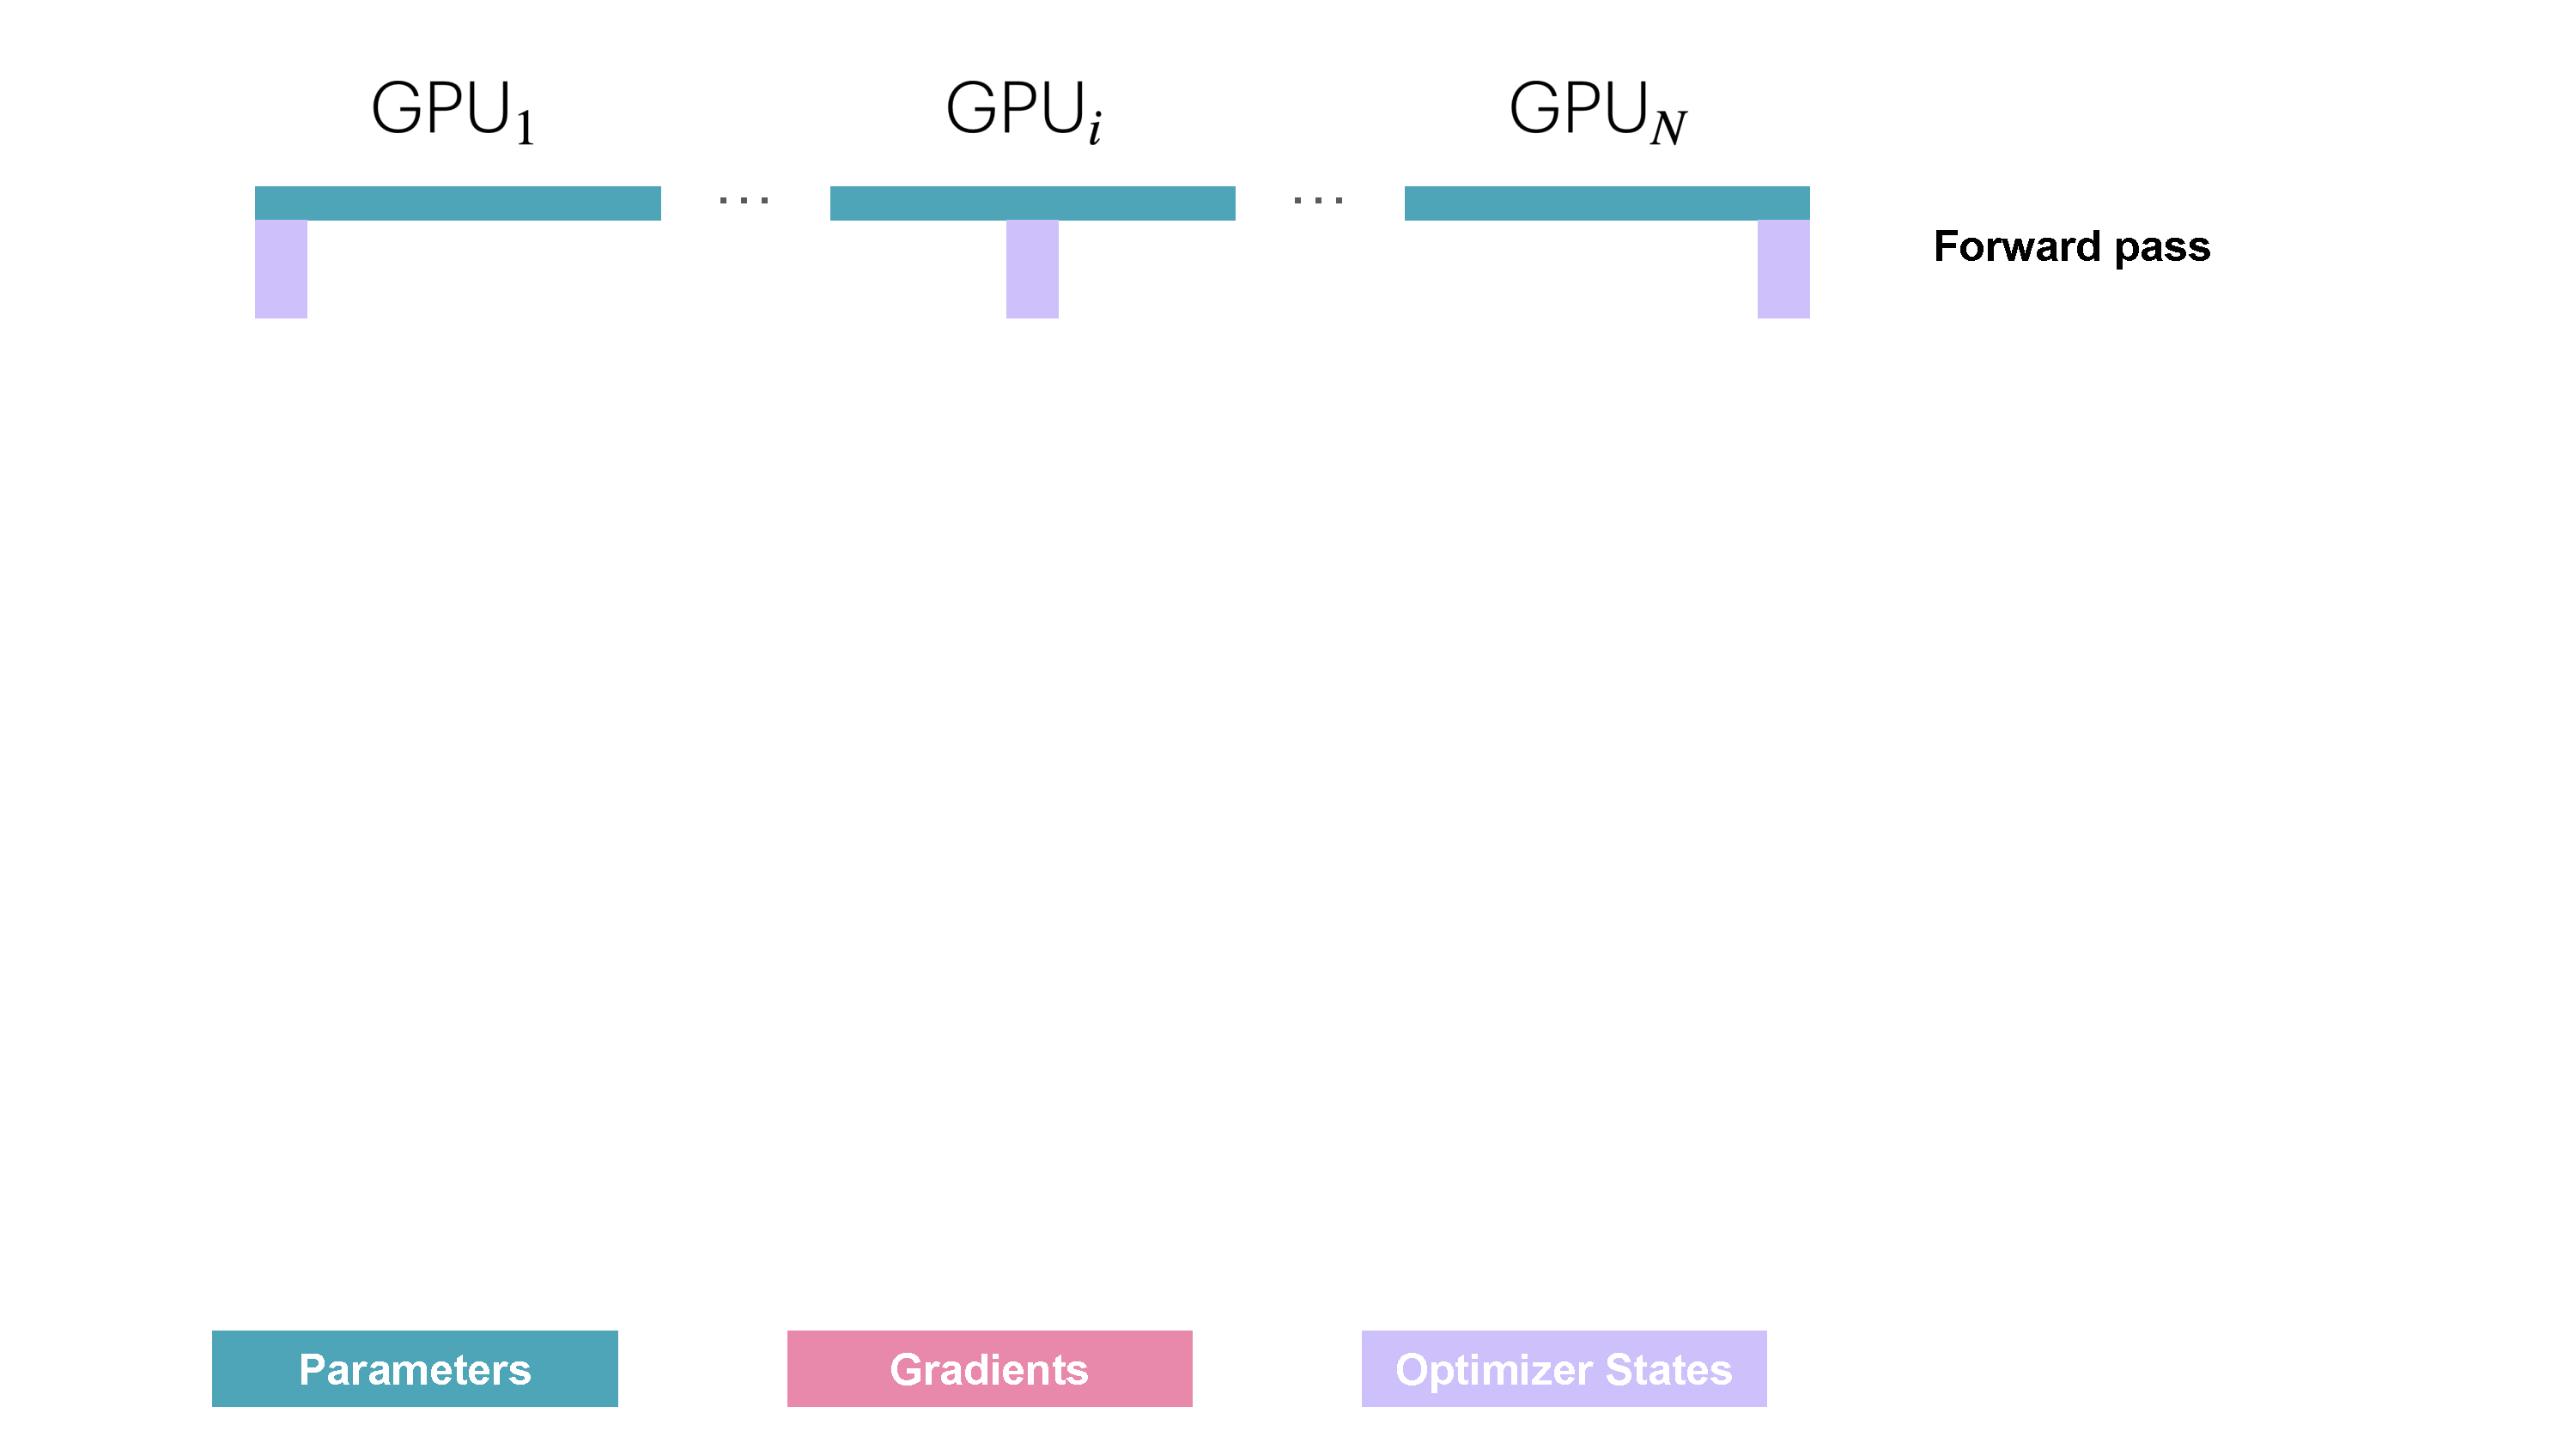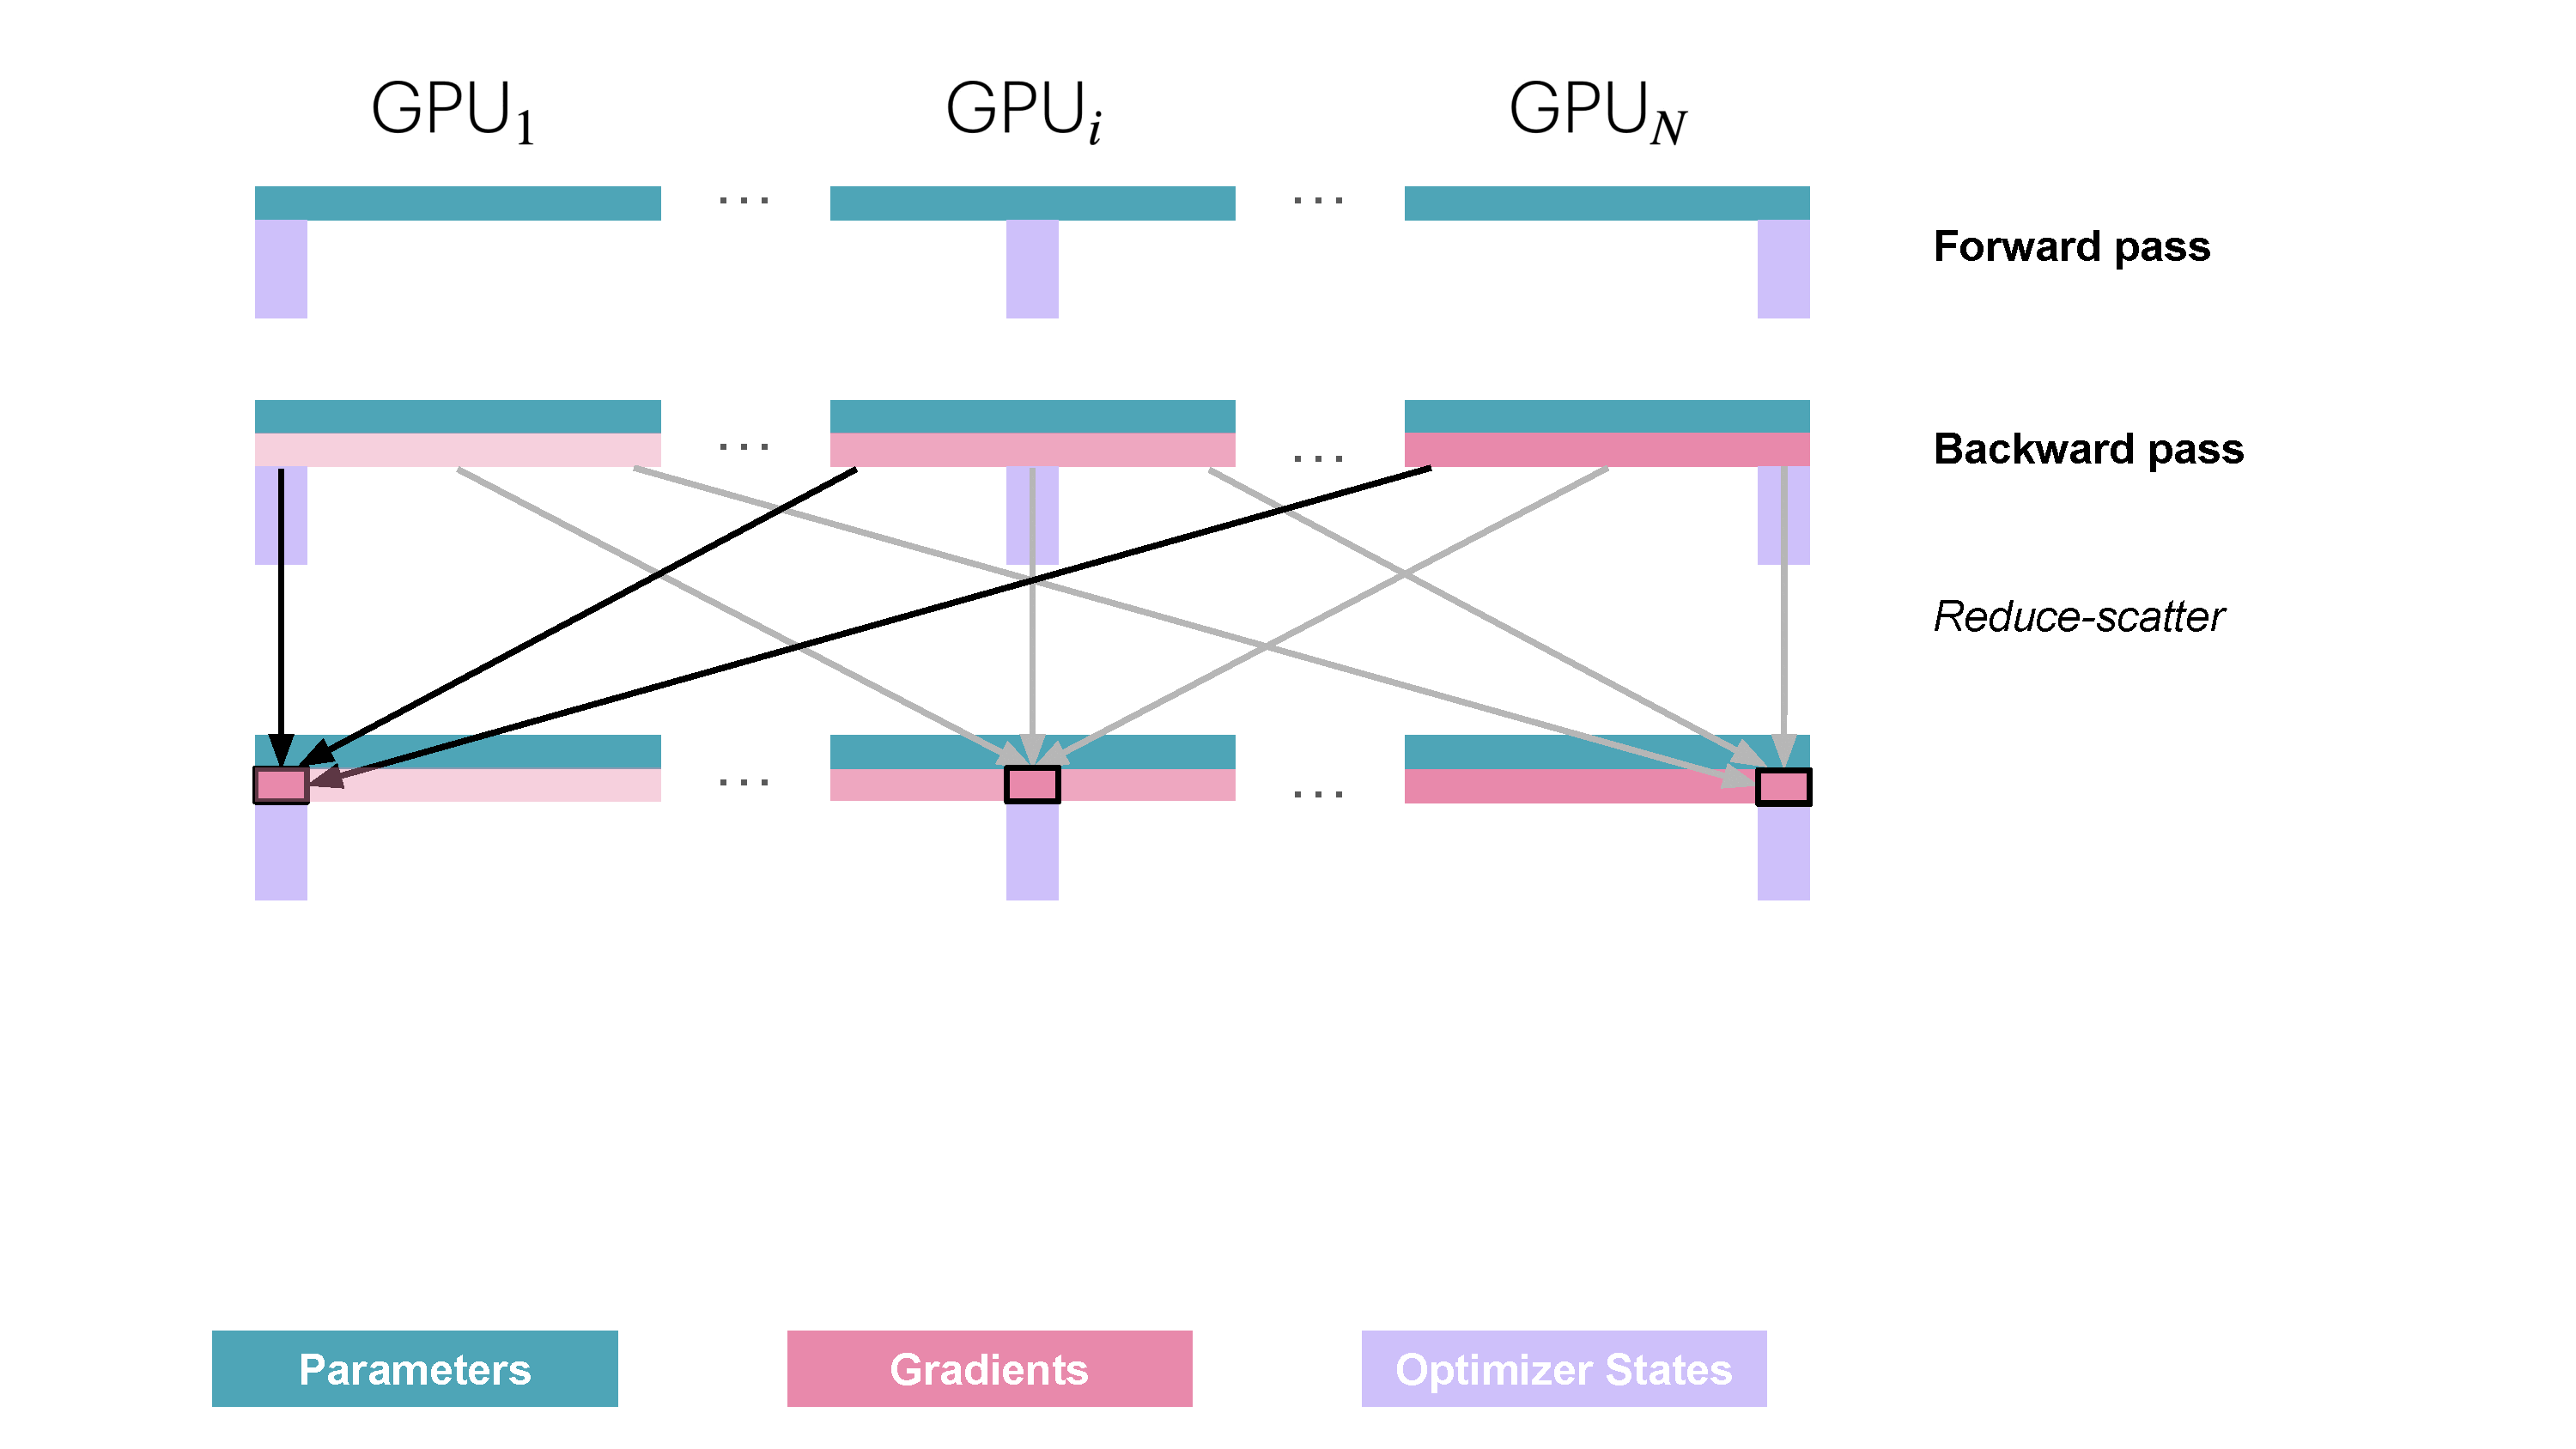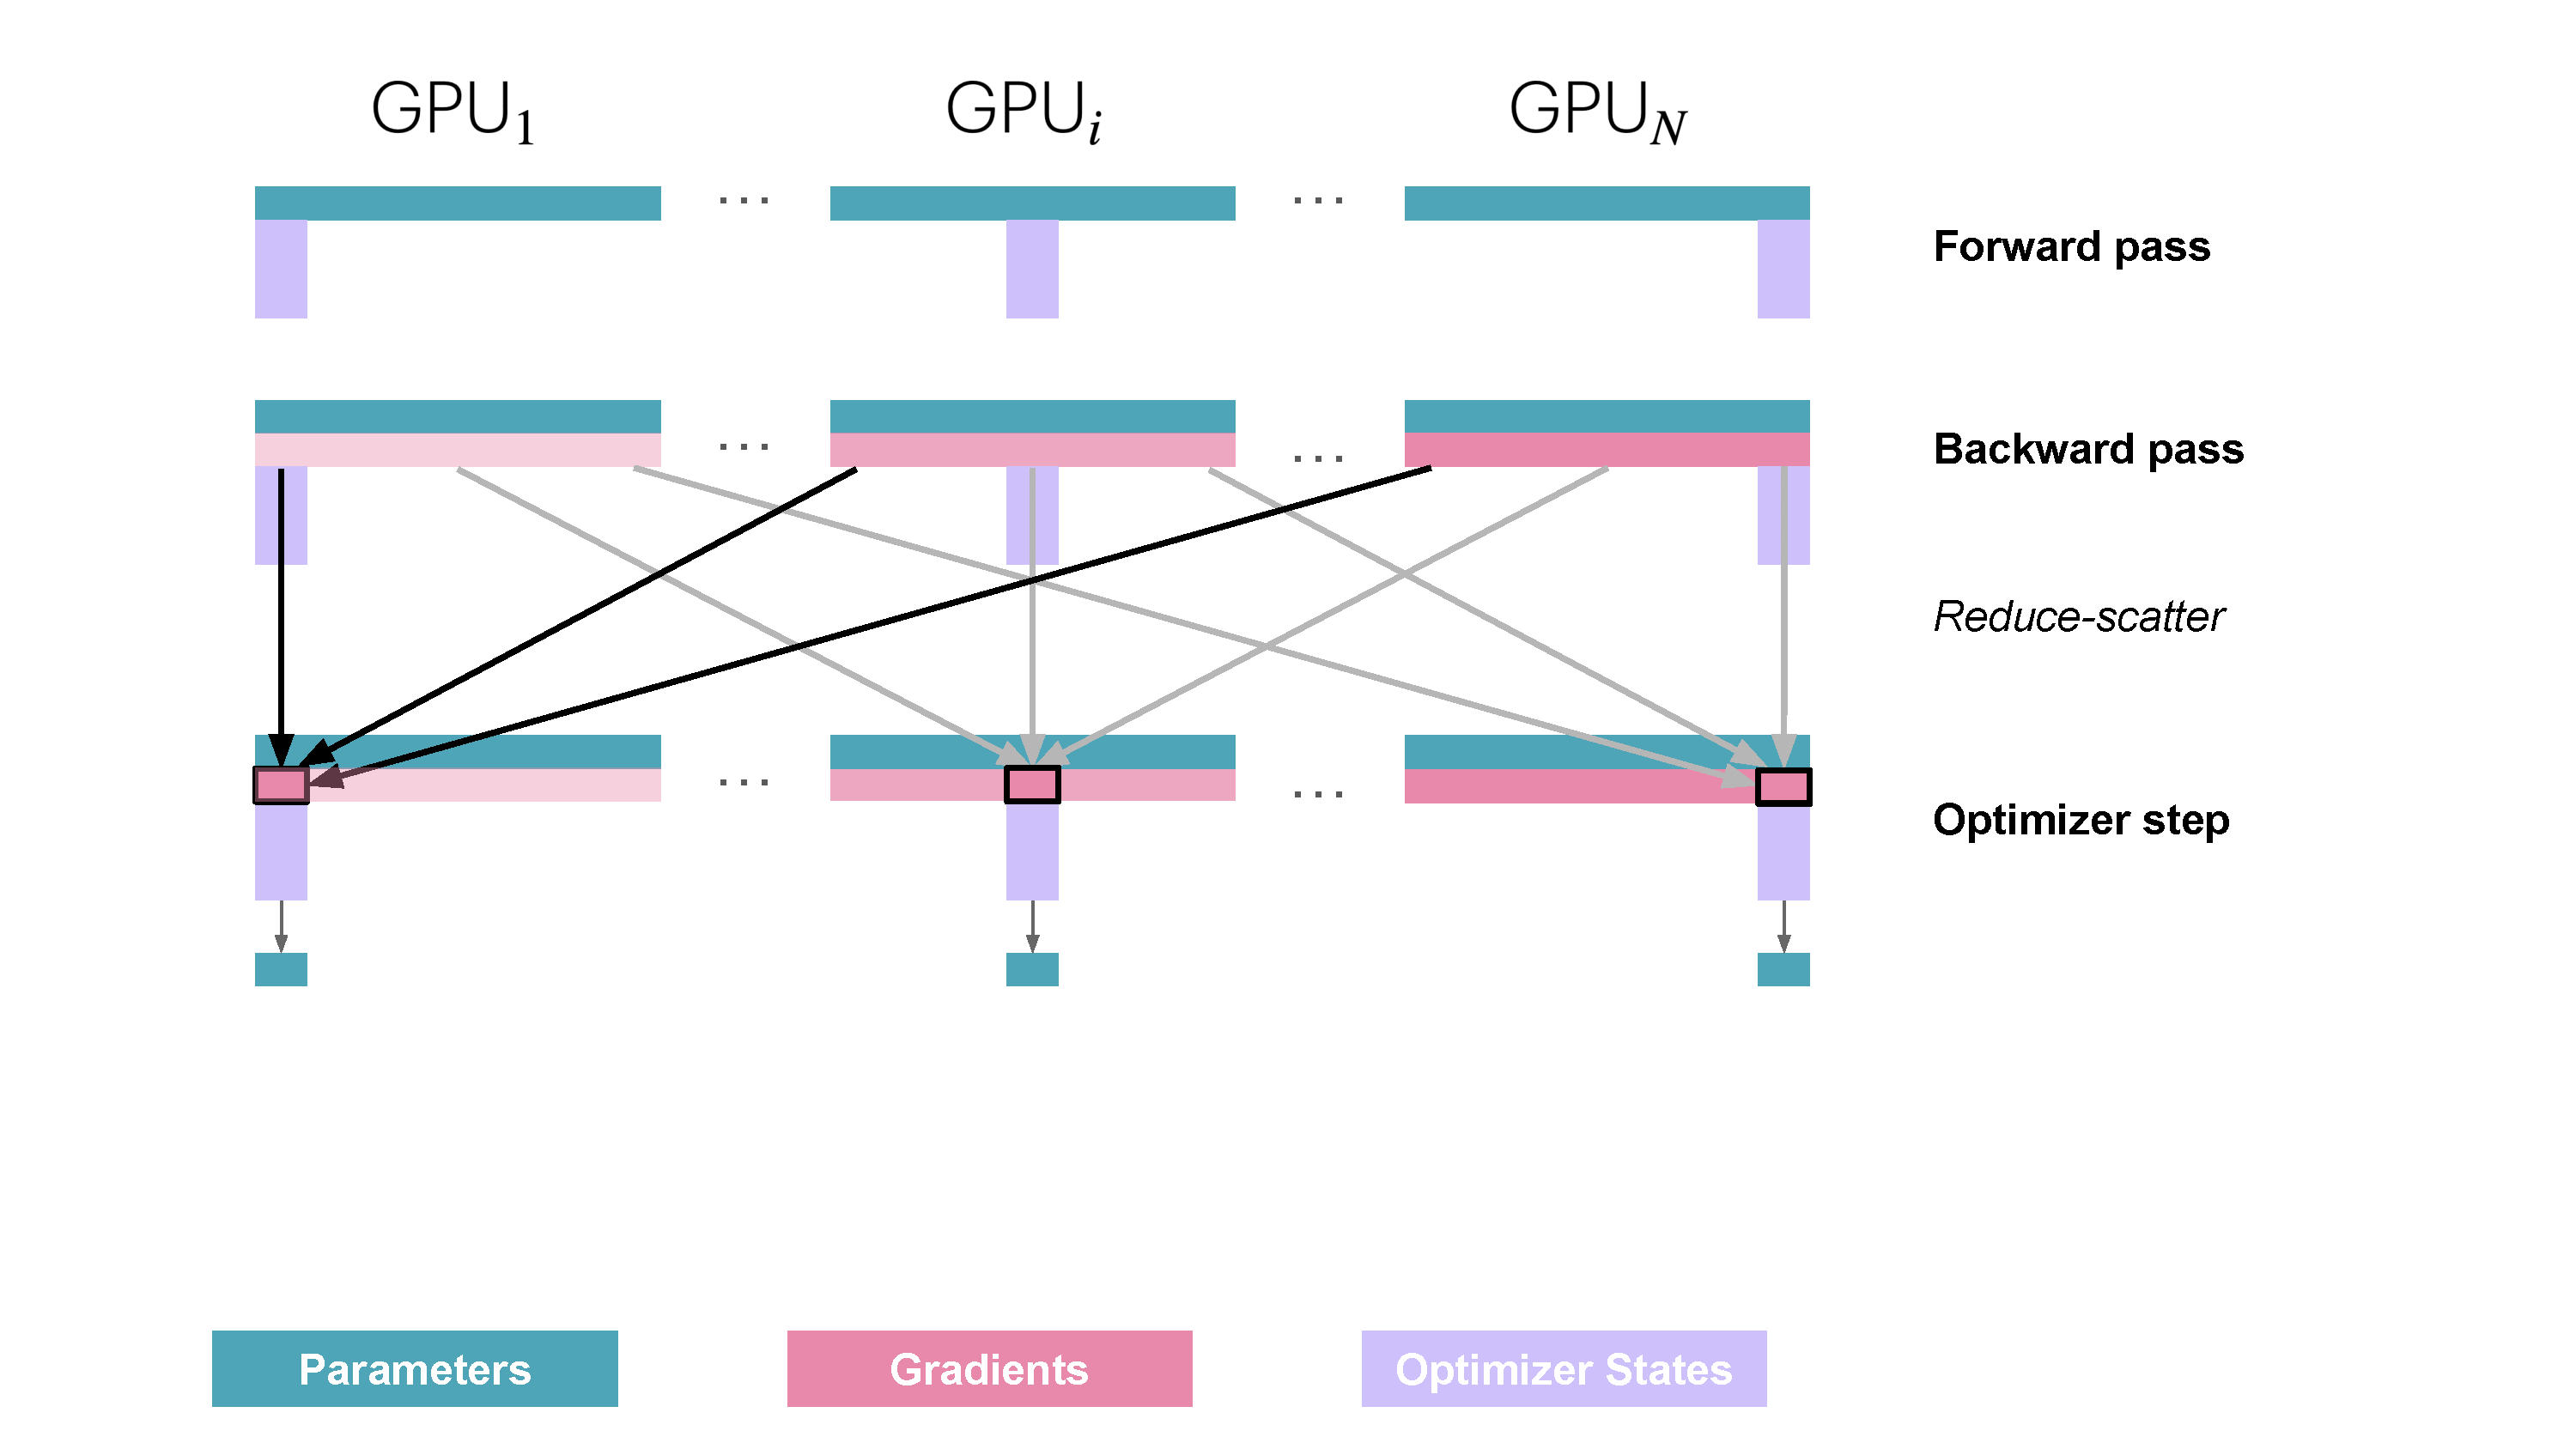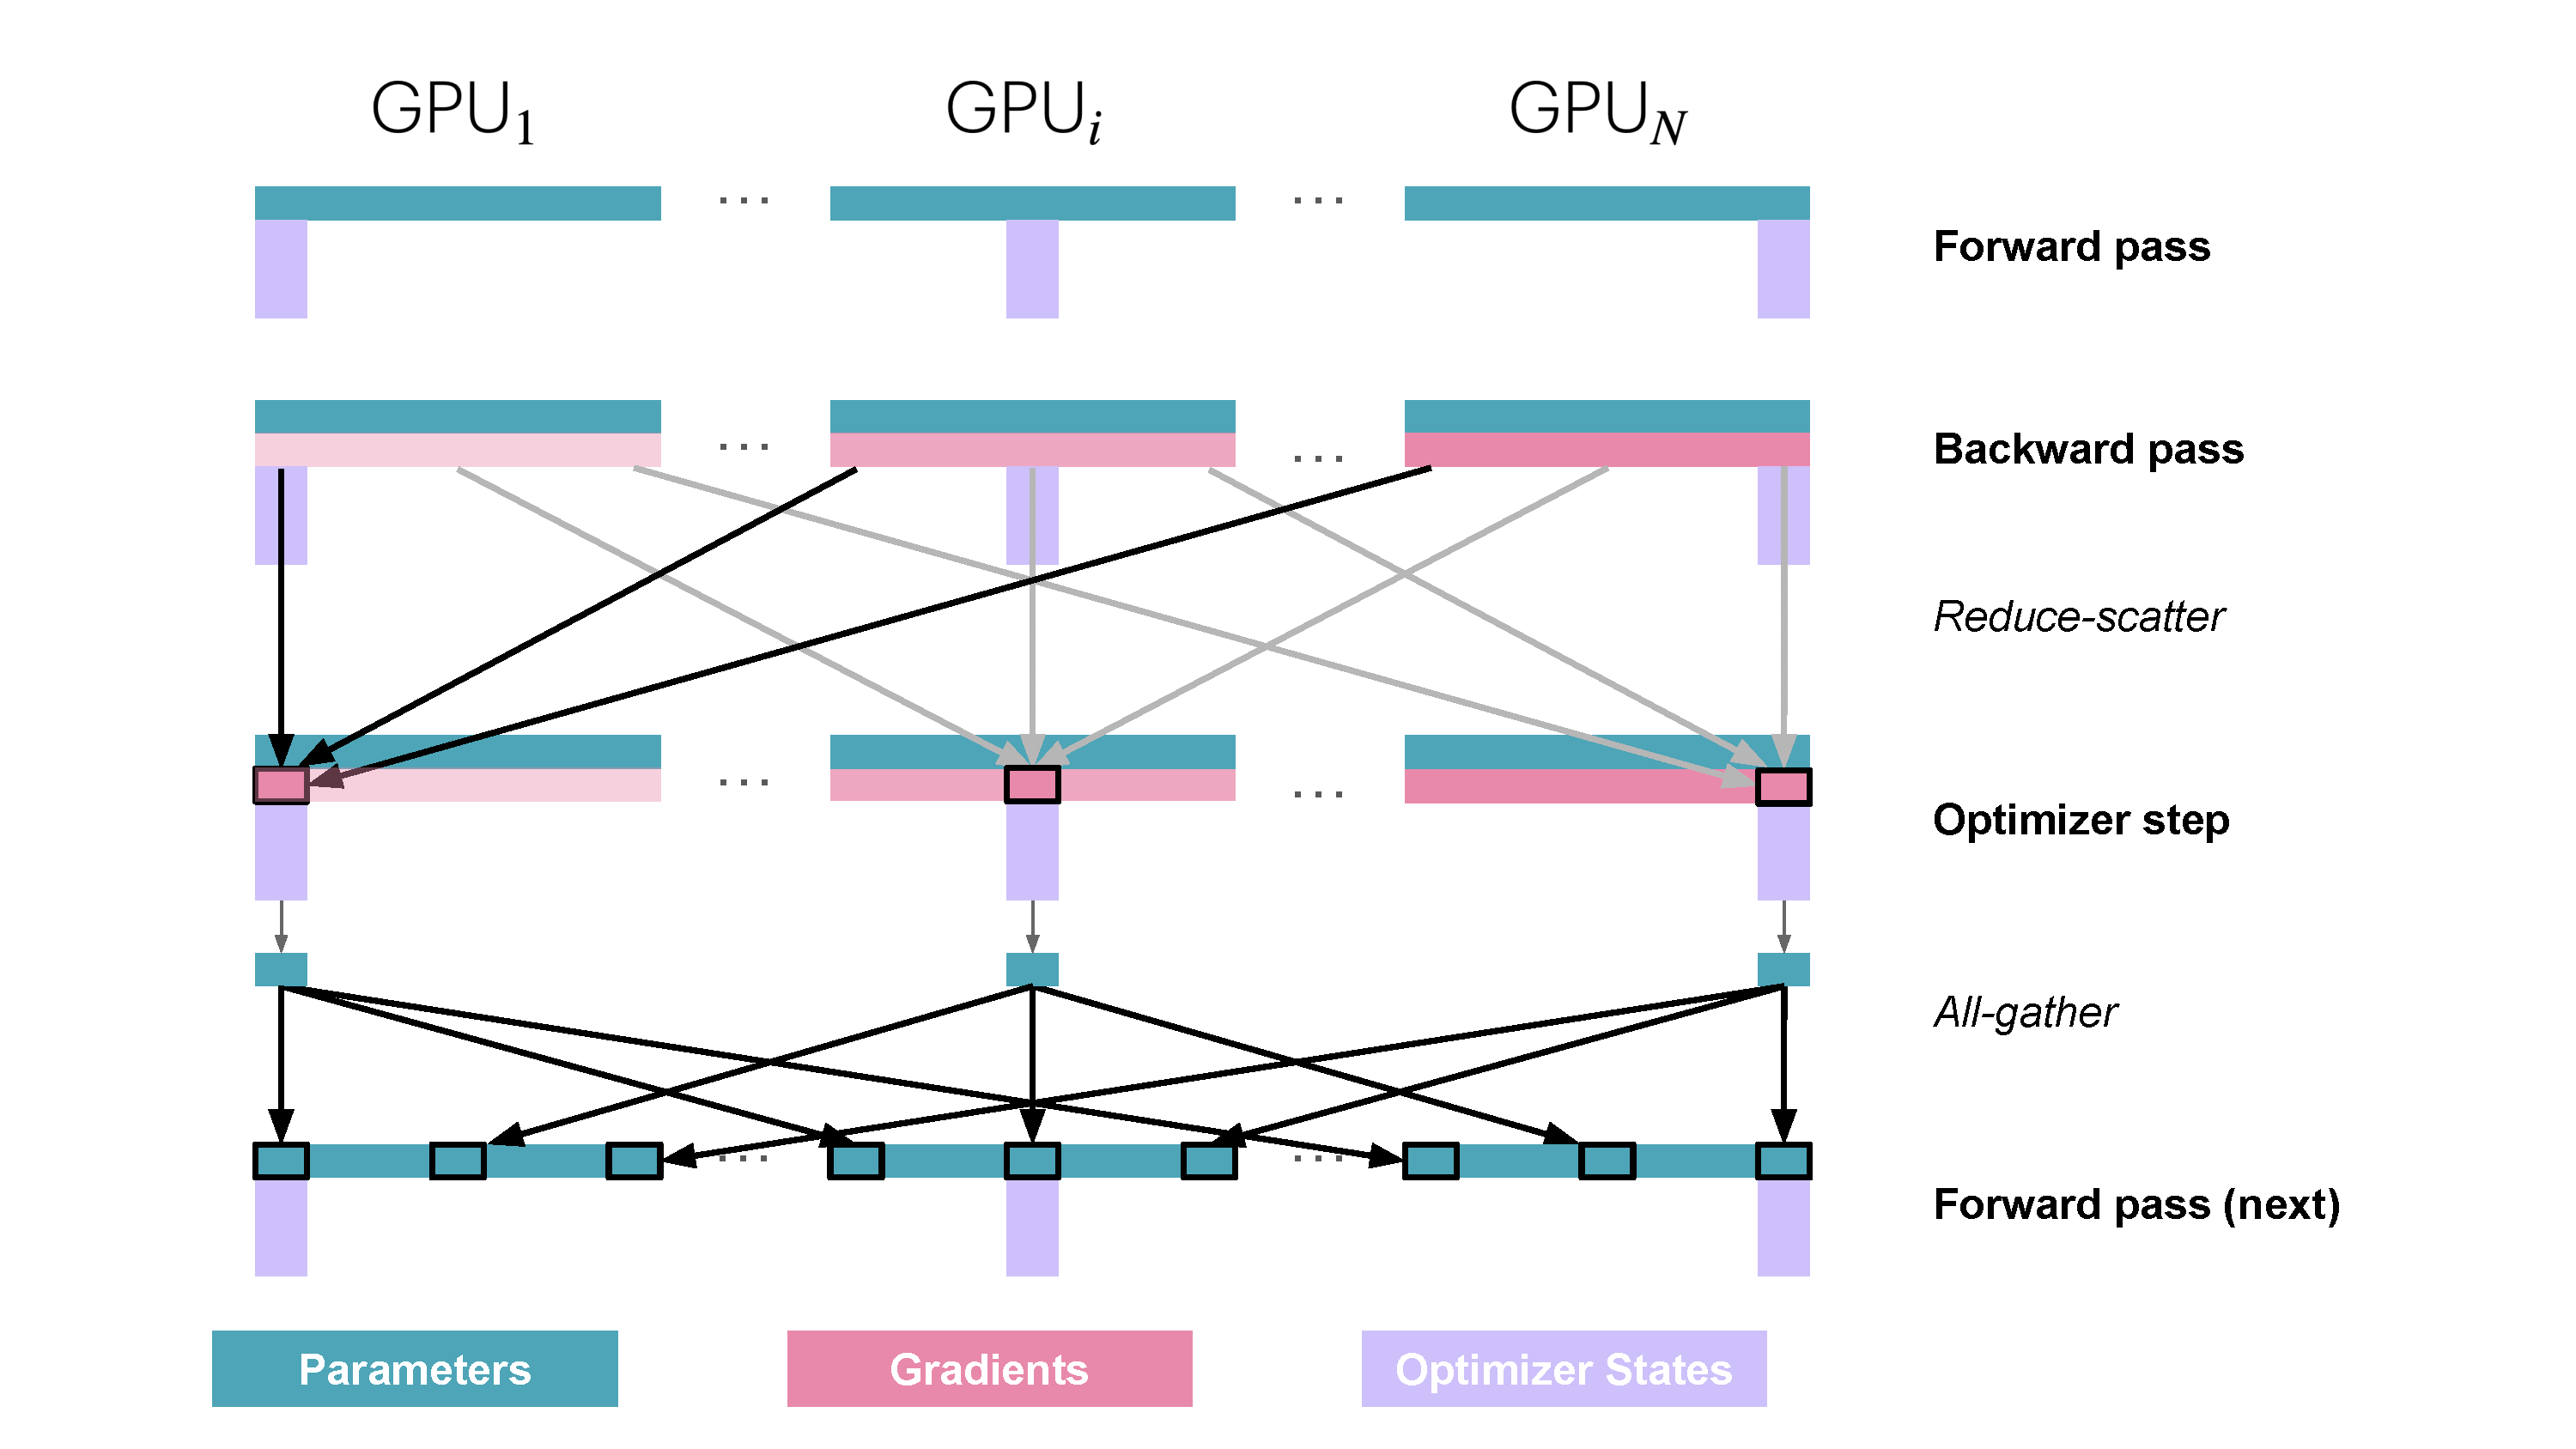
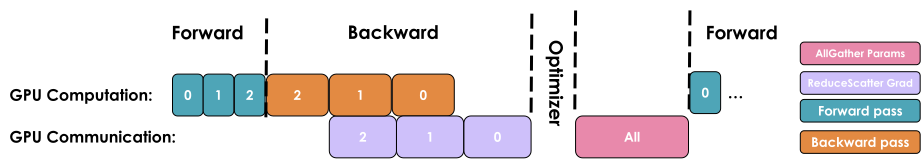
실제 통신 측면에서 보면, ZeRO-1은 기본 DP와 비교해 그래디언트 AllReduce 통신을 ReduceScatter 연산으로 바꾸고, 옵티마이저 스텝 뒤에 모든 파라미터에 대한 AllGather 연산을 더합니다. 모습은 다음과 같습니다.
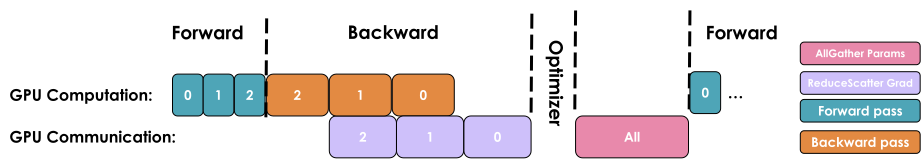
잘 따라오셨다면, 기본 DP를 다룰 때 그래디언트 AllReduce 통신을 역전파 계산과 겹칠 수 있었던 것을 기억하실 겁니다. ZeRO-1에서도 새로 더해진 BF16 파라미터 AllGather를 효율적으로 겹치는 방법을 찾아볼 수 있습니다. 주된 전략은 두 가지입니다.
- 옵티마이저 스텝 동안: 옵티마이저가 파라미터의 첫 조각을 업데이트한 직후 AllGather를 시작할 수 있습니다. 그러면 통신이 나머지 파라미터의 업데이트와 겹칠 수 있습니다.
- 순전파 동안: 각 레이어 파라미터의 AllGather를 순전파와 겹칠 수 있습니다.
📝 참고
아쉽게도 이 기법들은 구현이 간단하지 않고 훅과 버킷 묶기를 정교하게 써야 합니다. 실제로는 PyTorch에 내장된 ZeRO-3/FSDP 구현을 그대로 쓰고
FSDPUnit을 모델 전체로 설정하면 됩니다(자세한 내용은 뒤에서 다룹니다).
ZeRO-1에서는 옵티마이저 상태가 분할되어 있으므로 복제본마다 상태의 만 업데이트합니다. 눈치 빠른 독자라면 최적화 스텝에는 그래디언트의 일부만 필요하니, 모든 DP 랭크가 모든 그래디언트를 가지고 있을 필요가 사실 없다는 점을 알아채셨을 겁니다. ZeRO-2를 만나 볼 차례입니다!
ZeRO-2: 그래디언트 분할 더하기
복제본마다 자기 옵티마이저 상태 샤드에 해당하는 그래디언트 샤드만 있으면 되므로, 옵티마이저 상태처럼 그래디언트도 샤딩하는 것이 자연스럽습니다. 그러면 역전파 때 그래디언트에 AllReduce를 수행하는 대신 ReduceScatter 연산만 수행하면 됩니다! 이때 필요한 의 그래디언트만 메모리에 저장하므로 ZeRO-1보다 메모리를 더 아낍니다.
이제 그래디언트를 샤딩하면 메모리가 가 된다는 것을 쉽게 알 수 있고, 를 늘리면 기준선보다 최대 8배 적은 메모리를 쓸 수 있습니다. 통신 측면에서는 ZeRO-1과 같은 과정이 적용되고, 유일한 차이는 통신하면서 그때그때 메모리를 해제한다는 점입니다. 둘 다 그래디언트에 대한 ReduceScatter와 모든 파라미터에 대한 AllGather가 필요합니다. 따라서 ZeRO-2도 통신 면에서는 기본 DP 학습과 같습니다.
그래디언트까지 샤딩했으니 이제 끝일까요, 아니면 더 개선할 수 있을까요? ZeRO-3가 등장합니다!
ZeRO-3: 파라미터 분할 더하기(FSDP)
3단계에서는 옵티마이저 상태와 그래디언트를 DP 복제본에 걸쳐 샤딩하던 위의 방식을 모델 파라미터 샤딩으로까지 넓힙니다.
📝 참고
이 단계를 PyTorch에 내장해 구현한 것을 FSDP(Fully Sharded Data Parallelism)라고 부릅니다. 이 책에서는 그냥 ZeRO-3라고 부르겠지만, ZeRO-3가 나올 때마다 FSDP를 떠올리셔도 됩니다.
그렇다면 모델 파라미터가 흩어져 있을 때 실제로 순전파나 역전파는 어떻게 할까요? 아주 간단합니다. 필요할 때 그때그때 모으면 됩니다. 순전파에서는 다음과 같습니다.
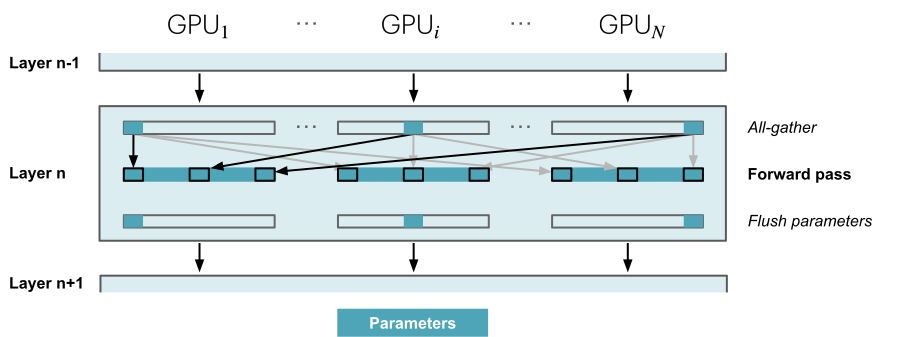
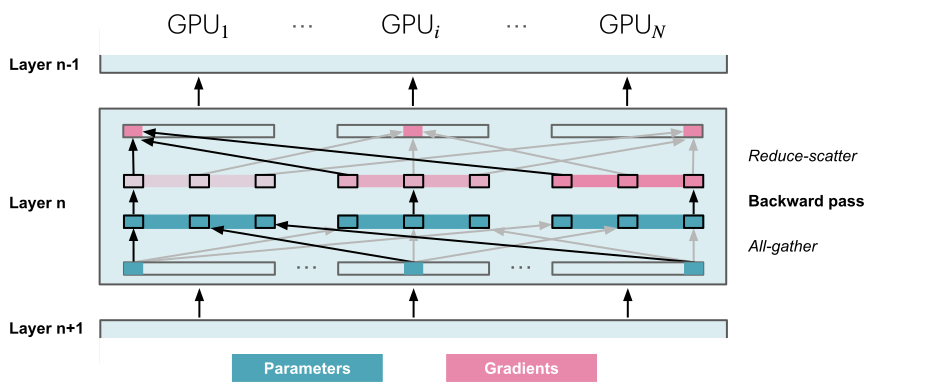
순전파를 수행하며 레이어를 차례로 지나갈 때, 필요한 파라미터를 그때그때 가져오고 더는 필요 없으면 곧바로 메모리에서 비웁니다. 역전파도 흐름만 거꾸로일 뿐 같은 방식으로 동작합니다. 이때 그래디언트 샤드를 만들어 냅니다.
또 다른 문제는 학습 스텝 하나의 순전파와 역전파 내내 이 AllGather를 계속해야 한다는 점입니다. ZeRO-2와 비교하면 학습 스텝마다 AllGather가 번 더 생깁니다. 다음 그림에서 보듯 AllGather마다 작은 기본 지연 시간 오버헤드가 따라옵니다.
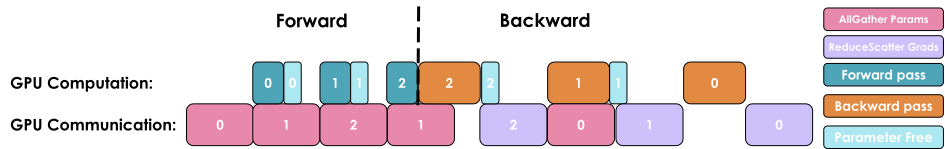
순전파 동안에는 파라미터가 필요할 때마다 AllGather 연산을 하므로 만큼의 통신 부담이 생깁니다. 순전파에서 쓴 파라미터는 곧바로 버리므로 역전파 때도 AllGather가 한 번 더 필요하고, 여기서 또 만큼의 통신 부담이 생깁니다. 마지막으로 그래디언트에는 ZeRO-2와 같은 ReduceScatter 연산이 필요하고, 이것도 통신 비용이 입니다. 그래서 총 통신 비용은 ZeRO-2의 와 비교해 가 됩니다.
통신 오버헤드가 꽤 커 보이지만, 실제로는 별일 아닙니다. 프리페치라는 방법으로 다음 레이어 파라미터의 통신을 현재 레이어의 순전파와 겹칠 수 있기 때문입니다. 프리페치를 쓰면 레이어 n의 순전파를 하는 동안 레이어 n+1의 가중치를 AllGather하고, 마찬가지로 레이어 n의 역전파를 하는 동안 레이어 n-1의 가중치를 AllGather합니다. 물론 이 겹치기는 DP를 너무 크게 늘리지 않을 때만 통합니다(경험상 DP는 512를 넘지 않는 것이 좋습니다).
메모리 측면에서는 식이 이제 최종 형태인 에 이르렀습니다. 즉 DP 크기를 늘릴 수만 있다면, 적어도 모델 관련 파라미터만큼은 이론상 메모리 사용량을 한없이 낮출 수 있습니다. 다만 중간 활성값에는 도움이 되지 않는다는 점에 주의하세요. 활성값에는 앞에서 보았듯이 활성값 체크포인팅과 그래디언트 누적을 쓸 수 있습니다.
지금까지 DP와 ZeRO를 따라온 여정을 정리해 보겠습니다. DP를 쓰면 모델 복제본을 더하는 것만으로 학습을 확장해 학습 처리량을 크게 높일 수 있다는 것을 보았습니다. ZeRO를 쓰면 파라미터, 그래디언트, 옵티마이저 상태를 DP 복제본에 걸쳐 샤딩해, 보통은 GPU 한 개에 들어가지 않는 모델도 작은 통신 비용만 치르고 학습할 수 있습니다.
하지만 여기에는 한계가 있습니다: DP는 모델의 레이어 하나가 GPU 한 개에 들어갈 때만 쓸 수 있고, ZeRO는 파라미터, 그래디언트, 옵티마이저 상태만 분할할 수 있을 뿐 활성값 메모리는 분할하지 못합니다! 활성값 메모리 논의에서 이 부분의 메모리가 시퀀스 길이와 배치 크기에 따라 커진다는 것을 떠올려 보세요. 그 둘을 제한하면 그만이겠지만, 실제로는 하드웨어 때문에 짧은 시퀀스 길이로만 학습해야 하는 상황은 피하고 싶습니다.
이 문제를 넘어서기 위해, 이제 직교하는 새 병렬화 축인 텐서 병렬화를 살펴볼 차례입니다. 파라미터 통신에 크게 기대는 ZeRO-3와 달리, TP는 GPU 사이에 모델 파라미터를 전혀 주고받지 않고도 파라미터, 그래디언트, 옵티마이저 상태, 그리고 활성값까지 여러 장치에 샤딩하자고 제안합니다.
네? 이게 어떻게 가능하죠?! 마법처럼 보이는 이 방식을 함께 살펴봅시다. 🙂
텐서 병렬화
🎧 소리 파일(원문에서 듣기): 읽는 동안 팟캐스트를 듣는 기분을 더하고 싶다면, 이 책의 다음 절들을 두고 이야기하는 NotebookLM 진행자들의 대화를 함께 들어 보세요.
지금까지 ZeRO로 모델의 파라미터, 그래디언트, 옵티마이저 상태를 샤딩했지만, 활성값 메모리가 메모리 예산을 넘어서는 순간 한계에 부딪힙니다. 이제 텐서 병렬화가 나설 차례입니다. 텐서 병렬화는 가중치, 그래디언트, 옵티마이저 상태뿐 아니라 활성값까지 샤딩하며, 그러면서도 계산 전에 이것들을 모두 모을 필요가 없습니다. 꿈같은 이야기죠! 먼저 간단한 행렬 곱셈 연산으로 TP가 어떻게 동작하는지 살펴보겠습니다.
텐서 병렬화는 행렬 곱셈 의 수학적 성질을 활용합니다. 어떻게 동작하는지 이해하기 위해, 이런 병렬화를 가능하게 하는 두 가지 기본 등식을 살펴보겠습니다.
즉 행렬 곱은 의 각 열을 따로 곱하거나, 각 행을 따로 곱한 뒤 결과를 합쳐서 계산할 수 있습니다. 신경망에서는 행렬 곱셈을 주로 꼴로 나타내며, 각 기호의 뜻은 다음과 같습니다.
- 는 입력, 곧 활성값을 나타냅니다.
- 는 Linear 레이어의 가중치를 나타냅니다.
실제로 이 연산을 작은 예로 그려 보면 다음과 같습니다.
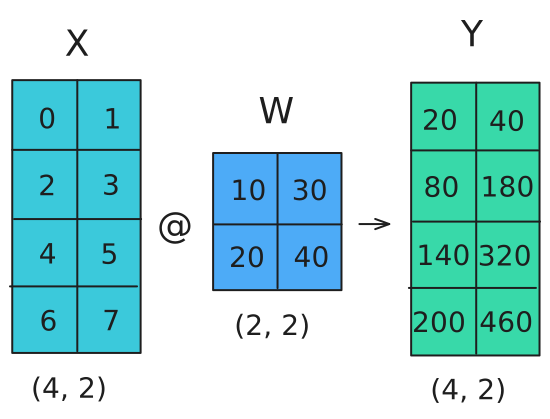
이 연산을 어떻게 병렬화할 수 있는지 봅시다! 텐서 병렬화에서는 텐서를 특정 차원을 따라 개의 샤드로 나누어 개의 GPU에 분산합니다. 행렬은 열 기준으로도, 행 기준으로도 나눌 수 있고, 그에 따라 열 병렬화나 행 병렬화가 됩니다. 이어지는 내용에서 보겠지만, 행 샤딩과 열 샤딩에는 서로 다른 통신 프리미티브가 필요합니다.
첫 번째 방법은 열 방향 샤딩(열 선형 샤딩이라고도 합니다)입니다. 각 워커에 전체 입력 행렬을 복사하고(이때 Broadcast라는 연산이 필요합니다) 가중치 행렬은 열 단위로 나눕니다. 그런 다음 입력을 부분 가중치 행렬과 곱하고, 마지막으로 AllGather 연산으로 결과를 합칩니다.
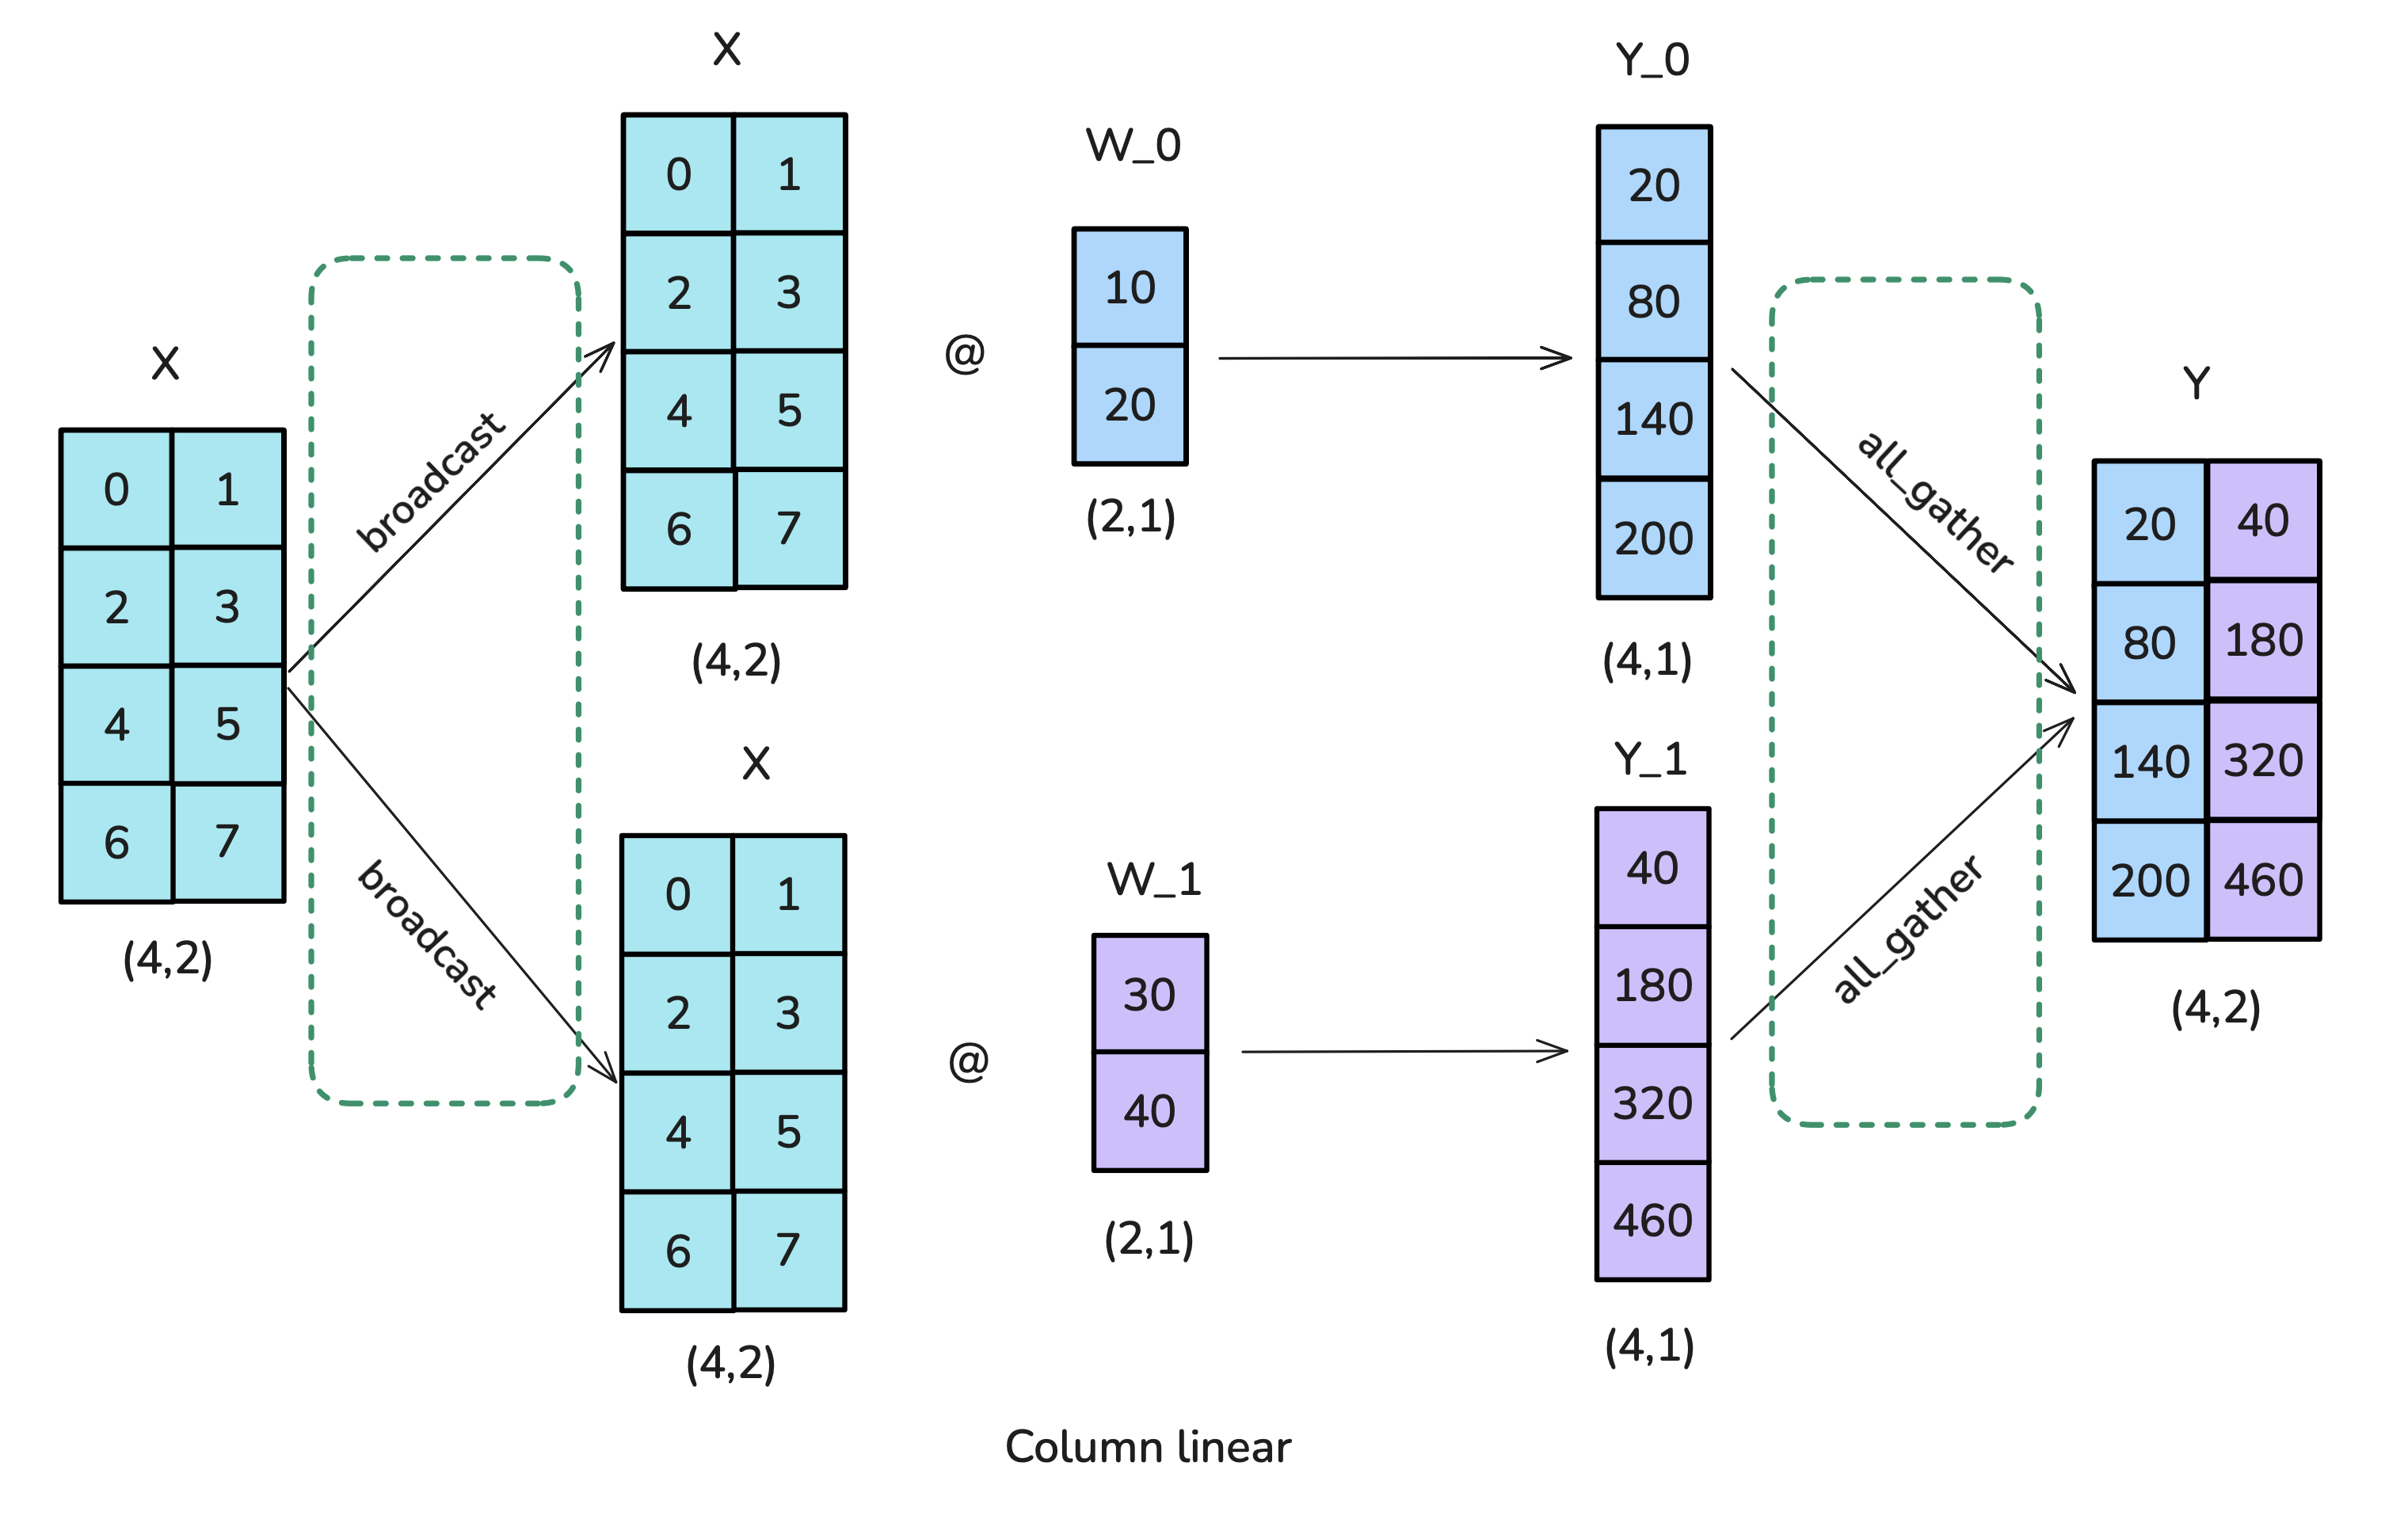
열 방향 텐서 병렬화를 코드로 구현하면 다음과 같습니다.
👉 Picotron의 열 병렬 TP 구현(펼치려면 클릭)
원문 페이지에 삽입된 코드: huggingface/picotron tensor_parallel.py L54-L123
두 번째 방법은 행 방향 샤딩(또는 행 선형 샤딩)입니다. 눈치 빠른 독자라면 짐작하셨겠지만, 행 선형은 가중치 행렬을 행 덩어리로 나눈다는 뜻입니다. 그런데 이렇게 하면 입력도 나눠야 하므로, 열 선형 샤딩에서 쓴 Broadcast 연산 대신 Scatter 연산(우리가 만나는 네 번째 분산 통신 프리미티브입니다!)을 써야 합니다. 각 워커의 결과는 이미 올바른 모양이지만 최종 결과를 얻으려면 모두 더해야 하므로, 이 경우에는 AllReduce 연산도 필요합니다.
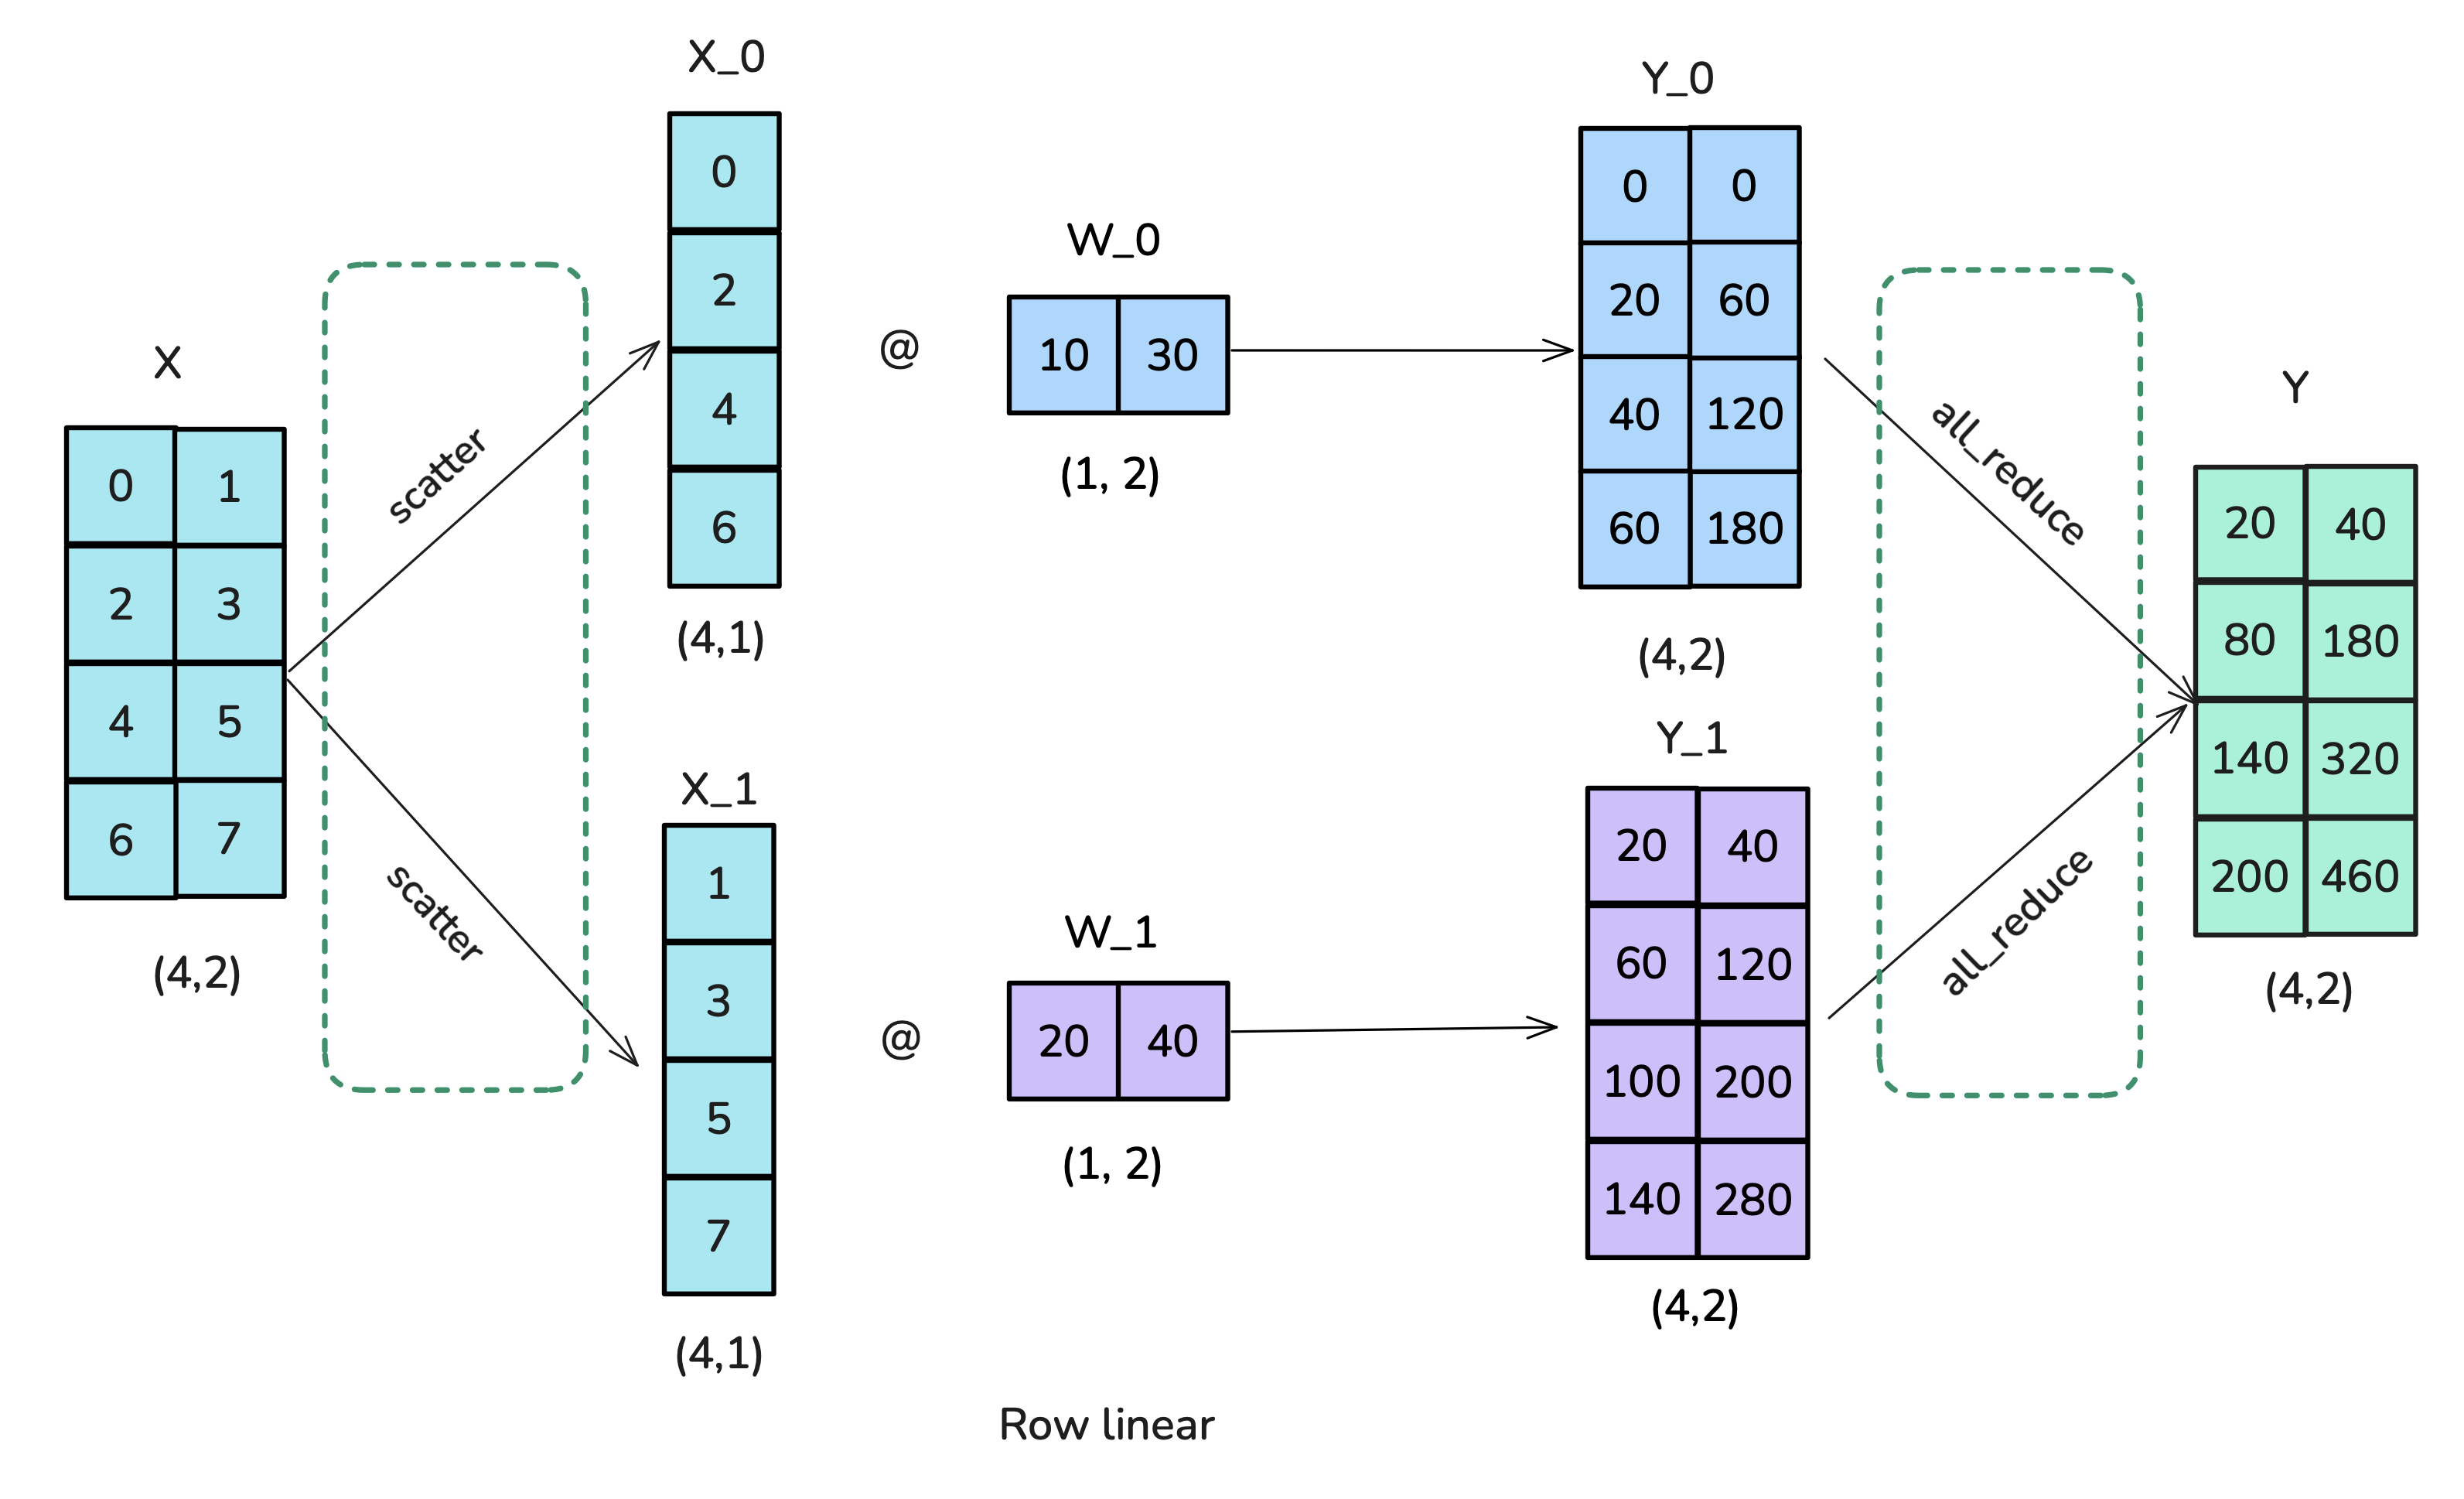
행 방향 텐서 병렬화의 구현은 다음과 같습니다.
👉 Picotron의 행 병렬 TP 구현(펼치려면 클릭)
원문 페이지에 삽입된 코드: huggingface/picotron tensor_parallel.py L125-L189
TP의 기본 구성 요소를 갖췄으니, 이제 이것들을 트랜스포머 레이어 안에서 어떻게 효과적으로 조합할 수 있는지 살펴봅시다!
트랜스포머 블록의 텐서 병렬화
따라갈 전략을 세우기 위해 장난감 예제에서 실제 모델의 구성 블록으로 넘어가 보겠습니다. 트랜스포머 모델은 피드포워드 다층 퍼셉트론 블록과 멀티헤드 어텐션 블록이라는 두 가지 주요 구성 블록으로 이루어집니다. 텐서 병렬화는 두 블록 모두에 적용할 수 있습니다.
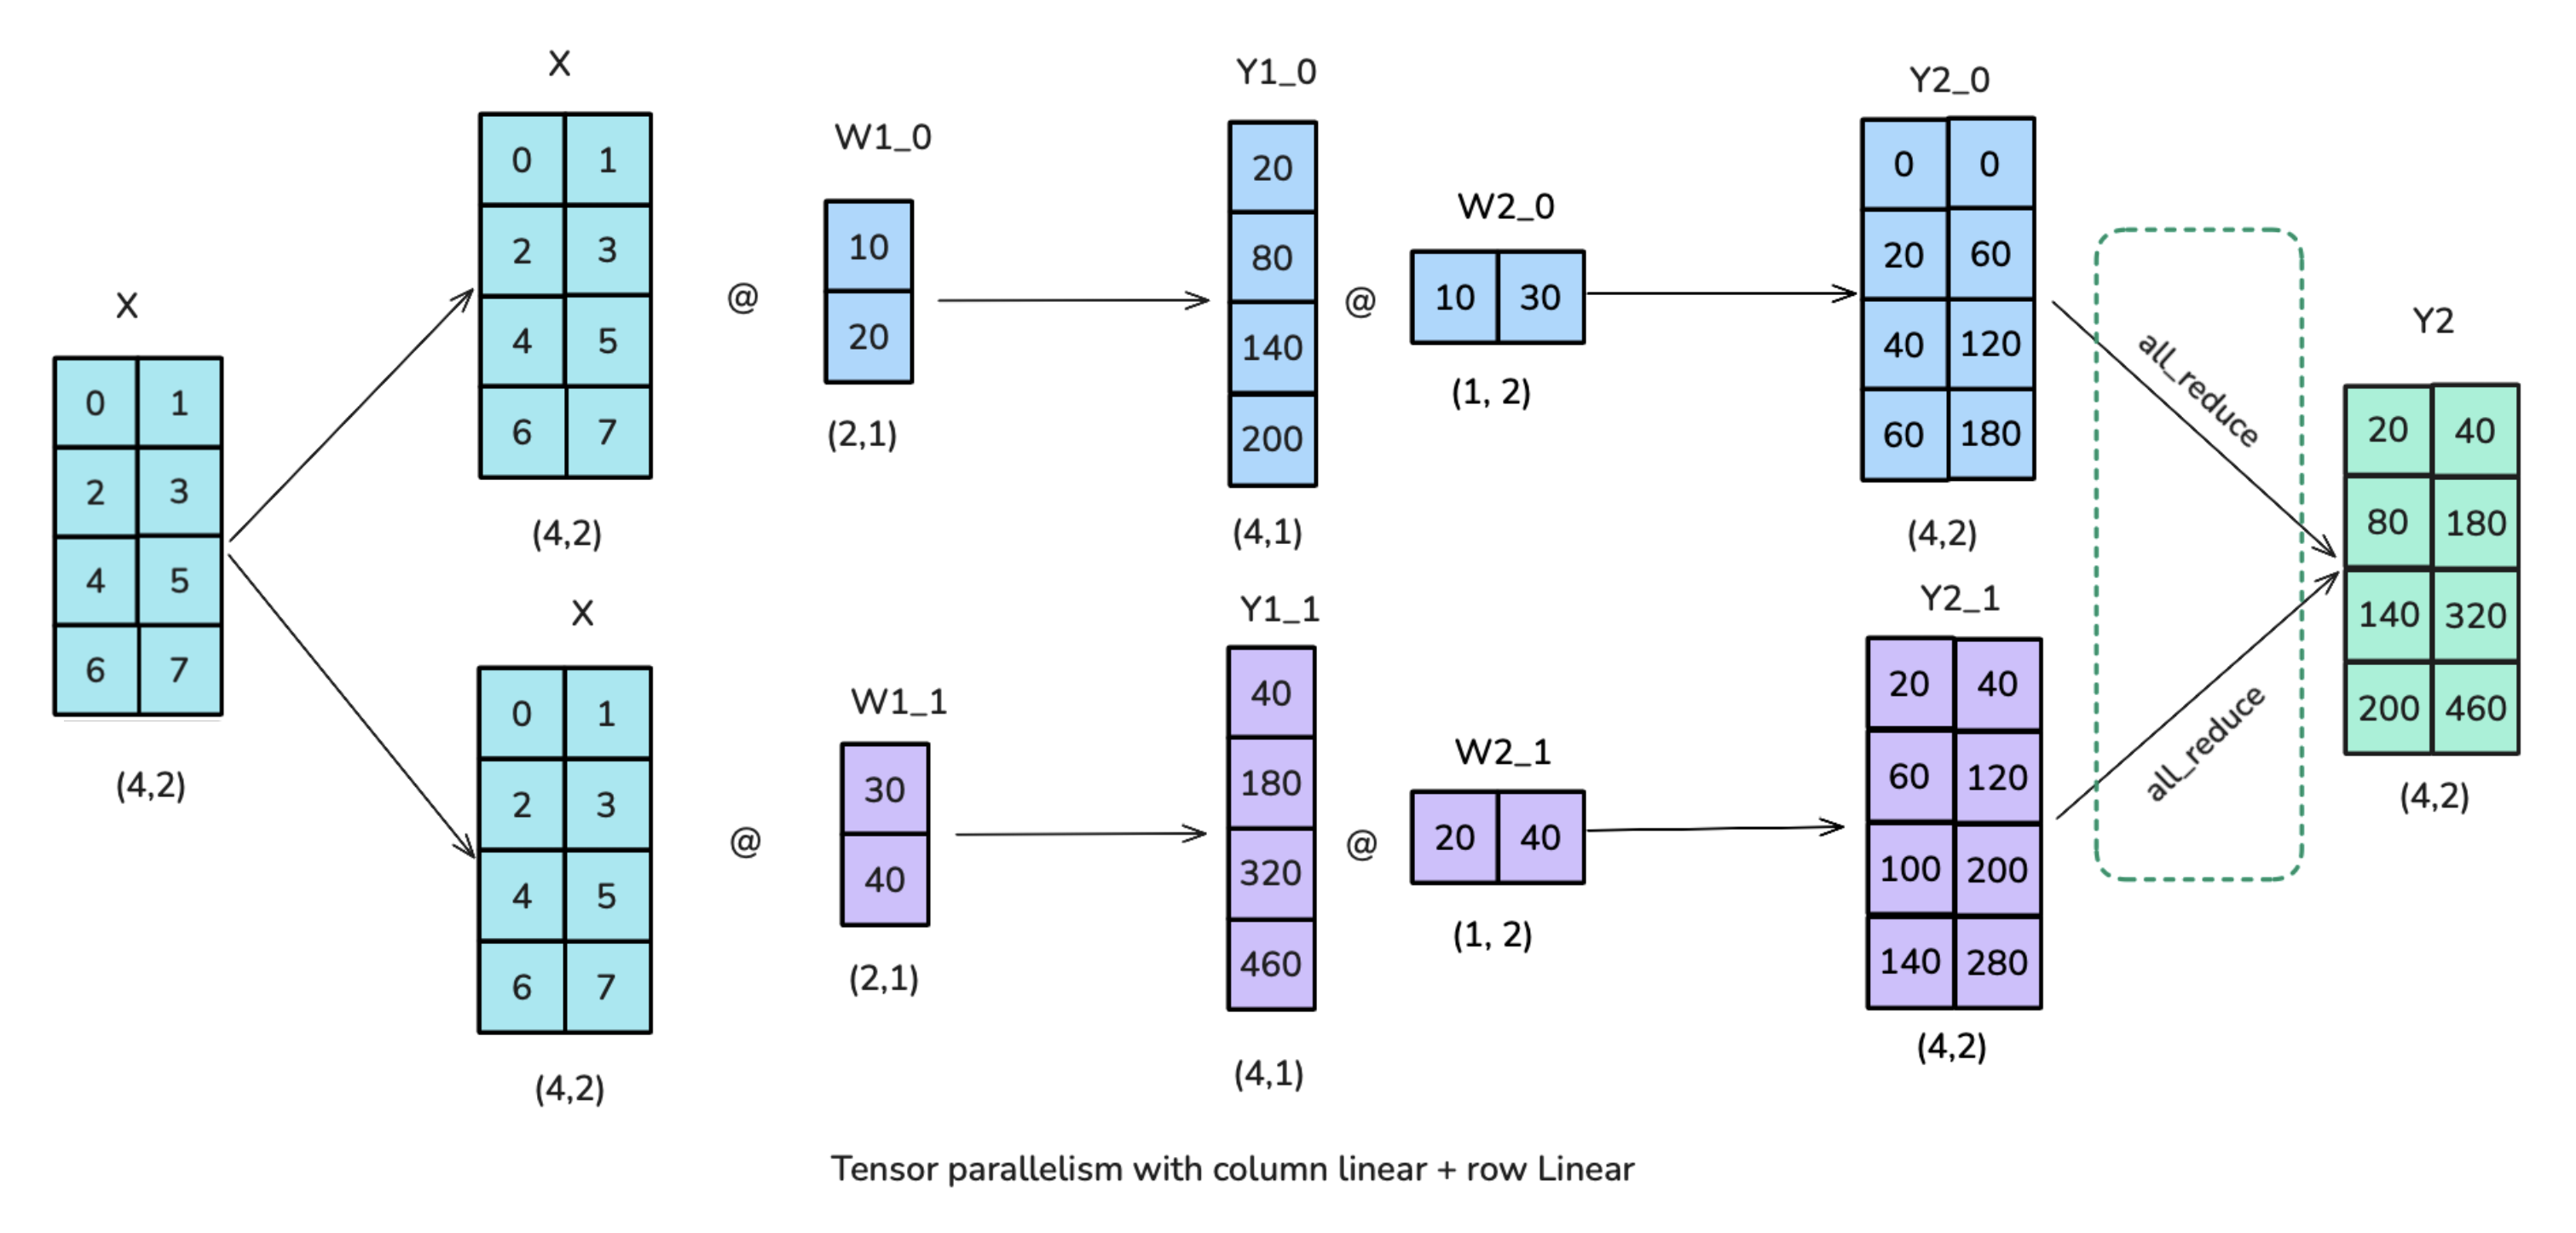
피드포워드 부분은 열 선형 분할 뒤에 행 선형 분할을 두는 방식으로 병렬화할 수 있습니다. 이렇게 하면 순전파에서 입력을 복사하는 Broadcast 한 번과 AllReduce 한 번이 필요합니다. 다만 실제 학습에서는 입력이 TP 랭크 사이에 이미 동기화되어 있게 만들 수 있으므로 Broadcast가 필요 없다는 점도 알아 두세요. 이 구성은 행 선형 분할로 시작해 열 선형 분할을 잇는 방식보다 효율적입니다. 두 분할 연산 사이의 중간 AllReduce를 건너뛸 수 있기 때문입니다.
트랜스포머의 피드포워드 부분에 쓸 효율적인 구성을 찾았으니, 이제 멀티헤드 어텐션 블록을 살펴보겠습니다.
여기서도 대체로 비슷한 방식을 따를 수 있습니다. 쿼리(Q), 키(K), 값(V) 행렬은 열 병렬 방식으로 나누고, 출력 프로젝션은 행 선형으로 볼 수 있습니다. 멀티헤드 어텐션에서는 열 병렬 방식을 아주 자연스럽게 해석할 수 있습니다. 각 GPU가 어텐션 헤드 하나, 또는 헤드 몇 개를 묶은 부분 집합의 어텐션을 계산하는 것입니다. 키와 값을 여러 쿼리가 공유하는 멀티쿼리 어텐션(multi-query attention, MQA)이나 그룹 쿼리 어텐션(grouped query attention, GQA)에도 같은 방식이 그대로 통합니다.
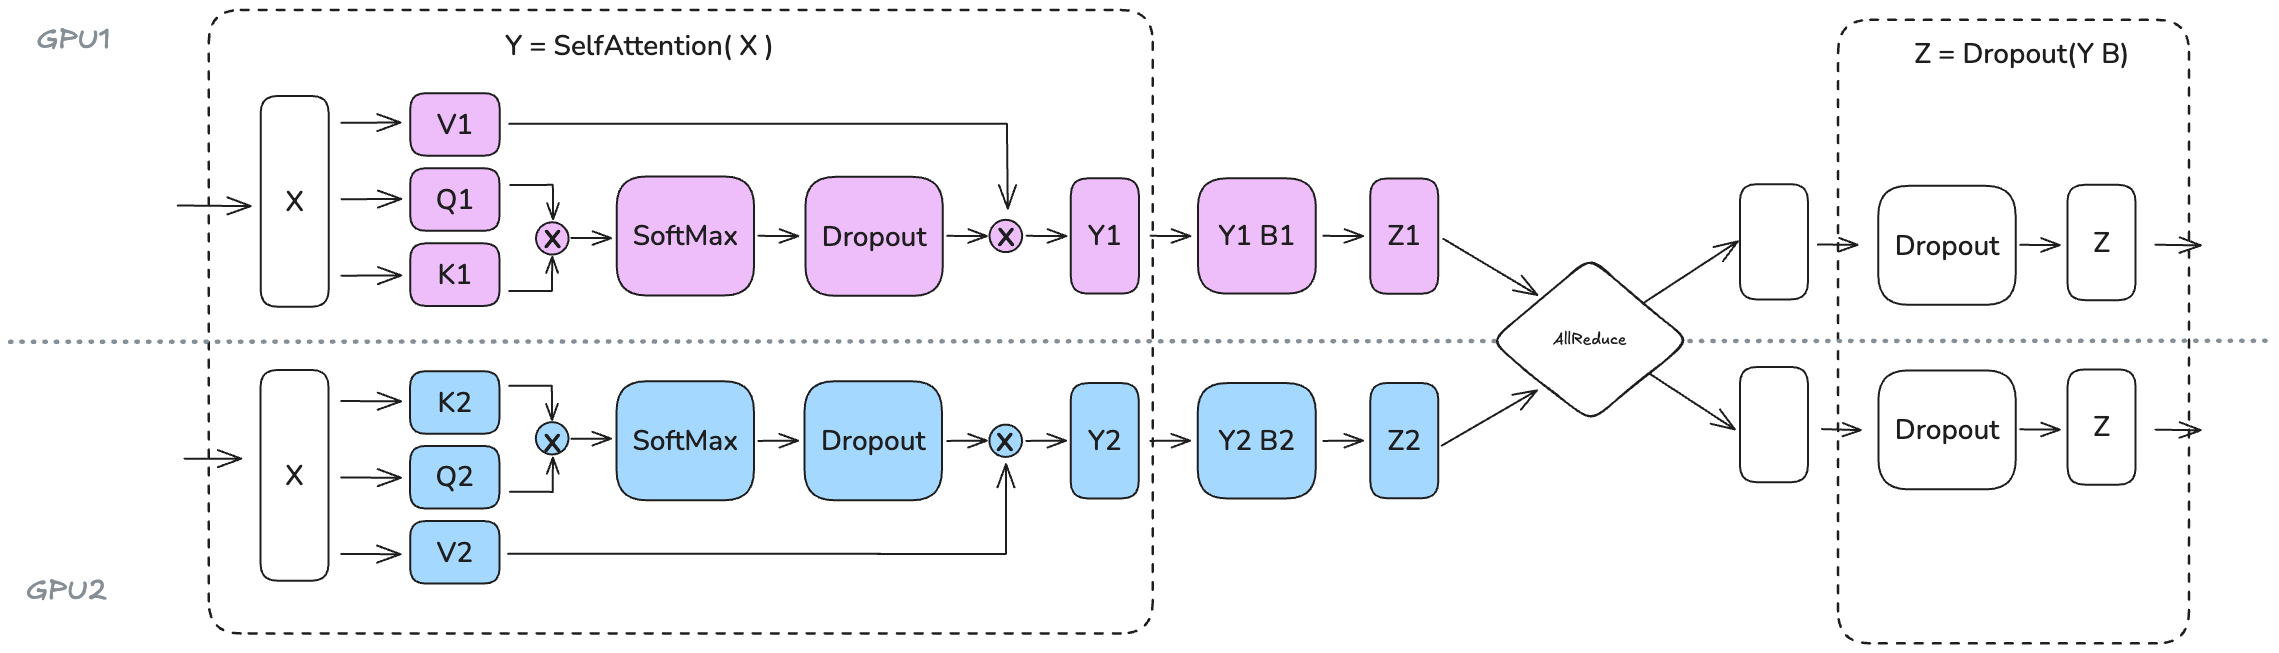
어텐션 블록과 MLP 블록 모두에 텐서 병렬화를 이렇게 효과적으로 적용할 수 있는 것은, 두 블록에 본래부터 서로 독립인 차원이 있기 때문입니다. 어텐션 블록은 각 어텐션 헤드가 독립적으로 동작하므로 num_attention_heads 차원을 따라 병렬화할 수 있습니다. 마찬가지로 MLP 블록은 피드포워드 네트워크 안의 연산이 hidden_dim 차원을 따라 서로 독립이므로 이 차원을 따라 병렬화할 수 있습니다.
다만 QKV 프로젝션을 num_attention_heads 차원을 따라 샤딩하므로, 텐서 병렬화 차수가 어텐션 헤드 수를 넘어서는 안 된다는 점은 짚고 넘어갈 만합니다. 그룹 쿼리 어텐션을 쓰면 쿼리 헤드는 개이지만 키/값 헤드는 개뿐입니다(). 이 경우에도 로 설정할 수는 있지만, K/V 헤드가 GPU 사이에서 제대로 동기화된 상태를 유지하도록 해야 합니다. 예를 들어 Llama-3 8B는 쿼리 헤드가 32개인데 키/값 헤드는 8개뿐입니다. 그래서 이론적으로는 TP 차수를 32까지 올릴 수 있지만, 텐서 병렬 워커 사이에서 K/V 헤드 동기화를 유지하려면 구현을 신중하게 해야 합니다.
또한 텐서 병렬화가 학습의 만능 열쇠는 아니라는 점도 기억해 두세요. 모델의 계산 경로에 분산 통신 프리미티브를 여러 개 직접 넣었기 때문에, (ZeRO에서 했던 것처럼) 이 통신을 계산 뒤에 완전히 숨기거나 계산과 겹치기가 어렵습니다. 따라서 최종 성능은 계산과 메모리에서 얻는 이득과 늘어난 통신 오버헤드 사이의 트레이드오프로 정해집니다. 그림으로 살펴보겠습니다.
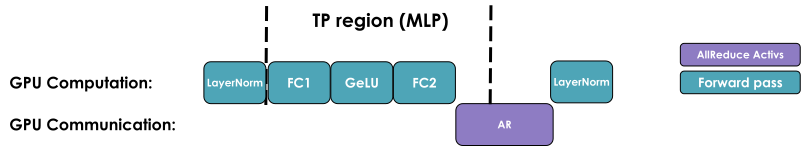
텐서 병렬 MLP의 연산 타임라인을 보면(MHA도 마찬가지입니다) 여기에 얽힌 트레이드오프를 더 잘 이해할 수 있습니다. 각 디코더 레이어의 순전파에서는 계산과 겹칠 수 없는 AllReduce 연산이라는 동기화 지점을 만나게 됩니다. 이 드러난 통신 오버헤드(exposed communication overhead)는 마지막 LayerNorm을 적용하기 전에 텐서 병렬 랭크들의 부분 결과를 합치려면 꼭 필요합니다.
텐서 병렬화는 중간 활성값을 여러 GPU에 샤딩하므로 행렬 곱셈의 활성값 메모리를 줄이는 데 분명 도움이 됩니다. 하지만 LayerNorm 같은 연산에는 여전히 전체 활성값을 모아야 하므로, 얻을 수 있는 메모리 이득을 다 얻지는 못합니다. 게다가 TP는 상당한 통신을 요구하고, 그 부담은 네트워크 인프라에 크게 좌우됩니다. 이 AllReduce는 계산 뒤에 완전히 숨길 수 없으므로, 그 시간이 순전파의 임계 경로에 그대로 더해집니다. 여기서 임계 경로란 순전파를 마치는 데 필요한 최소 시간을 결정하는 연산들의 순서를 말합니다.
TP 차수를 늘려 가며 이 트레이드오프를 더 자세히 살펴봅시다.
TP를 늘리면 GPU당 처리량은 줄어들지만(왼쪽) 더 큰 배치 크기를 처리할 수 있게 됩니다(오른쪽). 이는 분산 학습에서 계산 효율과 쓸 수 있는 메모리 사이의 트레이드오프를 잘 보여 줍니다.
실제로 위 왼쪽 그래프에서 보듯, 텐서 병렬화의 통신 오버헤드는 GPU 8개를 넘어서면서 특히 두드러집니다. 단일 노드 안의 텐서 병렬화는 빠른 NVLink 인터커넥트를 활용할 수 있지만, 노드를 넘나들면 더 느린 네트워크 연결을 거쳐야 합니다. TP=8에서 TP=16으로 갈 때 성능이 크게 떨어지고, TP=16에서 TP=32로 갈 때는 더 가파르게 떨어집니다. 병렬화 차수가 높아지면 통신 오버헤드가 너무 커져서 금세 계산 시간을 압도합니다.
그렇다 해도 텐서 병렬화는 모델 파라미터, 그래디언트, 옵티마이저 상태, 그리고 (어느 정도까지는) 활성값을 여러 GPU에 분산하므로 메모리 사용 면에서 중요한 이점이 있습니다. 70B 파라미터 모델에서 이 효과를 살펴봅시다.
텐서 병렬화 차수를 높이면 GPU마다 모델 파라미터, 그래디언트, 옵티마이저 상태에 드는 메모리가 줄어들어, GPU 8개짜리 단일 노드에도 더 큰 모델을 올릴 수 있게 됩니다.
이 기법에서 더 많은 이득을 끌어낼 방법은 없을까요? 레이어 정규화와 드롭아웃은 여전히 GPU마다 전체 활성값을 모아야 해서, 아낀 메모리를 일부 깎아 먹습니다. 남은 이 연산들까지 병렬화할 방법을 찾으면 더 잘할 수 있습니다.
📝 참고
텐서 병렬 학습에서 레이어 정규화와 관련해 흥미로운 점이 하나 있습니다. AllGather 뒤에는 모든 TP 랭크가 같은 활성값을 보므로, 역전파 뒤에 LayerNorm 가중치의 그래디언트를 동기화하려고 AllReduce를 할 필요가 없습니다. 랭크 사이에서 저절로 동기화된 상태가 유지되기 때문입니다. 반면 드롭아웃 연산은 결정적인 동작을 유지하려면 TP 랭크 사이에 난수 시드를 반드시 동기화해야 합니다.
다음으로, 바로 이 일을 해 주는 텐서 병렬화의 작고 자연스러운 확장인 시퀀스 병렬화를 알아보겠습니다.
시퀀스 병렬화
시퀀스 병렬화는 드롭아웃이나 LayerNorm처럼 텐서 병렬화가 다루지 않는 모델 부분의 활성값과 계산을 나누는 방법입니다. 다만 은닉 차원이 아니라 입력 시퀀스 차원을 따라 나눕니다.
📝 참고
시퀀스 병렬화라는 용어는 여러 뜻으로 쓰이는 편입니다. 이 절에서 다루는 시퀀스 병렬화는 텐서 병렬화와 밀접하게 묶여 있으며 드롭아웃과 레이어 정규화 연산에 적용됩니다. 하지만 시퀀스가 더 길어지면 어텐션 계산이 병목이 되고, 그러면 링 어텐션 같은 기법이 필요해집니다. 이런 기법도 시퀀스 병렬화 방식이라고 불리곤 하지만, 이 책에서는 두 방식을 구분하기 위해 컨텍스트 병렬화라고 부릅니다. 그러니 이 책에서 “시퀀스 병렬화”라는 말이 나오면, 텐서 병렬화와 함께 쓰는 방식이라는 점을 기억해 주세요(독립적으로 쓸 수 있는 컨텍스트 병렬화와 대비됩니다).
이런 방법이 필요한 까닭은 이 연산들이 올바르게 계산하려면 은닉 차원 전체에 접근해야 하기 때문입니다. 예를 들어 LayerNorm은 평균과 분산을 계산하려면 은닉 차원 전체가 필요합니다.
여기서 와 는 은닉 차원 에 걸쳐 계산합니다.
그래서 이 연산들은 계산 비용은 적어도 활성값 메모리는 상당히 많이 필요합니다. 시퀀스 병렬화는 은닉 차원 대신 시퀀스 차원을 따라 나누어 이 메모리 부담을 여러 GPU에 샤딩합니다.
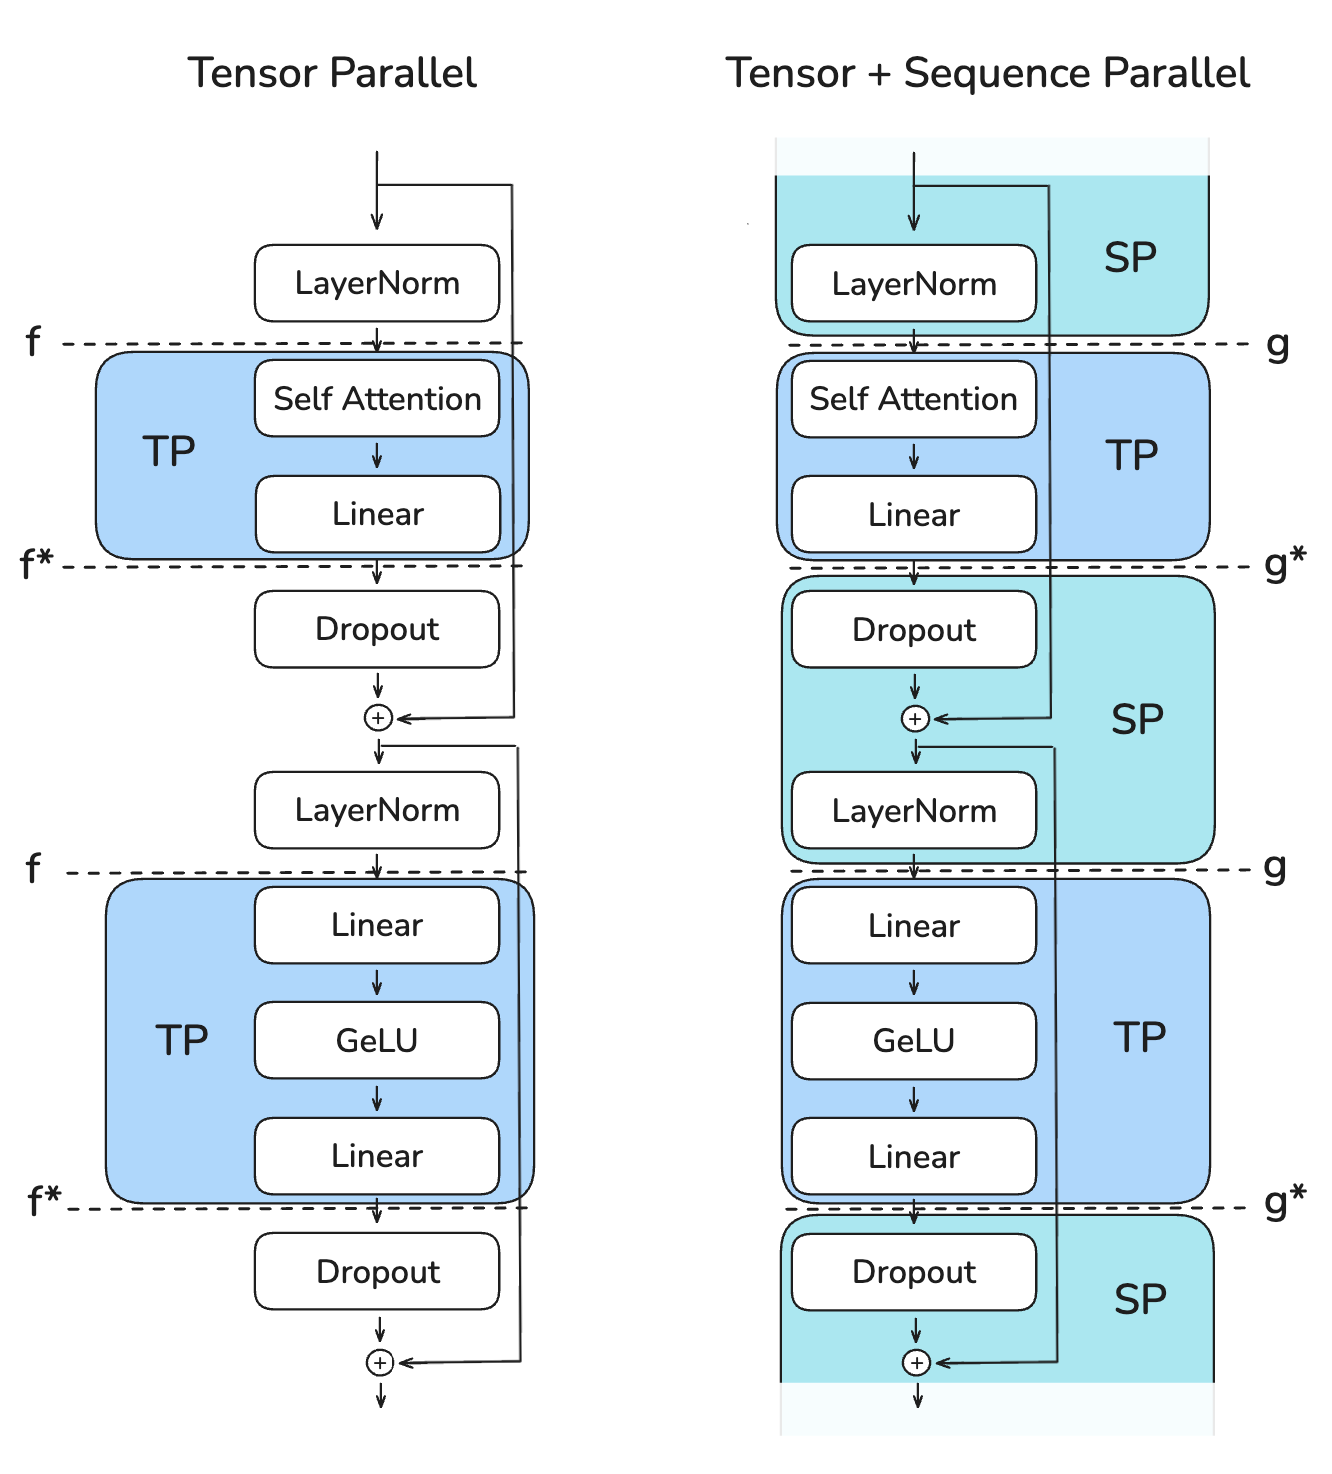
다음 도식은 서로 다른 집합 연산(f와 g로 표시)을 써서 텐서 병렬 영역과 시퀀스 병렬 영역 사이를 어떻게 오가는지 보여 줍니다. 실제로는 왼쪽에서 오른쪽으로 진행합니다.
핵심 과제는 메모리 사용량을 낮게 유지하고 정확성을 지키면서 이 전환을 효율적으로 관리하는 것입니다.
텐서 병렬화의 순전파에서는 다음과 같습니다.
- f는 활성값이 이미 랭크마다 복제되어 있으므로 no-op(아무 연산도 하지 않음)입니다.
- f*는 활성값을 동기화해 정확성을 보장하는 AllReduce입니다.
역전파 때는 다음과 같습니다.
- f*는 그래디언트가 이미 랭크마다 복제되어 있으므로 no-op입니다.
- f는 그래디언트를 동기화하는 AllReduce입니다.
이 f와 f* 연산은 서로를 보완하기 때문에 켤레 쌍이라고 부릅니다. 각 패스에서 하나가 no-op이면 다른 하나는 AllReduce이고, 반대쪽 패스에서는 그 반대가 됩니다.
시퀀스 병렬화에서는 g와 g*로 표시한 다른 연산을 씁니다. 구체적으로 말하면, SP 영역에서는 AllReduce를 쓰지 않습니다. AllReduce를 쓰면 전체 활성값을 모아야 해서 최대 메모리 사용량이 늘어나고, SP를 쓰는 의미가 없어지기 때문입니다.
그럼 여기서 실제로 무슨 일이 일어나는 걸까요? 어느 유명한 LLM의 말처럼, 한 단계씩 차근차근 살펴봅시다.
첫 LayerNorm 레이어(SP 영역)
- 입력 텐서 X1*, X2* 가 이미 시퀀스 차원을 따라 나뉜 상태로 들어옵니다.
- 각 GPU가 자기 몫의 시퀀스 조각에서 LayerNorm을 독립적으로 계산해 Y1*, Y2*를 얻습니다.
첫 번째 전환(SP → TP)
- g 연산(AllGather)이 Y1과 Y2를 다시 전체 시퀀스 길이로 합칩니다.
- 열 선형 레이어에는 전체 은닉 차원 가 필요하므로 Y 를 복원합니다.
첫 번째 선형 레이어(TP 영역)
- A1과 A2는 열 선형 레이어이므로 Y를 은닉 차원을 따라 나눕니다.
- 각 GPU가 GELU를 독립적으로 적용합니다.
- Z1*, Z2*는 입니다.
두 번째 선형 레이어(TP 영역)
- B1과 B2는 행 선형 레이어이므로 은닉 차원을 복원합니다.
- W1과 W2는 이며 서로 더해야 합니다.
마지막 전환(TP → SP)
- g* 연산(ReduceScatter)이 앞선 행 선형 레이어의 결과가 올바르도록 리듀스하면서, 동시에 시퀀스 차원을 따라 흩어 보냅니다.
- W1*, W2*는 입니다.
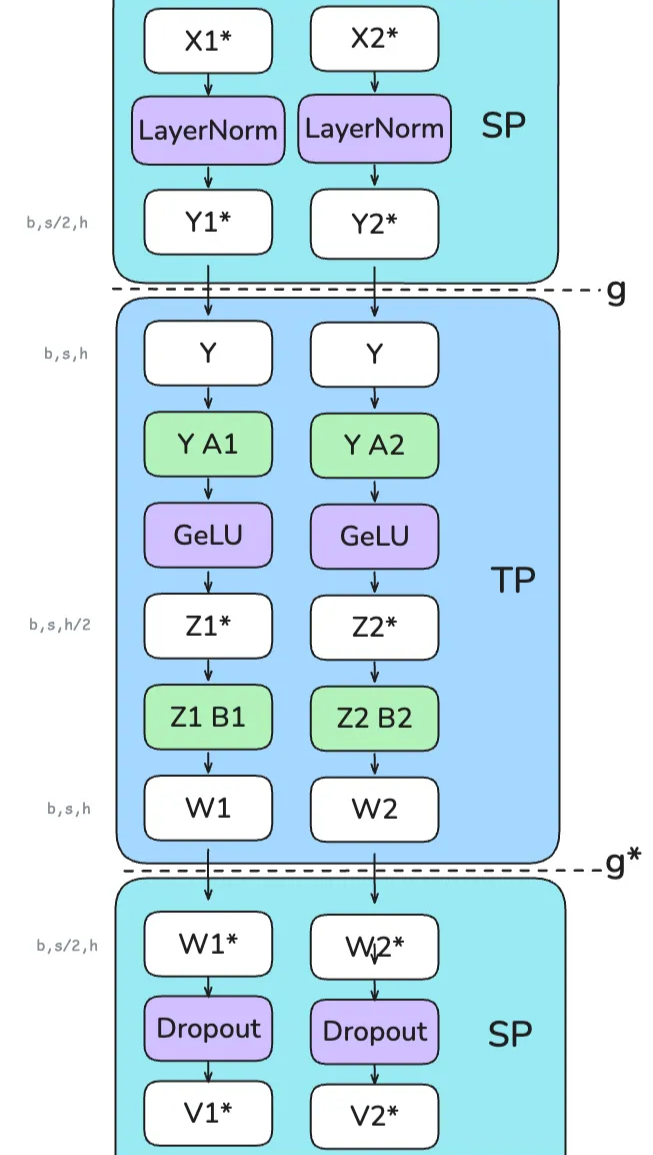
시퀀스 병렬화의 핵심 장점은 저장해야 하는 활성값의 최대 크기를 줄여 준다는 점입니다. 텐서 병렬화만 쓸 때는 여러 지점에서 모양의 활성값을 저장해야 했습니다. 하지만 시퀀스 병렬화를 쓰면 항상 시퀀스 차원이나 은닉 차원 중 하나를 따라 나누므로, 활성값의 최대 크기가 로 줄어듭니다.
TP와 TP+SP에서 저마다 다르게 샤딩되는 부분을 모두 따라가기는 조금 어렵습니다. 정말이지 저희도 머릿속에 정리하기 어려워서, 순전파 동안 활성값(hidden_states라고도 합니다)의 모양이 은닉 차원 와 시퀀스 차원 에서 어떻게 바뀌는지 요약한 작은 표를 만들었습니다.
| 영역 | TP만 사용 | SP와 함께 쓰는 TP |
|---|---|---|
| TP 진입(열 선형) | : 샤딩됨(weight_out이 샤딩됨): 전체 | : 샤딩됨(weight_out이 샤딩됨): AllGather로 전체 복원 |
| TP 영역 | : 샤딩됨 : 전체 | : 샤딩됨 : 전체 |
| TP 종료(행 선형) | : 전체(weight_out이 전체 + 정확성을 위한 AllReduce): 전체 | : 전체(weight_out이 전체 + 정확성을 위한 ReduceScatter): ReduceScatter로 샤딩 |
| SP 영역 | : 전체 : 전체 | : 전체 : 샤딩됨 |
임베딩 레이어는 다음과 같습니다.
| 영역 | 기본 TP | SP와 함께 쓰는 TP |
|---|---|---|
| 임베딩 레이어(행 선형, 어휘 차원으로 샤딩) | : 전체(weight_out이 전체 + 정확성을 위한 AllReduce): 전체 | : 전체(weight_out이 전체 + 정확성을 위한 ReduceScatter): ReduceScatter로 샤딩 |
시퀀스 병렬화를 쓰면 활성값 메모리를 더 많이 아낄 수 있어서, 배치 크기와 시퀀스 길이를 텐서 병렬화만 쓸 때보다 더 키울 수 있습니다. 앞의 70B 모델 예에서 이것이 무엇을 뜻하는지 봅시다.
GPU당 최대 메모리 사용량을 다시 한번 크게 줄여서, TP+SP=16으로 16k 토큰 길이의 시퀀스를 올릴 수 있게 되었습니다. 기본 TP보다 나아졌습니다! (앞 절에서 보았듯 TP=16은 여전히 조금 크지만, 다음 절에서 이를 어떻게 개선할 수 있는지 살펴보겠습니다.)
TP+SP를 쓰면 기본 TP보다 통신 오버헤드가 더 드는지 궁금할 수 있습니다. 답은 ‘그렇기도 하고 아니기도 하다’입니다. 기본 TP의 순전파에서는 트랜스포머 블록마다 AllReduce 연산이 두 번 있었고, SP에서는 트랜스포머 블록마다 AllGather 두 번과 ReduceScatter 두 번이 있습니다. 그러니 SP는 TP보다 통신 연산 횟수가 두 배입니다. 하지만 AllReduce 연산은 AllGather 하나와 ReduceScatter 하나로 쪼갤 수 있으므로(부록의 “Ring AllReduce” 절 참고), 통신 비용으로 따지면 사실 둘은 같습니다. 역전파에도 같은 논리가 적용됩니다. 각 연산의 켤레(no-op ↔ AllReduce, AllGather ↔ ReduceScatter)를 쓰기만 하면 되기 때문입니다.
주의 깊게 읽으셨다면 레이어마다 통신 연산이 네 번(어텐션에 두 번, MLP에 두 번) 있다는 것을 눈치채셨을 겁니다. TP+SP를 쓸 때 MLP를 프로파일링하면 다음과 같습니다.
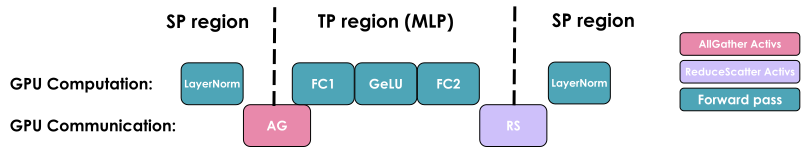
기본 TP와 마찬가지로 TP+SP도 계산과 쉽게 겹칠 수 없어서, 처리량이 통신 대역폭에 크게 좌우됩니다. 이번에도 기본 TP처럼 TP+SP는 보통 노드 안에서만 씁니다(TP 차수를 노드당 GPU 수 이하로 유지합니다. 예: TP≤8).
텐서 병렬화 규모를 키울수록 이 통신 오버헤드가 점점 더 문제가 되는 모습을 벤치마크로 확인할 수 있습니다. 시퀀스 길이가 4,096인 3B 파라미터 모델에서 SP와 함께 TP를 늘려 가며 처리량과 메모리 사용률을 측정해 봅시다.
여기서도 계산 효율(왼쪽)과 메모리 용량(오른쪽) 사이에 트레이드오프가 있습니다. 병렬화 차수를 높이면 활성값 메모리가 줄어 훨씬 큰 배치 크기를 처리할 수 있지만, GPU당 처리량도 줄어듭니다. 특히 노드당 GPU 수에 해당하는 문턱을 넘어서면 더 그렇습니다.
관찰한 내용을 정리해 봅시다.
- 두 방법 모두 TP=8에서 TP=16으로 넘어갈 때 성능이 가장 크게 떨어집니다. 이때 단일 노드 안에서만 통신(NVLink)하던 데서 노드 사이 통신(EFA)으로 바뀌기 때문입니다.
- SP와 함께 TP를 쓰면 활성값 메모리를 아낄 수 있어서, TP만 쓸 때보다 훨씬 큰 배치를 올릴 수 있습니다.
지금까지 TP가 어텐션과 피드포워드 연산을 은닉 차원을 따라 나누어 활성값을 여러 GPU에 샤딩하는 방법과, SP가 나머지 연산을 시퀀스 차원을 따라 나누어 TP를 자연스럽게 보완하는 방법을 살펴보았습니다.
📝 참고
SP 영역의 LayerNorm 레이어는 시퀀스의 서로 다른 부분을 처리하므로, 그래디언트가 TP 랭크마다 달라집니다. 가중치가 동기화된 상태를 유지하도록, DP가 가중치를 맞춰 두는 것과 비슷하게 역전파 중에 이 그래디언트를 AllReduce해야 합니다. 다만 LayerNorm은 파라미터가 비교적 적으므로 통신 오버헤드는 작습니다.
그래도 TP+SP에는 두 가지 한계가 있습니다. 시퀀스 길이를 늘리면 TP 영역에서 활성값 메모리가 여전히 폭증하고, 모델이 너무 커서 TP=8로 담을 수 없으면 노드 사이 연결 때문에 속도가 크게 떨어집니다.
첫 번째 문제는 컨텍스트 병렬화로, 두 번째 문제는 파이프라인 병렬화로 해결할 수 있습니다. 먼저 컨텍스트 병렬화부터 살펴봅시다!
컨텍스트 병렬화
텐서 병렬화와 시퀀스 병렬화를 함께 쓰면 모델 가중치와 활성값이 모두 여러 GPU에 나뉘어 놓이므로, GPU당 필요한 메모리를 크게 줄일 수 있습니다. 하지만 점점 더 긴 시퀀스로 모델을 학습시키면(예를 들어 시퀀스 하나에 128k 토큰 이상으로 늘리면), TP 영역 안에서는 여전히 시퀀스 전체를 처리해야 하므로 노드 하나에 있는 메모리를 넘어설 수 있습니다.
게다가 활성값을 전체 재계산하더라도(계산 오버헤드가 약 30%나 붙습니다), 레이어 경계에 있는 활성값 일부는 여전히 메모리에 들고 있어야 하고, 이 양은 시퀀스 길이에 따라 선형으로 늘어납니다. 컨텍스트 병렬화가 어떻게 도움이 되는지 살펴봅시다:
컨텍스트 병렬화의 핵심 아이디어는 시퀀스 병렬화와 비슷하지만(곧 시퀀스 길이 방향으로 나눕니다), 이 방식을 텐서 병렬화가 이미 적용된 모듈에 씁니다. 그래서 이 모듈들을 두 차원으로 나누게 되고, 덕분에 시퀀스 길이의 영향도 줄어듭니다. 지금까지 다룬 내용을 생각하면 꽤 직관적으로 느껴질 테지만, 요령이 하나 숨어 있으니 졸지 마세요!
컨텍스트 병렬화에서도 시퀀스 병렬화처럼 입력을 시퀀스 차원으로 나눕니다. 하지만 앞서 TP+SP에서 했던 것처럼 모델의 시퀀스 병렬 영역에서만 나누는 것이 아니라, 이제는 모델 전체에 걸쳐 나눕니다.
시퀀스를 나눠도 MLP나 LayerNorm처럼 토큰을 하나씩 독립적으로 처리하는 대부분의 모듈은 영향을 받지 않습니다. 가중치 행렬이 아니라 입력만 나누므로 TP처럼 비싼 통신도 필요 없습니다. 데이터 병렬화와 똑같이, 그래디언트를 계산한 뒤에는 AllReduce 연산을 시작해 CP 그룹 전체의 그래디언트를 동기화합니다.
그런데 중요한 예외가 하나 있습니다: 어텐션 블록에는 각별히 주의(attention)를 기울여야 합니다(하하… 일부러 한 말장난입니다 :D). 어텐션 모듈에서는 각 토큰이 시퀀스의 다른 모든 토큰의 키/값 쌍에 접근해야 합니다(인과 어텐션이라면 적어도 앞선 토큰 하나하나에는 어텐션해야 합니다).
컨텍스트 병렬화는 입력을 시퀀스 차원으로 나눠 여러 GPU에 흩어 놓기 때문에, 어텐션 모듈에서 필요한 키/값 데이터를 주고받으려면 GPU끼리 빠짐없이 통신해야 합니다.
그냥 단순하게 하면 비용이 엄청나게 들 것 같습니다. 더 싸고 빠르게 할 방법은 없을까요? 다행히 이런 키/값 쌍 통신을 효율적으로 처리하게 해 주는 핵심 기법이 있습니다: 링 어텐션.
📝 참고
컨텍스트 병렬화는 이 책 뒤에서 살펴볼 FlashAttention과 개념상 닮은 데가 있습니다. 두 기법 모두 온라인 소프트맥스 계산으로 메모리 사용량을 줄입니다. 하지만 FlashAttention이 GPU 한 대에서 어텐션 계산 자체를 최적화하는 데 집중한다면, 컨텍스트 병렬화는 시퀀스를 여러 GPU에 나눠 메모리를 줄입니다.
링 어텐션
어텐션 메커니즘을 이렇게 구현하면, 각 GPU는 먼저 비동기 통신 연산을 시작해 자기 키/값 쌍을 다른 GPU로 보냅니다. 다른 GPU의 데이터를 기다리는 동안에는 이미 메모리에 있는 부분의 데이터로 어텐션 점수를 계산합니다. 이상적으로는 이 계산이 끝나기 전에 다른 GPU에서 다음 키/값 쌍이 도착하므로, GPU는 첫 계산을 마치자마자 다음 차례의 계산을 바로 시작할 수 있습니다.
예를 들어 보겠습니다. GPU가 네 대 있고 입력이 토큰 네 개라고 합시다. 처음에는 입력 시퀀스를 시퀀스 차원으로 고르게 나누므로, 각 GPU는 토큰 하나와 그에 해당하는 Q/K/V 값만 갖습니다. Q1, K1, V1이 첫 번째 토큰의 쿼리, 키, 값을 나타내고, 이 값들이 첫 번째 GPU에 있다고 해 봅시다. 어텐션 계산은 네 타임스텝에 걸쳐 끝납니다. 타임스텝마다 각 GPU는 다음 세 연산을 차례로 수행합니다:
- 현재 키와 값을 논블로킹 방식으로 다음 머신에 보냅니다(마지막 타임스텝만 빼고). 그래서 이 연산이 끝나기 전에 다음 연산을 시작할 수 있습니다.
- 현재 키와 값으로 어텐션 점수를 로컬에서 계산합니다. 보통 를 계산하는 일입니다.
- 이전 GPU에서 키와 값을 받을 때까지 기다렸다가 1단계로 돌아갑니다. 이제 방금 받은 키/값이 현재 키와 값이 됩니다.
이 세 단계를 네 번 반복하면 어텐션 계산이 끝납니다.
GPU 네 대로 진행하는 전체 과정은 다음 애니메이션과 같습니다:
[그림: 링 어텐션 애니메이션. GPU들이 고리 모양으로 키·값 조각을 차례로 넘기며 어텐션을 계산하는 모습. 원문에 출처 표기가 없습니다. 누가 만들었는지 확인하지 못해 싣지 않았습니다. 원문에서 볼 수 있습니다.]
이 애니메이션을 보면 저자들이 왜 이 방식에 링 어텐션7이라는 이름을 붙였는지 바로 알 수 있을 겁니다!
그런데 큰 문제가 하나 있습니다. 링 어텐션을 단순하게 구현하면 인과 어텐션 행렬의 모양 때문에 GPU 사이에 심한 불균형이 생깁니다. 인과 어텐션 마스크를 씌운 어텐션 점수 행렬을 놓고 소프트맥스 계산을 살펴봅시다:
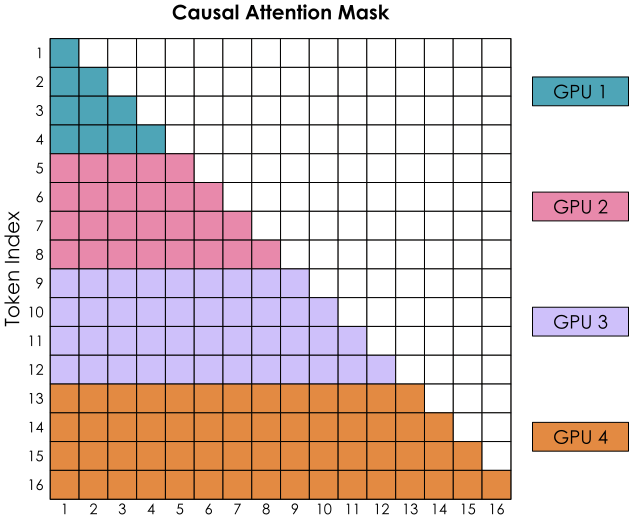
소프트맥스는 행 단위로 계산하므로, GPU가 한 행의 토큰을 모두 받으면 그때 계산할 수 있습니다. GPU 1은 토큰 1-4로 시작하고 다른 GPU에서 아무 정보도 받을 필요가 없으므로 곧바로 계산할 수 있습니다. 하지만 GPU 2는 두 번째 라운드까지 기다려 토큰 1-4를 받아야 비로소 토큰 1-8의 값을 모두 갖게 됩니다. 게다가 GPU 1은 다른 모든 GPU보다 일을 훨씬 적게 하는 것으로 보입니다.
계산을 더 고르게 나눌 수 있는지 봅시다.
지그재그 링 어텐션: 계산 균형을 맞춘 구현
입력 시퀀스를 나누는 더 나은 방법이 필요합니다. 토큰을 순서대로만 GPU에 배정하지 않고 순서를 조금 섞어서, 각 GPU가 앞쪽 토큰과 뒤쪽 토큰을 골고루 갖게 하면 됩니다. 이 방식을 지그재그 어텐션이라고 부릅니다. 이렇게 새로 배치하면 어텐션 마스크에 계산이 고르게 분포한 모습이 나타나는데, 색칠된 칸 수를 세어 보면 이제 모든 GPU에 계산이 균형 있게 나뉘었음을 알 수 있습니다.
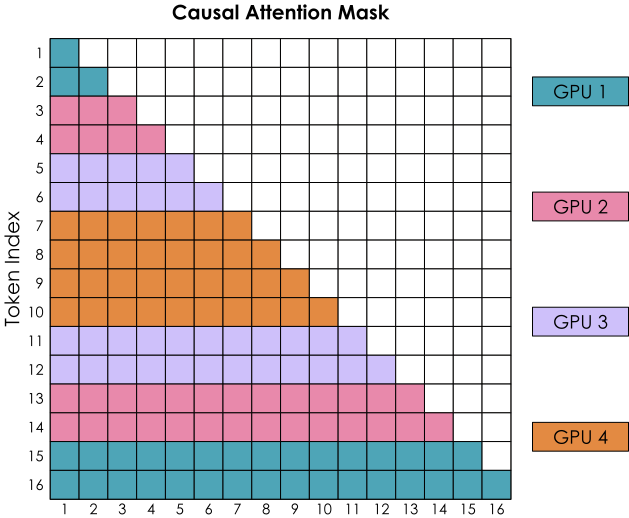
또 모든 행을 완성하려면 각 GPU가 다른 모든 GPU의 정보를 받아야 한다는 것도 알 수 있습니다.
계산과 통신을 겹치는 방법은 크게 두 가지입니다. 하나는 일반적인 AllGather를 수행해 모든 키와 값을 각 GPU에 한꺼번에 다시 모으는 방법이고(ZeRO-3와 비슷한 방식), 다른 하나는 각 GPU가 필요할 때마다 다른 GPU에서 키와 값을 받아 오는 방법입니다.
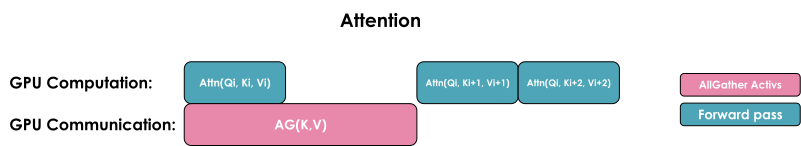
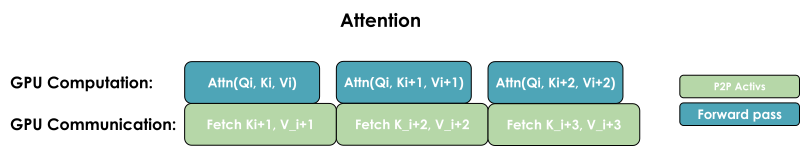
두 구현의 핵심 차이는 통신 패턴과 메모리 사용량에 있습니다:
1. AllGather 구현:
- 모든 GPU가 동시에 다른 모든 GPU의 키/값 쌍 전체를 모읍니다.
- 각 GPU가 모든 K/V 쌍을 한꺼번에 저장해야 하므로 임시 메모리가 더 많이 필요합니다.
- 통신이 한 번에 끝나지만 메모리 오버헤드가 더 큽니다.
2. All-to-all(링) 구현:
- GPU들이 링 모양 패턴으로 K/V 쌍을 한 번에 한 청크씩 주고받습니다.
- 각 GPU가 추가 청크 하나만 임시로 저장하면 되므로 메모리 효율이 더 좋습니다.
- 통신이 여러 번에 나뉘어 계산과 겹칩니다. 다만 통신 단계가 여러 번이라 기본 지연 시간 오버헤드가 조금 더 붙습니다.
대체로 all-to-all 방식은 통신 패턴이 조금 더 복잡한 대신 메모리 효율이 더 좋고, AllGather 방식은 더 단순하지만 어텐션 계산 중에 임시 메모리가 더 많이 필요합니다.
지금까지 TP로 모델을 노드 하나 안에서 나눠 큰 모델을 길들이는 방법과, CP로 긴 시퀀스에서 활성값이 폭증하는 문제를 길들이는 방법을 살펴봤습니다.
하지만 TP가 여러 노드로는 잘 확장되지 않는다는 것을 이미 알고 있습니다. 그렇다면 모델 가중치가 노드 하나에 쉽게 들어가지 않을 때는 어떻게 해야 할까요? 네 번째 병렬화 차원, 파이프라인 병렬화가 구하러 나설 차례입니다!
파이프라인 병렬화
🎧 원문의 팟캐스트 오디오: 듣기
팟캐스트를 듣는 기분으로 읽고 싶다면, 읽는 동안 NotebookLM 진행자들이 이 책의 다음 절들을 두고 나누는 이야기를 들어 보세요.
“텐서 병렬화” 절에서 보았듯이, 텐서 병렬화를 노드 하나에 있는 GPU 수(보통 4개나 8개)보다 크게 늘리려 하면 대역폭이 낮은 네트워크 통신을 써야 하므로 성능이 크게 떨어질 수 있습니다. 저희 클러스터에서 여러 노드에 걸쳐 AllReduce 연산을 벤치마크해 보면 이런 노드 사이 통신의 영향이 뚜렷하게 보입니다(여기서 노드마다 GPU가 8개 있습니다):
노드 수에 따른 노드 사이 통신 대역폭 측정값입니다. 선은 중앙값, 음영은 AllReduce, AllGather, ReduceScatter 연산의 5~95번째 백분위수 범위를 나타냅니다.
시퀀스 병렬화와 컨텍스트 병렬화는 긴 시퀀스에는 도움이 되지만, 메모리 문제의 근본 원인이 시퀀스 길이가 아니라 모델 크기 자체라면 별 도움이 되지 않습니다. 큰 모델(파라미터 70B 이상)은 가중치 크기만으로도 노드 하나에 있는 GPU 4-8개의 한계를 넘어설 수 있습니다. 이 문제는 병렬화 차원을 하나 더 불러와 풀 수 있습니다: 파이프라인 병렬화.
파이프라인 병렬화는 단순하지만 강력한 기법입니다. 모델의 레이어를 여러 GPU에 나누는 것이죠! 예를 들어 GPU가 8개라면 레이어 1-4는 GPU 1에, 레이어 5-8은 GPU 2에 두는 식입니다. 이렇게 하면 각 GPU는 모델 레이어의 일부만 저장하고 처리하면 되므로 GPU당 필요한 메모리가 크게 줄어듭니다. 8B 파라미터 모델에서 파이프라인 병렬화가 메모리 사용량에 실제로 어떤 효과를 내는지 봅시다:
위 그림을 보면 흥미로운 점이 눈에 띕니다. 모델 파라미터는 여러 GPU에 깔끔하게 나뉘지만, 활성값 메모리는 GPU마다 그대로입니다! 즉 이 방식으로는 활성값 메모리를 전혀 아끼지 못합니다.
📝 참고
각 GPU가 첫 역전파를 시작하기 전에 순전파를 PP번 수행해야 하기 때문입니다. 각 GPU는 레이어의 1/PP만 맡지만 첫 역전파 전에 마이크로배치 PP개를 처리해야 하므로, 결국 만큼 저장하게 됩니다. 그래서 필요한 활성값 메모리가 파이프라인 병렬화를 쓰지 않을 때와 거의 같습니다.
여기서 새로운 통신 패턴이 등장합니다. 데이터 병렬화의 ZeRO-3에서처럼 파라미터를 주고받는 대신, 이제는 활성값 텐서를 GPU 사이에서 “파이프라인”을 따라 차례로 넘깁니다. 개념은 단순하지만 이 기법을 효율적으로 구현하기는 꽤 까다롭습니다. 바로 세부 사항으로 들어가 봅시다!
레이어를 여러 노드에 나누기: 전부 순전파, 전부 역전파
우선 레이어를 여러 장치에 그냥 나눠 놓는다고 합시다. 예를 들어 첫 번째 GPU가 앞쪽 레이어 몇 개를 맡고, 두 번째 GPU가 모델의 두 번째 부분을 맡는 식입니다. 이제 모델의 순전파는 데이터 배치를 모델을 따라 차례로 넘기는 일, 곧 계산 장치를 하나씩 연달아 쓰는 일이 됩니다.
곧바로 얻는 첫 번째 장점이 있습니다: 모델 깊이를 따라 몇 군데에서만 적당한 크기의 활성값을 보내므로 필요한 인터커넥트 대역폭이 꽤 낮게 유지됩니다. 레이어마다 통신이 여러 번 일어나는 TP 방식 등과 비교하면 이 차이는 엄청날 수 있습니다.
하지만 앞으로 닥칠 문제가 슬슬 보이기 시작했을지도 모릅니다. “차례로”와 “연달아”라니?!? 병렬 계산의 세계에서는 그다지 효율적으로 들리지 않습니다. 계산과 통신을 겹치는 이야기를 한참 하고 난 뒤라면 더더욱 그렇죠.
맞습니다, 독자 여러분! 파이프라인 병렬화의 핵심 과제는 PP의 순차적인 성질을 효율적으로 우회해 GPU를 늘 바쁘게 하고, GPU 하나만 계산하는 동안 나머지는 기다리는 상황을 막는 것입니다. 모델을 아무 궁리 없이 단순하게 순전파하고 역전파하면 GPU 활용률은 다음과 같습니다(여기서 숫자는 모델 레이어를 나타냅니다):
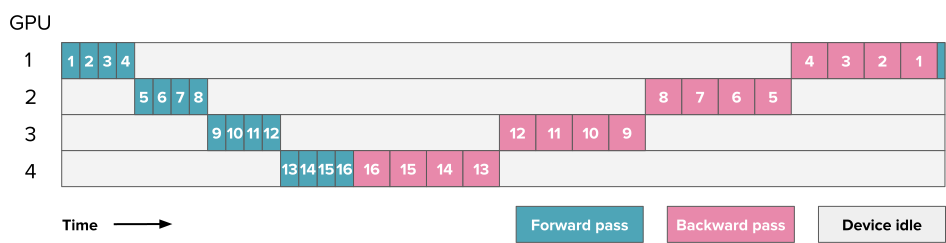
남는 유휴 시간은 회색으로 표시했고, 보통 “버블”이라고 부릅니다. 처리량을 최적화하느라 그렇게 공을 들였는데 이 광경을 보니 가슴이 무너졌을 겁니다.
파이프라인 구성이 얼마나 효율적인지는 버블 때문에 잃는 시간이 얼마인지로 정량화할 수 있습니다. 마이크로배치 하나와 파이프라인 스테이지 하나를 기준으로 잰 순전파 시간과 역전파 시간을 각각 , 라고 합시다(위 그래프처럼 흔히 라고 단순하게 가정합니다). 완벽하게 병렬화할 수 있다면 이상적인 총 시간은 입니다. 하지만 이 예에서는 파이프라인 버블 때문에 만큼 시간이 더 듭니다(여기서 는 파이프라인 병렬화 차수, 곧 GPU 수입니다). 이것이 다른 GPU가 계산하는 동안 각 GPU가 기다리는 시간입니다.
추가 버블 시간이 이상적인 시간의 몇 배인지는 다음과 같이 계산할 수 있습니다:
따라서 스테이지를 늘릴수록 버블 시간은 늘고 활용률은 떨어집니다. 보다시피 단순한 구현에서는 버블이 아주 커질 수 있습니다!
다행히 버블 크기를 줄이려고 고안된 파이프라인 병렬화 방식이 여럿 있습니다.
도구 상자에서 첫 번째 도구를 꺼내, 앞서 DP에서 했던 것처럼 배치를 병렬로(또는 거의 병렬로) 처리할 수 있는 한입 크기의 작은 조각으로 나누는 방법을 생각해 봅시다. 이제 두 번째 GPU가 마이크로배치 1을 처리하느라 바쁠 때, 첫 번째 GPU는 벌써 마이크로배치 2를 처리하기 시작할 수 있습니다. 다음은 마이크로배치 여덟 개를 쓰는 스케줄입니다:
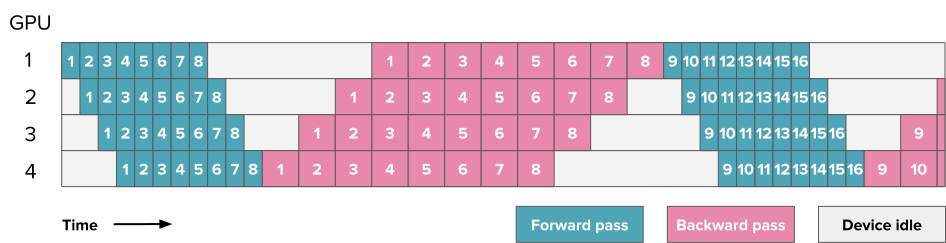
위 스케줄은 순전파를 모두 먼저 하고 나서 역전파를 모두 하므로 all forward, all backward(AFAB) 스케줄이라고 부릅니다. 순전파 단계와 역전파 단계가 여전히 대체로 순차적이어서 모델 학습 코드의 전체 구성을 그대로 유지할 수 있다는 것이 장점입니다. 구현하기 가장 쉬운 PP 방식 가운데 하나입니다.
AFAB 파이프라인의 전체 구현은 Picotron에서 볼 수 있습니다:
👉 Picotron의 AFAB PP 구현(펼치려면 클릭)
GitHub에서 코드 보기: picotron/pipeline_parallel/pipeline_parallel.py, L54-L83
이 예에서 버블을 추정해 봅시다. 첫 번째 예와 다른 점은 이제 마이크로배치 개를 처리하는 이상적인 시간이 라는 것입니다:
보다시피 마이크로배치를 늘리면 버블 크기를 분의 1로 줄여, 파이프라인 스테이지의 비효율을 어느 정도 덜 수 있습니다.
하지만 버블만큼이나 골치 아픈 것이 모든 활성값을 저장하는 데 드는 메모리입니다. 역전파 단계에 이를 때까지 모든 활성값을 메모리에 들고 있어야 하므로, 이런 PP 구현에서는 금세 메모리가 폭증합니다. 더 나은 방법으로 이 문제를 피할 수는 없을까요?
메모리 폭증은 역전파를 위해 저장해 두는 활성값 때문에 일어나므로, 아직 순전파 계산을 하는 도중에 역전파를 시작할 수 있는지 살펴봅시다. 그러면 역전파에 필요한 활성값 일부를 최대한 빨리 버릴 수 있습니다.
순전파 한 번, 역전파 한 번 방식과 Llama 3.1 방식
이 스케줄은 가운데의 안정 상태에서 순전파 한 번과 역전파 한 번을 번갈아 수행하므로 one forward, one backward(1F1B) 스케줄이라고 부릅니다. 기본 발상은 역전파를 최대한 빨리 시작하는 것입니다. 스케줄은 다음과 같습니다:
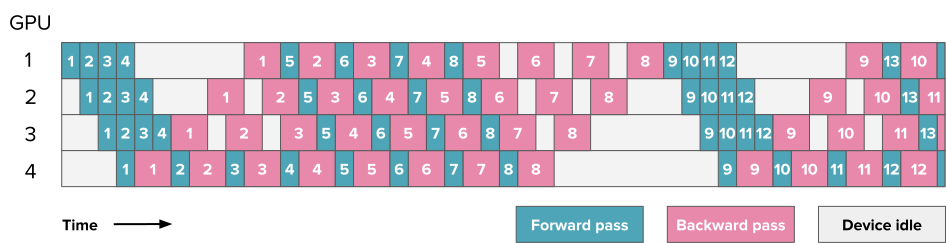
잘 세어 보면 버블 크기는 여전히 같으므로 학습 효율이 크게 나아지지는 않습니다. 하지만 이제 마이크로배치 개(는 파이프라인 병렬화 차수)의 활성값만 저장하면 되고, 개(은 마이크로배치 수)를 다 저장할 필요가 없으므로, AFAB 스케줄에서 겪었던 활성값 메모리 폭증을 줄일 수 있습니다. 그 결과 마이크로배치를 더 늘릴 수 있고, 그러면 실제로 버블이 줄어듭니다.
위 그림에서 보이듯 이 구성이 크게 복잡해지는 까닭은 순전파와 역전파가 더 이상 깔끔하게 순차적이지 않고, 여러 장치에서 병렬로 엇갈려 수행된다는 점입니다. 그래서 순전파에서 역전파로 넘어가는 시점을, 평소처럼 단순한 공용 중앙 학습 루프에서 정하는 대신 장치마다 따로 스케줄해야 합니다.
이것이 파이프라인 병렬화를 구현할 때 보통 모델링 코드뿐 아니라 학습 코드도 꽤 많이 고쳐야 하는 이유 가운데 하나입니다.
1F1B의 전체 구현도 Picotron에서 볼 수 있습니다:
👉 Picotron의 1F1B PP 구현(펼치려면 클릭)
GitHub에서 코드 보기: picotron/pipeline_parallel/pipeline_parallel.py, L85-L145
저희 클러스터에서 돌린 벤치마크로 1F1B 파이프라인 병렬화 스케줄이 실제로 어떻게 확장되는지 살펴봅시다:
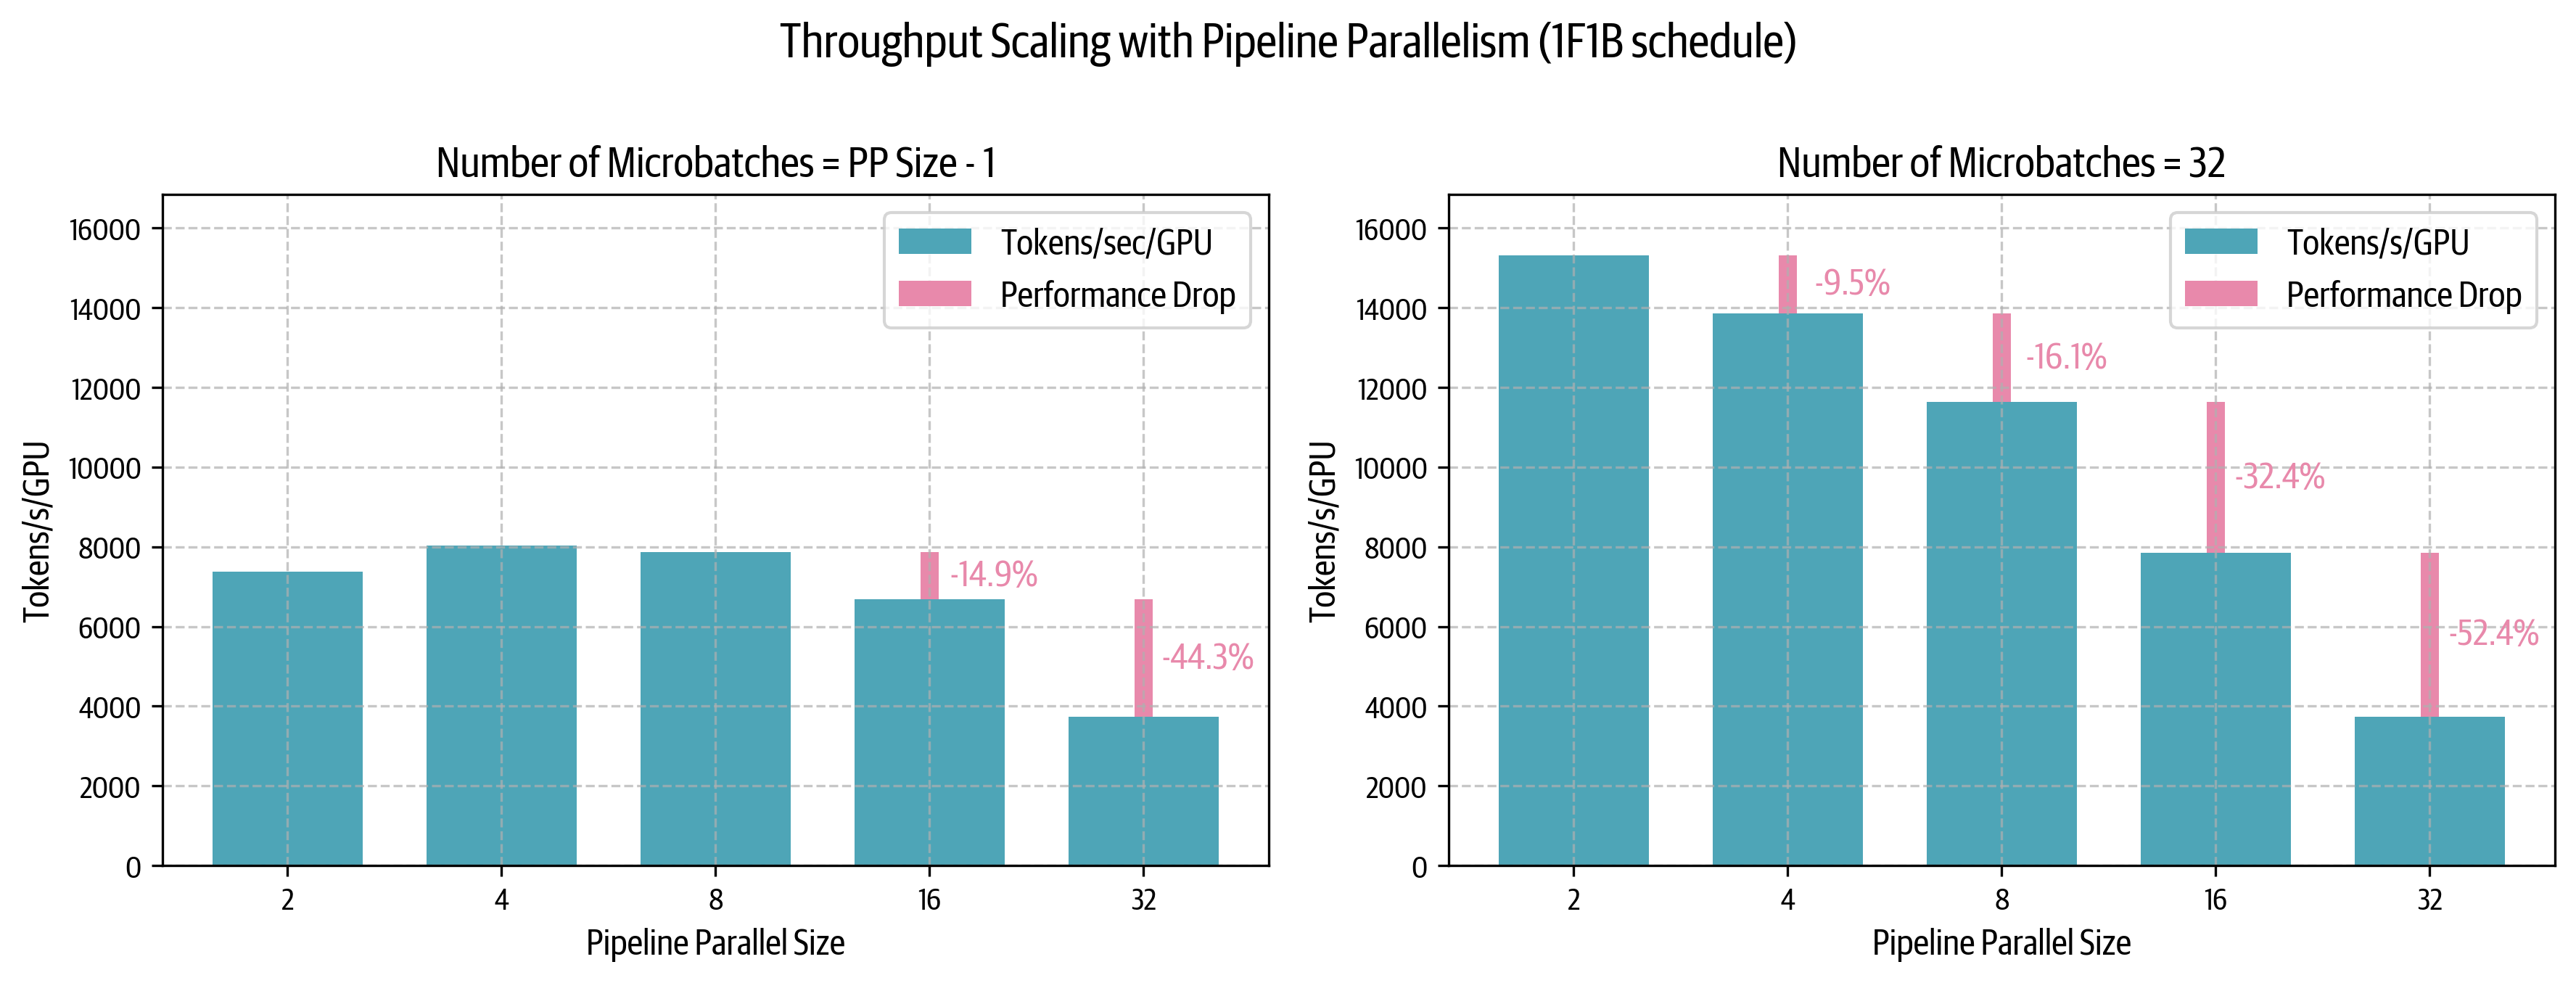
왼쪽 그래프는 마이크로배치 수가 PP 차수에서 1을 뺀 값 이하일 때() 파이프라인 버블이 얼마나 해로운지 보여 줍니다. 성능이 낮고, PP를 늘릴수록 오히려 떨어집니다. 오른쪽 그래프는 마이크로배치를 PP 차수보다 훨씬 많이 쓰면() PP 차수가 낮을 때의 성능이 좋아지지만, PP 차수가 아주 클 때는 여전히 한계가 있음을 보여 줍니다. 실제로는 결국 목표 전역 배치 크기에 묶이므로, 비율을 유지하려고 마이크로배치 수를 마음대로 늘릴 수는 없습니다. 마이크로배치 수가 가능한 최대치에 이른 상태에서 PP 차수를 더 늘리면, 결국 에 따라 버블 크기가 커질 수밖에 없습니다.
흥미롭게도 마이크로배치 수가 적을 때 노드 하나()에서 노드 둘()로 늘려도 성능은 14%만 떨어집니다. 노드를 넘나드는 비슷한 상황에서 성능이 보통 43% 안팎 떨어지는 텐서 병렬화보다 훨씬 잘 확장되는 셈입니다. 대역폭이 낮은 노드 사이 네트워크를 만나도 이렇게 버티기 때문에, 파이프라인 병렬화는 여러 노드에 걸친 분산 학습에 특히 매력적입니다.
1F1B는 활성값 메모리 사용량을 크게 줄여 주지만, 방금 본 그래프에서 알 수 있듯 파이프라인 버블은 여전히 효율의 큰 병목입니다. 버블 크기가 아직 파이프라인 스테이지 수에 비례하므로 귀한 GPU 연산 능력을 놀리고 있는 셈입니다. 이렇게 낭비되는 계산 시간을 최소로 줄이는, 더 영리한 스케줄을 설계할 수는 없을까요?
스테이지 교차 배치
1F1B 스케줄로 메모리 사용량은 개선했지만 유휴 버블의 크기에는 별 효과가 없었습니다. 이 한계를 더 밀어붙일 방법은 없을까요?
통신 연산을 몇 개 더 들일 각오만 있다면 가능합니다. 이제 스테이지 교차 배치 이야기를 할 차례입니다!
지금까지는 모델을 깊이 방향으로 단순하게 잘라, 예를 들어 레이어 1-4는 첫 번째 GPU에, 레이어 5-8은 두 번째 GPU에 두었습니다. 하지만 레이어를 자르는 방법은 이 밖에도 생각해 볼 수 있습니다. 이를테면 홀수 레이어(1, 3, 5, 7)는 첫 번째 GPU에, 짝수 레이어(2, 4, 6, 8)는 두 번째 GPU에 두는 식입니다.
넓게 보면 이는 일종의 “순환 파이프라인”입니다. 마이크로배치가 모델의 순전파를 거치는 동안 GPU에서 다음 GPU로 빙글빙글 돌며 이동하는 것이죠. 어떻게 동작하는지 봅시다:
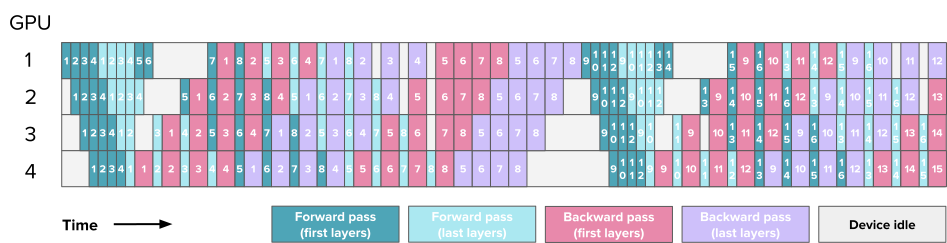
이전에는 한 번 지나가면 끝나던 계산을 위해 모델이 각 GPU를 여러 번 거치므로 통신이 더 필요합니다. 하지만 순전파와 역전파를 더 잘 엇갈려 배치할 수 있어서, 순전파와 역전파 각각이 분의 1로 줄어듭니다. 여기서 는 GPU당 스테이지 수, 곧 모델 청크 수입니다:
이제 마이크로배치와 교차 배치 스테이지를 늘려 버블을 줄일 수 있습니다. 다만 양으로 따지면 통신량도 배로 늘어나므로 트레이드오프가 있다는 점에 유의하세요. 다음 그래프는 인 PP 구성의 여러 설정을 보여 줍니다. 인 특수한 경우는 단순한 파이프라인 병렬화에 해당하고, 인 설정은 AFAB나 1F1B 구성이며, 인 경우가 교차 배치 설정입니다.
여기서는 스케줄링도 더 복잡해집니다. 특정 GPU에서 특정 순간에, 앞선 마이크로배치가 뒤쪽 레이어를 통과하는 일을 우선할지, 아니면 나중 마이크로배치가 앞쪽 레이어를 통과하는 일을 우선할지 정해야 하기 때문입니다. 앞의 경우는 순전파와 역전파 루프를 최대한 빨리 닫는다는 뜻으로, 배치를 최대한 빨리 모델 밖으로 내보내는 것을 우선하는 “깊이 우선” 방식입니다. 뒤의 경우는 파이프라인을 최대한 채우는 것을 우선하는 “너비 우선” 방식입니다. 이 선택은 “Breadth-First Pipeline Parallelism” 논문9에 자세히 설명되어 있습니다.
이제 Llama 3.1의 파이프라인 병렬화 방식을 이해할 재료가 모두 갖춰졌습니다. Llama 3.1은 스테이지를 교차 배치한 1F1B 구성을 쓰고, 깊이 우선과 너비 우선 사이에서 우선순위를 조절할 수 있게 해 둡니다:
[그림: Llama 3.1의 파이프라인 스케줄. 스테이지를 교차 배치한 1F1B에서 깊이 우선과 너비 우선 사이를 조절하는 모습. 출처는 Llama 3 논문(arXiv 2407.21783)입니다. 논문의 arXiv 라이선스가 기본 배포 허락(nonexclusive-distrib)뿐이라 싣지 않았습니다. 원문에서 볼 수 있습니다.]
하지만 파이프라인 스케줄의 가능성은 여기서 끝나지 않습니다. 최근에는 버블을 사실상 0으로 줄이는 방법들까지 제안되었습니다! 예를 들어 DeepSeek-V3/R1 구현2에 이런 기법이 쓰였습니다. 호기심이 생기셨나요? 파이프라인 병렬화의 세계를 떠나기 전에 이 마법 같은 스케줄들을 마지막으로 빠르게 살펴봅시다!
제로 버블과 DualPipe
최근에는 버블을 줄이는 훨씬 더 정교한 방법들이 제안되어 “제로 버블”에 가까운 수준에 이르렀습니다. DualPipe라고 부르는 DeepSeek-V3/R1의 파이프라인 구현 방식이 그런 예입니다. 비결은 관련 연산을 한층 더 잘게 쪼개서 가장 효율적인 방식으로 엇갈려 배치하는 데 있습니다.
DualPipe의 전신인 Sea AI Lab의 제로 버블 연구10를 요약하면서 이것이 어떻게 동작하는지 간단히 살펴봅시다. 기본 관찰은 행렬 곱셈의 역전파가 사실 서로 다른 두 연산으로 이루어진다는 것입니다: 입력 쪽 역전파 연산()과 가중치 쪽 역전파 연산()입니다.
입력 쪽 역전파인 의 출력은 아래쪽 레이어의 역전파를 수행하는 데 꼭 필요하지만, 가중치 쪽 역전파인 는 그렇지 않아서 보통 옵티마이저 스텝 전에만 수행하면 됩니다. 다음 도식(Zero Bubble 논문에서 가져옴)에서 이를 볼 수 있습니다:
[그림: Zero Bubble 논문의 계산 그래프 그림. 레이어의 역전파를 입력에 대한 그래디언트 B와 가중치에 대한 그래디언트 W로 나눈 의존 관계. 출처는 Zero Bubble 논문(Qi 외, arXiv 2401.10241)입니다. 논문의 arXiv 라이선스가 기본 배포 허락(nonexclusive-distrib)뿐이라 싣지 않았습니다. 원문에서 볼 수 있습니다.]
따라서 는 같은 스테이지의 해당 뒤라면 어디에든 유연하게 스케줄할 수 있습니다. 그래서 를 전략적으로 배치해 파이프라인 버블을 메울 수 있습니다. 오른쪽 위의 ZB-H2 스케줄은 이렇게 잘게 나눈 분해를 활용해 버블을 0으로 만든 (이론상의) 스케줄의 예입니다.
[그림: Zero Bubble 논문의 Figure 2와 3. 위는 고전적인 1F1B 스케줄, 아래는 B와 W를 나눠 손으로 짠 스케줄 두 개. 출처는 Zero Bubble 논문(Qi 외, arXiv 2401.10241)입니다. 논문의 arXiv 라이선스가 기본 배포 허락(nonexclusive-distrib)뿐이라 싣지 않았습니다. 원문에서 볼 수 있습니다.]
DeepSeek이 V3 기술 보고서2와 함께 소개한 DualPipe는 이 분해 방식을 확장해, PP 차원의 양 끝에서 각각 출발해 전파되는 두 스트림까지 다룹니다. 이 두 스트림을 엇갈려 배치해 GPU의 유휴 시간을 더 줄이는 것이죠. 이 스케줄은 다음 스케줄링 그래프와 같습니다. 보다시피 앞의 것들보다 훨씬 더 복잡합니다:
[그림: DeepSeek-V3의 DualPipe 스케줄. 파이프라인 양 끝에서 출발한 두 스트림의 순전파·역전파 블록이 엇갈려 놓인 표. 출처는 DeepSeek-V3 기술 보고서(arXiv 2412.19437)입니다. 논문의 arXiv 라이선스가 기본 배포 허락(nonexclusive-distrib)뿐이라 싣지 않았습니다. 원문에서 볼 수 있습니다.]
일반적으로 이렇게 복잡한 스케줄을 완전히 최적화하려면 잘게 나눈 여러 연산의 소요 시간을 꼼꼼히 측정하고, 최종 버블 시간을 최소화하는 정수 선형 계획법(Integer Linear Programming, ILP) 문제를 풀어야 합니다. (이런 스케줄링에 쓰는 휴리스틱과 알고리즘에 관한 논의는 예를 들어 Zero Bubble 논문10을 참고하세요.) 그래서 제로 버블과 DualPipe 스케줄은 너무 복잡해 여기서 코드 조각을 보여 드리기는 어렵지만, 관련 개념은 대략 감을 잡으셨을 겁니다.
이것으로 파이프라인 스케줄과 버블의 세계를 둘러보는 여행을 마칩니다. 즐거우셨기를 바랍니다!
이제 이 책에서 자세히 다룰 마지막 병렬화 방법, 큰 모델을 효율적으로 학습시키는 데 쓸 수 있는 방법으로 넘어갈 차례입니다: 전문가 병렬화.
전문가 병렬화
이번이 마지막으로 다룰 병렬화 방법입니다. 본격적으로 들어가기 전에, Mixture of Experts(MoE) 모델을 접해 본 적이 없다면 저희가 예전에 올린 훨씬 짧은 블로그 글을 먼저 읽어 보셔도 좋습니다. MoE 아키텍처 전반을 이해하는 데 도움이 될 것입니다.
MoE 패러다임은 최근 GPT-4, Mixtral11, DeepSeek-V3/R1 같은 모델 덕분에 주목받으며 널리 알려졌습니다. 기본 아이디어는 레이어마다 피드포워드 모듈을 하나만 두는 대신 여러 모듈을 나란히 두고, 토큰을 이 모듈들로 라우팅해 서로 다르게 처리하자는 것입니다.
[그림: Switch Transformers 논문의 MoE 레이어 그림. 라우터가 토큰마다 전문가 FFN 하나를 고르는 구조. 출처는 Switch Transformers 논문(arXiv 2101.03961)입니다. 논문의 arXiv 라이선스가 기본 배포 허락(nonexclusive-distrib)뿐이라 싣지 않았습니다. 원문에서 볼 수 있습니다.]
MoE 레이어는 구조상 전문가 차원을 따라 병렬화하기가 쉽습니다. 이것을 전문가 병렬화라고 부릅니다. 피드포워드 레이어들은 서로 완전히 독립적이므로, 전문가마다 피드포워드 레이어를 서로 다른 워커에 올려 두기만 하면 됩니다. TP와 비교하면 이 방식은 훨씬 가볍습니다. 행렬 곱셈을 쪼갤 필요 없이, 토큰의 은닉 상태를 알맞은 전문가에게 라우팅하기만 하면 되기 때문입니다.
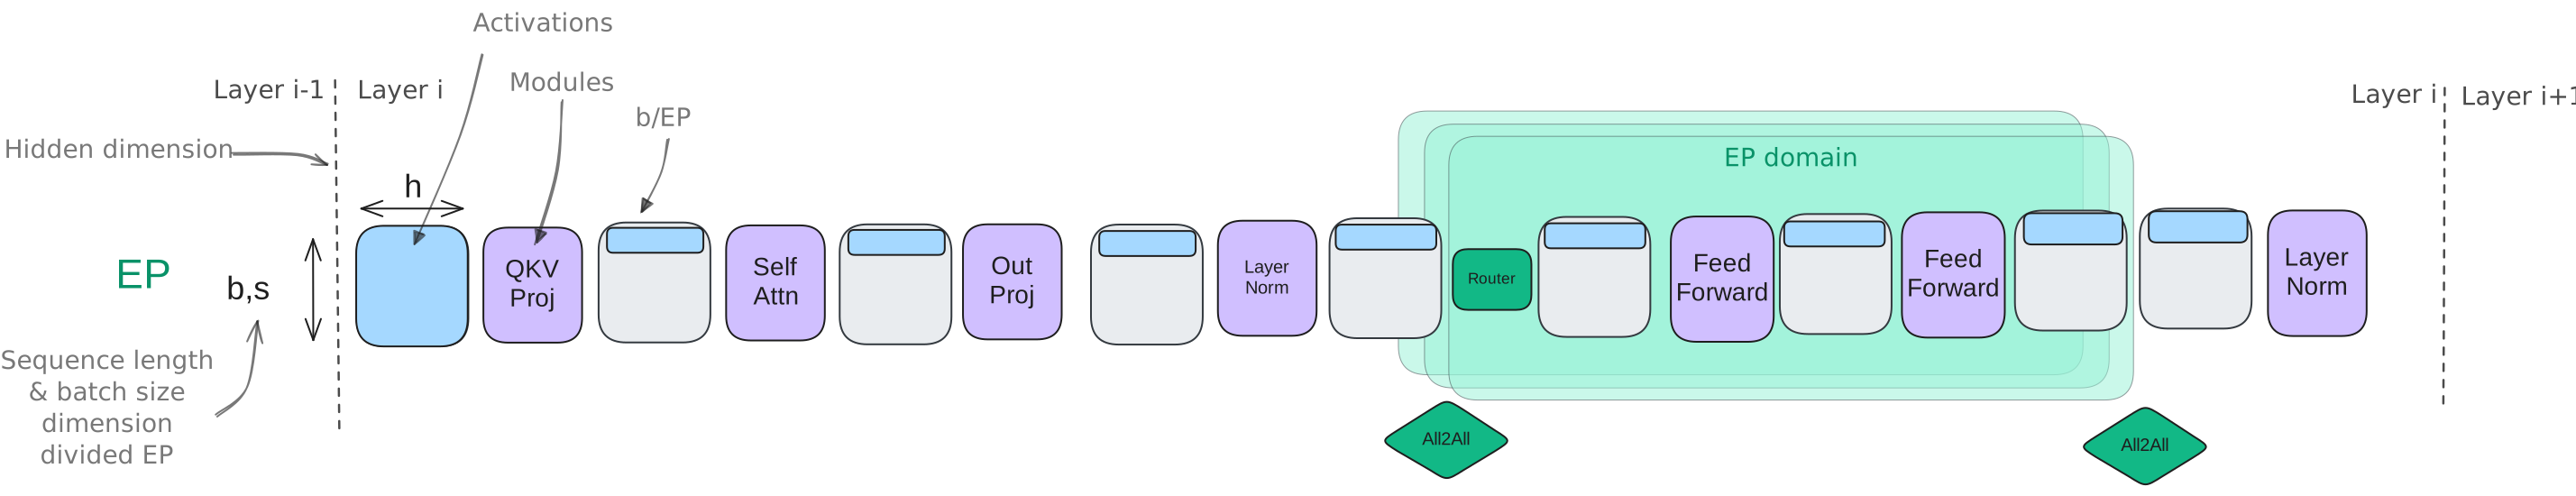
실제로 EP는 보통 데이터 병렬화 같은 다른 병렬화 방식과 함께 씁니다. EP는 MoE 레이어에만 영향을 줄 뿐 입력 토큰은 샤딩하지 않기 때문입니다(토큰을 시퀀스 길이 차원을 따라 샤딩하는 컨텍스트 병렬화와는 다릅니다). 그래서 EP만 쓰면 MoE가 아닌 블록 전부에서 GPU들이 같은 계산을 중복해서 하게 됩니다. EP를 DP와 결합하면, 아래의 단순화한 도식처럼 전문가와 입력 배치를 모두 GPU들에 효율적으로 샤딩할 수 있습니다.
[그림: MoE 서베이의 전문가 병렬화 방식 분류 그림. 출처는 “A Survey on Mixture of Experts”(arXiv 2407.06204)입니다. 논문의 arXiv 라이선스가 기본 배포 허락(nonexclusive-distrib)뿐이라 싣지 않았습니다. 원문에서 볼 수 있습니다.]
하지만 너무 앞서 나가지는 맙시다. 여러 병렬화 전략이 서로 어떻게 맞물리는지는 다음 절에서 모두 이야기할 테니, 방금 본 도식이 아직 이해되지 않더라도 걱정하지 마세요.
실제로 EP를 효율적으로 돌리려면 몇 가지 요령이 필요하고, 이 요령들은 모델 설계와 밀접하게 얽혀 있습니다. 예를 들어 DeepSeek-V3는 라우터에 제약을 걸어 각 토큰이 최대 개 노드(DeepSeek-V3에서는 4개)로만 보내지게 합니다. 토큰을 한 노드 안에 붙잡아 두어 통신 오버헤드를 줄이려는 것입니다. 전문가 병렬화는 꽤 오래전부터 있었지만14, MoE 아키텍처가 인기를 얻으면서 이제야 새롭게 주목받고 있습니다.
곧 Picotron/Nanotron에 더 완전한 EP 예제를 추가할 계획이니, 기대해 주세요!
5D 병렬화 한눈에 보기
축하합니다, 독자 여러분! 이제 모델 학습을 확장하는 데 쓸 수 있는 다섯 가지 병렬화 전략을 모두 살펴보았습니다.
- 데이터 병렬화: 배치 차원을 따라
- 텐서 병렬화: 은닉 차원을 따라
- 시퀀스 병렬화와 컨텍스트 병렬화(SP/CP): 시퀀스 차원을 따라
- 파이프라인 병렬화: 모델 레이어를 따라
- 전문가 병렬화: 모델의 전문가를 따라
그리고 메모리를 줄이려고 데이터 병렬화와 함께 쓸 수 있는 세 가지 ZeRO 전략도 살펴보았습니다.
- ZeRO-1: 옵티마이저 상태를 DP 복제본들에 나눠 샤딩
- ZeRO-2: 옵티마이저 상태와 그래디언트를 DP 복제본들에 나눠 샤딩
- ZeRO-3: 옵티마이저 상태, 그래디언트, 파라미터를 DP 복제본들에 나눠 샤딩
여기까지 오면 아마 이 병렬화 전략들과 ZeRO 전략들이 서로 어떻게 다르고 어떻게 맞물리는지 궁금하실 것입니다. 다시 말해, 어떤 것들은 함께 효율적으로 결합해 쓸 수 있고, 어떤 것들은 따로 떼어 두어야 할까요?
닮은 점과 상호작용을 살펴보겠습니다. 먼저 파이프라인 병렬화와 ZeRO-3를 나란히 비교해 보겠습니다. 둘은 아주 비슷한 점도 있지만 중요한 차이점도 있습니다.
파이프라인 병렬화와 ZeRO-3는 둘 다 모델 가중치를 여러 GPU에 나눠 두고, 모델의 깊이 축을 따라 통신과 계산을 하는 방식입니다(예를 들어 ZeRO-3에서는 계산하는 동안 다음 레이어를 미리 가져옵니다). 그래서 두 경우 모두 각 장치가 레이어 연산을 통째로 계산합니다. 반면 TP나 EP 같은 방식에서는 레이어보다 작은 단위로 계산합니다.
하지만 PP와 ZeRO-3 방식 사이에는 몇 가지 큰 차이가 있습니다.
| ZeRO-3 | 파이프라인 병렬화 | |
|---|---|---|
| 각 계산 단위가 저장하는 것은… | 레이어의 일부분만 | 레이어 전체 |
| 통신으로 전송하는 것은… | 가중치 | 활성값 |
| 조율 | 모델 무관 | 모델 무관 |
| 구현상의 어려움 | 모델 분할과 통신을 다루기가 복잡함 | 효율적인 PP 스케줄을 다루기가 복잡함 |
| 확장 시 고려할 점 | 통신을 숨기려면 큰 와 이 유리함 | 버블을 숨기려면 큰 가 유리함 |
보시다시피 ZeRO-3와 PP는 같은 문제를 서로 다른 방식으로 풉니다. 둘 중 무엇을 고를지는 통신을 가중치 전송에 쓸지, 활성값 전송에 쓸지에 달려 있습니다. 둘을 결합할 수도 있지만 실제로는 그렇게 하는 경우가 드뭅니다. 결합하려면 통신 비용을 상쇄할 만큼 전역 배치 크기를 크게 늘려야 하고, 그러면 전역 배치 크기, 모델 크기, 네트워크 대역폭, 학습 효율 사이에 트레이드오프가 생기기 때문입니다. 그래도 결합하기로 했다면, 불필요한 통신 오버헤드를 최대한 줄이도록 PP 마이크로배치들이 이어지는 동안 ZeRO-3가 가중치를 메모리에 계속 들고 있게 설정해야 합니다.
반면 옵티마이저 상태와 그래디언트에 집중하는 ZeRO-1과 ZeRO-2는 파이프라인 병렬화와 쉽게 결합할 수 있고 서로 보완합니다. 이렇게 결합해도 특별히 새로운 문제가 생기지 않습니다. 예를 들어 DeepSeek-v3의 학습에는 PP와 ZeRO-1을 결합해 썼습니다.
텐서 병렬화(시퀀스 병렬화와 함께 쓰는 경우)는 파이프라인 병렬화와도, ZeRO-3와도 자연스럽게 서로 보완하며 결합할 수 있습니다. 텐서 병렬화가 기대는 행렬 곱셈의 분배 법칙 덕분에, 가중치와 활성값을 샤딩해 각각 독립적으로 계산한 뒤 합칠 수 있기 때문입니다.
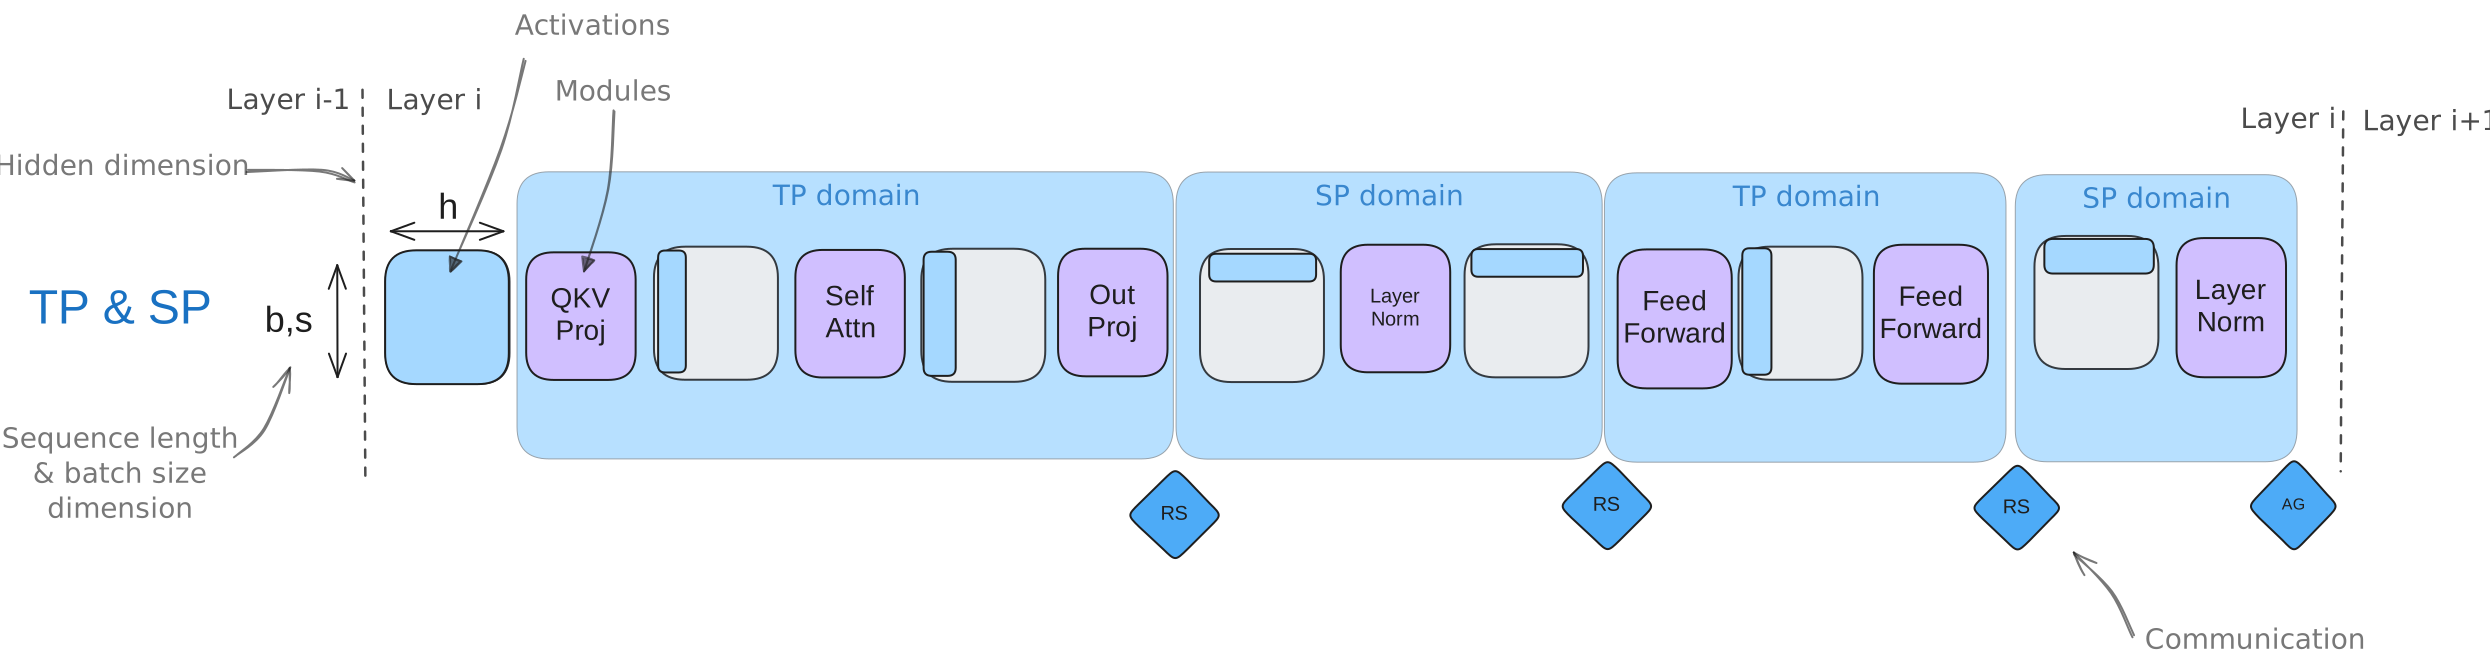
병렬화에 TP만 쓰지 않으려는 주된 이유는 실제로 TP에 두 가지 한계가 있다는 점입니다(앞 절들에서 다룬 내용입니다). 첫째, TP의 통신 연산은 계산의 임계 경로에 놓이므로 어느 지점을 넘어서면 잘 확장되지 않습니다. 그 지점을 지나면 통신 오버헤드가 전체 시간을 좌우하기 시작합니다. 둘째, 모델 구조와 무관하게 쓸 수 있는 ZeRO나 PP와 달리, TP는 활성값 샤딩을 세심하게 다뤄야 합니다. 어떤 때는 은닉 차원을 따라(TP 영역), 어떤 때는 시퀀스 차원을 따라(SP 영역) 샤딩해야 하지요. 그래서 올바르게 구현하기가 더 번거롭고, 모델 전체에서 샤딩 패턴이 제대로 맞도록 하려면 모델별 지식이 필요합니다.
그래서 병렬화 전략을 결합할 때 TP는 보통 빠른 노드 내부 통신 범위 안에 두고, 상대적으로 느린 노드 사이 통신에 걸치는 병렬화 그룹에는 ZeRO-3나 PP를 씁니다. 이 둘의 통신 패턴은 대역폭이 덜 필요하거나(PP의 경우) 계산과 겹치기가 더 쉽기(ZeRO-3의 경우) 때문입니다. 이 기법들을 결합할 때 가장 신경 쓸 점은 TP의 확장 한계를 염두에 두면서, 처리량을 최대로 높이고 통신 오버헤드를 최소로 줄이도록 병렬화 차원마다 GPU를 효율적으로 그룹 짓는 것입니다. 예를 들어 TP로 통신하는 GPU 그룹은 노드 안에 두어야 합니다.
컨텍스트 병렬화와 전문가 병렬화도 활성값을 샤딩하는 데 도움이 되며, TP를 보완하는 기법으로 볼 수 있습니다. CP는 긴 시퀀스를 처리하고 EP는 분산 MoE 학습을 가능하게 하며, 둘은 별문제 없이 결합할 수 있습니다.
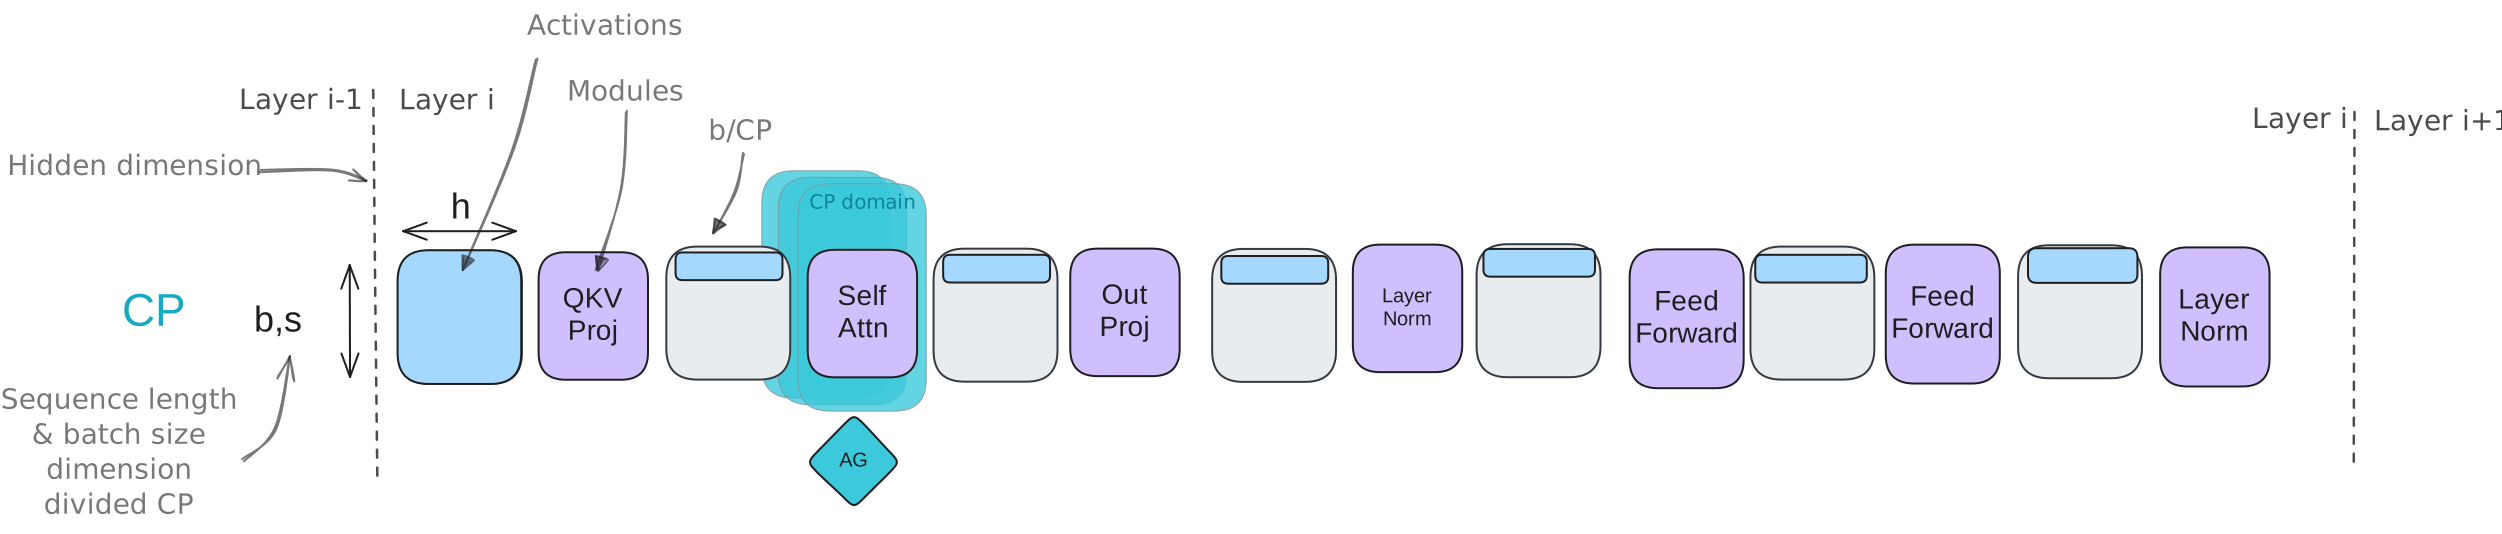
CP는 활성값을 시퀀스 차원을 따라 여러 GPU에 샤딩해서, 아주 긴 시퀀스로 학습하는 문제를 정면으로 겨냥합니다. MLP나 LayerNorm 같은 대부분의 모듈은 이렇게 샤딩된 시퀀스를 독립적으로 처리할 수 있지만, 어텐션 블록은 각 토큰이 전체 시퀀스의 키/값을 참조해야 하므로 통신이 필요합니다. CP 절에서 보았듯이, 이 문제는 계산과 통신을 겹치는 링 어텐션 패턴으로 효율적으로 처리합니다. CP는 극단적인 시퀀스 길이(128k 토큰 이상)로 확장할 때 특히 쓸모가 큽니다. 이런 길이에서는 활성값을 전체 재계산하더라도 어텐션에 필요한 메모리가 GPU 한 개로는 감당할 수 없을 만큼 커지기 때문입니다.
전문가 병렬화는 특화된 “전문가”들을 여러 GPU에 샤딩하고, 계산 중에 토큰을 관련된 전문가에게 동적으로 라우팅해서 MoE 모델 학습이라는 문제를 정면으로 겨냥합니다. EP의 핵심 통신 연산은 토큰을 배정된 전문가에게 보내고 결과를 다시 모아 오는 “all-to-all” 연산입니다. 이 때문에 통신 오버헤드가 어느 정도 생기지만, 추론(과 학습) 중에 각 토큰은 전체 파라미터 가운데 훨씬 작은 일부만 거쳐 처리되므로 모델 용량을 크게 늘릴 수 있습니다. 분산 학습/추론 관점에서는, 모델의 전문가 수가 많아질 때 전문가를 여러 GPU에 나눠 두는 일이 중요해집니다.
📝 참고
입력을 다루는 방식에서 EP와 DP가 이렇게 닮았기 때문에, 일부 구현에서는 전문가 병렬화를 데이터 병렬화의 일종으로 봅니다. 핵심 차이는 모든 GPU가 똑같은 모델 사본으로 입력을 처리하는 대신, EP는 특화된 전문가 라우팅을 쓴다는 점입니다.
적용 범위와 초점
이 여러 병렬화 전략이 모델의 어느 부분에 가장 크게 영향을 주는지도 빠르게 정리해 보겠습니다.
- 텐서 병렬화(와 시퀀스 병렬화)는 가중치와 활성값을 모두 샤딩하므로 모델 전체의 계산에 영향을 줍니다.
- 컨텍스트 병렬화는 주로 어텐션 레이어에 영향을 줍니다. 시퀀스 전체에 걸친 통신이 필요한 곳이 바로 어텐션 레이어이고, 다른 레이어들은 샤딩된 시퀀스를 독립적으로 처리합니다.
- 전문가 병렬화는 주로 MoE 레이어(표준 MLP 블록을 대신하는 레이어)에 영향을 주고, 어텐션 레이어와 다른 구성 요소는 그대로 둡니다.
- 파이프라인 병렬화와 ZeRO는 특정 하위 모듈이나 구성 요소에 딱히 얽매이지 않습니다. 다만 파이프라인 병렬화에서는 모듈과 레이어의 균형을 맞춰야 한다는 예외가 있습니다(그래서 첫 레이어와 마지막 레이어는 임베딩 레이어가 더 붙는 탓에 따로 다룰 때가 많습니다).
| 텐서 + 시퀀스 병렬화 | 컨텍스트 병렬화 | 전문가 병렬화 |
|---|---|---|
| 가중치와 활성값을 은닉/시퀀스 차원을 따라 샤딩 | 활성값을 시퀀스 차원을 따라 샤딩 | 특화된 전문가 가중치와 활성값을 샤딩 |
| 행렬 곱셈 연산(열/행 선형)을 위한 통신 | 어텐션 키/값을 위한 통신 | 토큰을 전문가에게 라우팅하기 위한 통신 |
| 모델별 구현이 필요함 | 어텐션을 빼면 모델 무관 | MoE 레이어를 빼면 모델 무관 |
| 고대역폭 노드 내부 통신이 유리함 | 긴 시퀀스 길이가 유리함 | MoE 레이어가 있어야 함 |
한데 모아 정리하기
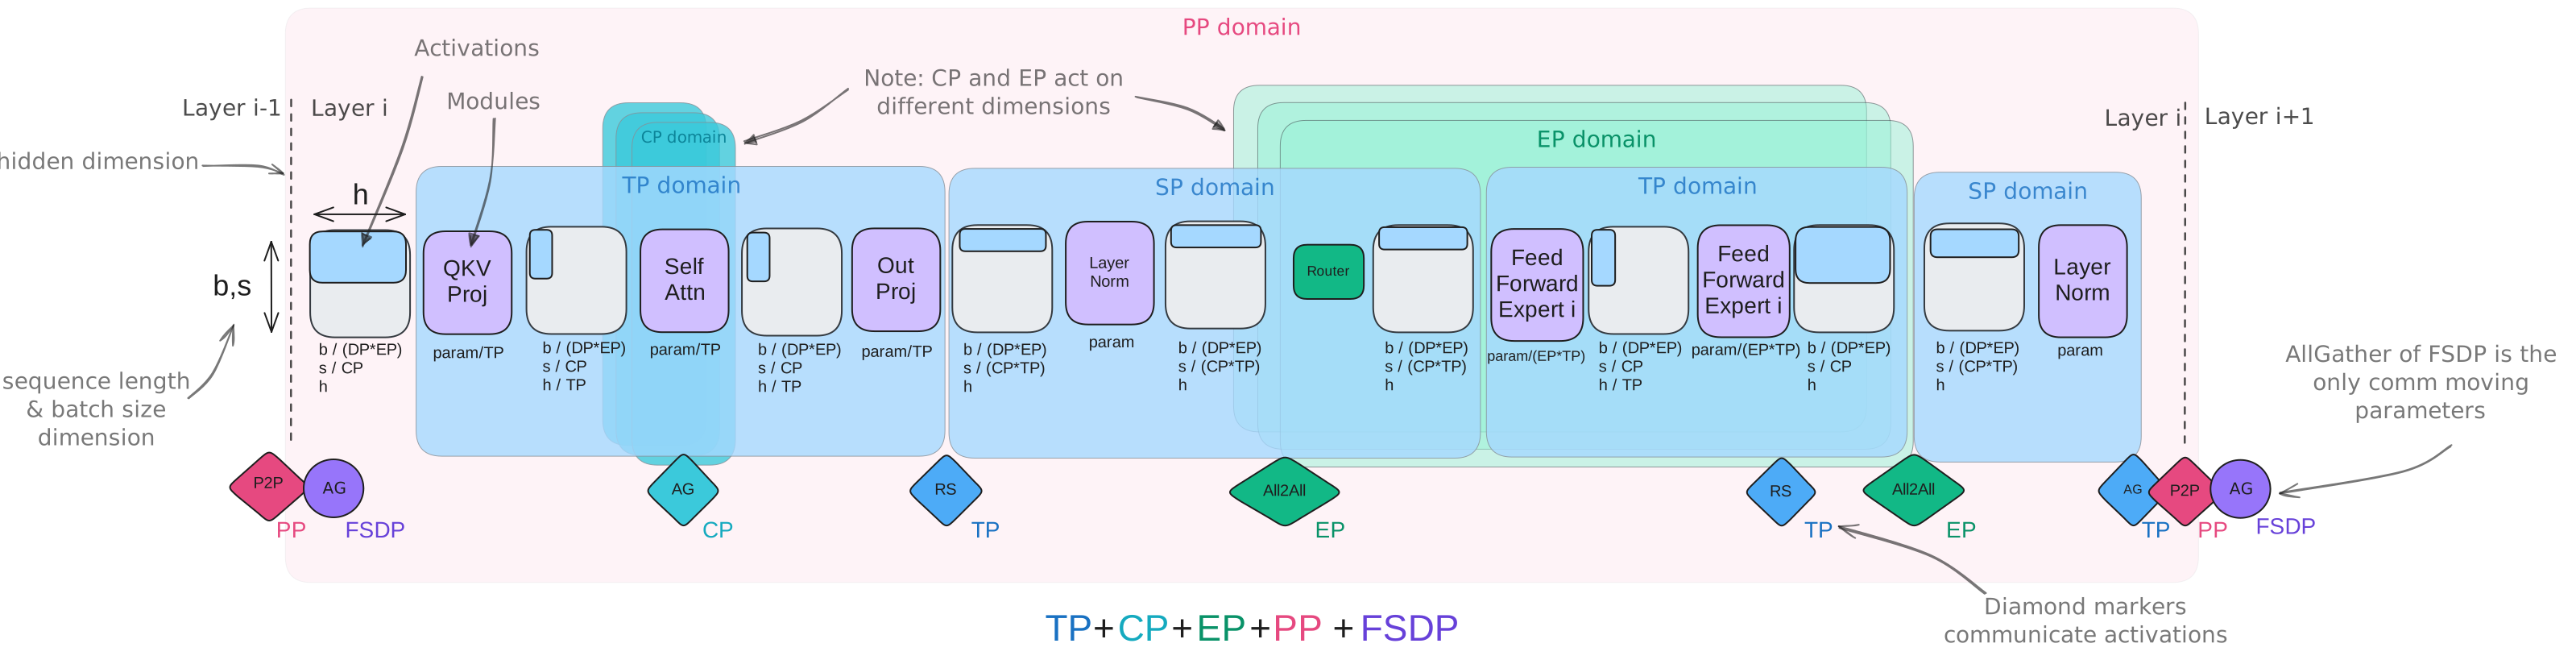
그렇다면 지금까지 본 기법을 모두 결합해 도식 하나에 담아 보면 어떨까요? 네, 저희가 그 도전을 받아들이겠습니다!
이 요약 도식에는 트랜스포머 레이어 하나(MoE 변형)의 활성값과 모듈이 그려져 있습니다. 앞 절들에서 다룬 여러 병렬화 방향과 통신 연산도 함께 나타냈습니다.
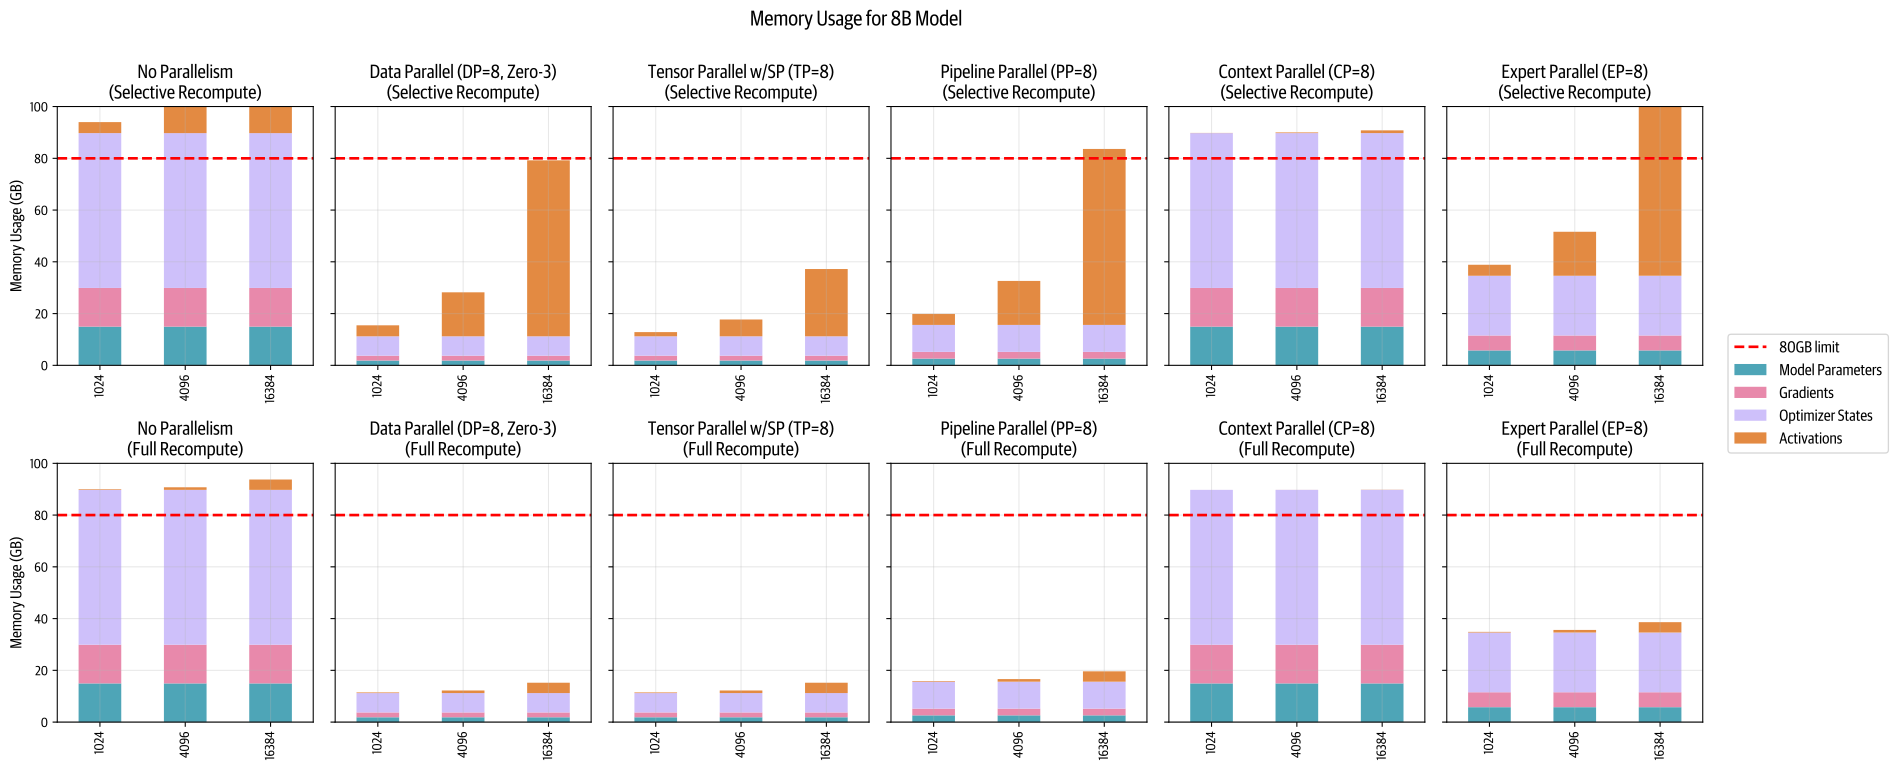
이 전략들 각각이 메모리를 얼마나 아껴 주는지 전체 개요도 보여 드릴 수 있습니다. 시퀀스 길이를 바꿔 가며, 그리고 선택적 재계산(위)과 전체 재계산(아래)을 적용한 경우로 나눠 그려서, 각 전략이 활성값과 어떻게 맞물리는지 보이도록 했습니다.
이 절은 모든 기법과 그 바탕이 되는 핵심 아이디어, 주요 병목을 한눈에 정리하며 마치겠습니다.
| 방법 | 메모리 절약이 적용되는 대상 | 병렬화/샤딩 차원 | 단점 |
|---|---|---|---|
| DP | 활성값(로컬 배치 크기를 줄임) | 배치 | 최대 배치 크기에 제한됨 |
| PP | 모델 파라미터 | 모델 레이어 | 유휴 버블과 복잡한 스케줄 |
| TP+SP | 모델 파라미터와 활성값 | 은닉 차원/시퀀스 길이 | 고대역폭 통신이 필요함 |
| CP | 활성값 | 시퀀스 길이 | 어텐션 모듈에 통신 오버헤드가 더해짐 |
| EP | 전문가 파라미터 | 전문가 차원 | MoE 레이어가 필요하고, 라우팅 통신 오버헤드가 더해짐 |
| ZeRO-1 | 옵티마이저 상태 | DP 복제본들에 나눠 샤딩 | 파라미터 통신 오버헤드 |
| ZeRO-2 | 옵티마이저 상태와 그래디언트 | DP 복제본들에 나눠 샤딩 | 파라미터 통신 오버헤드 |
| ZeRO-3 | 옵티마이저 상태, 그래디언트, 모델 파라미터 | DP 복제본들에 나눠 샤딩 | 파라미터 통신 오버헤드 |
분명히 이 기법들 가운데 무엇도 마법처럼 확장을 해결해 주는 만능 열쇠는 아니며, 대개는 이런저런 방식으로 결합해야 합니다. 그렇다면 이 기법들 가운데 무엇을 고르고 어떻게 결합할지 정할 때 좋은 출발점이 되어 줄 규칙을 몇 가지 세울 수 있을까요? 이것이 다음 절의 주제입니다.
최적의 학습 구성 찾기
지금까지 더 큰 모델을 분산해 학습할 때 실제로 쓰는 병렬화 기법을 모두 다루었고, 이 기법들을 어떻게, 왜 결합할 수 있는지도 살펴보았습니다. 그래도 큰 질문은 남아 있습니다. 어떤 기법을 골라야 하고, 구체적인 조합은 어떻게 정해야 할까요?
앞 절에서 조금 다루기는 했지만, 이제 결정을 내리는 과정 하나를 단계별로 더 자세히 따라가 보겠습니다(다만 여러분의 컴퓨팅 클러스터에 맞는 최종 최적 설정을 찾으려면, 클러스터의 여러 물리적 특성, 네트워크 대역폭, 노드당 GPU 수, GPU당 메모리 등을 고려해 언제나 몇 가지 실험을 돌려 봐야 한다는 점을 염두에 두세요).
1단계: 학습 스텝 하나를 메모리에 올리기
먼저 모델 인스턴스 하나를 통째로 GPU에 올릴 방법을 찾아야 합니다. 크게 두 가지 경우가 있습니다.
1. GPU 부자의 경우 🤑: GPU를 넉넉하게 쓸 수 있을 때
- 파라미터가 10B 미만인 모델이라면 병렬화 기법 하나만 써도 됩니다. 예를 들어 GPU 8개에 걸쳐 텐서 병렬화나, 전체 재계산을 곁들인 ZeRO-3/DP를 쓰는 식입니다.
- 파라미터가 10B~100B여서 GPU가 8개보다 많이 필요한 모델이라면, 몇 가지 선택지가 있습니다.
- 텐서 병렬화(TP=8)와 파이프라인 병렬화 결합하기
- 텐서 병렬화(TP=8)와 데이터 병렬화(ZeRO-3) 결합하기
- ZeRO-3만 쓰기(곧 순수 데이터 병렬화)
- GPU가 512개 이상인 규모에서는 순수 데이터 병렬화/ZeRO-3가 통신 비용 때문에 비효율적으로 바뀌기 시작합니다. 이때는 DP를 텐서 병렬화나 파이프라인 병렬화와 결합하는 편이 나을 수 있습니다.
- GPU가 1024개 이상인 규모에서는 텐서 병렬화(TP=8)에 데이터 병렬화(ZeRO-2)와 파이프라인 병렬화를 함께 쓰는 설정을 권할 만합니다.
특별히 고려할 점:
- 시퀀스가 아주 길다면 노드 사이에 걸쳐 컨텍스트 병렬화를 더하는 편이 좋을 것입니다.
- MoE 아키텍처라면 노드 사이에 걸쳐 전문가 병렬화를 쓰는 것이 유리합니다.
2. GPU 가난뱅이의 경우 😭: GPU 자원이 부족할 수 있을 때
- 활성값 전체 재계산을 켜서 계산을 조금 더 쓰는 대신 메모리를 아낄 수 있습니다(학습은 조금 느려집니다).
- 그래디언트 누적을 늘려, 제한된 메모리로도 더 큰 배치를 처리할 수 있습니다.
이제 첫 모델 인스턴스가 학습을 시작했으니, 배치 크기가 알맞은지 확인해야 합니다.
2단계: 목표 전역 배치 크기 맞추기
1단계를 마친 시점의 마이크로배치 크기와 DP에 따라, 지금 배치 크기는 너무 작을 수도, 너무 클 수도 있습니다. 이제 목표 배치 크기를 맞출 차례입니다.
현재 전역 배치 크기를 늘리려면:
- 데이터 병렬화나 그래디언트 누적 스텝 수를 늘릴 수 있습니다.
- 시퀀스가 길다면 컨텍스트 병렬화를 활용할 수 있습니다.
현재 전역 배치 크기를 줄이려면:
- 데이터 병렬화를 줄이고 그만큼 다른 병렬화 전략을 쓸 수 있습니다.
- 시퀀스가 길다면 컨텍스트 병렬화를 줄일 수 있습니다.
좋습니다. 이제 모델 크기와 배치 크기 면에서 원하는 대략의 구성으로 모델이 돌아갑니다. 그런데 과연 가장 빠른 방식으로 학습하고 있을까요? 마지막 단계는 처리량을 최적화하는 일입니다.
3단계: 학습 처리량 최적화하기
소중한 GPU를 언제나 알차게 쓰도록 학습이 최대한 빠르게 돌아가게 하고 싶습니다. 메모리와 통신이 병목이 아닌 한, 다음을 시도해 볼 수 있습니다.
- (빠른 노드 내부 대역폭을 활용해) 텐서 병렬화의 차수를 노드 크기에 가까워질 때까지 늘려, 다른 병렬화를 줄일 수 있게 합니다.
- 목표 배치 크기는 유지하면서 ZeRO-3로 데이터 병렬화를 늘립니다.
- 데이터 병렬화의 통신이 병목이 되기 시작하면 파이프라인 병렬화로 넘어갑니다.
- 여러 병렬화를 하나씩 늘려 봅니다.
- 마이크로배치 크기()를 바꿔 가며 실험해, 최대 전역 배치 크기, 모델 크기, 계산, 통신 사이의 최적 균형을 노립니다.
수천 가지 구성 벤치마크하기
단계별 과정을 살펴보았으니, 이제 이 탐색 과정을 실제로 구현해 보겠습니다.
Nanotron 저장소에는 앞에서 이야기한 실험을 모두 돌려 보고, 여러분의 모델과 클러스터를 벤치마크할 수 있는 스크립트가 여럿 있습니다.
저희는 이 책에서 지금까지 다룬 결과를 얻으려고 수천 가지 분산 구성으로 직접 벤치마크를 돌렸습니다. 여기서 다룬 모든 모델 크기와 아주 많은 클러스터 구성(구체적으로는 8xH100 노드 1~64개)을 아울렀습니다.
이제 한 걸음 물러나 모든 벤치마크 결과를 모아 분석하면서, 이론을 넘어 실제 데이터로 여러 구성이 서로 견주어 어떤 성적을 내는지 알아낼 수 있는지 보겠습니다.
아래 벤치마크는 모두 시퀀스 길이 4,096, 전역 배치 크기 1M 토큰으로 진행했습니다. 모델 크기와 클러스터 크기마다 가장 좋은 구성을 모두 모아 다음 히트맵에 그렸습니다.
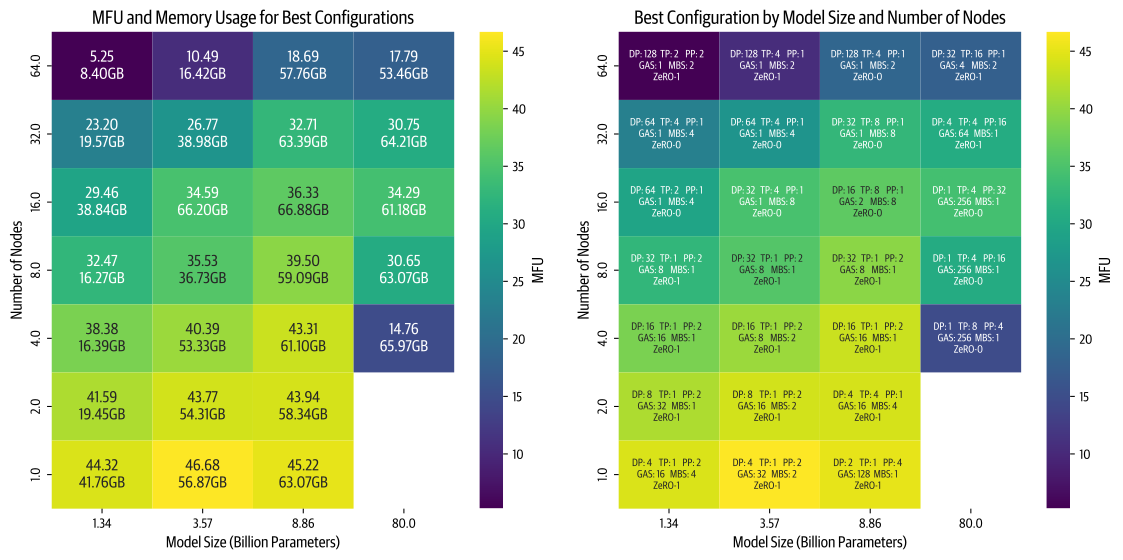
이 개괄적인 시각화에서 몇 가지 중요한 통찰을 얻을 수 있습니다.
- 첫째, 노드 수를 늘릴수록(병렬화 정도가 높을수록) 효율이 떨어집니다. 이 효과는 모델 크기 대비 계산량 비율이 낮은 작은 모델에서 특히 두드러집니다. 보통은 배치 크기를 늘려 작은 모델 크기를 보완할 수 있겠지만, 여기서는 전역 배치 크기 상한 1M에 묶여 있습니다.
- 둘째, 큰 모델에는 다른 어려움이 있습니다. 모델이 커질수록 필요한 메모리가 크게 늘어납니다. 그래서 노드가 적을 때는 두 가지 상황이 생깁니다. 모델이 아예 올라가지 않거나, 올라가더라도 GPU 메모리 한계 가까이에서 돌아가느라 효율이 떨어집니다(예를 들어 노드 4개에서 학습하는 80B 파라미터 모델을 보세요).
- 마지막으로, 저희 벤치마크는 성능이 구현 품질에 얼마나 크게 좌우되는지 보여 줍니다. 두 병렬화 전략을 처음 구현했을 때는 텐서 병렬화가 파이프라인 병렬화보다 성능이 좋았습니다. PP 코드를 최적화하고 나서는 PP가 더 빨라졌습니다. 지금은 TP 구현에서 통신 겹치기를 개선하고 있으니, TP가 성능 우위를 되찾으리라 기대합니다.
벤치마크에서 얻은 교훈
이 책의 목표는 이론과 구현을 이야기하는 데 그치지 않고 실제 데이터도 함께 보여 드리는 것이었습니다. 그래서 계획은 단순했습니다. 모든 모델과 여러 클러스터 크기에서 가능한 분산 구성을 전부 돌려 보자는 것이었지요. 불가능한 구성을 빼고도 여전히 수천 번의 실험을 돌려야 했습니다.
말로는 꽤 쉬워 보입니다. 클러스터에 대량의 작업 배열을 손쉽게 띄울 수 있으니까요. 하지만 첫 실험 묶음을 띄우자마자 고생이 시작되었습니다.
- PyTorch 프로세스가 가끔 제대로 정리되지 않았습니다.
- Slurm 작업 관리자가 작업을 강제로 종료해 노드 장애로 이어졌습니다.
- 몇 분이면 끝나야 할 간단한 벤치마크가 몇 시간씩 늘어졌습니다.
- 어떤 작업은 끝없이 멈춰 있었습니다.
정해진 시간 안에 모든 실험을 돌리려면 추가 엔지니어링이 필요했고, 결국 다음과 같은 일에 상당한 시간을 쏟았습니다.
- 클러스터 재시작 시간을 최소화하고 유휴 시간을 최적화하기
- 자세한 NCCL 디버그 로그 분석하기
- 메모리 사용 패턴과 CUDA 메모리 할당자의 동작 이해하기
- 다중 노드 환경에서 파이프라인 병렬화 성능 개선하기
이런 어려움을 겪으며 분산 학습 인프라가 얼마나 복잡한지 톡톡히 배웠습니다. 이론으로는 단순해 보이는 일도 실제로는 맞물려 돌아가는 수많은 부분을 세심하게 살펴야 할 때가 많습니다.
이론상의 결과를 현실에서 재현하기란 어렵습니다. 프로덕션 수준의 학습 코드를 구하기 어렵다는 점을 생각하면 더욱 그렇습니다. 저희는 Nanotron과 Picotron 같은 오픈 소스 프로젝트로 분산 학습 기법을 더 많은 사람이 쓸 수 있게 돕고, 연구자와 실무자가 하드웨어 자원을 최대한 활용할 수 있는 단순하고 효율적인 코드베이스를 함께 만들어 가기를 바랍니다.
이것으로 5D 병렬화의 분산 방법을 아주 깊이 파고든 여정을 마칩니다.
한 걸음 물러나 보면, 지금까지의 논의는 중요한 가정 하나에 기댈 때가 많았습니다. 바로 GPU에서 계산과 통신을 계산 처리량에 아무 영향 없이 효율적으로 겹칠 수 있다는 가정입니다. 현실은 그보다 미묘합니다. NCCL send/recv 같은 흔한 통신 프리미티브를 쓰면, 계산 자원과 통신 자원 사이에 숨은 경합이 생깁니다. 통신 커널도 대개 계산에 쓰이는 것과 같은 GPU 스트리밍 멀티프로세서(SM, 다음 절에서 다룹니다)를 쓰기 때문입니다. 그래서 통신을 계산과 겹치면 처리량이 떨어집니다. 분산 학습을 제대로 최적화하려면 GPU 아키텍처 자체를 더 깊이 파고들어야 합니다.
이제 불을 끄고 CUDA 모드를 켤 시간입니다!
GPU 깊이 들여다보기: 융합, 스레딩, 혼합
🎧 소리 파일(원문에서 듣기): NotebookLM 진행자들이 이 책의 다음 절들을 두고 나누는 팟캐스트 오디오(GPU Deep Dive: Optimizing Model Performance and Memory Efficiency)
읽는 동안 팟캐스트를 듣는 기분을 더하고 싶다면, NotebookLM 진행자들이 이 책의 다음 절들을 두고 나누는 이야기를 함께 들어 보세요.
지금까지는 모델 연산을 큰 틀에서 어떻게 짜는지에 초점을 맞춰 이야기했습니다. 전반적인 메모리 제약과 연산 장치의 상위 수준 스케줄링을 고려하면서 여러 가속기에 계산을 이리저리 옮겨 보았지요.
하지만 그러느라 모델 연산이 각 GPU에서 어떻게 스케줄링되고 수행되는지 꼼꼼히 이해하면 할 수 있는, 훨씬 낮은 수준의 최적화는 모두 빠뜨렸습니다.
이 절에서는 GPU 아키텍처를 자세히 파고듭니다. 특히 NVIDIA의 GPU 아키텍처를 중심으로 보겠지만, 흔히 그렇듯 전반적인 개념은 비슷한 가속기에도 그대로 쓸 수 있습니다.
먼저 GPU가 어떻게 구성되어 있는지 간단히 설명한 다음, FlashAttention이 일으킨 혁명, GPU에서 작업을 효율적으로 스케줄링하는 방법, 그리고 GPU에서 여러 정밀도를 효율적으로 쓰는 방법을 다루겠습니다.
GPU 입문
GPU는 대체로 아주 계층적으로 구성되어 있습니다. 연산 쪽에서 보면, GPU는 스트리밍 멀티프로세서라는 연산 장치가 여럿 늘어선 배열로 이루어져 있습니다. SM 하나하나는 코어라고도 부르는 스트리밍 프로세서 여러 개를 품고 제어합니다. 예를 들어 NVIDIA H100 GPU에는 SM이 132개 있고 SM마다 코어가 128개 있어서 코어가 모두 16,896개입니다(자세한 내용은 텐서 코어 문서를 참고하세요). 코어 하나하나는 여러 스레드를 동시에 처리할 수 있습니다.
[그림: GPU의 연산 계층 구조(SM과 코어). 출처는 codingconfessions 블로그 글(blog.codingconfessions.com/p/gpu-computing)입니다. 원출처에서 재사용을 허락하는 라이선스 표시를 찾지 못해 싣지 않았습니다. 원문에서 볼 수 있습니다.]
메모리 쪽도 여러 층의 캐시와 메모리로 이루어진 아주 계층적인 구조입니다. 레지스터는 가장 작은 단위로, 실행 중에 각 스레드만 쓰는 전용 공간입니다. 공유 메모리와 L1 캐시는 한 SM에서 도는 스레드끼리 함께 씁니다. 그 위에는 모든 SM이 함께 쓰는 L2 캐시가 있고, 마지막으로 전역 메모리가 있습니다. 전역 메모리는 GPU에서 가장 큰 메모리이지만(예를 들어 H100 사양에 적힌 80GB가 바로 이것입니다), 접근하고 조회하는 속도도 가장 느립니다.
[그림: GPU의 메모리 계층 구조. 출처는 YouTube 강연(youtube.com/watch?v=ZQKMZIP3Fzg)입니다. 원출처에서 재사용을 허락하는 라이선스 표시를 찾지 못해 싣지 않았습니다. 원문에서 볼 수 있습니다.]
GPU를 쓸 때의 목표는 이처럼 계층적으로 짜인 연산 자원과 메모리 자원을 잘 활용해서, 가용 코어에서 최대한 많은 작업을 병렬로 돌리는 것입니다.
GPU 코어에서 실행되는 코드 조각을 커널이라고 합니다. 커널은 예를 들어 CUDA나 Triton으로 고수준에서 작성한 뒤, NVIDIA GPU가 쓰는 저수준 어셈블리인 PTX(Parallel Thread Execution)로 컴파일합니다.
커널을 실행하려면 호스트 코드도 있어야 합니다. 호스트 코드는 CPU, 곧 호스트에서 실행되며, 데이터를 담을 메모리를 할당하고 데이터와 코드를 불러오는 일을 맡습니다:
// Host code
void vecAdd(float* h_A, float *h_B, float *h_c, int n) {
    // Allocate vectors in device memory
    int size = n * sizeof(float);
    float *d_A, *d_B, *d_C;
    cudaMalloc(&d_A, size);
    cudaMalloc(&d_B, size);
    cudaMalloc(&d_C, size);

    // Copy vectors from host memory to device memory
    cudaMemcpy(d_A, h_A, size, cudaMemcpyHostToDevice);
    cudaMemcpy(d_B, h_B, size, cudaMemcpyHostToDevice);

    // Invoke kernel
    int threadsPerBlock = 256;
    int blocksPerGrid =
            (N + threadsPerBlock - 1) / threadsPerBlock;
    VecAdd<<<blocksPerGrid, threadsPerBlock>>>(d_A, d_B, d_C, N);

    // Copy result from device memory to host memory
    // h_C contains the result in host memory
    cudaMemcpy(h_C, d_C, size, cudaMemcpyDeviceToHost);

    // Free device memory
    cudaFree(d_A);
    cudaFree(d_B);
    cudaFree(d_C);
}
두 벡터를 더하는 CUDA 커널의 호스트 코드입니다. 다음 두 곳의 코드를 바탕으로 고쳤습니다: https://docs.nvidia.com/cuda/cuda-c-programming-guide/ , https://blog.codingconfessions.com/p/gpu-computing
// Device code
__global__ void VecAdd(float* A, float* B, float* C, int N)
{
    int i = blockDim.x * blockIdx.x + threadIdx.x;
    if (i < N)
        C[i] = A[i] + B[i];
}
벡터 덧셈 커널의 정의가 담긴 디바이스 코드입니다. 다음 두 곳의 코드를 바탕으로 고쳤습니다: https://docs.nvidia.com/cuda/cuda-c-programming-guide/ , https://blog.codingconfessions.com/p/gpu-computing
커널 스케줄링은 대개 다음과 같이 이루어집니다:
- 스레드는 워프 단위로 묶이며, 워프 하나에는 스레드가 32개 들어 있습니다. 한 워프의 모든 스레드는 동기화되어 명령어를 동시에 실행하지만, 저마다 데이터의 다른 부분을 처리합니다.
- 워프는 크기를 더 유연하게 정할 수 있는 더 큰 블록으로 묶이고(예를 들어 블록 하나에 스레드가 512개나 1,024개 들어갈 수 있습니다), 블록 하나는 SM 하나에 배정됩니다. SM 하나가 여러 블록을 병렬로 돌릴 수도 있습니다. 다만 가용 자원에 따라 모든 블록이 곧바로 실행에 배정되지는 않을 수 있으며, 일부 블록은 자원이 더 생길 때까지 대기열에서 기다리기도 합니다.
여기서 꼭 기억할 점은, GPU 아키텍처를 가장 효율적으로 쓰려면 고려해야 할 크기 제약과 할당 제약이 여럿 있다는 것입니다(여러 메모리의 크기, 동시에 실행되는 블록 수와 워프의 스레드 수).
대부분의 경우에는 이렇게까지 세세한 수준으로 내려갈 필요가 없고, 커뮤니티의 다른 사람들이 만들어 둔 커널과 코드를 가져다 쓰면 됩니다. 그래도 커널 작성을 시작할 때 도움이 될 몇 가지 팁은 알려 드리겠습니다!
커널로 성능 높이기
최적화된 커널이 없는 새 연산을 추가하거나 기존 PyTorch 함수를 빠르게 만들고 싶다면, 커널을 처음부터 작성하는 것이 가장 직접적인 방법처럼 보일 수 있습니다. 하지만 고성능 CUDA 커널을 처음부터 만들려면 경험이 아주 많이 필요하고, 학습 곡선도 가파릅니다. 보통은 torch.compile을 활용해 시작하는 편이 더 낫습니다. torch.compile은 여러분이 작성한 연산을 포착한 뒤 Triton으로 더 낮은 수준의 고성능 커널을 만들어 PyTorch 코드를 동적으로 최적화합니다.
예를 들어 ELU(Exponential Linear Unit) 활성화 함수의 커널을 작성하고 싶다고 해 봅시다:
먼저 간단한 PyTorch 구현을 작성한 다음, 그 위에 @torch.compile 데코레이터만 붙이면 됩니다:
@torch.compile
def elu(x, alpha=1.0):
    return torch.where(x < 0, alpha * (torch.exp(x) - 1), x)
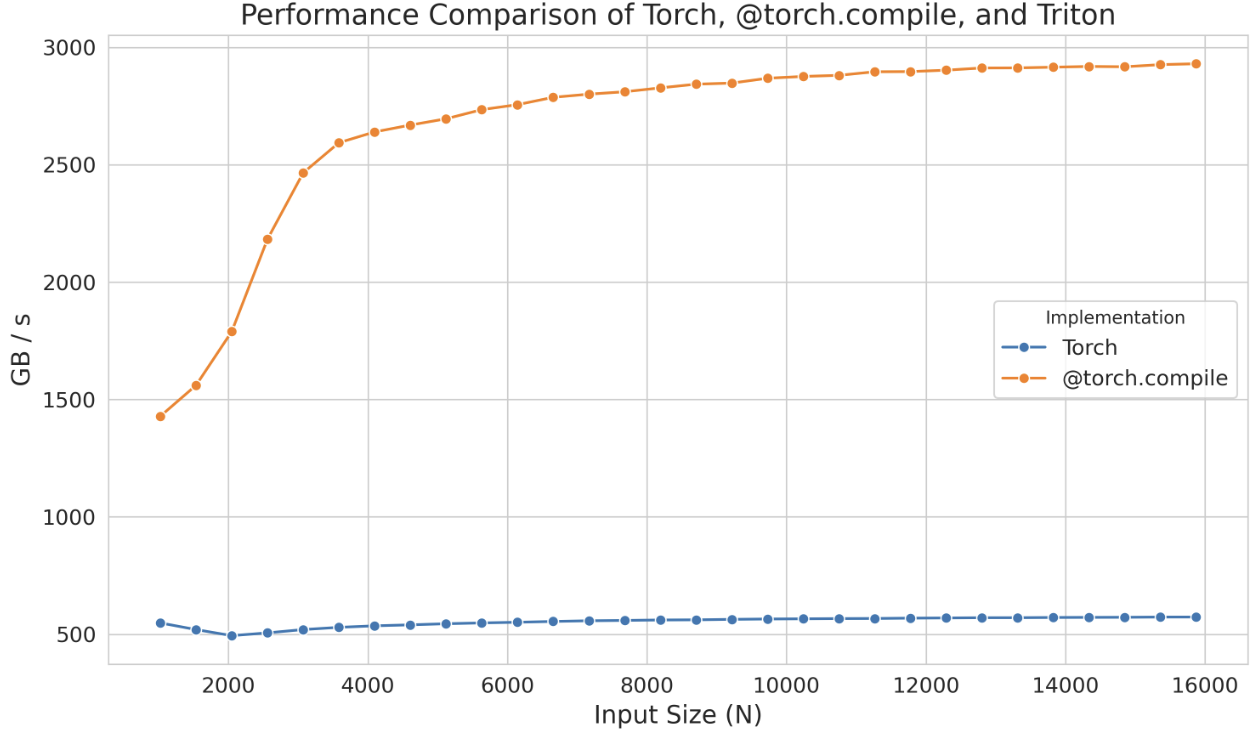
다음 그래프에서 보듯, 컴파일한 버전과 컴파일하지 않은 버전의 성능 차이는 놀라울 만큼 큽니다. 데코레이터 하나만 붙였을 뿐이라는 점을 생각하면 더욱 그렇습니다(여기서 은 열의 개수입니다):
하지만 이 정도 성능 향상으로 부족하다면 Triton 커널을 직접 구현해 볼 수 있습니다. 출발점으로는 @torch.compile이 생성한 Triton 커널을 살펴보면 좋습니다. 그러려면 환경 변수 TORCH_LOGS를 "output_code"로 설정하기만 하면 됩니다:
export TORCH_LOGS="output_code"@torch.compile 데코레이터를 붙인 Python 스크립트를 실행하면 그에 해당하는 Triton 커널이 생성되어 출력됩니다. 이 경우에는 다음과 같습니다:
@triton.jit
def triton_(in_ptr0, out_ptr0, xnumel, XBLOCK : tl.constexpr):
    xnumel = 100000000
    xoffset = tl.program_id(0) * XBLOCK
    xindex = xoffset + tl.arange(0, XBLOCK)[:]
    xmask = xindex < xnumel
    x0 = xindex
    tmp0 = tl.load(in_ptr0 + (x0), xmask)
    tmp1 = 0.0
    tmp2 = tmp0 < tmp1
    tmp3 = tl_math.exp(tmp0)
    tmp4 = 1.0
    tmp5 = tmp3 - tmp4
    tmp6 = tl.where(tmp2, tmp5, tmp0)
    tl.store(out_ptr0 + (x0), tmp6, xmask)
읽기 쉽게 하려면 아래처럼 변수 이름을 바꾸고, 주석을 달고, 조금씩 손보면 됩니다(아니면 LLM에게 대신 해 달라고 해도 됩니다):
@triton.jit
def elu_kernel(input_ptr, output_ptr, num_elements, BLOCK_SIZE: tl.constexpr):
    # Calculate the starting index for this block
    block_start = tl.program_id(0) * BLOCK_SIZE
    # Create an array of indices for this block
    block_indices = block_start + tl.arange(0, BLOCK_SIZE)[:]
    # Create a mask to ensure only valid indices are processed
    valid_mask = block_indices < num_elements
    # Load input values from the input pointer based on valid indices
    input_values = tl.load(input_ptr + block_indices, valid_mask)
    # Define the ELU parameters
    zero_value = 0.0  # Threshold for ELU activation
    negative_mask = input_values < zero_value
    exp_values = tl.math.exp(input_values)
    # Define the ELU output shift
    one_value = 1.0
    shifted_exp_values = exp_values - one_value

    output_values = tl.where(negative_mask, shifted_exp_values, input_values)

    # Store the computed output values back to the output pointer
    tl.store(output_ptr + block_indices, output_values, valid_mask)
여기서 tl.program_id(0)은 고유한 블록 ID를 주며, 이 ID로 그 블록이 데이터의 어느 구간을 처리할지 정합니다. 이 블록 ID를 써서 block_start는 블록마다 맡은 구간의 시작 인덱스를 계산하고, block_indices는 그 구간 안의 인덱스 범위를 지정합니다. valid_mask는 num_elements 안에 드는 인덱스만 처리되게 해서 tl.load로 데이터를 안전하게 불러오도록 합니다. 그다음 ELU 함수를 적용해 값이 음수인지에 따라 값을 바꾸고, 그 결과를 tl.store로 메모리에 다시 씁니다.
생성된 커널을 triton.testing.Benchmark로 벤치마크하면 성능은 다음과 같습니다:
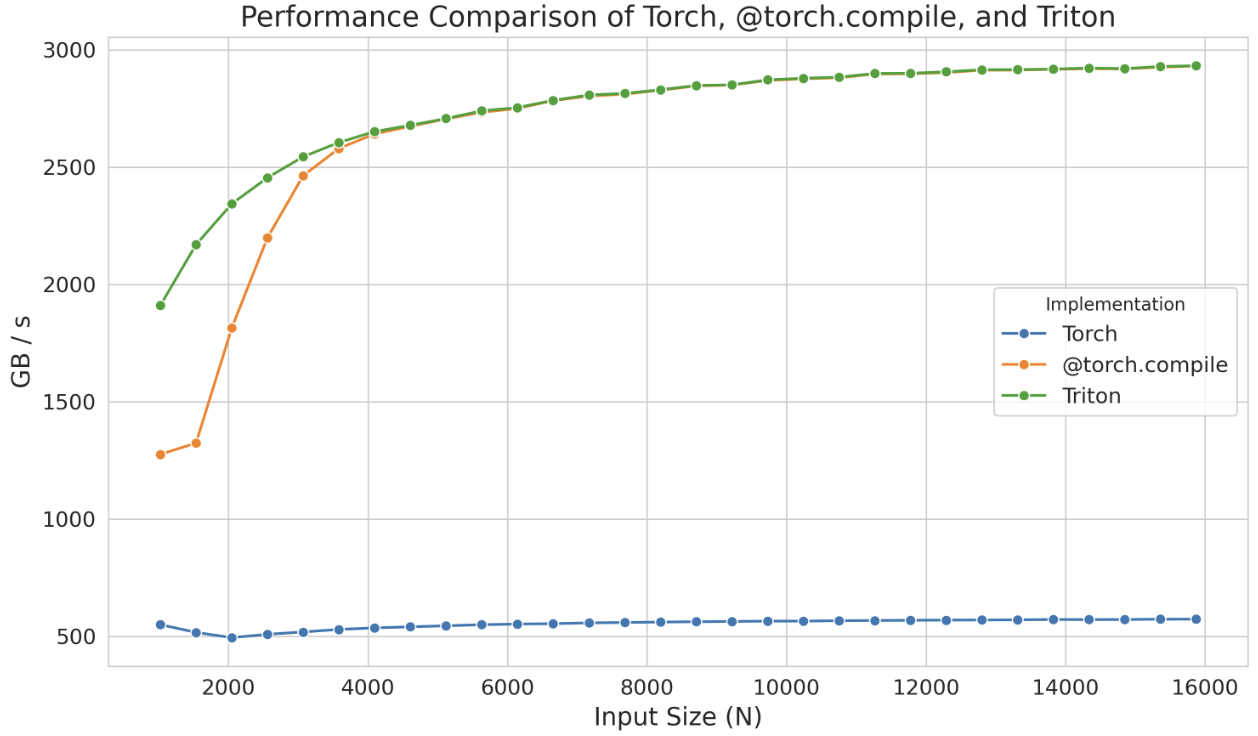
이 독립 커널은 크기가 작을 때 @torch.compile보다 성능이 더 좋기까지 하지만, 이는 아마 torch.compile의 컴파일 시간 때문에 생긴 착시일 것입니다. 어쨌든 처음부터 시작하는 대신 이렇게 생성된 커널에서 출발해 성능 최적화에만 집중할 수 있다는 점을 기억해 두세요. 시간을 크게 아낄 수 있습니다.
Triton으로도 장치의 최대 성능을 다 끌어내지 못할 때가 있습니다. 공유 메모리나 스트리밍 멀티프로세서 안의 스케줄링 같은 저수준 세부 사항을 다루는 데 언어 자체의 한계가 있기 때문입니다. Triton이 다룰 수 있는 것은 블록, 그리고 블록을 여러 SM에 스케줄링하는 일까지입니다. 더 깊이 제어하려면 CUDA로 커널을 직접 구현해야 하며, CUDA에서는 밑바탕의 저수준 세부 사항에 모두 접근할 수 있습니다.
CUDA에서는 커널의 효율을 높이는 여러 기법을 쓸 수 있습니다. 여기서는 그중 몇 가지, 곧 메모리 접근 패턴을 최적화해 지연 시간을 줄이는 방법, 자주 접근하는 데이터를 공유 메모리에 저장하는 방법, 스레드별 작업량을 관리해 유휴 시간을 최소화하는 방법만 다루겠습니다.
CUDA 예제로 더 깊이 들어가기 전에, GPU에서 명령어를 실행할 커널 코드를 작성하는 도구로 지금까지 살펴본 것들을 정리해 보겠습니다:
- PyTorch: 쉽지만 느림
@torch.compile: 쉽고 빠르지만 유연하지 않음- Triton: 더 어렵지만, 더 빠르고 더 유연함
- CUDA: 가장 어렵고, 가장 빠르고, 가장 유연함(제대로만 한다면)
CUDA를 가장 자주 쓰는 용도 가운데 하나인 메모리 접근 최적화부터 살펴보겠습니다. GPU의 전역 메모리(앞에서 보았듯 가장 큰 메모리 영역입니다)는 캐시에 비해 지연 시간이 길고 대역폭이 낮아서, 많은 애플리케이션에서 큰 병목이 됩니다. 전역 메모리의 데이터에 효율적으로 접근하면 성능을 크게 높일 수 있습니다.
메모리 병합
전역 메모리의 대역폭을 제대로 활용하려면 그 구조를 꼭 이해해야 합니다. CUDA 장치에서 전역 메모리는 DRAM으로 구현됩니다.
메모리 병합은 메모리 주소에 접근할 때마다 DRAM이 데이터를 버스트 단위로 한꺼번에 내보낸다는 점을 활용합니다. DRAM의 한 위치에 접근할 때마다, 요청한 위치를 포함한 연속된 여러 위치를 DRAM 칩 안의 여러 센서가 병렬로 읽습니다. 이렇게 읽은 데이터는 버스트 하나로 프로세서에 빠르게 전달될 수 있습니다. CUDA에서 병합은 이 버스트 동작을 이용합니다. 워프(같은 명령어를 발맞춰 함께 실행하는 스레드 32개의 묶음)에 속한 스레드들이 연속된 메모리 위치에 접근하게 해서 메모리 접근 효율을 최대로 끌어올리는 것이지요. 예를 들어 스레드 0이 위치 에, 스레드 1이 에, 스레드 2가 에 접근하는 식이라면, GPU 하드웨어는 각 접근을 하나씩 따로 처리하지 않고 이 요청들을 병합해(하나로 합쳐) DRAM 버스트에 맞는 크고 효율적인 접근 요청으로 만듭니다.
행렬 곱셈을 예로 들어 보겠습니다. 단순하고 직관적으로 구현하면, 다음처럼 스레드 하나가 출력 행렬의 원소 하나를 계산하게 됩니다:
__global__ void matmul_naive(int M, int N, int K, const float *A, const float *B, float *C) {
    const uint x = blockIdx.x * blockDim.x + threadIdx.x;
    const uint y = blockIdx.y * blockDim.y + threadIdx.y;

    if (x < M && y < N) {
        float tmp = 0.0;
        for (int i = 0; i < K; ++i) {
            tmp += A[x * K + i] * B[i * N + y];
        }
        C[x * N + y] = tmp;
    }
}
Simon Boehm의 멋진 블로그 글에 실린, 이 커널을 훌륭하게 시각화한 그림입니다:
[그림: 단순한 행렬 곱셈 커널의 시각화. 출처는 Simon Boehm의 블로그 글(siboehm.com/articles/22/CUDA-MMM)입니다. 원출처에서 재사용을 허락하는 라이선스 표시를 찾지 못해 싣지 않았습니다. 원문에서 볼 수 있습니다.]
그런데 ncu 같은 도구로 이 커널을 프로파일링해 보면, 메모리 처리량이 낮고 메모리 접근이 병합되지 않는 등의 문제가 보입니다:

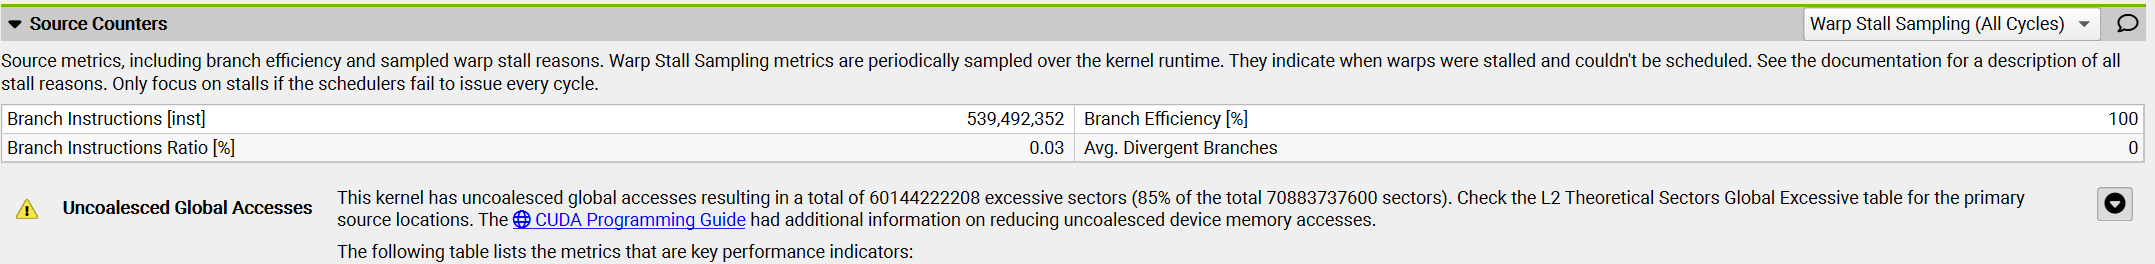
이유는 이렇습니다. 이 커널에서 같은 블록에 있는 스레드 ID (0, 0)과 (1, 0)인 두 스레드는(결국 같은 워프에 들어갑니다) 둘 다 행렬 B의 같은 열에서 값을 불러오지만, 행렬 A에서는 서로 다른 행을 불러옵니다. 행렬 원소는 행 우선 순서로 저장되므로(아래 그림처럼 한 행의 원소들이 연속된 메모리 주소에 놓인다는 뜻입니다), 첫 번째 반복인 에서 스레드 (0, 0)은 을, 스레드 (1, 0)은 을 불러옵니다. 이 원소들은 메모리에서 서로 가까이 저장되어 있지 않고, 이런 어긋남이 반복마다 생기므로 메모리 접근이 병합되지 못합니다.
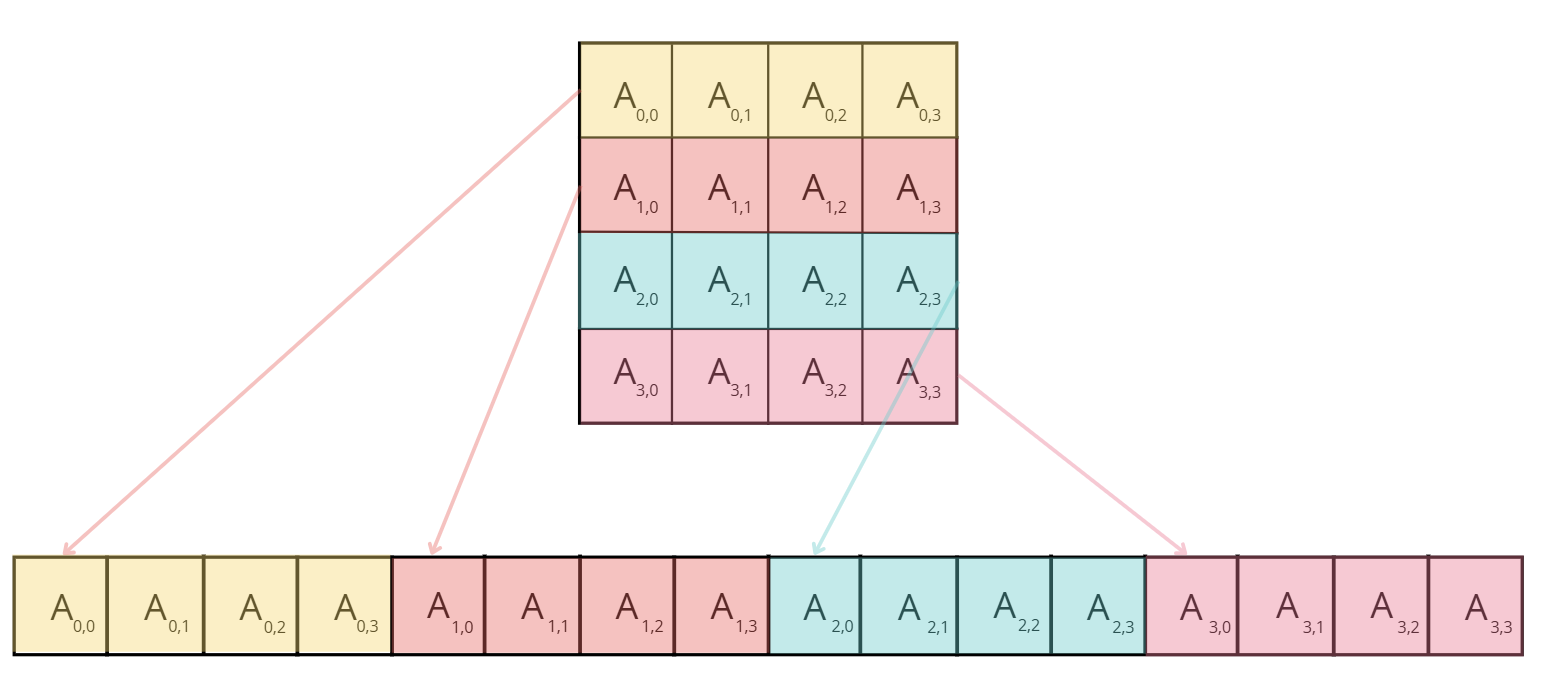
커널 성능을 높이려면 좌표 x와 y를 계산하는 방식을 다음과 같이 바꾸면 됩니다:
const int x = blockIdx.x * BLOCKSIZE + (threadIdx.x / BLOCKSIZE);
const int y = blockIdx.y * BLOCKSIZE + (threadIdx.x % BLOCKSIZE);

if (x < M && y < N) {
float tmp = 0.0;
for (int i = 0; i < K; ++i) {
    tmp += A[x * K + i] * B[i * N + y];
}
C[x * N + y] = tmp;
}
2D 블록 대신 1D 블록으로 바꾸고, x와 y 값을 구하는 방식을 새로 정했습니다. 이 새 방식에서는 같은 워프 안의 스레드들(threadIdx.x 값이 서로 가깝습니다)이 같은 x 값을 공유하고 y 값은 서로 다릅니다. 즉, 행렬 A에서는 같은 행을, 행렬 B에서는 서로 다른 열을 불러옵니다. 그 결과 행 우선 행렬에서 메모리 접근이 병합될 수 있습니다.
새 커널을 프로파일링하면 병합되지 않은 메모리 접근 경고가 사라지고 GPU의 메모리 처리량이 약 10배 늘어난 것을 볼 수 있습니다.

커널 실행 시간도 10분의 1로 줄어든 것을 볼 수 있습니다. 놀랍지요!
이제 문헌에서 자주 보게 될 또 다른 기법인 타일링을 다뤄 보겠습니다.
타일링
타일링은 공유 메모리를 활용해 메모리 접근 패턴을 최적화하는 기법입니다. 앞에서 말했듯이 GPU의 공유 메모리는 한 블록 안의 모든 스레드가 접근할 수 있는 작고 빠른 메모리 영역입니다. 공유 메모리를 쓰면 여러 스레드가 데이터를 재사용할 수 있어서, 더 느린 전역 메모리에서 데이터를 반복해 불러올 일이 줄어듭니다.
예를 들어 행렬 곱셈에서는 블록 안의 각 스레드가 두 행렬, 이를테면 A와 B의 원소가 필요할 수 있습니다. 각 스레드가 필요한 행과 열을 전역 메모리에서 저마다 따로 불러오면, 한 블록의 여러 스레드가 겹치는 데이터에 접근하므로 같은 데이터를 쓸데없이 여러 번 불러오게 됩니다. 대신 타일링을 쓰면 A와 B의 한 블록(곧 “타일”)을 공유 메모리에 딱 한 번만 불러오고, 해당 스레드 블록의 모든 스레드가 같은 공유 데이터를 재사용할 수 있습니다.
타일링 방식에서는 반복할 때마다 블록 안의 모든 스레드가 힘을 합쳐 타일 두 개(행렬 A에서 하나, 행렬 B에서 하나)를 공유 메모리로 불러옵니다. 구체적으로 스레드들은 행렬 A의 타일(BLOCK_SIZE_M × BLOCK_SIZE_K 크기)과 행렬 B의 타일(BLOCK_SIZE_K × BLOCK_SIZE_N 크기)을 불러옵니다. 타일이 공유 메모리에 올라오면 스레드들은 이 타일들로 행렬 곱셈을 수행합니다. 필요한 데이터에 모두 빠르게 접근할 수 있으니 계산이 효율적입니다. 타일 곱셈의 결과는 중간 결과를 담아 두는 누적 행렬에 저장합니다. 반복이 끝날 때마다 현재 타일 곱셈의 결과를 이 누적 행렬에 더하며, 두 행렬의 모든 타일을 다 처리할 때까지 이 과정을 이어 갑니다.
[그림: 타일링 방식의 행렬 곱셈 도식. 출처는 Cedric Nugteren의 튜토리얼(cnugteren.github.io/tutorial/pages/page4.html)입니다. 원출처에서 재사용을 허락하는 라이선스 표시를 찾지 못해 싣지 않았습니다. 원문에서 볼 수 있습니다.]
구현에서 꼭 이해해야 할 중요한 부분을 살펴보겠습니다:
// Set pointers to the starting elements
A += blockRow * TILE_SIZE * K; // Start at row = blockRow, column = 0
B += blockCol * TILE_SIZE; // Start at row = 0, column = blockCol
C += blockRow * TILE_SIZE * N + blockCol * TILE_SIZE; // Start at row = blockRow, column = blockCol
float sum = 0.0;
// The outer loop moves through tiles of A (across columns) and B (down rows)
for (int tileIdx = 0; tileIdx < K; tileIdx += TILE_SIZE) {
sharedA[localRow * TILE_SIZE + localCol] = A[localRow * K + localCol];
sharedB[localRow * TILE_SIZE + localCol] = B[localRow * N + localCol];

// Ensure all threads in the block have completed data loading
__syncthreads();

// Shift pointers to the next tile
A += TILE_SIZE;
B += TILE_SIZE * N;
// Compute the partial dot product for this tile
for (int i = 0; i < TILE_SIZE; ++i) {
    sum += sharedA[localRow * TILE_SIZE + i] * sharedB[i * TILE_SIZE + localCol];
}
// Synchronize again to prevent any thread from loading new data
// into shared memory before others have completed their calculations
__syncthreads();
}
C[localRow * N + localCol] = sum;각 스레드는 먼저 행렬 A와 행렬 B에서 원소를 하나씩 공유 메모리로 불러옵니다. 이 경우에는 병합된 메모리 접근을 쉽게 이룰 수 있습니다. threadIdx.x를 로컬 열 인덱스(localCol)로 정하면, 같은 워프 안의 스레드들이 두 행렬 모두에서 서로 이웃한 원소에 접근하게 됩니다. 블록 안의 모든 스레드가 자기 원소를 공유 메모리에 다 불러오고 나면(__syncthreads()를 호출해 이를 보장합니다), 두 타일의 내적을 계산합니다. 스레드들이 모든 타일을 다 돌고 나면(A는 가로 방향으로, B는 세로 방향으로), 그렇게 구한 합을 행렬 C의 해당 위치에 저장합니다.
이 커널을 ncu로 벤치마크해 보니, 메모리 처리량은 410 Gb/s로 늘고 커널 실행 시간은 약 43% 줄어, 약 6.6 TFLOPS의 성능을 냈습니다.
스레드 코어스닝
타일링 기법 덕분에 커널 성능이 크게 좋아졌습니다. 그런데 워프 상태(각 상태에서 사이클을 얼마나 썼는지 보여 주는 수치)를 분석해 보면 다음과 같은 결과가 나옵니다.
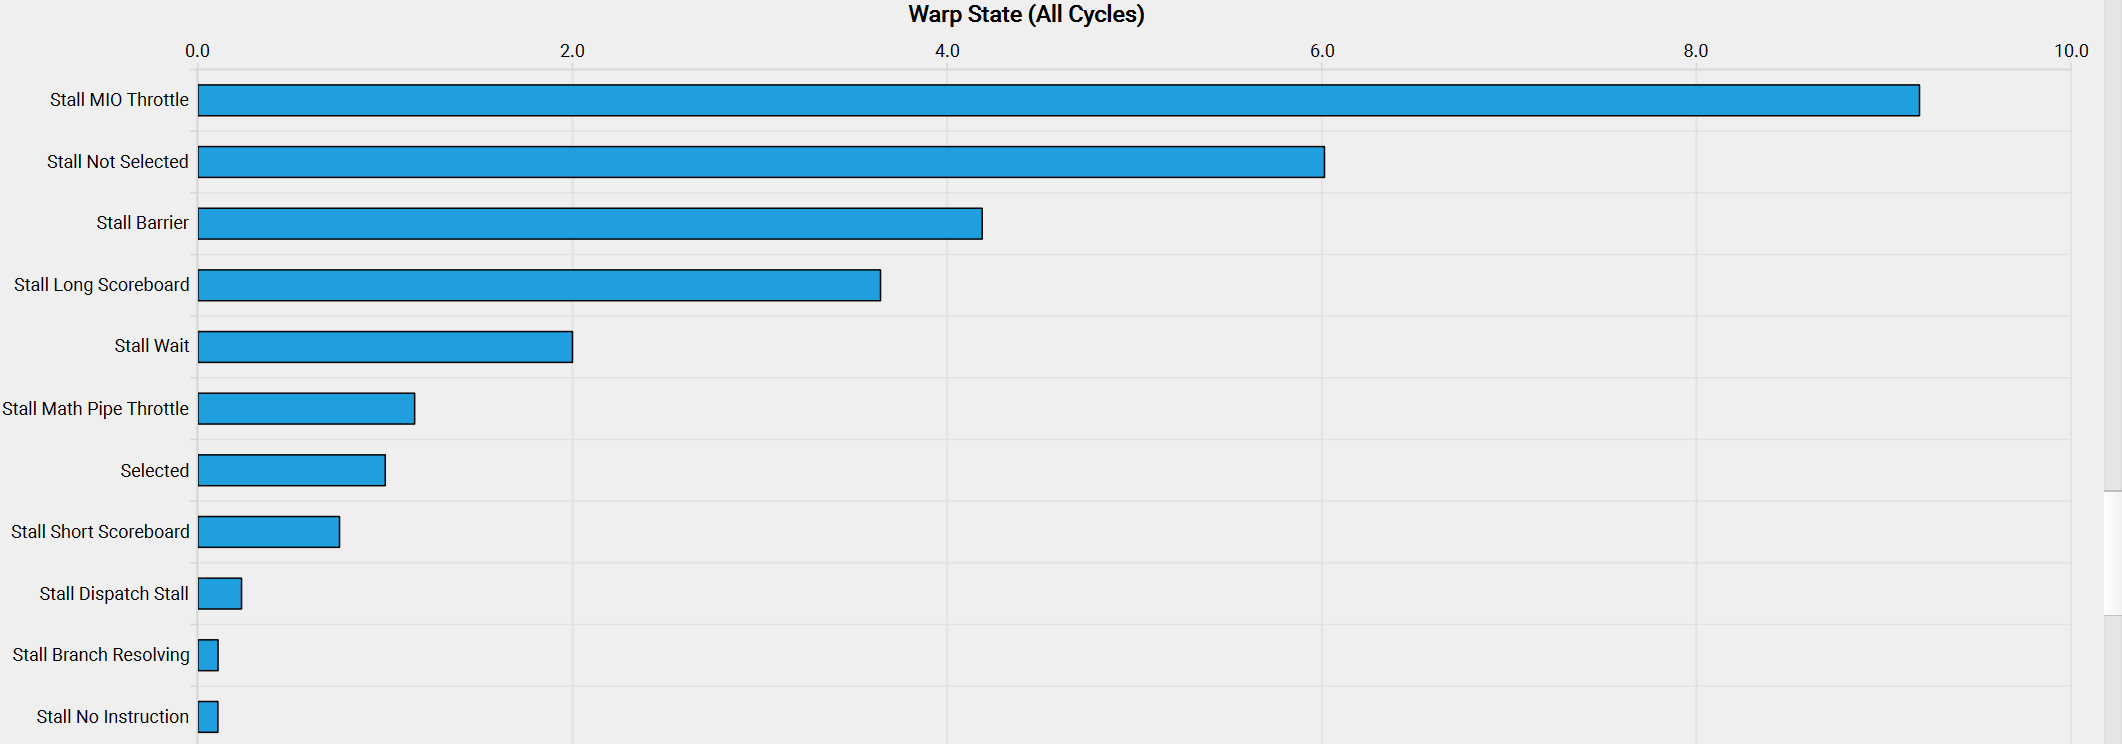
이 알쏭달쏭한 상태 이름들의 뜻은 NVIDIA의 커널 프로파일링 가이드의 “Warp Stall Reasons” 절에서 찾을 수 있습니다. 그 절에 따르면 smsp__pcsamp_warps_issue_stalled_mio_throttle는 다음과 같은 뜻입니다. “워프가 MIO(메모리 입출력) 명령어 큐에 빈자리가 나기를 기다리며 멈춰 있었습니다. 이 멈춤 원인은 MIO 파이프라인(특수 수학 명령어, 동적 분기, 공유 메모리 명령어 등)을 극도로 많이 쓸 때 높게 나타납니다. 공유 메모리 접근 때문이라면, 로드 횟수는 줄이고 한 번에 더 넓게 불러오도록 해 보면 파이프라인 부담을 줄일 수 있습니다.”
즉 워프들이 공유 메모리 접근 결과가 돌아오기를 기다리며 멈춰 있는 것 같습니다! 이 문제를 풀려면 스레드 코어스닝이라는 기법을 쓸 수 있습니다. 여러 스레드를 코어스닝된 스레드 하나로 합치는 방법입니다. 코어스닝된 스레드 하나가 출력 원소를 여러 개 맡을 수 있으므로, 공유 메모리 접근이 크게 줄어듭니다.
다음으로, 커스텀 커널을 작성하거나 개선할 때 중요하게 따져야 할 마지막 사항인 제어 분기 줄이기를 짧게 살펴보겠습니다.
제어 분기 줄이기
스트리밍 멀티프로세서는 워프 안의 모든 스레드를 단일 명령어 다중 데이터(Single Instruction, Multiple Data, SIMD) 모델로 실행하도록 만들어져 있습니다. 즉 어느 순간에든 명령어 하나를 가져와 워프 안의 모든 스레드에서 동시에 실행합니다. 워프가 실행될 때 그 안의 스레드들은 데이터의 서로 다른 부분을 다루지만 같은 명령어를 따릅니다(그래서 이름이 ‘단일 명령어, 다중 데이터’입니다). SIMD의 가장 큰 장점은 효율입니다. 명령어를 가져오고 배분하는 일을 맡은 제어 하드웨어를 여러 실행 유닛이 함께 씁니다. 이런 설계 덕분에 제어 기능에 드는 하드웨어 오버헤드가 최소로 줄고, 하드웨어의 더 많은 부분을 연산 처리량을 높이는 데 쓸 수 있습니다.
제어 분기는 같은 워프 안의 스레드들이 서로 다른 실행 경로를 탈 때 생깁니다. 예를 들어 if 문 같은 조건문 때문에 일부 스레드는 한 코드 블록을, 나머지 스레드는 다른 코드 블록을 실행하게 되면, 워프는 이 실행들을 차례로 하나씩 처리해야 하므로 다른 스레드가 끝나기를 기다리는 유휴 스레드가 생깁니다. 제어 분기를 줄이려면 같은 워프 안의 스레드들이 같은 실행 경로를 따르도록 커널을 설계해야 합니다. 분기가 줄도록 코드를 재구성하거나, 모든 스레드가 비슷한 실행 경로를 따르게 하는 자료 구조를 쓰거나, 프레디케이션 같은 기법을 쓰면 됩니다.
지금까지 커스텀 커널을 작성하고 GPU 연산의 성능과 메모리 사용량을 개선할 때 따져야 할 주요 사항 몇 가지를 다뤘습니다. 그런데 실제 예제로 넘어가기 전에 짚어야 할 중요한 개념이 하나 더 있습니다. 바로 커널 융합입니다.
융합 커널
이미 여러 곳에서 GPU와 CPU의 연산이 비동기로 돌아갈 수 있다고 말씀드렸습니다. 특히 CPU의 호스트 코드는 GPU에 작업을 논블로킹 방식으로 예약할 수 있습니다.
이 성질은 이 여정에서 여러 번 보았듯이 통신을 계산과 겹치는 데 쓸모가 있지만, 더 일반적인 아이디어로 넓힐 수도 있습니다. 바로 호스트와 GPU 커널 명령 사이를 오가는 일을 무슨 수를 써서라도 피하자는 것입니다.
Horace He가 이 도식들에서 이 아이디어를 멋지게 그려 냈습니다.
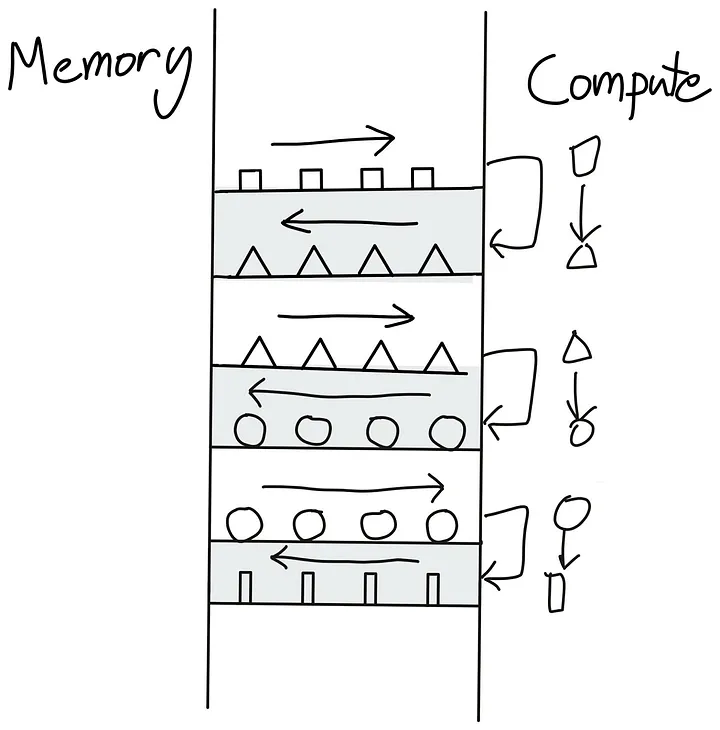
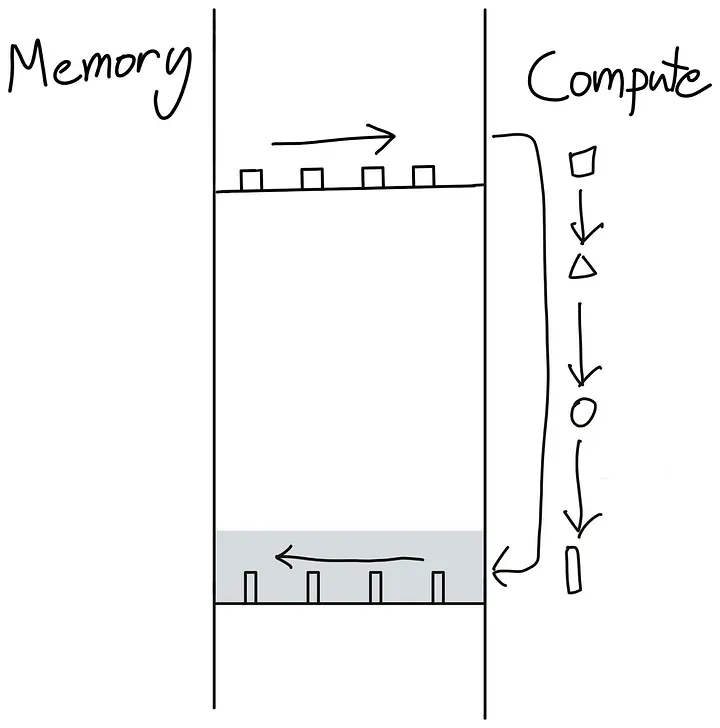
첫 번째 그림처럼 오가는 일을 어떻게 피할 수 있을까요? 가장 좋은 방법은 GPU를 최대한 자율적으로 만드는 것입니다. 그러려면 연속된 계산 연산을 가능한 한 많이 커널 하나에 묶어 GPU가 실행하게 하면 됩니다. 두 번째 그림에 보이는 이런 커널을 ‘융합 커널’이라고 부릅니다.
융합 커널은 입력 토큰마다 서로 독립적으로 수행되는 원소별 연산이 연달아 이어질 때 특히 효율적이고 작성하기도 쉽습니다. 이럴 때는 계산한 값을 전역 메모리로 돌려보냈다가 다시 SM 메모리로 옮기고 새 커널을 런치할 까닭이 없습니다. 모든 계산이 끝날 때까지 값을 모두 로컬에 두는 편이 훨씬 효율적입니다.
트랜스포머 모델에서는 LayerNorm 레이어의 계산처럼 원소별 연산이 연달아 나올 때마다 이 ‘융합’ 방식을 적용할 수 있습니다.
이제 커널 엔지니어링의 진정한 걸작에 감탄할 준비가 모두 끝났습니다. 바로 FlashAttention입니다.
FlashAttention
FlashAttention은 Tri Dao가 내놓은 기법으로, 커스텀 CUDA 커널을 작성해 어텐션 계산을 훨씬 빠르게, 그리고 메모리를 더 효율적으로 쓰도록 최적화합니다. FlashAttention의 핵심은 GPU의 여러 메모리를 효율적으로 써서, 가장 느린 메모리인 전역 메모리에 너무 많이 기대지 않는 것입니다.
최신 GPU의 전역 메모리는 흔히 고대역폭 메모리(High Bandwidth Memory, HBM)라는 기술을 씁니다. 이름과 달리 HBM은 GPU 메모리 계층에서 SRAM보다 느립니다. 이 HBM이라는 용어는 뒤에서 FlashAttention의 구현을 자세히 다룰 때 중요해집니다.
어텐션 메커니즘을 기본 방식대로 구현하면 메모리와 연산 유닛 사이에 데이터가 많이 오갑니다. S 행렬(S = QK^T, 어텐션 점수)과 P 행렬(P = softmax(S), 정규화된 어텐션 가중치)을 HBM에 실체화해야 하므로, 결과를 HBM으로 보냈다가 다음 계산을 위해 다시 SRAM으로 가져와야 합니다.
[그림: 기본 어텐션 구현에서 HBM과 SRAM 사이를 오가는 데이터. 원문에 출처 표기가 없지만, 바로 뒤 그림과 같은 FlashAttention 논문(arXiv 2205.14135) 그림으로 보입니다. 출처를 확정하지 못해 싣지 않았습니다. 원문에서 볼 수 있습니다.]
HBM은 대역폭이 훨씬 낮기 때문에, 이 방식은 어텐션 계산에 심각한 병목을 만듭니다. 더 잘할 수는 없을까요? Tri Dao는 할 수 있다고 말합니다!
핵심은 S 행렬을 SM의 더 작은 공유 메모리에 들어갈 만한 작은 조각으로 나눠 계산하는 것입니다. 하지만 여기서 더 나아가, 아주 큰 S 행렬을 아예 실체화하지 않고 소프트맥스의 정규화 계수를 계산하는 데 필요한 통계값만 남겨 둘 수도 있습니다. 그러면 중간 결과를 이리저리 옮기지 않고 의 일부를 SRAM 안에서 한 번에 바로 계산할 수 있습니다. 이렇게 하면 공유 메모리를 활용할 뿐 아니라, 모델에서 (컨텍스트가 길 때) 가장 큰 활성값 행렬 가운데 하나인 어텐션 행렬을 실체화하느라 생기던 메모리 병목도 풀립니다.
[그림: FlashAttention의 타일 단위 계산 방식. 출처는 FlashAttention 논문(arXiv 2205.14135)입니다. 논문의 arXiv 라이선스가 기본 배포 허락(nonexclusive-distrib)뿐이라 싣지 않았습니다. 원문에서 볼 수 있습니다.]
FlashAttention의 아이디어는 모델 학습의 수많은 병목을 해결해 주어서, 금세 모든 트랜스포머에서 어텐션을 수행하는 기본 방식이 되었습니다. 특히 다음과 같은 점이 두드러집니다.
- S 행렬을 실체화하지 않으므로 어텐션의 메모리 부담을 줄입니다.
- 또한 어텐션의 비용이 단순한 구현에서 미치던 영향의 상당 부분을 없앱니다.
트랜스포머 아키텍처가 나온 직후에 개발된 선형 어텐션의 여러 변형과, 어텐션을 근사하는 이차 미만 방식들은 대부분 정확하면서도 빠른 FlashAttention의 구현과 메커니즘에 밀려났습니다.
FlashAttention-1에 이어 같은 연구실에서 개선판 두 개를 차례로 내놓았습니다. FlashAttention-2와 -3입니다. FlashAttention-1과 비교하면 FlashAttention-2와 -3의 개선은 어텐션 메커니즘 전반보다는 저수준 구현을 GPU에 더 꼭 맞게 다듬는 데 있습니다. 구체적으로는 (1) 행렬 곱이 아닌 연산의 수를 최대한 줄이고, (2) 작업을 워프와 스레드 블록에 세심하게 나눠 맡기고(FlashAttention-2), (3) 최신 Hopper(H100) 아키텍처에서 FP8과 Tensor Core 지원에 맞춰 세심하게 최적화했습니다(FlashAttention-3).
FlashAttention은 현재 GPU 가속기의 내부 메모리와 연산 설계를 고려하면 얼마나 획기적인 개선을 얻을 수 있는지 더할 나위 없이 잘 보여 주는 사례입니다.
이 절에서 지금까지 다룬 기법들은 학습 속도를 높이려고 모델링 코드를 고치고 일부 연산에 커스텀 커널을 작성해야 했습니다.
계산 연산 자체를 저수준에서 파고드는 이 여정의 마지막 절에서는 모델링 코드와 무관한 여러 방법을 살펴보겠습니다. 이 방법들은 어떤 모델에든 쓸 수 있고, 워낙 널리 쓰여서 업계 표준이 되었습니다. 다음 주제는 바로 혼합 정밀도 학습입니다!
혼합 정밀도 학습
이 책의 여러 절에서 저정밀도 형식을 다루면서, 이 형식들이 활성값, 파라미터, 옵티마이저 상태를 저장하는 데 드는 메모리를 어떻게 바꾸는지 이야기했습니다. 이제 이 형식들을 더 자세히 들여다보고, 그 트레이드오프와 장점, 한계를 더 잘 이해할 차례입니다.
혼합 정밀도 학습은 이름 그대로 학습할 때 서로 다른 정밀도를 섞어 쓰는 방법입니다. PyTorch 텐서의 기본 수치 정밀도는 단정밀도 부동소수점 형식(FP32 또는 float32라고도 부릅니다)으로, 저장하는 수 하나하나가 32비트, 곧 4바이트를 차지합니다. 수를 나타내는 데 쓸 수 있는 비트는 세 부분으로 나뉩니다.
- 부호: 첫 비트로 수가 양수인지 음수인지 정합니다.
- 지수: 수의 크기를 조절합니다.
- 가수: 수의 유효숫자를 정합니다.
[그림: 부호, 지수, 가수로 나뉜 비트 구성. 위키백과 그림으로 보이지만 원문에 출처 표기가 없습니다. 출처를 확정하지 못해 싣지 않았습니다. 원문에서 볼 수 있습니다.]
부동소수점 수의 원리는 과학적 표기법을 떠올려 보면 쉽게 이해할 수 있습니다. 예를 들어 에서는 먼저 부호가 오고, 이어서 가수와 지수가 옵니다. 이렇게 하면 아주 다양한 크기의 수를, 크기에 맞춰 달라지는 정밀도로 나타낼 수 있습니다. float32가 기본값이긴 하지만, PyTorch에서는 여러 부동소수점 형식을 쓸 수 있습니다.
| 형식 | 전체 비트 수 | 부호 | 지수 | 가수 |
|---|---|---|---|---|
| float32 | 32 | 1 | 8 | 23 |
| float16 | 16 | 1 | 5 | 10 |
| bfloat16 | 16 | 1 | 8 | 7 |
| float8 (e4m3) | 8 | 1 | 4 | 3 |
| float8 (e5m2) | 8 | 1 | 5 | 2 |
전체 비트 수를 줄이는 데는 대가가 따르지만(여기에도 공짜 점심은 없습니다), 그 대가를 어떻게 치를지는 어느 정도 고를 수 있습니다. 가수 쪽 비트를 희생할 수도, 지수 쪽 비트를 희생할 수도 있습니다. 그래서 float8(FP8) 형식도 지수와 가수의 비트 수에 따라 이름 붙인 두 가지가 있어, 가장 알맞은 형식을 유연하게 고를 수 있습니다. 각 형식이 나타낼 수 있는 수의 범위를 살펴보겠습니다.
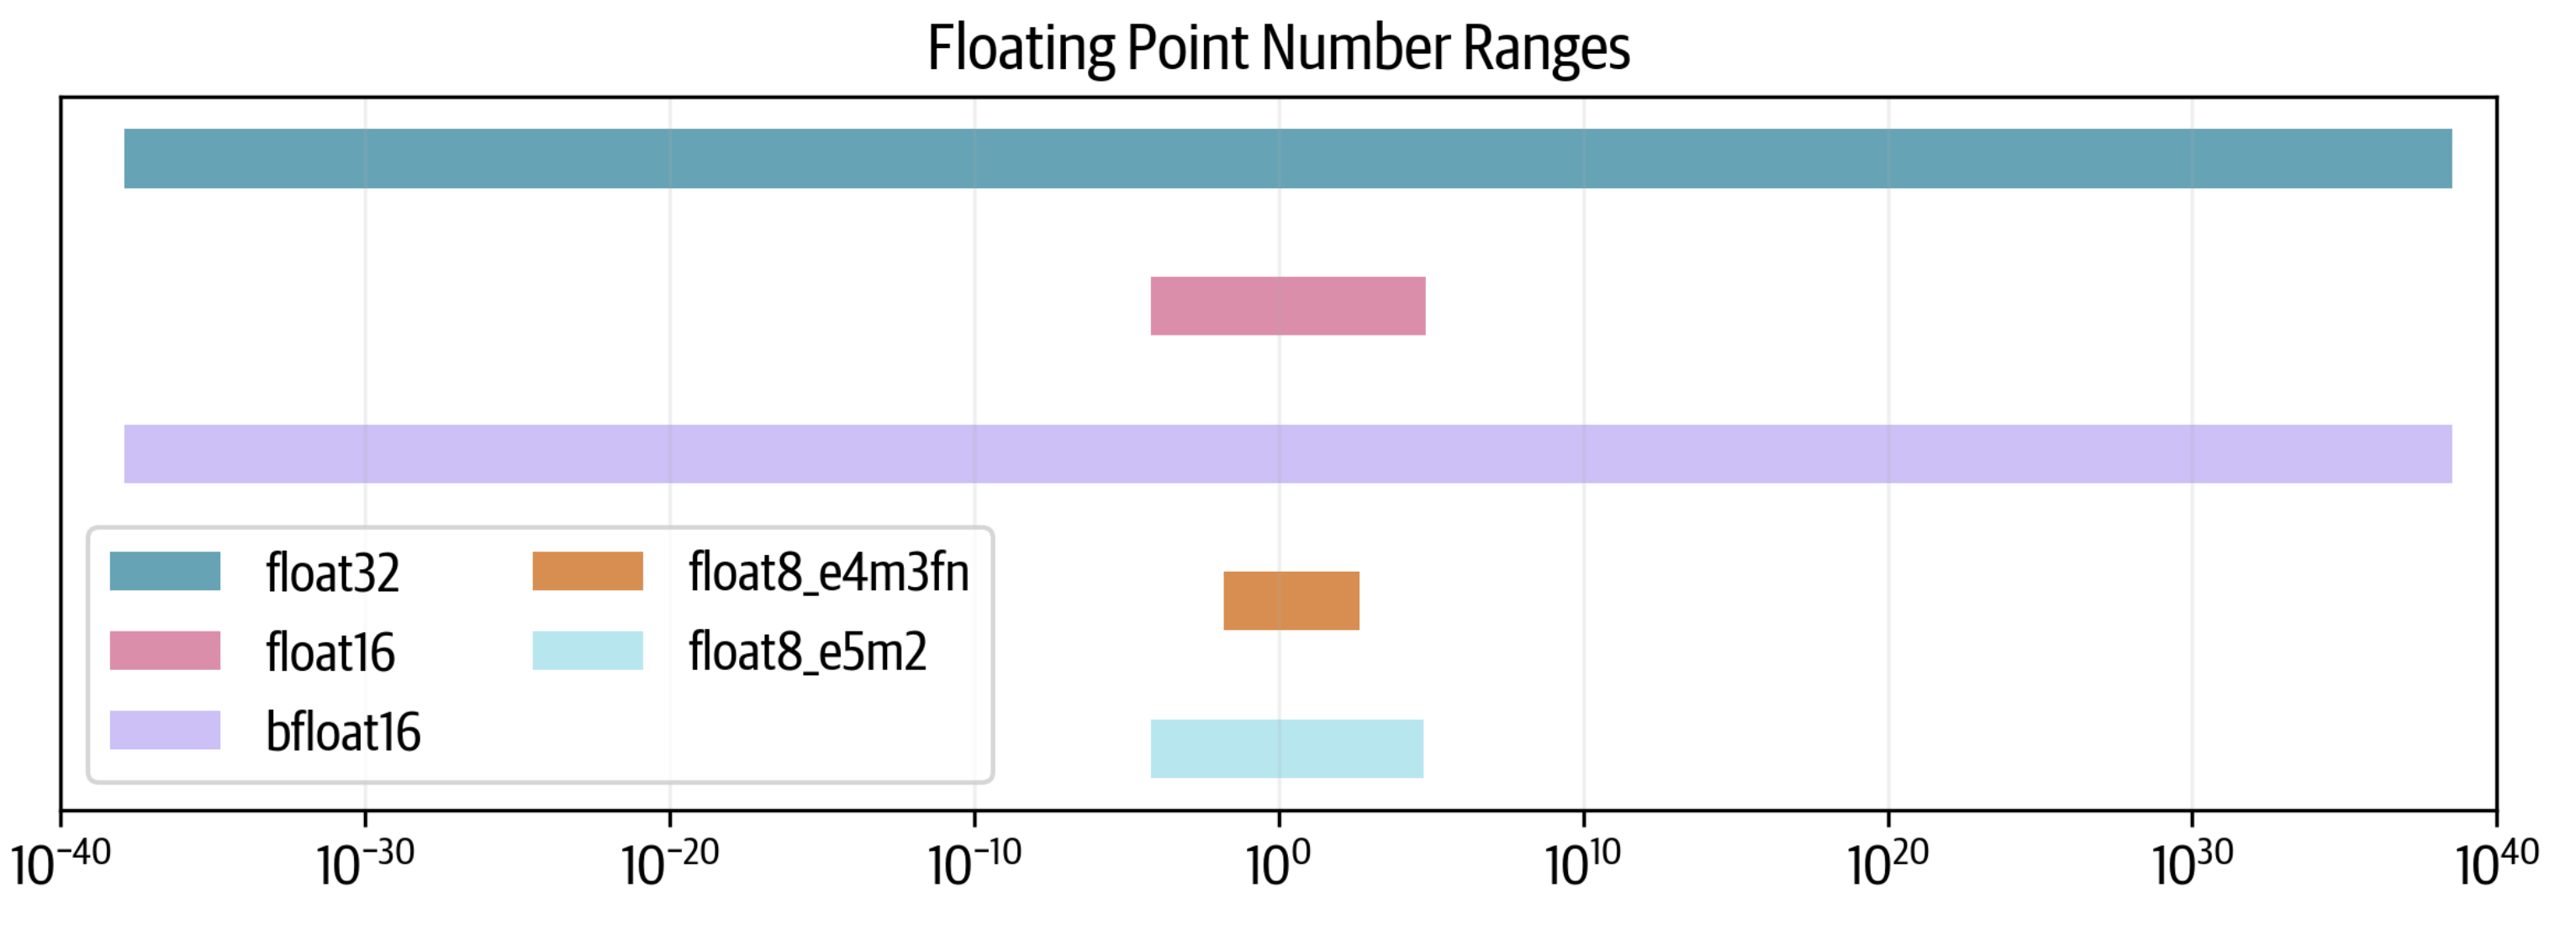
float32는 80자릿수에 걸친 범위를 아우르고, float16은 범위를 많이 희생하는 반면 bfloat16은 전체 범위를 그대로 유지합니다. 두 float8 형식은 범위를 더 줄입니다. e5m2는 float16의 범위를 유지할 수 있지만, e4m3는 범위가 그보다도 더 좁습니다.
어떤 형식은 전체 범위를 유지하는데 다른 형식은 왜 그러지 못할까요? 1과 2 사이에 점 10,000개를 찍어 각 형식의 해상도를 살펴보겠습니다. 각 점은 형식마다 나타낼 수 있는 가장 가까운 수로 반올림됩니다.
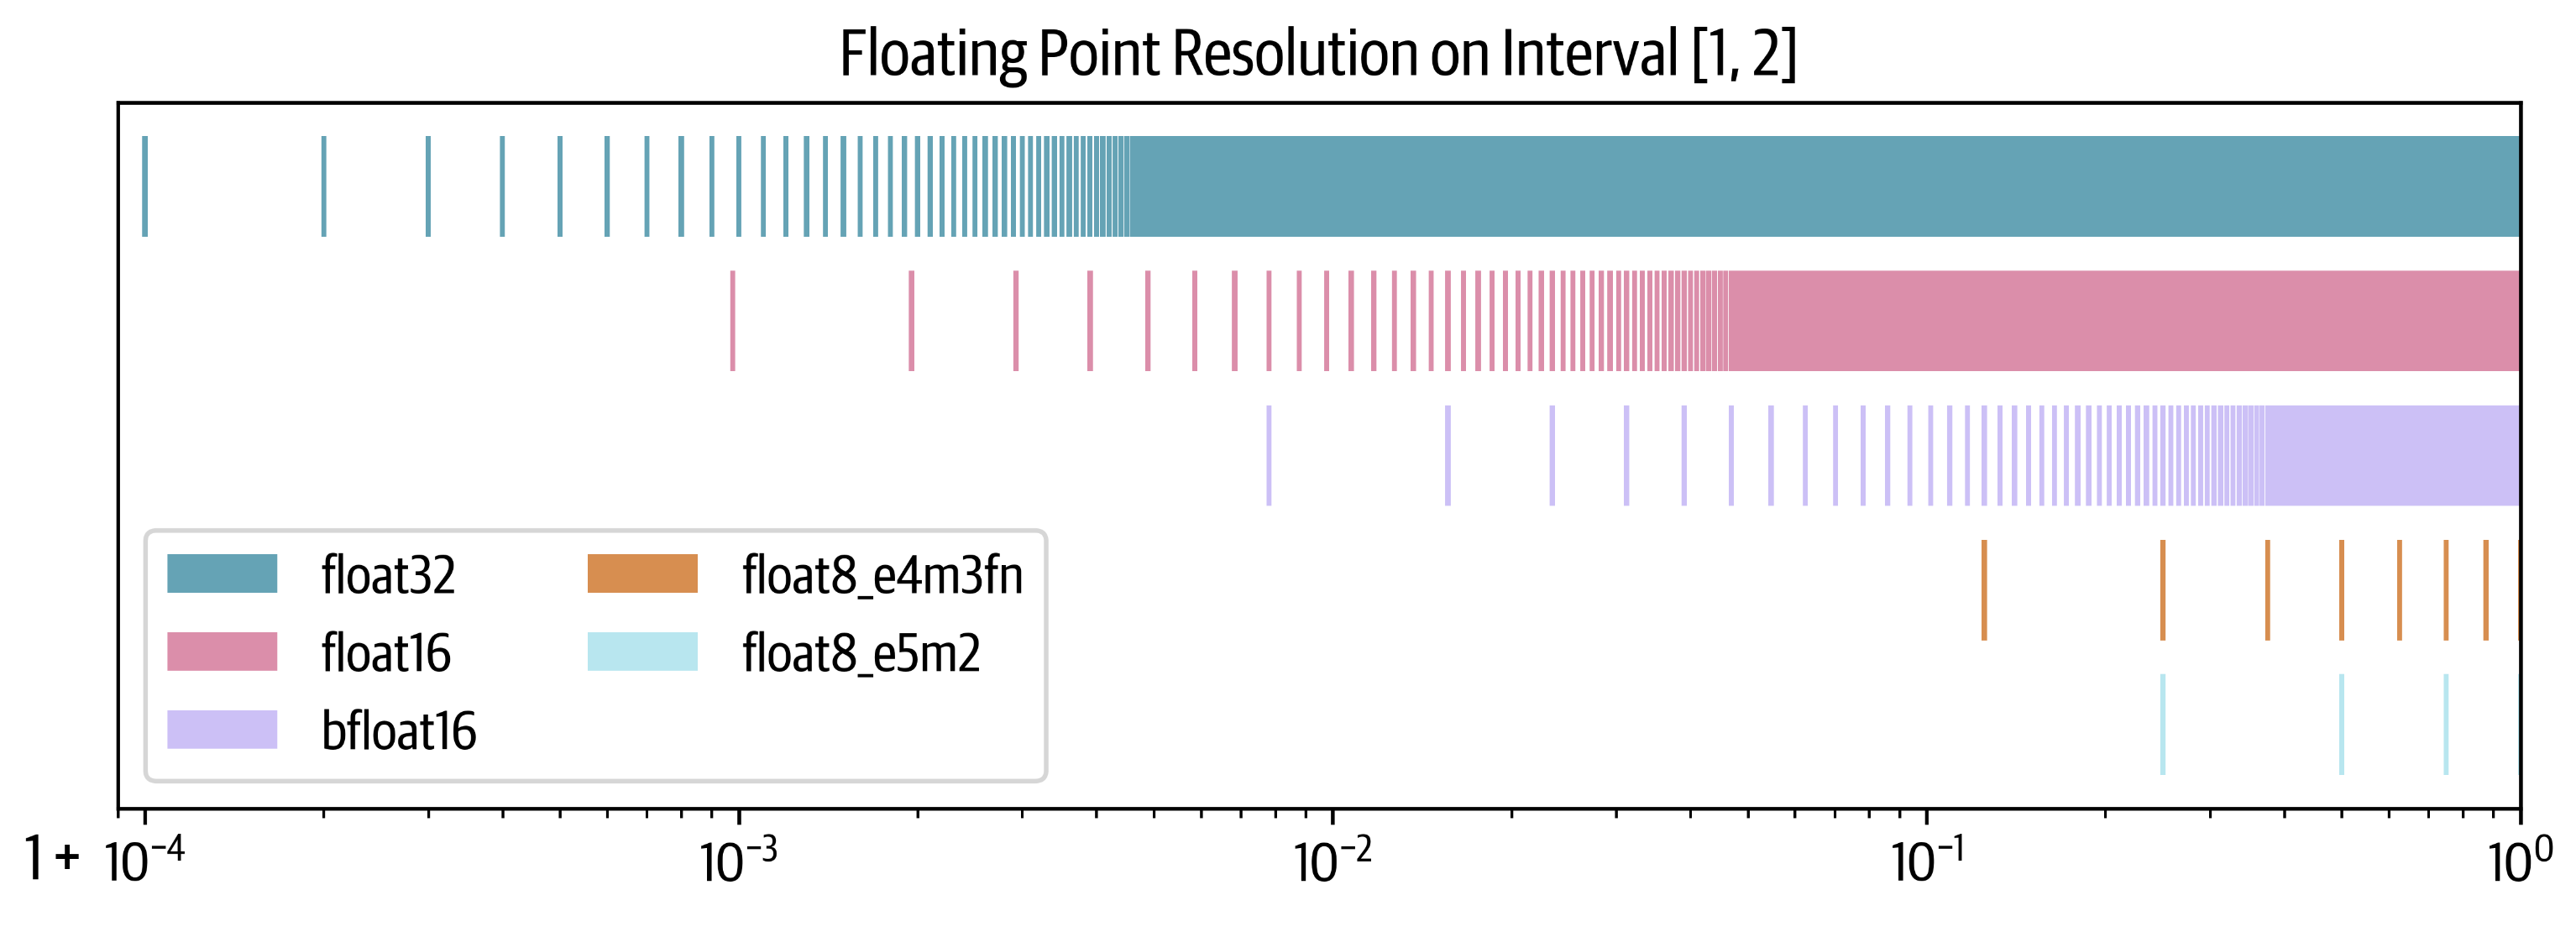
여기서 보듯 bfloat16은 (float16과 달리) float32의 범위를 유지하지만, 그 대가로 정밀도를 더 많이 희생합니다. float8은 상황이 더 심각합니다. 구간 [1,2]에서 e4m3는 수를 7개, e5m2는 3개밖에 나타내지 못합니다.
형식의 해상도를 재는 흔한 지표로 엡실론이 있습니다. 다음으로 나타낼 수 있는 첫 번째 수입니다. float32 형식에서는 가 상한임을 알 수 있습니다(실제로는 , 곧 1.19×10⁻⁷입니다). float16은 약 이고, bfloat16은 그보다도 10배 큽니다.
혼합 정밀도 학습의 아이디어는 전체 정밀도 학습의 성능은 유지하면서 일부 계산에 이런 저정밀도 형식을 쓰는 것입니다. 알고 보니 float32를 완전히 버릴 수는 없고, 대개 일부 계산은 전체 정밀도로 해야 합니다.
이제 16비트로 모델을 학습하는 방법을 살펴보고, 한 걸음 더 나아가 8비트까지 내려갈 수 있는지 알아보겠습니다.
FP16과 BF16 학습
안타깝게도 모든 텐서와 연산을 무작정 float16으로 바꾸면 잘 되지 않고, 대개 손실이 발산하고 맙니다. 하지만 최초의 혼합 정밀도 학습 논문3은 float32 학습에 맞먹는 결과를 내는 세 가지 요령을 내놓았습니다.
- 가중치의 FP32 사본: FP16 가중치에는 두 가지 문제가 생길 수 있습니다. 학습 중에 일부 가중치가 아주 작아져 0으로 반올림될 수 있습니다. 또 가중치 자체는 0에 가깝지 않더라도, 업데이트가 아주 작으면 둘의 크기 차이 때문에 덧셈 과정에서 언더플로가 일어날 수 있습니다. 가중치가 일단 0이 되면 더는 그래디언트 신호가 흘러 들어오지 않으므로, 남은 학습 내내 0에 머뭅니다.
- 손실 스케일링: 그래디언트에도 비슷한 문제가 있습니다. 그래디언트는 1보다 훨씬 작은 경우가 많아 언더플로가 일어날 위험이 있습니다. 간단하면서도 효과적인 전략은 역전파 전에 손실을 스케일링하고, 역전파가 끝나면 그래디언트의 스케일을 되돌리는 것입니다. 이렇게 하면 역전파 중에 언더플로가 일어나지 않고, 그래디언트를 더 처리하기(예: 클리핑) 전과 최적화 스텝 전에 스케일을 되돌리므로 스케일링이 학습에 영향을 주지도 않습니다.
- 누적: 마지막으로, 평균이나 합계 같은 특정 산술 연산을 16비트 정밀도로 수행할 때도 언더플로나 오버플로를 겪을 수 있습니다. 이럴 때는 연산 도중의 중간 결과를 FP32로 누적하고, 최종 결과만 16비트 정밀도로 다시 변환하면 됩니다.
이런 기법을 쓰면, 더 빠른 저정밀도 산술 연산 덕분에 처리량이 높아지는 이점을 누리면서도 안정적으로 학습할 수 있습니다.
호기심 많은 독자이자 이제는 처리량 극대화에 살짝 중독되기까지 한 여러분이라면 자연스럽게 이런 질문을 던져 보실 수도 있겠습니다. 16비트 정밀도보다 더 멀리, 더 빠르게 갈 수 있을까요?
어쩌면요!
FP8 사전 학습
통신을 계산과 완벽하게 겹치더라도, 결국에는 언제나 하드웨어 자체의 저수준 이론 FLOPS 한계, 곧 하드웨어에서 개별 연산 하나하나가 내는 효율에 부딪힙니다. 바로 여기서 수치 정밀도가 결정적으로 중요해집니다. 예를 들어 NVIDIA H100 GPU에서 FP8 행렬 곱셈(GEMM 연산)은 BF16보다 이론 FLOPS가 두 배이므로, 저정밀도 학습은 한층 더 최적화할 수 있는 매력적인 길이 됩니다.
FP8-LM16, torchao17, DeepSeek-V32를 비롯한 최근 연구는 대규모 모델에서 FP8 학습의 잠재력을 보여 주었습니다. 그래도 FP8 사전 학습에는 큰 과제가 하나 있습니다. 바로 안정성입니다. 정밀도가 낮으면 수치 불안정성 때문에 손실이 발산하는 일이 잦아, 더 높은 정밀도로 학습할 때의 정확도를 따라잡기 어렵습니다.
모델 크기가 고정되어 있을 때 학습률이 높아질수록 불안정성이 커진다는 사실이 알려져 있어18, FP8 사전 학습은 특히 까다롭습니다.
다음은 FP8 학습에서 흔히 볼 수 있는, 발산하는 손실 곡선의 예입니다.
FP8 혼합 정밀도로 아주 큰 규모의 학습에 처음 성공했다고 공개적으로 보고한 것은 DeepSeek-V3 기술 보고서2입니다. 저자들은 순전파(Fprop)의 각 연산과, 활성값 쪽 역전파(Dgrad), 가중치 쪽 역전파(Wgrad)를 꼼꼼히 분석했습니다. BF16 혼합 정밀도 학습과 마찬가지로, 일부 집계 연산과 마스터 가중치는 더 높은 정밀도로 유지하고 연산 자체는 FP8로 수행합니다.
[그림: FP8 혼합 정밀도 학습의 연산별 정밀도 구성. 출처는 DeepSeek-V3 기술 보고서(arXiv 2412.19437)입니다. 논문의 arXiv 라이선스가 기본 배포 허락(nonexclusive-distrib)뿐이라 싣지 않았습니다. 원문에서 볼 수 있습니다.]
높은 정밀도(예: FP32나 BF16)에서 범위가 더 좁은 낮은 정밀도(예: FP16이나 FP8)로 바꾸려면, 활성값의 절댓값 최댓값을 구하는 등의 방법으로 활성값의 범위를 정규화해야 합니다. DeepSeek-V3는 여기에 더해, 범위를 타일 단위로 정규화하는 특정한 양자화 방식을 도입했습니다. 입력/활성값은 1x128, 가중치와 스케일 원소는 128x128 단위입니다. 이렇게 하면 정규화가 활성값의 이상값에 덜 휘둘립니다. 저자들은 메모리와 통신 사용량을 더 줄이는 여러 추가 요령도 제안했는데, 기술 보고서2의 3.3절에서 읽어 보실 수 있습니다.
다음은 알려진 FP8 학습 방식 몇 가지를 정리한 표입니다.
| GEMM 정밀도 | 마스터 모델 가중치 | 누적 그래디언트 | 모델 가중치 | 그래디언트 | 옵티마이저 상태 | 총 메모리 | |
|---|---|---|---|---|---|---|---|
| FP32를 쓰는 BF16 혼합 정밀도 기준선 | BF16 | FP32 | FP32 | BF16 | BF16 | FP32 + FP32 | 4 + 4 + 2 + 2 + 4 + 4 = 20바이트 |
| 위 설정에서 FP32 그래디언트 누적을 뺀 것 | BF16 | FP32 | 해당 없음 | BF16 | BF16 | FP32 + FP32 | 4 + 2 + 2 + 4 + 4 = 16바이트(20% 감소) |
| Transformer engine | FP8 | 해당 없음 | 해당 없음 | FP32 | FP32 | FP32 + FP32 | 4 + 4 + 4 + 4 = 16바이트(20% 감소) |
| FP8-LM의 O3 단계 | FP8 | FP16 | FP16 | FP8 | FP8 | FP8 + FP16 | 2 + 2 + 1 + 1 + 1 + 2 = 9바이트(55% 감소) |
| DeepSeek-V3 | FP8 | FP32 | FP32 | FP8 | BF16 | BF16 + BF16 | 4 + 4 + 1 + 2 + 2 + 2 = 15(25% 감소) |
| Nanotron의 FP8 | FP8 | BF16 | FP32 | FP8 | FP8 | FP8 + FP8 | 2 + 4 + 1 + 1 + 1 + 1 = 10바이트(50% 감소) |
전반적으로 FP8은 (2025년 초 기준으로) 아직 실험적인 기법이며, 방법들도 계속 발전하고 있습니다. 이점이 분명한 만큼 FP8은 표준이 되어 머지않아 BF16 혼합 정밀도를 대체할 가능성이 큽니다. FP8 학습 기법의 오픈 소스 구현을 보시려면 이 Nanotron PR을 확인해 보세요.
더 먼 미래를 내다보면, NVIDIA의 차세대 칩인 Blackwell은 FP4 학습을 지원한다고 발표되었습니다. 학습 속도는 더 빨라지겠지만, 틀림없이 학습 안정성 면에서 새로운 과제도 생길 것입니다.
이 마지막 절로, 수십에서 수천 개의 GPU로 큰 모델을 빠르게 학습시키는 세계를 향한 긴 여정을 마칩니다. 이제 GPU 클러스터를 천천히 쉬게 하고, 한 걸음 물러서서 지금까지 배운 모든 것을 돌아볼 시간입니다!
결론
독자 여러분, 축하합니다. 끝까지 오셨습니다! 꽤 긴 여정이었습니다. GPU 한 개로 간단한 모델을 학습시키는 방법을 살펴보는 데서 출발해, Llama-405B나 DeepSeek-V3 같은 거대한 언어 모델을 수천 개의 GPU로 효율적으로 학습시키는 데 쓰이는 갖가지 정교한 기법을 익히기까지 왔습니다. 이제 여러분은 Llama-3의 4D 병렬 구성 같은 도식도 (비교적) 쉽게 읽을 수 있습니다.
[그림: Llama-3의 4D 병렬 구성 도식. 출처는 Llama 3 논문(arXiv 2407.21783)입니다. 논문의 arXiv 라이선스가 기본 배포 허락(nonexclusive-distrib)뿐이라 싣지 않았습니다. 원문에서 볼 수 있습니다.]
LLM을 효율적으로 학습시키려고 대규모 GPU 클러스터를 조율하는 일은 결코 쉽지 않지만, 여러분은 GPU들이 늘 최대 활용률로 돌아가도록 GPU의 계산과 GPU 사이의 통신을 최적화하는 방법을 배웠습니다. 보셨듯이 그러려면 주어진 모델과 클러스터 크기에 맞는 병렬화 전략을 고르고, 가능한 곳에서는 통신을 계산과 겹치고, 하드웨어 구조를 고려해 GPU에서 연산을 최대한 빠르게 수행하는 커스텀 커널을 작성해야 합니다.
이런 지식은 여전히 다소 틈새 분야라서 LLM을 사전 학습하는 소수의 사람들에게만 해당한다고 생각하실 수도 있습니다. 예전에는 그랬을지 모르지만, AI 빌더 커뮤니티와 모델 크기가 모두 빠르게 커지면서 추론, 미세 조정, 학습에 분산 기법을 쓰는 사람들의 커뮤니티도 기하급수적으로 늘고 있고, 분산 학습 구성은 갈수록 흔해지고 있습니다. 그러니 분산과 관련된 모든 것을 더 깊이 파고드는 일은 아주 시의적절할 수 있습니다.
길고 긴 배움의 여정이었습니다. 여러분에게만 그랬던 것도 아닙니다! GPU 클러스터에서 수천 번의 벤치마크를 돌리는 일은 저희가 예상했던 것보다 어려웠고, 저희가 배우며 겪은 일 가운데 몇 가지 하이라이트도 함께 나누고 싶었습니다.
그래서, 다음은?
이제 여러분은 주요 분산 학습 개념을 두루 파악하셨지만, 저희는 이 도구와 기법 가운데 여러 가지의 겉만 살짝 훑었을 뿐입니다. 한 주제를 더 깊이 파고드는 방법은 많지만, 저희가 권하는 단계는 다음과 같습니다.
- 이정표가 된 논문이나 아주 최근의 논문 몇 편을 꼼꼼히 읽어 보세요. 저희가 아는 가장 영향력 있는 논문, 블로그 글, 책을 폭넓게 모은 목록을 참고문헌에서 보실 수 있습니다.
- 백지에서 시작해 알고리즘을 직접 구현해 보세요. 어떤 방법이든 실제로 구현해 봐야 비로소 완전히 ‘감이 오는’ 경우가 많습니다.
- 널리 쓰이는 프레임워크 하나를 깊이 파고들어 기여를 시작해 보세요. 버그를 고치고, 이슈에 답하고, 새 기능을 구현하는 겁니다. 어떤 ML 분야에든 발을 들이는 가장 좋은 방법입니다!
이 책이 분산 학습을 시작하는 데 도움이 되기를, 그리고 여러분이 GPU 클러스터의 웅웅거리는 소리를 들으며 차세대 멋진 모델을 학습시키기를 바랍니다! 오픈 소스와 오픈 사이언스의 포스가 언제나 여러분과 함께하기를.
감사의 말
꼼꼼하게 검토해 주고 NotebookLM으로 오디오 구성 요소를 만들어 준 Elie에게 감사드립니다. 프런트엔드 성능을 최적화해 준 Hynek에게도 특별히 감사드립니다. Hub에서 생긴 몇 가지 문제를 해결해 준 Simon에게도 감사드립니다.
토론 페이지
이 책의 내용을 두고 이야기를 나누거나, 질문하거나, 수정을 제안하거나, 그냥 인사를 건네고 싶으시면 토론 페이지에 스레드를 열어 주세요.
참고 자료
LLM 확장의 이정표가 된 논문
대규모 언어 모델을 학습시키기 위한 텐서 병렬화와 효율적인 모델 병렬화 기법을 소개합니다.
DeepSpeed와 Megatron-LM 프레임워크를 함께 써서 530B 파라미터 모델을 학습시킨 과정을 설명합니다.
Google의 Pathways Language Model을 소개합니다. 수백 가지 언어 과제와 추론에서 뛰어난 성능을 보여 줍니다.
텍스트, 이미지, 오디오, 비디오 입력을 처리할 수 있는 Google의 멀티모달 모델 아키텍처를 제시합니다.
Llama 3 모델군을 소개합니다.
DeepSeek-V3 모델의 아키텍처와 학습을 다룬 DeepSeek의 보고서입니다.
학습 프레임워크
저희가 만든 대규모 언어 모델 학습 프레임워크로, 다양한 병렬화 전략을 갖추고 있습니다.
다양한 병렬화 전략을 갖춘 NVIDIA의 대규모 언어 모델 학습 프레임워크입니다.
ZeRO 최적화 단계와 다양한 병렬화 전략을 갖춘 Microsoft의 딥러닝 최적화 라이브러리입니다.
다양한 병렬화 기법과 최적화 기법을 제공하는, 대규모 학습용 PyTorch 확장 라이브러리입니다.
다양한 최적화 기법을 갖춘 통합 대규모 모델 학습 시스템입니다.
대형 모델 학습용 PyTorch 네이티브 라이브러리입니다.
EleutherAI의 대규모 언어 모델 학습 프레임워크로, GPT-NeoX-20B를 학습시키는 데 쓰였습니다.
Lightning AI가 20개가 넘는 최신 오픈 소스 LLM을 구현한 것으로, 재현성에 중점을 둡니다.
DiLoCo로 여러 컴퓨팅 클러스터에 걸쳐 언어 모델을 학습시키는 오픈 소스 프레임워크입니다.
PyTorch로 구현한 GPipe입니다.
대규모 모델링을 위한 Open Source for Large-scale Optimization 프레임워크입니다.
디버깅
프로파일러로 모델 성능과 병목을 분석하는 방법을 다룬 PyTorch 공식 튜토리얼입니다.
PyTorch에서 GPU 메모리 사용량을 이해하고 최적화하는 방법을 폭넓게 다룬 가이드입니다.
Memory profiling walkthrough on a simple example
PyTorch에서 GPU 메모리를 시각화하고 이해하는 방법을 안내합니다.
PyTorch 모델에 TensorBoard 프로파일링 도구를 쓰는 방법을 안내합니다.
분산 기법
딥러닝의 데이터 병렬 학습을 폭넓게 설명합니다.
메모리를 최적화해 대형 모델을 학습시키는 Zero Redundancy Optimizer를 소개합니다.
PyTorch의 Fully Sharded Data Parallel 학습 구현입니다.
Tensor and sequence parallelism + selective recomputation
여러 병렬화 전략을 결합해 대규모 모델을 효율적으로 학습시키는 고급 기법입니다.
대형 모델 학습에 파이프라인 병렬화를 구현하는 방법을 다룬 NVIDIA의 가이드입니다.
Breadth-first pipeline parallelism
PP 스케줄에 관한 폭넓은 논의를 담고 있습니다.
분산 학습에 쓰이는 Ring AllReduce 알고리즘을 자세히 설명합니다.
링 어텐션 메커니즘을 FlashAttention과 결합해 효율적으로 학습하도록 한 구현입니다.
링 어텐션의 개념과 구현을 설명하는 튜토리얼입니다.
ZeRO와 3D 병렬화 전략 사이의 트레이드오프를 이해하도록 돕는 DeepSpeed의 가이드입니다.
딥러닝 모델을 위한 혼합 정밀도 학습 기법을 소개합니다.
Visualizing 6D mesh parallelism
6D 병렬 메시에서 일어나는 집합 통신을 설명합니다.
하드웨어
Fire-Flyer, a 10,000 PCI chip cluster
PCI GPU 1만 개로 이뤄진 클러스터를 설계한 과정을 다룬 DeepSeek의 보고서입니다.
NVIDIA H100 GPU로 구축한 거대한 AI 인프라를 Meta가 직접 자세히 소개한 글입니다.
SemiAnalysis’s 100k H100 cluster
대규모 H100 GPU 클러스터와 그 클러스터가 AI 인프라에 주는 시사점을 분석합니다.
사람이 읽기 쉽게 풀어 쓴 CUDA 문서입니다.
기타
LLM 학습의 여러 측면을 폭넓게 다룬 핸드북입니다.
BLOOM 모델의 학습 과정과 그동안 겪은 어려움을 자세히 기록한 문서입니다.
OPT-175B 모델의 학습 과정을 자세히 기록한 Meta의 학습 일지입니다.
Harm’s law for training smol models longer
모델 크기와 학습 오버헤드의 관계를 살펴본 글입니다.
긴 컨텍스트 학습을 데이터와 학습 비용 측면에서 살펴본 글입니다.
GPU를 다루는 스터디 모임이자 커뮤니티입니다.
ML 확장성과 성능을 다루는 스터디 모임입니다.
모델을 확장하는 방법을 다룹니다.
약 500줄짜리 독립형 FSDP 구현입니다.
Horace He의 블로그 글 몇 편입니다.
FlashAttention을 쉽게 풀어 쓴 설명입니다.
TunibAI’s 3D parallelism tutorials
PyTorch로 배우는 대규모 언어 모델링 튜토리얼입니다.
부록
A0: 병렬 프로그래밍 속성 강좌
이 책에서 우리는 줄곧 LLM 학습을 GPU 한 개에서 수백 개로 확장해 왔습니다. 그러려면 모든 머신 사이에서 가중치, 그래디언트, 데이터를 주고받고 동기화해야 합니다. 바로 이 일을 해내는 분산 패턴들이 있는데, 이를 집합 연산이라고 부릅니다. 이 절에서는 Broadcast, AllReduce, Scatter 같은 연산을 짧게 훑어보는 작은 속성 강좌를 열어 보겠습니다. 바로 들어가 볼까요!
기본 상황은 이렇습니다. 서로 독립된 노드가 여러 개 있고, 노드는 CPU 코어일 수도, GPU일 수도, 컴퓨팅 노드일 수도 있습니다. 각 노드가 어떤 계산을 하고 나면, 다음 계산 단계()를 위해 그 결과나 결과의 일부를 다른 노드들에 전달해야 합니다.
한 노드의 결과를 다른 모든 노드로 보내야 할 수도 있고, 각 노드의 중간 결과를 모두 더해 전체 결과를 알려야 할 수도 있습니다. 보통은 특별한 지위를 가진 노드 하나가 중심 역할을 맡아 일부 연산의 목적지나 출발점이 되는데, 여기서는 이 노드를 루트라고 부르겠습니다. 가장 단순한 프리미티브 가운데 하나인 Broadcast 연산부터 시작해 보겠습니다.
Broadcast
아주 흔한 패턴은 이렇습니다. 노드 1에 어떤 데이터가 있고, 다른 모든 노드도 그 데이터로 계산할 수 있도록 데이터를 나눠 주고 싶습니다. Broadcast 연산이 바로 이 일을 합니다.
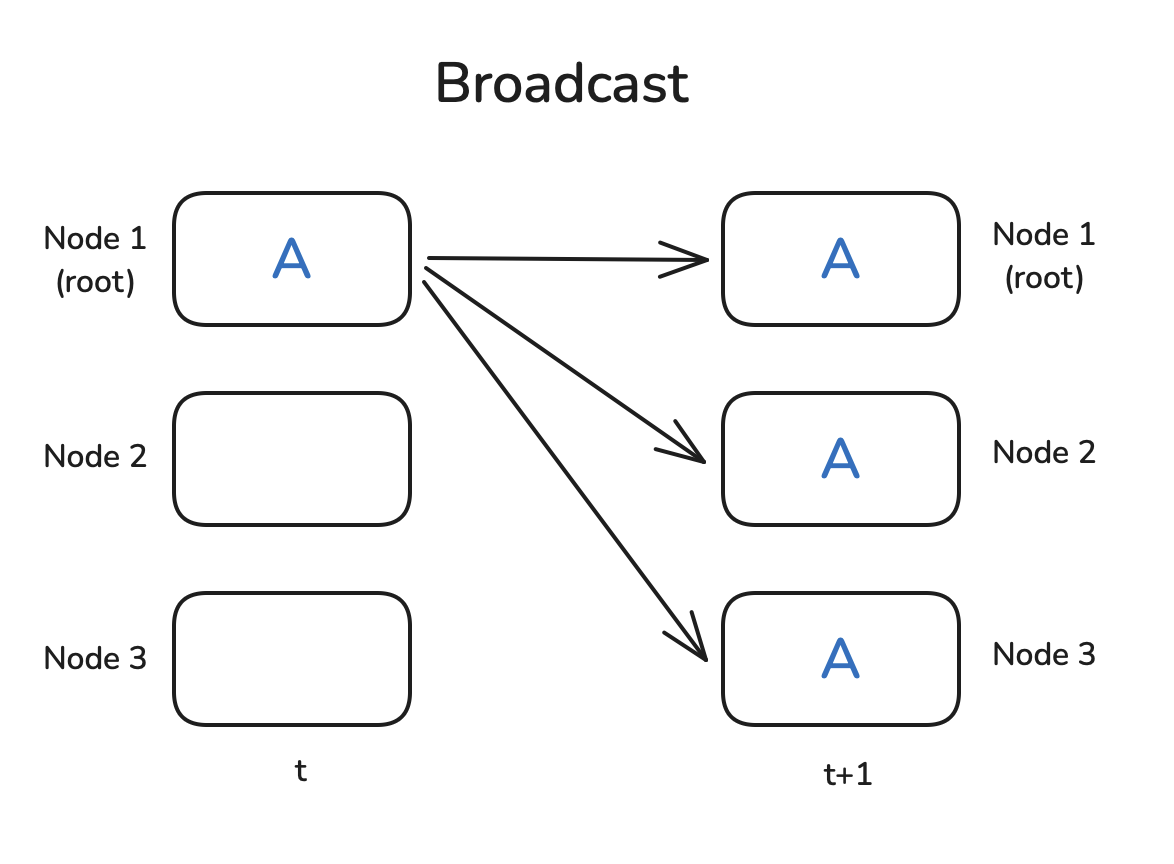
PyTorch는 집합 연산을 기본으로 제공하므로, Broadcast가 어떻게 동작하는지 보여 주는 작은 예제를 쉽게 짤 수 있습니다. 먼저 dist.initi_process_group으로 프로세스 그룹을 초기화해야 하는데, 이 함수가 통신 백엔드를 설정합니다(NCCL은 뒤에서 다룹니다). 이 함수는 워커(노드라고도 합니다)가 몇 개 있는지 파악하고 각 워커에 랭크를 하나씩 매깁니다(랭크는 dist.get_rank로 얻을 수 있습니다). 끝으로 워커들 사이에 연결을 맺습니다.
dist.broadcast 연산을 보여 드리려고 rank=0에는 0이 아닌 값을 담은 텐서를, 다른 워커에는 0으로 채운 텐서를 만들어 보겠습니다. 그런 다음 dist.broadcast(tensor, src=0)로 rank=0의 텐서를 다른 모든 랭크에 나눠 줍니다.
import torch
import torch.distributed as dist

def init_process():
    dist.init_process_group(backend='nccl')
    torch.cuda.set_device(dist.get_rank())

def example_broadcast():
    if dist.get_rank() == 0:
        tensor = torch.tensor([1, 2, 3, 4, 5], dtype=torch.float32).cuda()
    else:
        tensor = torch.zeros(5, dtype=torch.float32).cuda()
    print(f"Before broadcast on rank {dist.get_rank()}: {tensor}")
    dist.broadcast(tensor, src=0)
    print(f"After broadcast on rank {dist.get_rank()}: {tensor}")

init_process()
example_broadcats()
위 스크립트는 torchrun --nproc_per_node=3 dist_op.py로 실행할 수 있습니다(GPU가 세 개 필요하며, 없다면 nproc_per_node를 그에 맞게 바꾸세요). 실행하면 다음과 같은 출력이 나올 것입니다.
Before broadcast on rank 0: tensor([1., 2., 3., 4., 5.], device='cuda:0')
Before broadcast on rank 1: tensor([0., 0., 0., 0., 0.], device='cuda:1')
Before broadcast on rank 2: tensor([0., 0., 0., 0., 0.], device='cuda:2')

After broadcast on rank 0: tensor([1., 2., 3., 4., 5.], device='cuda:0')
After broadcast on rank 1: tensor([1., 2., 3., 4., 5.], device='cuda:1')
After broadcast on rank 2: tensor([1., 2., 3., 4., 5.], device='cuda:2')
좋습니다, 예상대로 동작하는 것 같네요. 어느 print 문이 먼저 실행될지는 우리가 정할 수 없으므로 랭크별 메시지가 뒤섞인 순서로 출력될 수 있다는 점에 유의하세요(여기서는 읽기 쉽게 순서를 맞춰 두었습니다). 이제 Reduce와 AllReduce 패턴으로 넘어가 봅시다!
Reduce와 AllReduce
Reduce 패턴은 분산 데이터 처리에서 가장 기본이 되는 패턴 가운데 하나입니다. 각 노드에 있는 데이터를 함수 f()로 합치는 것이 핵심인데, 이 함수로는 이를테면 합이나 평균을 구합니다. Reduce 방식에서는 결과를 루트 노드에만 보내고, AllReduce에서는 결과를 모든 노드에 Broadcast합니다.
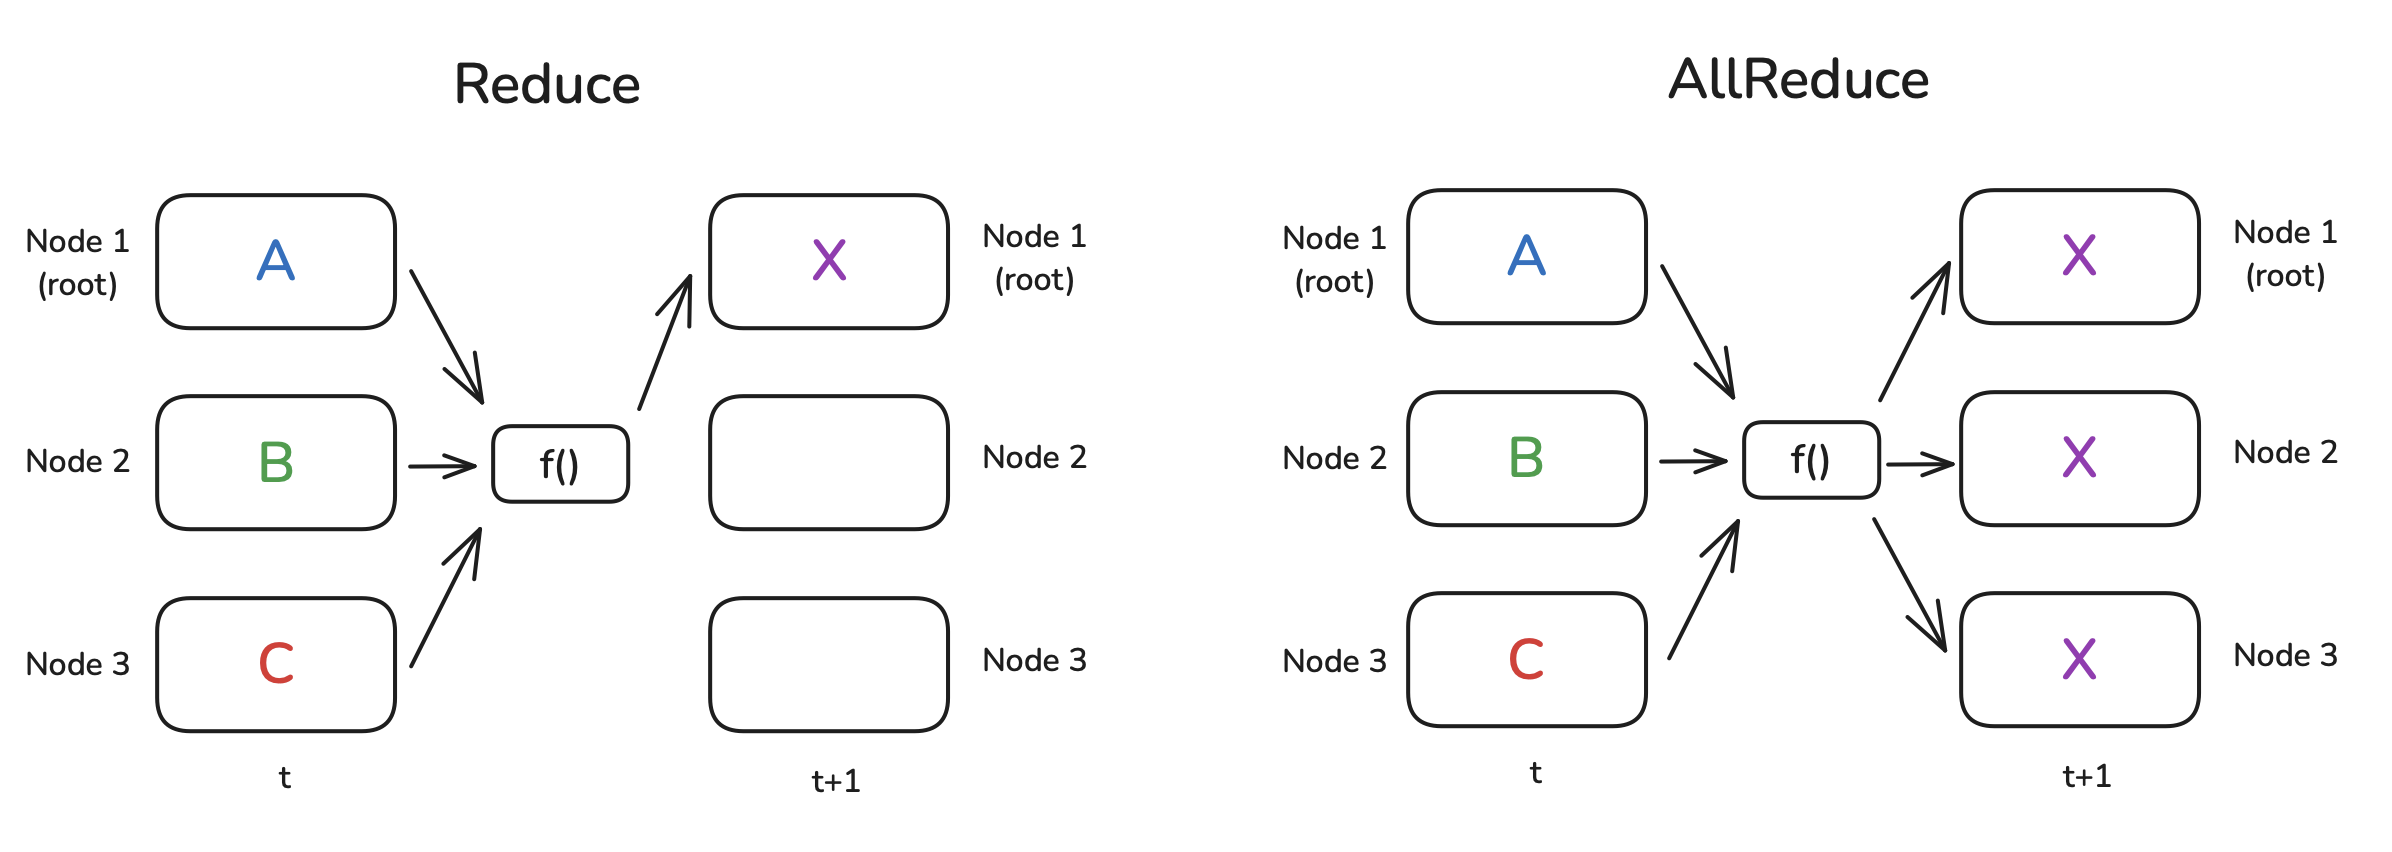
물론 이 연산을 혼자서 해내는 마법 같은 ‘공중에 떠 있는’ 노드는 없습니다. 보통은 노드들을 링이나 트리 구조로 엮고, 각 노드가 계산의 일부를 맡습니다. 간단한 예를 들어 보겠습니다. 각 노드에 있는 수의 합을 구해야 하고, 노드들이 링 모양으로 연결되어 있다고 합시다. 첫 번째 노드가 자기 수를 이웃에게 보내면, 그 이웃은 받은 수에 자기 수를 더해 다음 이웃에게 넘깁니다. 노드 링을 한 바퀴 다 돌면 첫 번째 노드가 전체 합을 받게 됩니다.
다음은 텐서들을 더하는 간단한 Reduce 연산을 실행하는 코드입니다. 사용할 연산은 op=dist.ReduceOp.SUM으로 지정합니다(지원하는 연산은 PyTorch 문서에서 더 자세히 볼 수 있습니다).
def example_reduce():
    tensor = torch.tensor([dist.get_rank() + 1] * 5, dtype=torch.float32).cuda()
    print(f"Before reduce on rank {dist.get_rank()}: {tensor}")
    dist.reduce(tensor, dst=0, op=dist.ReduceOp.SUM)
    print(f"After reduce on rank {rank}: {tensor}")

init_process()
example_reduce()
Reduce 연산에서는 dst 노드의 텐서만 바뀐다는 점에 주목하세요.
Before reduce on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0')
Before reduce on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1')
Before reduce on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2')

After reduce on rank 0: tensor([6., 6., 6., 6., 6.], device='cuda:0')
After reduce on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1')
After reduce on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2')
비슷하게 AllReduce는 다음과 같이 수행할 수 있습니다(이때는 목적지를 지정할 필요가 없습니다).
def example_all_reduce():
    tensor = torch.tensor([dist.get_rank() + 1] * 5, dtype=torch.float32).cuda()
    print(f"Before all_reduce on rank {dist.get_rank()}: {tensor}")
    dist.all_reduce(tensor, op=dist.ReduceOp.SUM)
    print(f"After all_reduce on rank {dist.get_rank()}: {tensor}")

init_process()
example_all_reduce()
이번에는 모든 노드에서 결과를 볼 수 있습니다.
Before all_reduce on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0')
Before all_reduce on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1')
Before all_reduce on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2')

After all_reduce on rank 0: tensor([6., 6., 6., 6., 6.], device='cuda:0')
After all_reduce on rank 1: tensor([6., 6., 6., 6., 6.], device='cuda:1')
After all_reduce on rank 2: tensor([6., 6., 6., 6., 6.], device='cuda:2')
이제 다음 분산 통신 연산으로 넘어가 보겠습니다. 실제로는 각 노드가 저마다 복잡한 계산을 많이 수행하고, 그 최종 결과를 모든 노드가 나눠 가져야 하는 경우가 많습니다. 이럴 때 쓰는 연산이 Gather와 AllGather입니다. 함께 살펴봅시다!
Gather와 AllGather
Gather와 AllGather는 데이터를 바꾸지 않고 노드들 사이에 나눠 준다는 점에서 Broadcast 연산과 꽤 비슷합니다. Broadcast와 가장 크게 다른 점은 한 노드에서 다른 모든 노드로 공유할 값이 하나가 아니라는 것입니다. 대신 각 노드가 저마다 데이터 청크를 하나씩 가지고 있고, 그 데이터를 모두 한 노드에 모으거나(Gather의 경우) 모든 노드에 모으려(AllGather의 경우) 합니다. 백문이 불여일견이니 그림으로 보겠습니다.
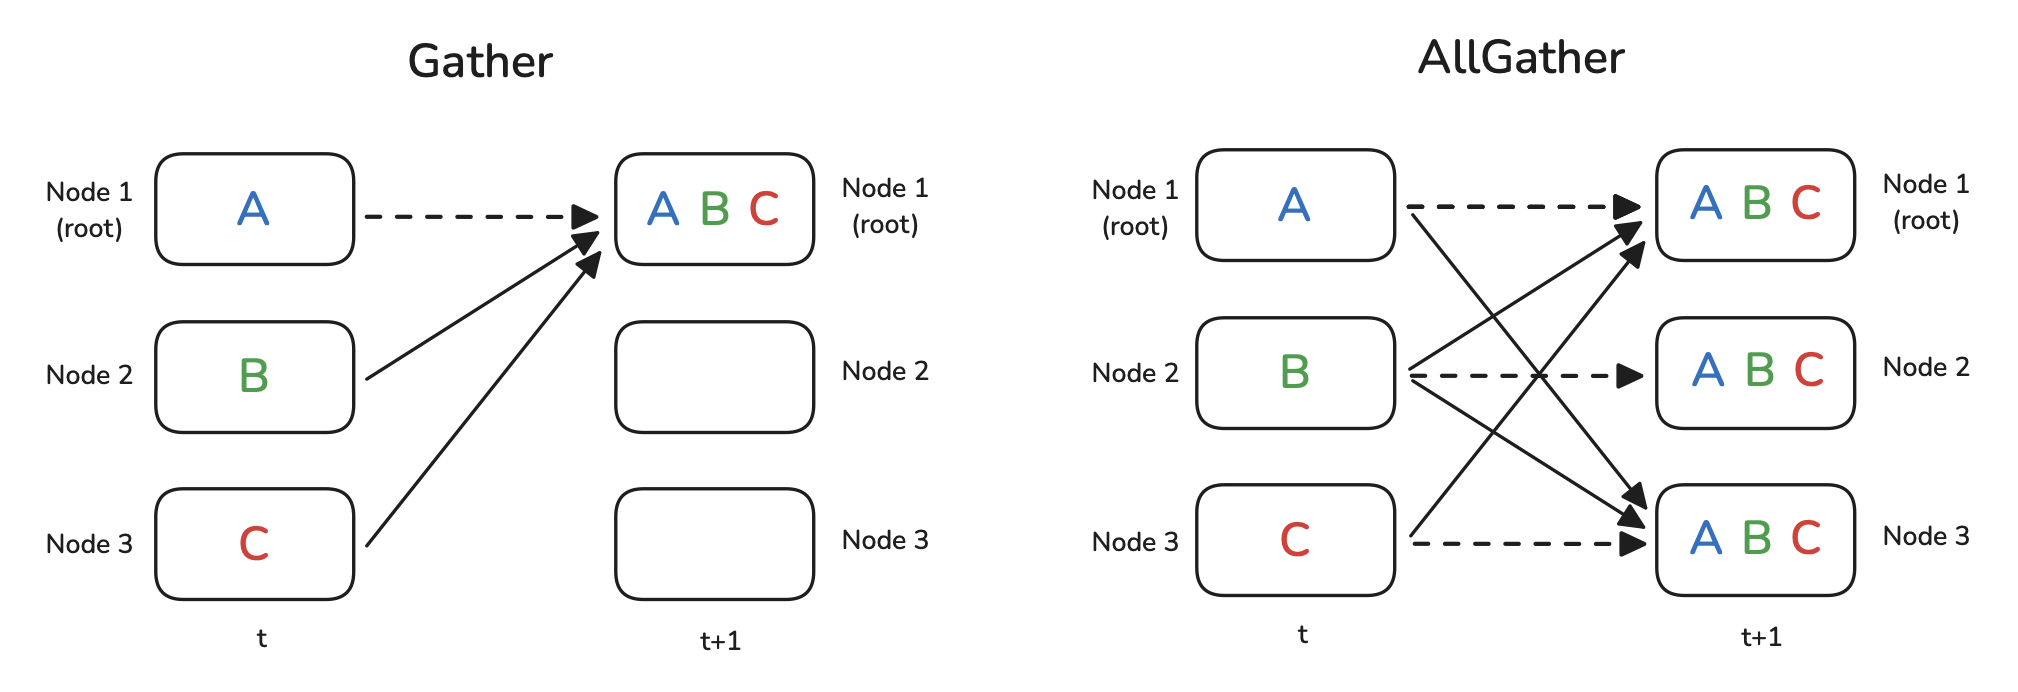
점선은 일부 데이터가 실제로는 전혀 움직이지 않는다는 뜻입니다(이미 그 노드에 있기 때문입니다).
Gather 연산에서는 모은 텐서들을 담아 둘 컨테이너 객체를 준비해야 합니다. 이 예제에서는 gather_list 객체가 그 역할을 합니다.
def example_gather():
    tensor = torch.tensor([dist.get_rank() + 1] * 5, dtype=torch.float32).cuda()
    if dist.get_rank() == 0:
        gather_list = [
            torch.zeros(5, dtype=torch.float32).cuda()
            for _ in range(dist.get_world_size())
            ]
    else:
        gather_list = None
    print(f"Before gather on rank {dist.get_rank()}: {tensor}")
    dist.gather(tensor, gather_list, dst=0)
    if dist.get_rank() == 0:
        print(f"After gather on rank 0: {gather_list}")

init_process()
example_gather()
그러면 gather_list에 정말로 모든 랭크의 텐서가 담긴 것을 볼 수 있습니다.
Before gather on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0')
Before gather on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1')
Before gather on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2')

After gather on rank 0: [tensor([1., 1., 1., 1., 1.], device='cuda:0'),
                         tensor([2., 2., 2., 2., 2.], device='cuda:0'),
                         tensor([3., 3., 3., 3., 3.], device='cuda:0')]
AllGather 예제에서 바꿀 것은 하나뿐입니다. 모든 노드에 결과를 담을 자리가 있어야 한다는 점입니다.
def example_all_gather():
    tensor = torch.tensor([dist.get_rank() + 1] * 5, dtype=torch.float32).cuda()
    gather_list = [
        torch.zeros(5, dtype=torch.float32).cuda()
        for _ in range(dist.get_world_size())
        ]
    print(f"Before all_gather on rank {dist.get_rank()}: {tensor}")
    dist.all_gather(gather_list, tensor)
    print(f"After all_gather on rank {dist.get_rank()}: {gather_list}")

init_process()
example_all_gather()
이제 각 노드가 모든 데이터를 갖게 된 것을 볼 수 있습니다.
Before all_gather on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0')
Before all_gather on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1')
Before all_gather on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2')

After all_gather on rank 0: [tensor([1., 1., 1., 1., 1.], device='cuda:0'),
                             tensor([2., 2., 2., 2., 2.], device='cuda:0'),
                             tensor([3., 3., 3., 3., 3.], device='cuda:0')]
After all_gather on rank 1: [tensor([1., 1., 1., 1., 1.], device='cuda:1'),
                             tensor([2., 2., 2., 2., 2.], device='cuda:0'),
                             tensor([3., 3., 3., 3., 3.], device='cuda:0')]
After all_gather on rank 2: [tensor([1., 1., 1., 1., 1.], device='cuda:2'),
                             tensor([2., 2., 2., 2., 2.], device='cuda:2'),
                             tensor([3., 3., 3., 3., 3.], device='cuda:2')]
그렇다면 Gather의 반대는 어떨까요? 이번에는 모든 데이터가 한 노드에 있고, 이를 잘라서 노드들에 나눠 주려 합니다. 중간에 어떤 처리를 거칠 수도 있습니다. 이럴 때는 Scatter 패턴을 쓰거나, 데이터를 나눠 주기 전에 연산을 적용하는 경우라면 ReduceScatter 패턴을 쓸 수 있습니다.
Scatter와 ReduceScatter
이름에서 알 수 있듯이 Scatter 연산의 목표는 한 노드에 있는 데이터를 모든 노드에 흩뿌리는 것이고, 이를 위해 데이터를 조각내어 각 노드에 한 조각씩 나눠 줍니다. 따라서 데이터를 자르지 않고 완전한 사본을 각 노드에 보내는 Broadcast 연산과는 다르며, 논리적으로는 Gather 연산의 역연산입니다.
ReduceScatter 패턴은 조금 더 복잡합니다. AllReduce처럼 모든 노드의 데이터에 연산을 적용합니다. 하지만 각 노드가 출력 텐서 전체를 받는 AllReduce와 달리, ReduceScatter에서는 각 노드가 출력 텐서의 한 조각만 받습니다. 다음 그림은 이 연산들의 차이를 보여 줍니다.
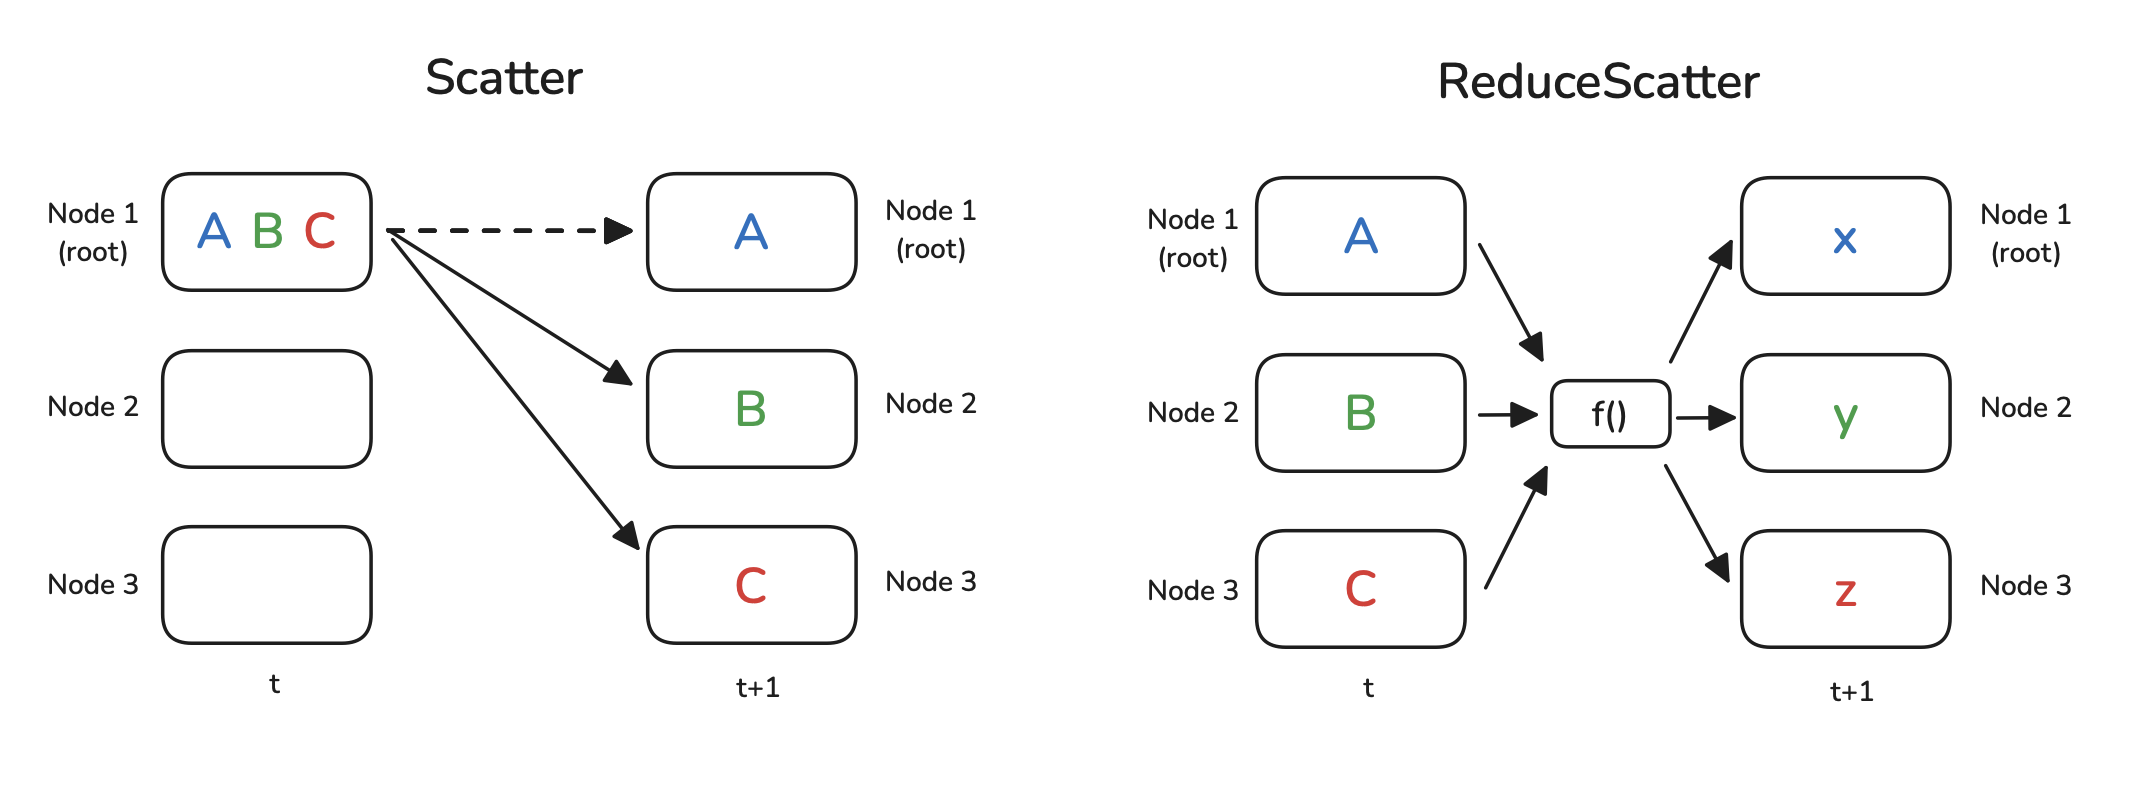
코드에서 Scatter 연산은 Gather와 반대로 씁니다. 텐서 리스트를 목적지로 준비하는 대신, 나눠 주려는 원본 데이터를 텐서 리스트로 준비합니다. src도 지정해야 합니다.
def example_scatter():
    if dist.get_rank() == 0:
        scatter_list = [
            torch.tensor([i + 1] * 5, dtype=torch.float32).cuda()
            for i in range(dist.get_world_size())
            ]
        print(f"Rank 0: Tensor to scatter: {scatter_list}")
    else:
        scatter_list = None
    tensor = torch.zeros(5, dtype=torch.float32).cuda()
    print(f"Before scatter on rank {dist.get_rank()}: {tensor}")
    dist.scatter(tensor, scatter_list, src=0)
    print(f"After scatter on rank {dist.get_rank()}: {tensor}")

init_process()
example_scatter()
그 결과 빈 텐서들이 scatter_list의 내용으로 채워집니다.
Rank 0: Tensor to scatter: [tensor([1., 1., 1., 1., 1.], device='cuda:0'),
                            tensor([2., 2., 2., 2., 2.], device='cuda:0'),
                            tensor([3., 3., 3., 3., 3.], device='cuda:0')]
Before scatter on rank 0: tensor([0., 0., 0., 0., 0.], device='cuda:0')
Before scatter on rank 1: tensor([0., 0., 0., 0., 0.], device='cuda:1')
Before scatter on rank 2: tensor([0., 0., 0., 0., 0.], device='cuda:2')

After scatter on rank 0: tensor([1., 1., 1., 1., 1.], device='cuda:0')
After scatter on rank 1: tensor([2., 2., 2., 2., 2.], device='cuda:1')
After scatter on rank 2: tensor([3., 3., 3., 3., 3.], device='cuda:2')
ReduceScatter의 동작을 보여 드리려고 조금 더 흥미로운 데이터를 만들어 보겠습니다. 각 노드에서, 노드 랭크에 따라 정해지는 거듭제곱 지수와 오프셋을 적용한 원소 두 개짜리 벡터의 리스트를 만듭니다.
def example_reduce_scatter():
    rank = dist.get_rank()
    world_size = dist.get_world_size()
    input_tensor = [
        torch.tensor([(rank + 1) * i for i in range(1, 3)], dtype=torch.float32).cuda()**(j+1)
        for j in range(world_size)
        ]
    output_tensor = torch.zeros(2, dtype=torch.float32).cuda()
    print(f"Before ReduceScatter on rank {rank}: {input_tensor}")
    dist.reduce_scatter(output_tensor, input_tensor, op=dist.ReduceOp.SUM)
    print(f"After ReduceScatter on rank {rank}: {output_tensor}")

init_process()
example_reduce_scatter()
print 문의 출력을 보면 우리가 만든 데이터의 패턴이 드러납니다. ReduceScatter 패턴이 동작하는 모습도 바로 보입니다. 첫 번째 랭크는 각 노드의 첫 번째 텐서를 더한 값을, 두 번째 랭크는 각 노드의 두 번째 텐서를 더한 값을 받는 식입니다.
Before ReduceScatter on rank 0: [tensor([1., 2.], device='cuda:0'),
											                       tensor([1., 4.], device='cuda:0'),
											                       tensor([1., 8.], device='cuda:0')]
Before ReduceScatter on rank 1: [tensor([2., 4.], device='cuda:1'),
                                 tensor([4., 16.], device='cuda:1'),
                                 tensor([8., 64.], device='cuda:1')]
Before ReduceScatter on rank 2: [tensor([3., 6.], device='cuda:2'),
                                 tensor([9., 36.], device='cuda:2'),
                                 tensor([27., 216.], device='cuda:2')]

After ReduceScatter on rank 0: tensor([6., 12.], device='cuda:0')
After ReduceScatter on rank 1: tensor([14., 56.], device='cuda:1')
After ReduceScatter on rank 2: tensor([36., 288.], device='cuda:2')
다음으로 ReduceScatter와 AllGather를 써서 AllReduce를 구현하는 흔한 방법인 Ring AllReduce를 잠깐 살펴보겠습니다.
Ring AllReduce
Ring AllReduce는 확장성에 맞춰 최적화한 AllReduce 구현의 한 가지입니다. Ring AllReduce는 모든 장치가 서로 직접 통신하는 대신(그러면 통신 병목이 생길 수 있습니다) ReduceScatter와 AllGather라는 두 핵심 단계로 나눌 수 있습니다. 동작 방식은 다음과 같습니다.
- ReduceScatter
- 각 장치는 자기 데이터(예: 그래디언트)를 N개의 청크로 나누고(N은 GPU 수), 청크 하나를 이웃에게 보냅니다. 동시에 각 장치는 반대쪽 이웃에게서 청크 하나를 받습니다.
- 각 장치는 청크를 받을 때마다 받은 청크에 자기 쪽의 대응하는 청크를 더합니다(리듀스합니다).
- 이 과정이 링을 따라 계속되어, 결국 각 장치는 완전히 리듀스된 청크 하나를 갖게 됩니다. 이 청크는 그 부분에 해당하는 모든 장치의 그래디언트를 합한 값입니다.
- AllGather
- 이제 각 장치는 다른 장치들에 있는 완전히 리듀스된 청크들을 모아야 합니다.
- 각 장치는 자기의 리듀스된 청크를 이웃에게 보내고, 반대쪽 이웃에게서 리듀스된 청크를 받습니다.
- 장치들은 모든 장치가 완전히 리듀스된 청크를 전부 가질 때까지 받은 청크를 계속 넘겨 주고, 그러면 각 장치가 다 더해진 완전한 그래디언트를 갖게 됩니다.
다음 GIF로 이 과정을 보여 드리겠습니다. GPU가 5개 있고, 각 GPU에는 길이가 5인 텐서가 있습니다. 첫 번째 애니메이션은 ReduceScatter 단계를 보여 주는데, 단계가 끝나면 각 GPU가 특정 데이터 청크(주황색 사각형)의 리듀스된 결과를 받습니다.
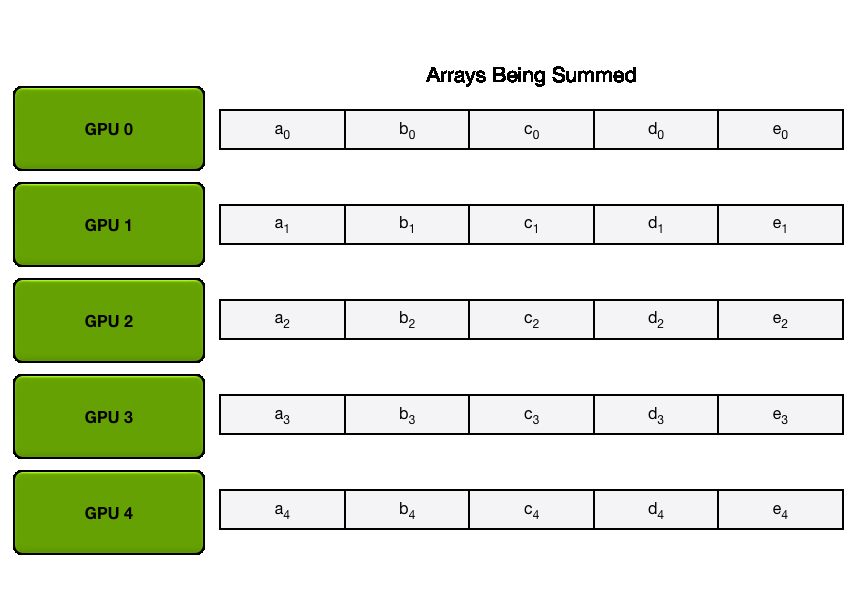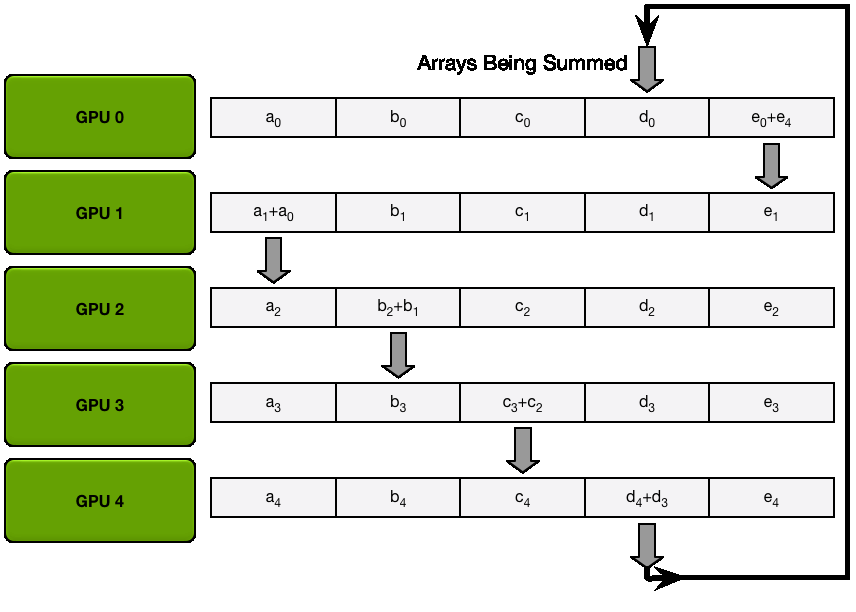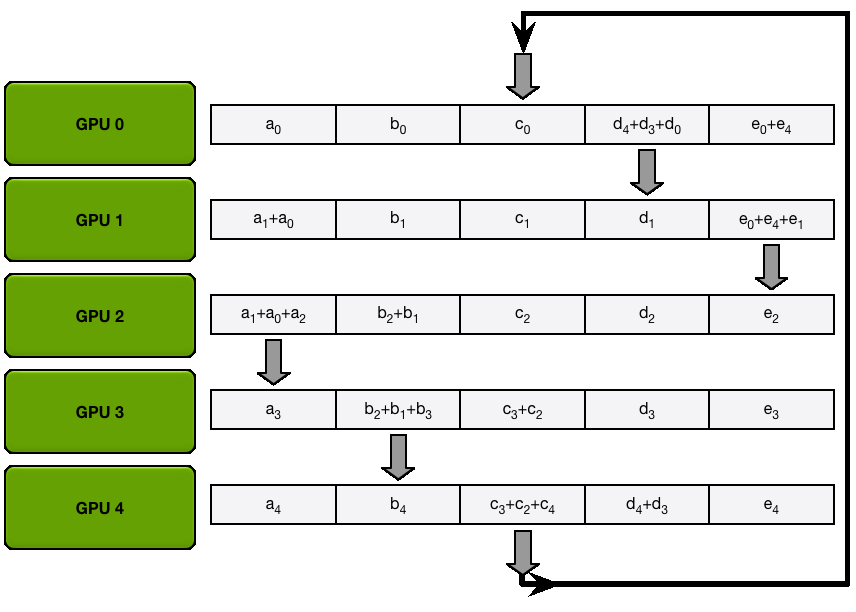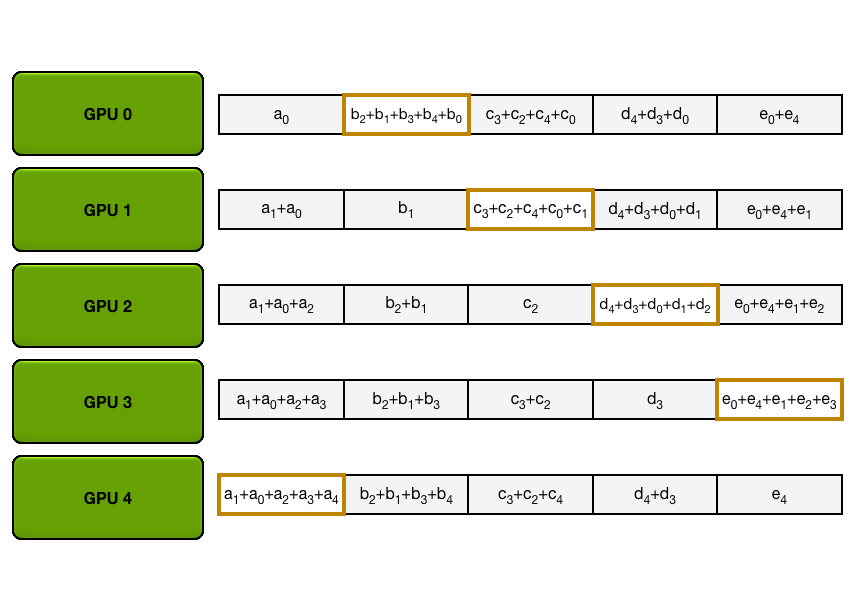
다음 애니메이션은 AllGather 단계를 보여 주며, 단계가 끝나면 각 GPU가 AllReduce 연산의 전체 결과를 얻습니다.
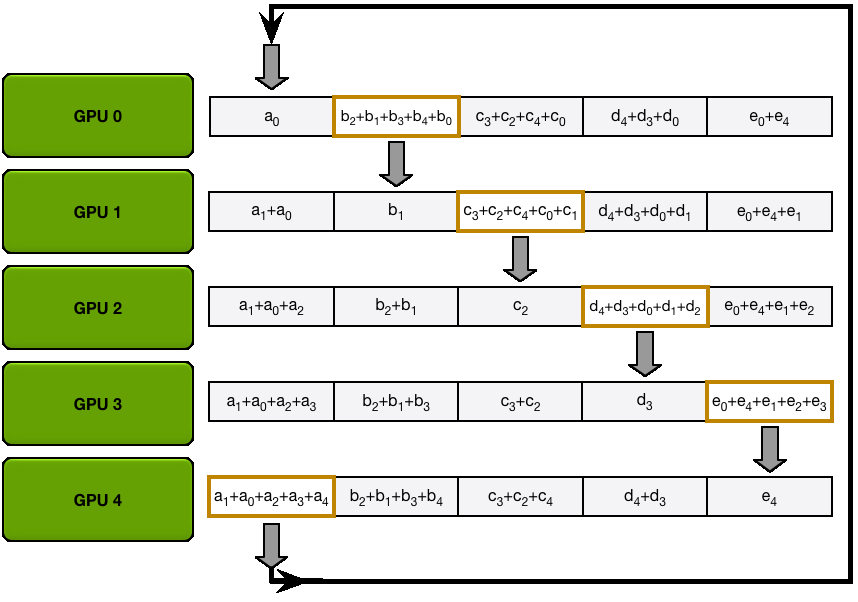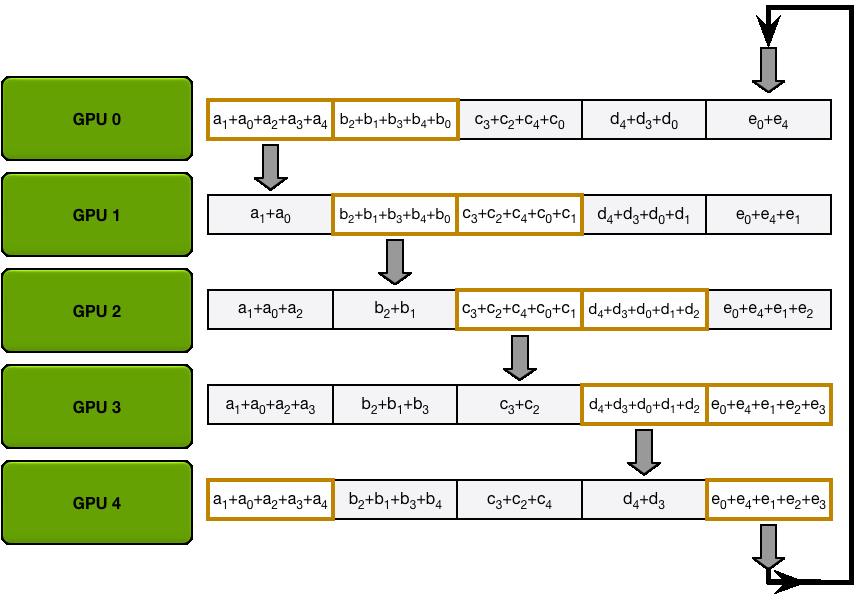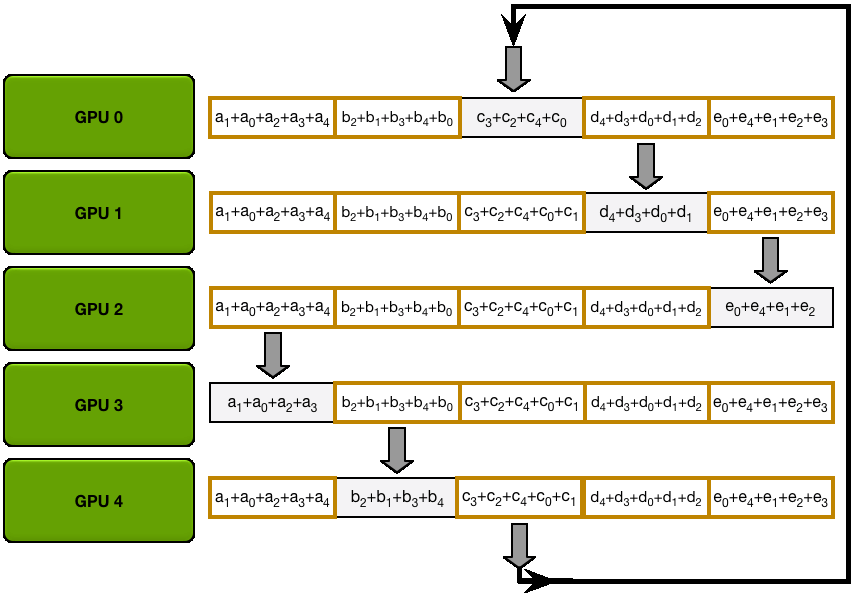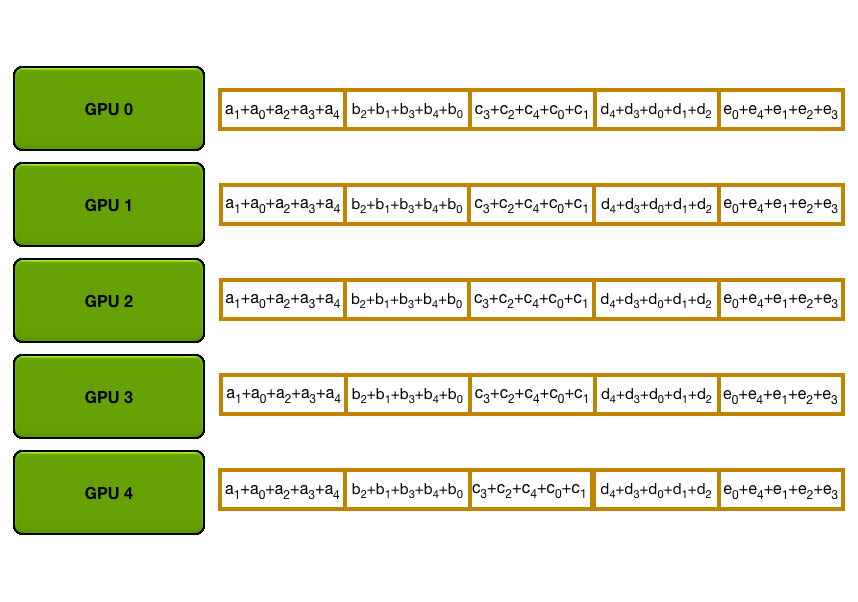
눈치채셨을지도 모르지만, 개의 GPU는 각각 ReduceScatter 단계와 AllGather 단계에서 모두 번씩 값을 보내고 받습니다. 각 GPU는 전송 한 번에 개의 값을 보내는데, 여기서 는 GPU들에 걸쳐 합산하는 배열에 든 값의 총개수입니다. 따라서 각 GPU가 주고받는 데이터의 총량은 입니다. (GPU 수)이 크면 각 GPU가 주고받는 데이터 총량은 대략 이고, 여기서 는 전체 파라미터 수입니다.
AllReduce에서 꼭 기억할 점은 두 가지입니다.
- AllReduce의 통신 비용은 (GPU 수)이 클 때 대략 입니다.
- AllReduce 연산은 ReduceScatter 뒤에 AllGather를 하는 것으로 나눌 수 있습니다. 이 두 연산의 통신 비용은 각각 AllReduce의 절반인 대략 입니다.
보시다시피 이 구현은 노드 사이의 제한된 대역폭도 효율적으로 쓸 수 있습니다.
이제 분산 연산의 주요 구성 요소를 살펴봤습니다. 하지만 이들이 실제로 동작하는 모습을 보기 전에, 동기화에 쓰는 특별한 연산인 Barrier 연산을 살펴보겠습니다.
Barrier
Barrier는 모든 노드를 동기화하는 간단한 연산입니다. 배리어는 모든 노드가 거기에 도달할 때까지 풀리지 않습니다. 그때가 되어서야 노드들이 다음 계산을 이어 갈 수 있습니다.
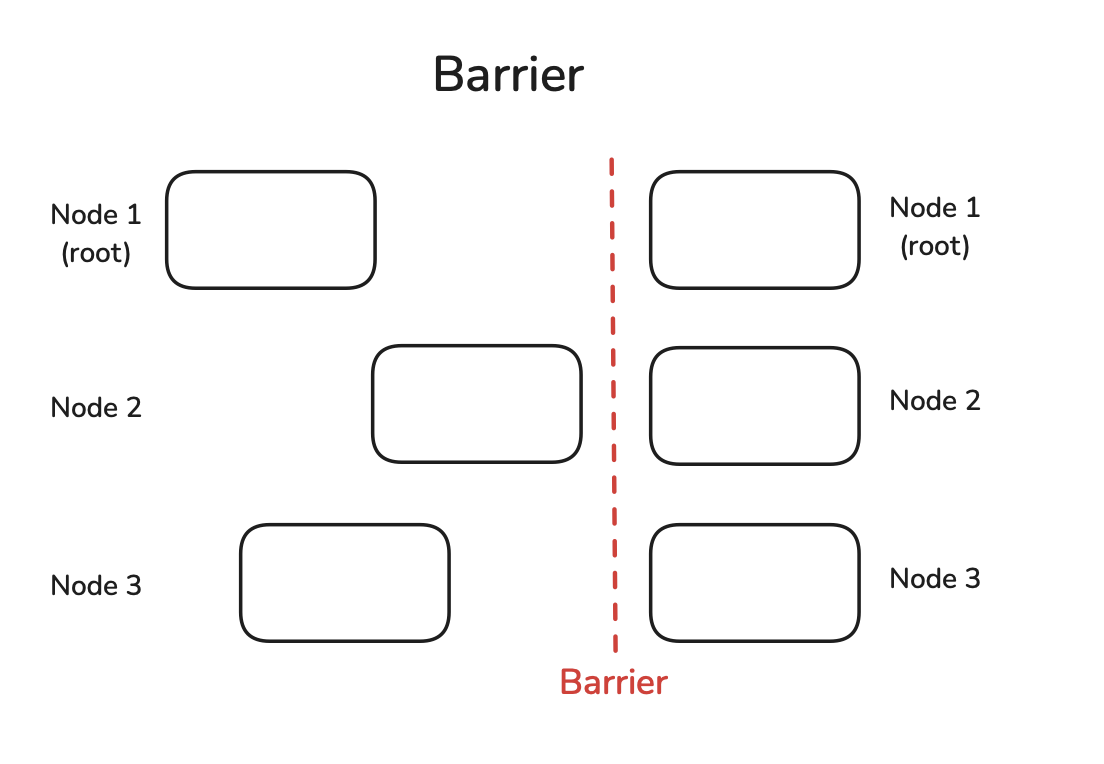
노드마다 대기(sleep) 시간을 다르게 주고 모든 노드가 배리어를 통과하는 데 얼마나 걸리는지 보면, 늦는 노드를 쉽게 흉내 낼 수 있습니다.
def example_barrier():
    rank = dist.get_rank()
    t_start = time.time()
    print(f"Rank {rank} sleeps {rank} seconds.")
    time.sleep(rank)  # Simulate different processing times
    dist.barrier()
    print(f"Rank {rank} after barrier time delta: {time.time()-t_start:.4f}")

init_process()
example_barrier()
첫 번째 랭크는 전혀 대기하지 않았는데도 배리어를 통과하는 데 역시 2초가 걸린 것을 볼 수 있습니다.
Rank 0 sleeps 0 seconds.
Rank 1 sleeps 1 seconds.
Rank 2 sleeps 2 seconds.

Rank 0 after barrier time delta: 2.0025
Rank 1 after barrier time delta: 2.0025
Rank 2 after barrier time delta: 2.0024
이렇게 모든 노드를 동기화할 때는 조심해야 합니다. 독립적인 연산을 병렬로 돌리는 취지를 해쳐 전체 처리 속도를 늦출 수 있기 때문입니다. 많은 경우 빠른 노드가 다른 노드보다 먼저 다음 작업을 처리하기 시작해도 괜찮습니다. 그 빠른 노드가 다음 반복에서는 더 느릴 수도 있어서, 전체 과정에 걸쳐 지연이 평준화되기 때문입니다.
실제 분산 학습 구현으로 넘어가기 전에 수수께끼 하나부터 풀고 가겠습니다. 대체 NCCL이 뭘까요?
NCCL
많은 GPU로 큰 모델을 학습하다 보면 가끔은 금맥을 캐기도 하겠지만, 니켈(nickel)은 반드시 만나게 됩니다(아니, NCCL 🥁)! 그게 뭐냐고요?
집합 통신을 구현하고 PyTorch가 지원하는 라이브러리가 몇 가지 있습니다. 고전적인 MPI(Message Passing Interface), Meta의 Gloo, 그리고 마지막으로 NCCL(NVIDIA Collective Communications Library)입니다. 셋 다 집합 통신 패턴 면에서는 비슷한 기능을 제공하지만, 서로 다른 하드웨어 구성에 맞춰 최적화되어 있습니다. NCCL은 GPU와 GPU 사이의 통신을 효율적으로 처리하도록 설계되었고, MPI와 Gloo는 CPU와 CPU, 또는 CPU와 GPU 사이의 통신에 맞춰져 있습니다. 어느 것을 쓸지 정하는 데 도움이 되는 훌륭한 가이드를 PyTorch가 제공하지만, 요점만 추리면 이렇습니다.
- GPU 학습: NCCL을 쓰세요
- CPU 학습: Gloo를 쓰세요
결정 트리에는 몇 가지 더 세세한 점이 있는데, 이는 위에서 소개한 PyTorch 가이드에서 독자 여러분이 직접 살펴보시도록 남겨 두겠습니다.
A1: 분산 학습 프로파일링
커널
우선 커널이 이미 PyTorch에 통합되어 있다고 가정하고 시작하겠습니다. 간단한 예로, PyTorch에 torch.nn.functional.layer_norm으로 구현된 레이어 정규화 함수를 살펴볼 수 있습니다. 이 함수 밑에서 돌아가는 커널을 프로파일링하는 방법은 여러 가지입니다. 가장 간단한 방법은 Python의 time 모듈을 쓰는 것일 겁니다. 하지만 CUDA 연산은 비동기로 실행되므로, 이 방법으로 시간을 재면 커널 자체의 실제 실행 시간이 아니라 Python에서 커널을 런치하는 데 드는 오버헤드만 잡힙니다.
이 문제를 해결하려면 정확한 시간 측정에는 torch.cuda.Event를 쓰고, torch.cuda.synchronize() 지시문으로 커널 실행이 끝날 때까지 확실히 기다리면 됩니다. 다음 코드 조각이 이 방법을 보여 줍니다.
def profile_pytorch(func, input):
    # Create CUDA events to track time. CUDA operations are asynchronous.
    start = torch.cuda.Event(enable_timing=True)  # Event to mark the start time
    end = torch.cuda.Event(enable_timing=True)    # Event to mark the end time
    # Warm up to eliminate any overhead from the first run, which might not reflect
    # the actual performance
    for _ in range(10):
        func(input)
    # Record the start time before executing the function
    start.record()
    func(input)  # Call the function we want to profile
    # Record the end time after the function has completed
    end.record()
    # Synchronize the CUDA operations to ensure all operations are completed
    # before measuring the elapsed time
    torch.cuda.synchronize()
    # Calculate and return the elapsed time in milliseconds
    return start.elapsed_time(end)
프로파일링을 더 효율적으로 하려면 앞에서 설명한 대로 PyTorch 프로파일러를 쓰면 됩니다. 예를 들어 다음 코드를 보세요:
import torch
import torch.nn.functional as F

def pytorch_layer_norm(input):
    return F.layer_norm(input, input.size()[1:])

a = torch.randn(10000, 10000).cuda()

with torch.profiler.profile(
    activities=[
        torch.profiler.ProfilerActivity.CPU,  # Profile CPU activities
        torch.profiler.ProfilerActivity.CUDA,  # Profile CUDA activities
    ],
    # Define a schedule for the profiler
    schedule=torch.profiler.schedule(
        wait=1,      # Wait for 1 iteration before starting to profile
        warmup=3,    # Warm up for 3 iterations to stabilize performance
        active=2,    # Profile for 2 active iterations
        repeat=1,    # Repeat the profiling schedule once
    ),
    on_trace_ready=torch.profiler.tensorboard_trace_handler('.'),

) as p:
    for iter in range(10):
        pytorch_layer_norm(a)
        p.step()

# Print a table of the profiling results, sorted by total CUDA time, limited to the top 10 entries
print(p.key_averages().table(sort_by="cuda_time_total", row_limit=8))
이 코드는 프로파일링 집계 결과를 총 CUDA 시간 순으로 정렬해 출력하며, 결과는 다음과 같습니다:
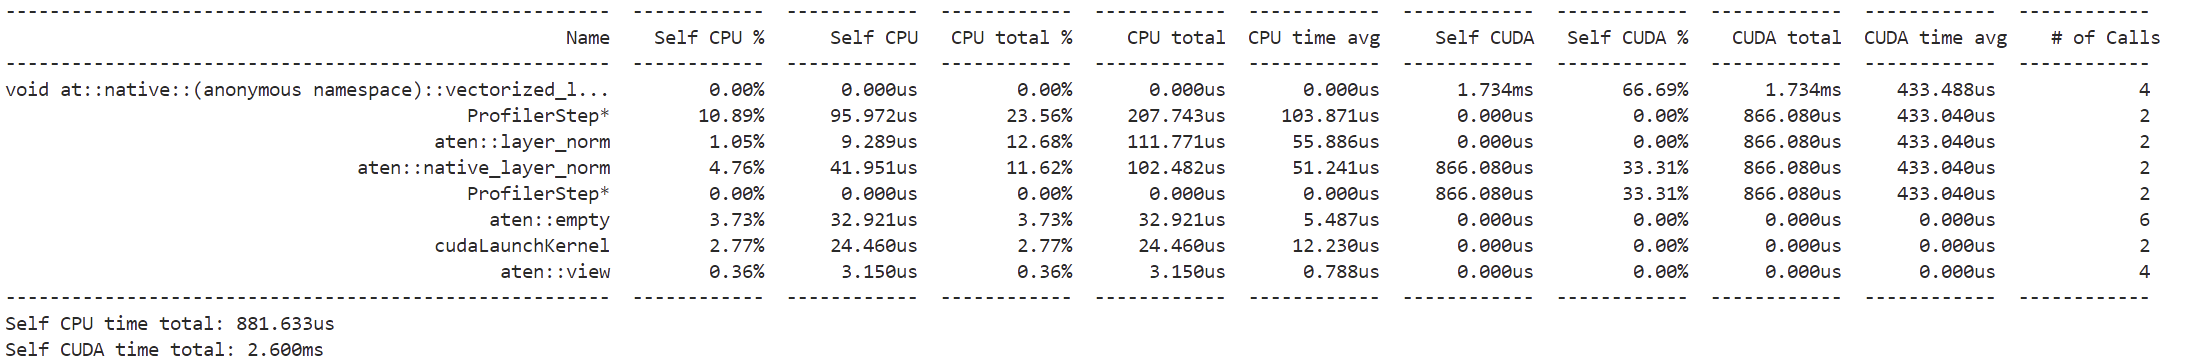
앞에서 말씀드렸듯이 chrome://tracing/에서 트레이스를 살펴볼 수도 있습니다.
💡 팁
이 도구가 처음이라면 왼쪽, 오른쪽 화살표 키로 트레이스 안을 이동할 수 있습니다. 또 Alt 키를 누른 채 마우스를 왼쪽이나 오른쪽으로 스크롤하면 확대하거나 축소할 수 있습니다.
확대해 보면 이 트레이스에서 layer_norm을 호출할 때 연산이 어떤 흐름으로 진행되는지 볼 수 있습니다:
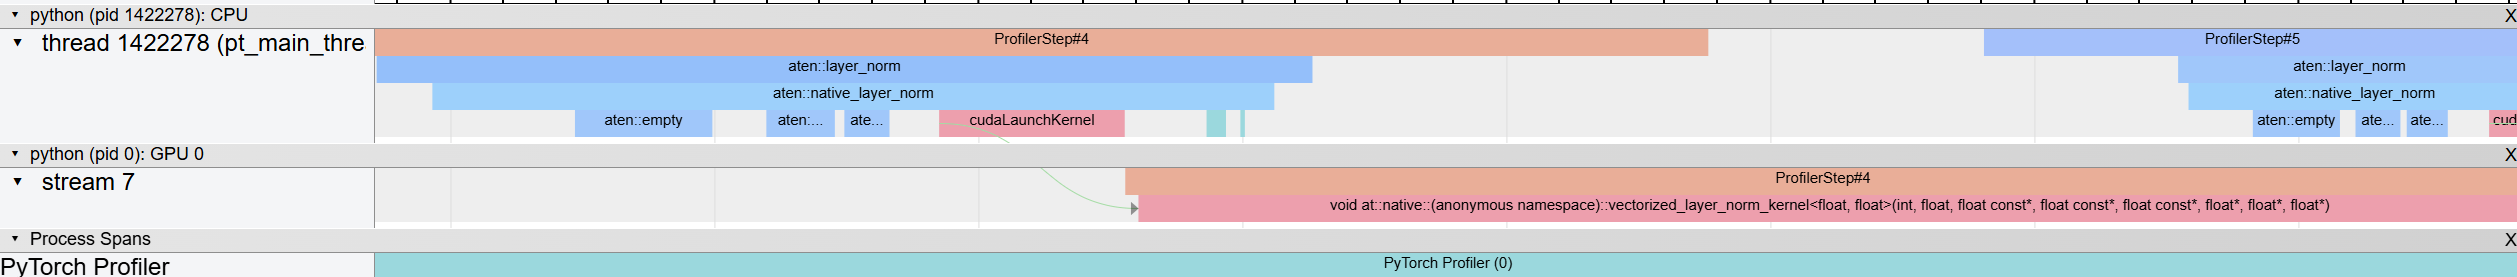
흐름은 CPU(위쪽 구역)에서 aten::layer_norm으로 시작해 aten::native_layer_norm으로 넘어가고, 이어서 cudaLaunchKernel로 옮겨 갑니다. 거기서 GPU로 넘어가 vectorized_layer_norm_kernel 커널이 호출됩니다.
📝 참고
프로파일러에서
profile_memory를True로 설정하면 메모리 프로파일링을 켤 수 있습니다. 다만 그러면 트레이스가 더 복잡해질 수 있습니다.
PyTorch 프로파일러가 성능을 빠르게 훑어보게 해 준다면, NVIDIA Nsight Compute CLI(ncu)는 커널마다 자세한 실행 시간과 메모리 사용량까지 포함해 GPU 성능을 더 깊이 들여다보게 해 줍니다. 프로파일러를 돌리는 방법은 간단합니다:
ncu --set full python layer_norm.py여기서 layer_norm.py는 레이어 정규화 함수를 실행하는 간단한 파일입니다. 이 명령은 로그 출력을 만들어 내지만, 결과를 시각화하려면 출력 플래그를 지정하는 편이 더 효과적입니다:
ncu --set full -o output python layer_norm.py그런 다음 output.ncu-rep 파일을 Nsight Compute로 열면 다음과 같은 화면이 나옵니다. 계산과 메모리 활용률에 관한 경고가 분명하게 표시되고, 커널이 계산과 메모리 사이의 균형을 더 잘 맞추고 최대 점유율에 이르도록 고치는 요령도 함께 나옵니다:
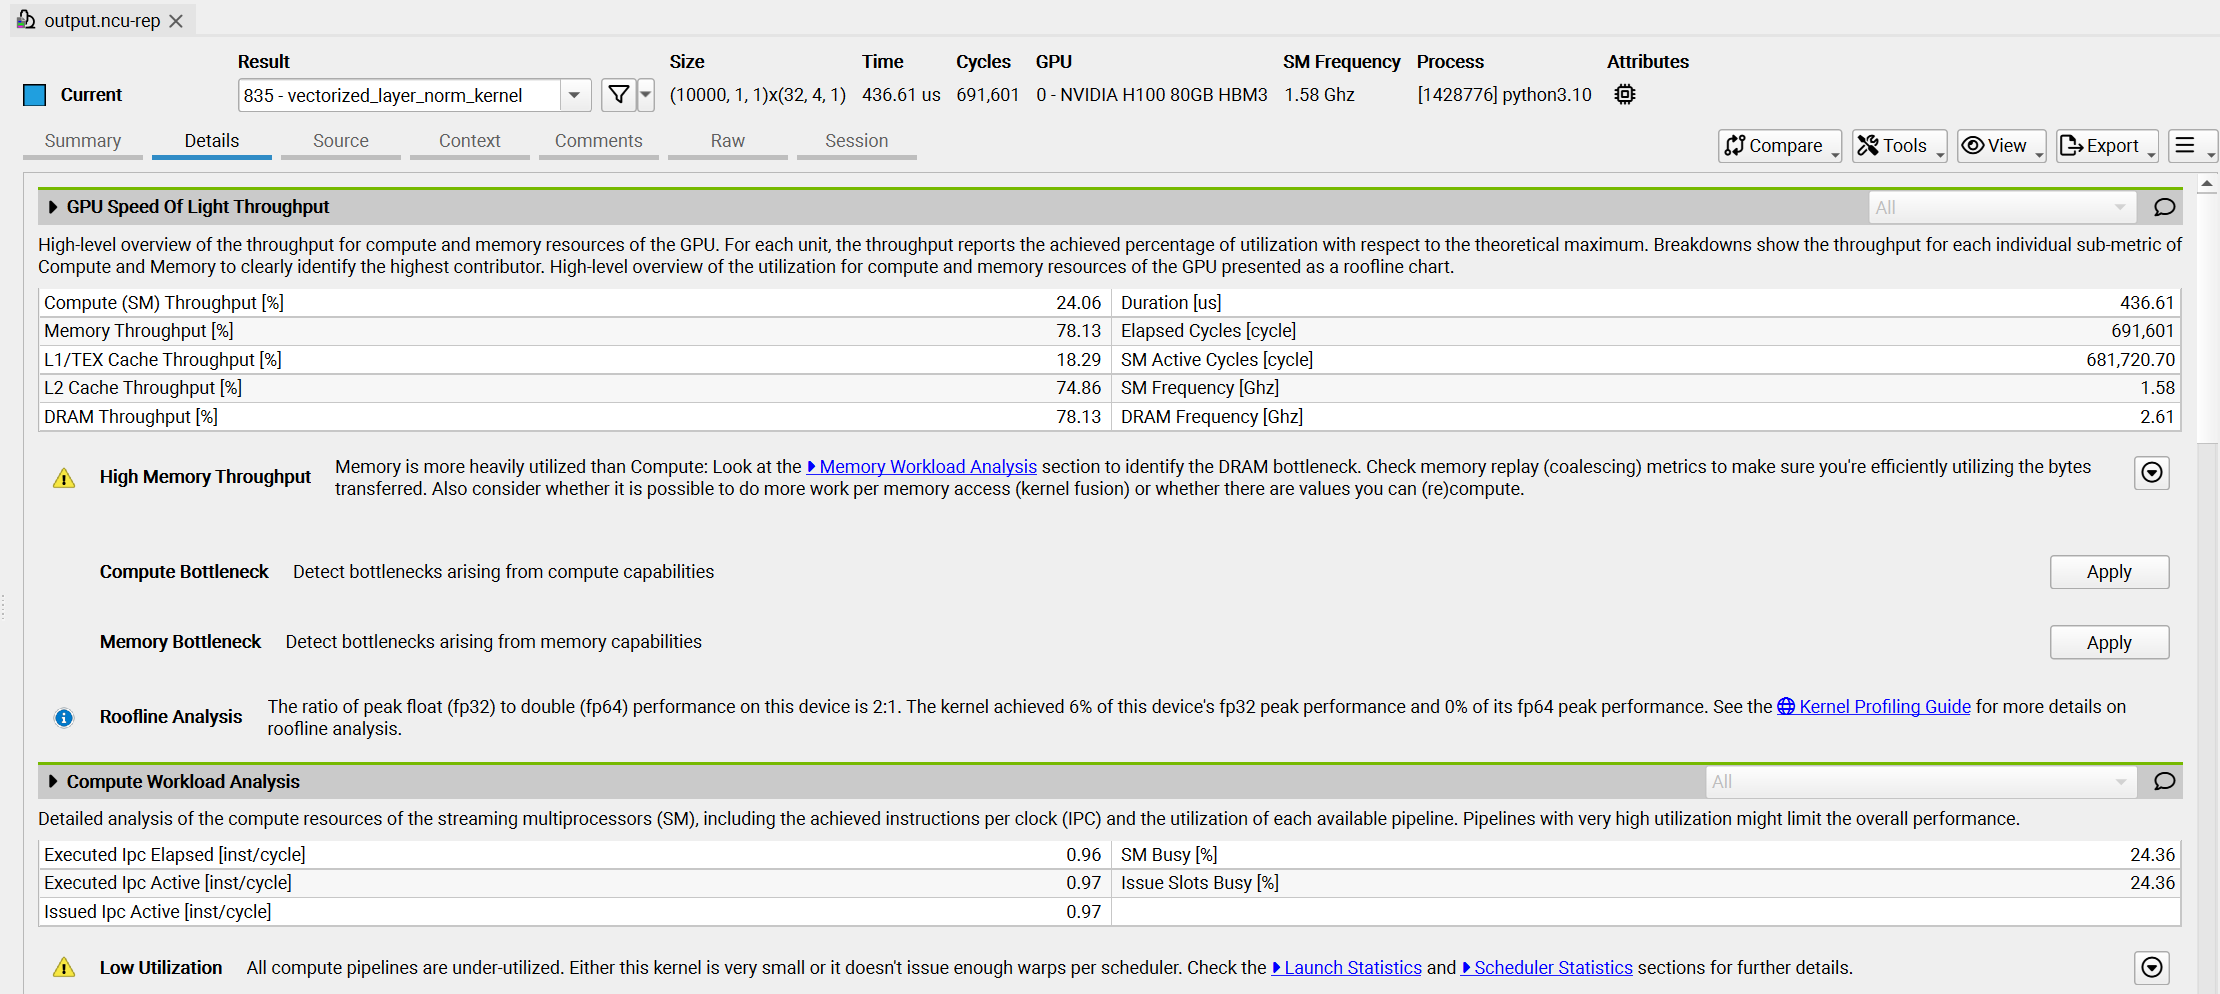
CPP 확장
프로파일링하려는 커널이 아직 PyTorch에 통합되어 있지 않다면, PyTorch의 cpp_extension 모듈로 커스텀 CUDA 코드를 손쉽게 컴파일하고 실행할 수 있습니다. 과정은 간단합니다. CUDA 커널을 .cu 파일에 작성하고, cpp_extension 모듈의 load 함수로 Python에서 불러오기만 하면 됩니다.
간단한 add 커널이라면 .cu 파일은 다음과 같습니다:
#include <torch/extension.h>
#include <cuda.h>
#include <cuda_runtime.h>

__global__ void add_kernel(float* x, float* y, float* output, int size) {
    int index = blockIdx.x * blockDim.x + threadIdx.x;
    if (index < size) {
        output[index] = x[index] + y[index];
    }
}

void add_cuda(torch::Tensor x, torch::Tensor y, torch::Tensor output) {
    int threads = 1024;
    int blocks = (x.size(0) + threads - 1) / threads;

    add_kernel<<<blocks, threads>>>(x.data_ptr<float>(), y.data_ptr<float>(), output.data_ptr<float>(), x.size(0));
}
PYBIND11_MODULE(TORCH_EXTENSION_NAME, m) {
    m.def("add_cuda", &add_cuda, "Vector addition (CUDA)");
}
그리고 이 커널을 불러오는 Python 파일은 다음과 같습니다:
import torch
from torch.utils.cpp_extension import load

# Load and compile the CUDA extension
vector_add = load(
    name="vector_add",
    sources=["add_kernel.cu"],
    verbose=True
)

# Define input tensors
size = 10000
x = torch.randn(size, device='cuda')
y = torch.randn(size, device='cuda')
output = torch.empty(size, device='cuda')

# Run the CUDA kernel
vector_add.add_cuda(x, y, output)
이 방법을 쓰면 앞에서 PyTorch 프로파일러나 NVIDIA 도구로 보여 드린 것과 똑같이 커스텀 CUDA 커널도 프로파일링할 수 있습니다.
A2: LLM 학습의 전형적인 규모
LLM 학습에서 다루는 것들이 보통 어느 정도 크기인지 감을 잡아 보겠습니다. 메모리나 계산량을 이야기할 때는 흔히 “원소”의 개수를 셉니다. 원소는 텐서 안에 든 숫자라고 생각하면 됩니다. 실제 메모리를 바이트 단위로 구하려면 숫자 하나의 크기를 곱해야 합니다(예: BF16은 2바이트, FP32는 4바이트).
대략적인 수치를 빠르게 짚어 보면 다음과 같습니다:
- 입력 토큰: 배치마다 개의 토큰을 처리합니다. 여기서 는 마이크로배치 크기이고 는 시퀀스 길이입니다.
- 활성값(은닉 상태): 레이어 하나에서 은닉 상태 텐서의 크기는 개 원소입니다.
- 모델 가중치와 그래디언트: 모델의 가중치 행렬(예: 선형 레이어) 하나에는 약 개의 원소가 들어 있습니다. 그래디언트의 크기는 가중치와 같습니다.
- 옵티마이저 상태: 가중치 행렬(개 원소) 하나마다, 혼합 정밀도로 학습하는 Adam 같은 옵티마이저는 모멘텀 상태와 분산 상태를 FP32 정밀도로 들고 있고(), 여기에 FP32 마스터 가중치()도 둡니다. 그래서 옵티마이저 상태의 총개수는 가중치 행렬 하나당 약 ()개가 됩니다.
- 모델 전체 파라미터: 트랜스포머 블록마다 다음을 저장합니다:
- 어텐션 파라미터:
- QKV 프로젝션: 파라미터 개
- 출력 프로젝션: 파라미터 개
- 게이트 선형 유닛을 쓰는 MLP 파라미터:
- 게이트 프로젝션과 업 프로젝션: 파라미터 개(크기가 인 행렬 2개)
- 다운 프로젝션: 파라미터 개(크기가 인 행렬 1개)
- 블록당 합계: GLU MLP를 쓰면 , GLU를 쓰지 않으면
- 모델 전체: (GLU를 쓸 때)
- 추가 파라미터:
- 입력 임베딩:
- LM 헤드: (입력 임베딩과 가중치를 묶지 않은 경우)
- 위치 임베딩(쓰는 경우):
- 어텐션 파라미터:
- 순전파와 역전파의 계산량: 순전파의 FLOPS를 아주 거칠게 어림하면 입니다. 역전파의 계산량은 그 두 배인 입니다.
📝 참고
순전파와 역전파를 합친 FLOPs를 더 정확하게 구하는 공식은 입니다. 이 식은 시퀀스 전체에 걸친 어텐션 연산 때문에 생기는 제곱 비례 증가까지 반영하지만, 계산을 단순하게 하려고 여기서는 라고 가정합니다.
A3: 계산과 통신 겹치기의 수학
앞 절의 공식을 쓰면 분산 학습에서 계산과 통신을 언제 효과적으로 겹칠 수 있는지 어림할 수 있습니다. 데이터 병렬화(ZeRO-0)를 예로 들어 보겠습니다.
데이터 병렬화 통신 분석
통신해야 하는 그래디언트의 전체 크기는 다음과 같습니다:
- 그래디언트 = 파라미터 ≈
역전파 동안에는 이 그래디언트를 버킷(기본 크기 25 MB) 단위로 통신합니다. 버킷 하나를 AllReduce하는 데 걸리는 통신 시간은 다음과 같습니다:
📝 참고
대역폭 계산에는 NCCL 문서에 나오는 버스 대역폭 공식을 씁니다. 이 공식들은 GPU 사이의 실효 대역폭을 계산할 때 통신 패턴마다 다른 특성을 반영합니다.
역전파의 계산 시간은 다음과 같습니다:
효과적으로 겹치려면 다음 조건을 만족해야 합니다:
이 비율을 보면 학습에서 통신이 병목이 될지 판단할 수 있습니다. 비율이 1보다 작으면 통신을 계산과 완전히 겹칠 수 있습니다.
ZeRO-3(FSDP) 통신 분석
ZeRO-3에서는 파라미터와 그래디언트를 여러 GPU에 샤딩합니다. 트랜스포머 블록 하나가 파라미터 개로 이루어진 모델에서 통신 패턴을 분석해 보겠습니다:
- 순전파에서 트랜스포머 블록마다:
- 파라미터 AllGather: 랭크당 바이트
- 역전파에서 트랜스포머 블록마다:
- 파라미터 AllGather: 랭크당 바이트
- 그래디언트 ReduceScatter: 랭크당 바이트
- 블록당 총 통신량: 바이트
- 모델 전체의 총 통신량: 바이트
AllGather 연산의 통신 시간은 다음과 같습니다:
디코더 레이어 하나의 순전파 계산 시간은 다음과 같습니다:
계산과 통신을 효과적으로 겹치려면 다음 조건을 만족해야 합니다:
이 비율이 1보다 작으면 다음 레이어의 파라미터 통신을 현재 레이어의 계산 뒤에 숨길 수 있습니다.
TP 통신 분석
텐서 병렬화에서는 TP 영역(예: MLP 블록)에서 활성값을 여러 GPU에 샤딩합니다. 통신 패턴을 분석해 보겠습니다:
- 순전파의 열 선형 연산마다:
- 활성값 AllGather: 랭크당 바이트
- 역전파의 열 선형 연산마다:
- 그래디언트 ReduceScatter: 랭크당 바이트
- 행 선형 연산은 그 반대입니다. 트랜스포머 블록마다 열 선형 연산이 2개, 행 선형 연산이 2개 있습니다.
- 블록당 총 통신량: 바이트
- 모델 전체의 총 통신량: 바이트
레이어 안의 TP 영역 하나를 골라, AllGather 통신을 다음 선형 레이어의 계산과 겹칠 수 있는지 분석해 보겠습니다. AllGather 연산의 통신 시간은 다음과 같습니다:
한편 다음 선형 레이어(파라미터 개)의 계산 시간은 다음과 같습니다:
효과적으로 겹치려면 통신 시간이 계산 시간보다 짧아야 합니다:
이 비율을 보면 AllGather 통신을 다음 선형 레이어의 계산 뒤에 제대로 숨길 수 있는지 알 수 있습니다. 흥미롭게도 이 비율은 은닉 차원 와 텐서 병렬화 차수 에만 달려 있고, 시퀀스 길이나 배치 크기와는 상관이 없습니다.
PP 통신 분석
파이프라인 병렬화에서는 파이프라인 스테이지 사이에서 활성값과 그래디언트를 주고받습니다. 통신 패턴을 분석해 보겠습니다:
- 순전파의 마이크로배치마다:
- 활성값 받기와 보내기: 바이트
- 역전파의 마이크로배치마다:
- 그래디언트 받기와 보내기: 바이트
- 마이크로배치당 총 통신량: 바이트
- 그래디언트 누적 스텝 수가 일 때 총 통신량: 바이트
활성값/그래디언트 통신을 다음 트랜스포머 블록의 계산과 겹칠 수 있는지 분석해 보겠습니다. 다음 스테이지에 있는 트랜스포머 블록들의 계산 시간은 다음과 같습니다:
한편 P2P 전송의 통신 시간은 다음과 같습니다:
효과적으로 겹치려면 다음 조건을 만족해야 합니다:
TP와 마찬가지로 이 비율도 시퀀스 길이나 배치 크기와는 상관이 없습니다. 이 비율을 좌우하는 것은 은닉 차원 , 다음 스테이지의 레이어 수, 그리고 하드웨어의 계산 성능과 P2P 대역폭 사이의 비율입니다.
인용
학술적인 맥락에서 출처를 밝힐 때는 이 책을 다음과 같이 인용해 주세요.
Tazi et al., "The Ultra-Scale Playbook: Training LLMs on GPU Clusters", 2025.BibTeX 인용 정보
@misc{ultrascale_playbook,
      title={The Ultra-Scale Playbook: Training LLMs on GPU Clusters},
      author={Nouamane Tazi, Ferdinand Mom, Haojun Zhao, Phuc Nguyen, Mohamed Mekkouri, Leandro Werra, Thomas Wolf},
      year={2025},
}
각주
-
Sam McCandlish 외, An Empirical Model of Large-Batch Training, arXiv:1812.06162, 2018. ↩
-
DeepSeek-AI 외, DeepSeek-V3 Technical Report, arXiv:2412.19437, 2024. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7
-
Paulius Micikevicius 외, Mixed Precision Training, arXiv:1710.03740, 2018. ↩ ↩2
-
Vijay Korthikanti 외, Reducing Activation Recomputation in Large Transformer Models, arXiv:2205.05198, 2022. ↩ ↩2
-
Samyam Rajbhandari 외, ZeRO: Memory Optimizations Toward Training Trillion Parameter Models, arXiv:1910.02054, 2020. ↩
-
Guanhua Wang 외, Domino: Eliminating Communication in LLM Training via Generic Tensor Slicing and Overlapping, arXiv:2409.15241, 2024. ↩
-
Hao Liu, Matei Zaharia, Pieter Abbeel, Ring Attention with Blockwise Transformers for Near-Infinite Context, arXiv:2310.01889, 2023. ↩
-
William Brandon 외, Striped Attention: Faster Ring Attention for Causal Transformers, arXiv:2311.09431, 2023. ↩
-
Joel Lamy-Poirier, Breadth-First Pipeline Parallelism, arXiv:2211.05953, 2023. ↩
-
Penghui Qi 외, Zero Bubble Pipeline Parallelism, arXiv:2401.10241, 2023. ↩ ↩2
-
Albert Q. Jiang 외, Mixtral of Experts, arXiv:2401.04088, 2024. ↩
-
William Fedus, Barret Zoph, Noam Shazeer, Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, arXiv:2101.03961, 2022. ↩
-
Weilin Cai 외, A Survey on Mixture of Experts, arXiv:2407.06204, 2024. ↩
-
Dmitry Lepikhin 외, GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding, arXiv:2006.16668, 2020. ↩
-
Tri Dao 외, FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, arXiv:2205.14135, 2022. ↩
-
Houwen Peng 외, FP8-LM: Training FP8 Large Language Models, arXiv:2310.18313, 2023. ↩
-
torchao maintainers and contributors, torchao: PyTorch native quantization and sparsity for training and inference, GitHub (https://github.com/pytorch/ao), 2024. ↩
-
Mitchell Wortsman 외, Small-scale proxies for large-scale Transformer training instabilities, arXiv:2309.14322, 2023. ↩