Anson Ho 외: AI 벤치마크를 위한 로제타석Anson Ho et al.: A Rosetta Stone for AI benchmarks
대부분의 벤치마크는 너무 빨리 포화되어 AI의 장기 추세를 볼 수 없다는 문제를, 여러 벤치마크를 하나의 통계 틀로 이어 붙여 풀고, 그 결과로 능력 추세, 소프트웨어 효율, 능력 가속 감지까지 다룬 Epoch AI의 글Most benchmarks saturate too quickly to study long-run AI trends. We solve this using a statistical framework that stitches benchmarks together, with big implications for algorithmic progress and AI forecasting.
번역문 · 원저자: Anson Ho, Jean-Stanislas Denain, David Atanasov, Samuel Albanie, Rohin Shah · 원문: A Rosetta Stone for AI benchmarks · 원문 라이선스: CC BY 4.0. 원문을 한국어로 옮긴 것 말고는 내용을 바꾸지 않았습니다.
원문: 「A Rosetta Stone for AI benchmarks」, Anson Ho, Jean-Stanislas Denain, David Atanasov, Samuel Albanie, Rohin Shah, Epoch AI, https://epoch.ai/blog/a-rosetta-stone-for-ai-benchmarks, 2025년 12월 2일 게시. 이 글은 원문을 한국어로 옮긴 번역문입니다.
라이선스: 원문 하단에 “Epoch AI의 저작물은 출처와 저자를 밝히면 Creative Commons 저작자표시 라이선스에 따라 자유롭게 쓰고, 배포하고, 복제할 수 있다”고 적혀 있습니다. 그림에도 “EPOCH AI | CC-BY” 표기가 있어 원문 그림을 그대로 실었습니다. 그림 속 글자는 영어 그대로 두고 아래에 우리말 설명을 붙였습니다.
대부분의 벤치마크는 너무 빨리 포화되어 AI의 장기 추세를 연구하는 데 쓰기 어렵습니다. 저희는 벤치마크들을 이어 붙이는 통계 틀로 이 문제를 풀었고, 이 방법은 알고리즘 발전과 AI 예측에 큰 시사점을 줍니다. 논문 읽기 / 소스 코드
들어가며
저희는 AI의 능력을 재는 데 벤치마크를 씁니다. 하지만 가장 좋은 벤치마크라도 AI가 할 수 있는 일을 좁게 엿보게 해 줄 뿐입니다.
벤치마크 하나를 생각해 봅시다. 모델이 아주 못하면 그 벤치마크에서 0%를 받습니다. 그런데 극도로 못하는 모델도 똑같이 0%를 받습니다. 한 모델이 다른 모델보다 훨씬 낫더라도, 벤치마크는 이 두 모델을 가려낼 신호를 전혀 주지 못합니다.
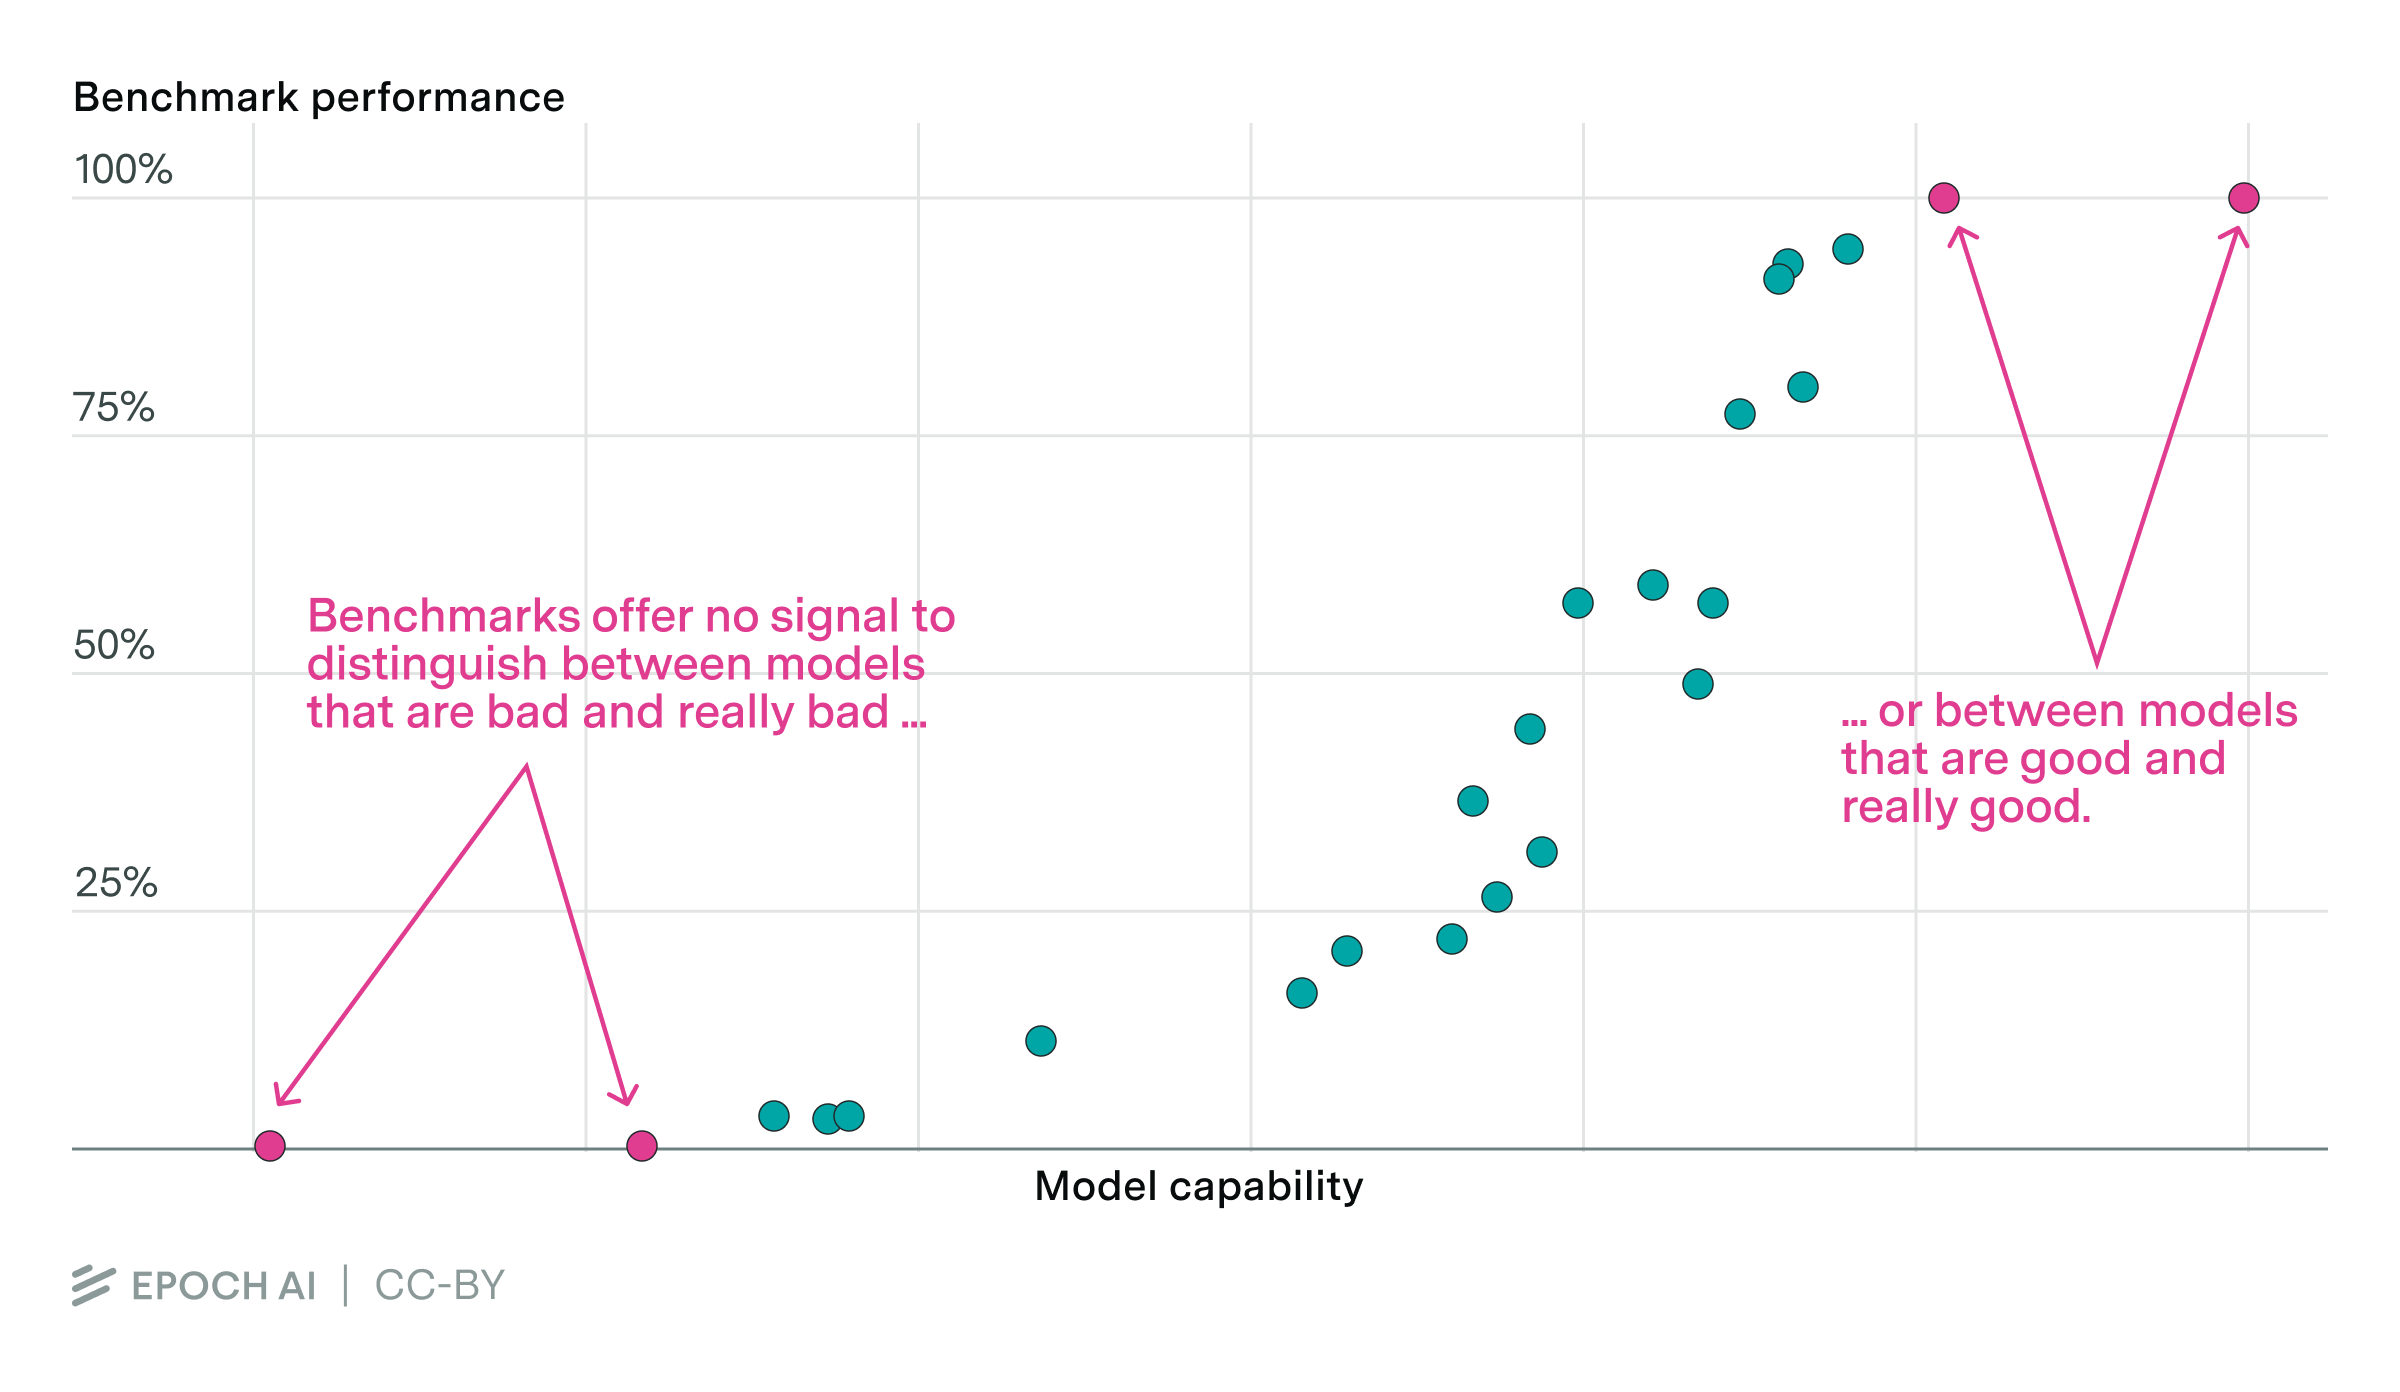
마찬가지로 아주 잘하는 모델은 100%를 받지만, 극도로 잘하는 모델도 100%를 받습니다. 이런 좋은 모델들끼리도 우리는 구별하지 못합니다.
모델을 비교할 수 있는 것은 모델이 중간에 있을 때, 곧 너무 잘하지도 너무 못하지도 않을 때뿐입니다. 그런데 모델이 워낙 빨리 좋아지다 보니 중간에 머무는 시간이 아주 짧습니다. 그래서 AI 발전이 빨라지는지, 느려지는지, 벽에 부딪혔는지 같은 장기 추세를 볼 수가 없습니다.
새로운 접근
그러면 이 문제를 어떻게 풀까요? 저희는 새로운 접근을 제안합니다. 통계 모델을 써서 난이도가 제각각인 여러 벤치마크를 하나의 통일된 틀 아래 “이어 붙이는” 것입니다. 이는 AI 벤치마크를 위한 로제타석과 같아서, 모델들이 같은 벤치마크로 평가받지 않았더라도 폭넓은 벤치마크 사이를 오가며 번역해 모델을 비교할 수 있게 해 줍니다.
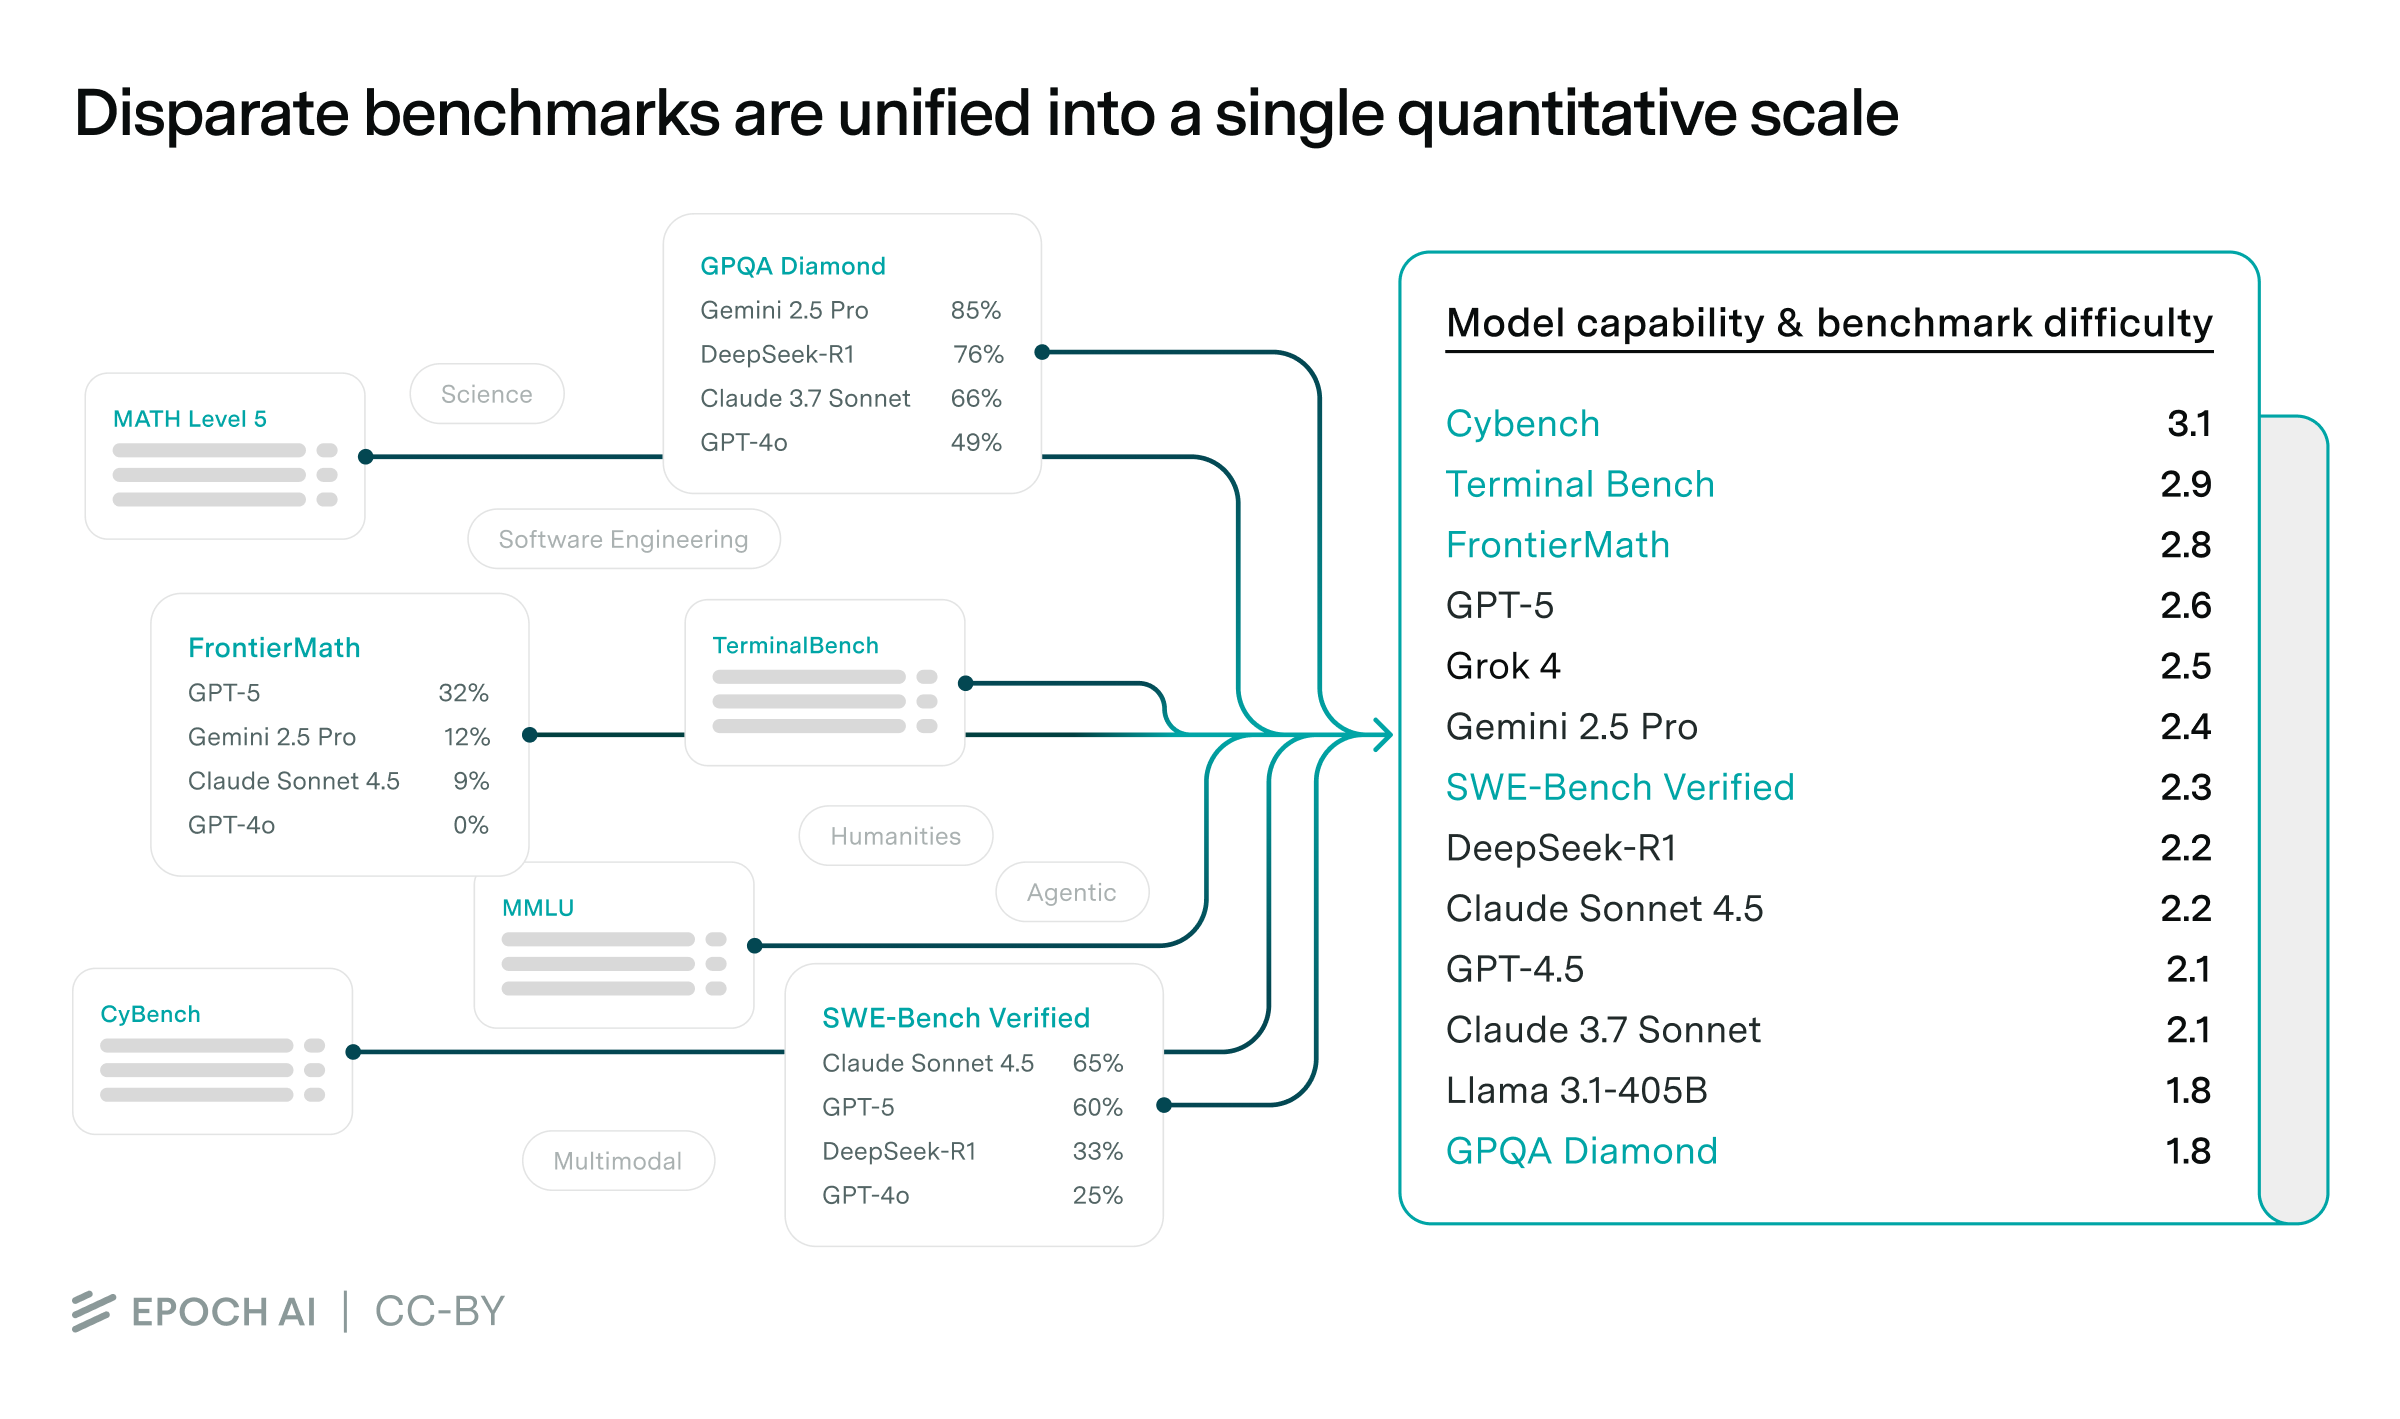
그런데 이게 어떻게 작동할까요? 핵심 생각은 모델마다 그 “능력”을 나타내는 숫자가 하나씩 있다고 가정하는 것입니다. 체스 선수에게 Elo 점수가 있는 것과 비슷합니다. 마찬가지로 벤치마크마다 “난이도” 점수가 하나씩 있는데, 체스 퍼즐에도 Elo 점수가 매겨지는 것과 비슷합니다. 끝으로 벤치마크마다 그 벤치마크가 얼마나 빨리 포화되는지를 나타내는 “기울기”가 있습니다.
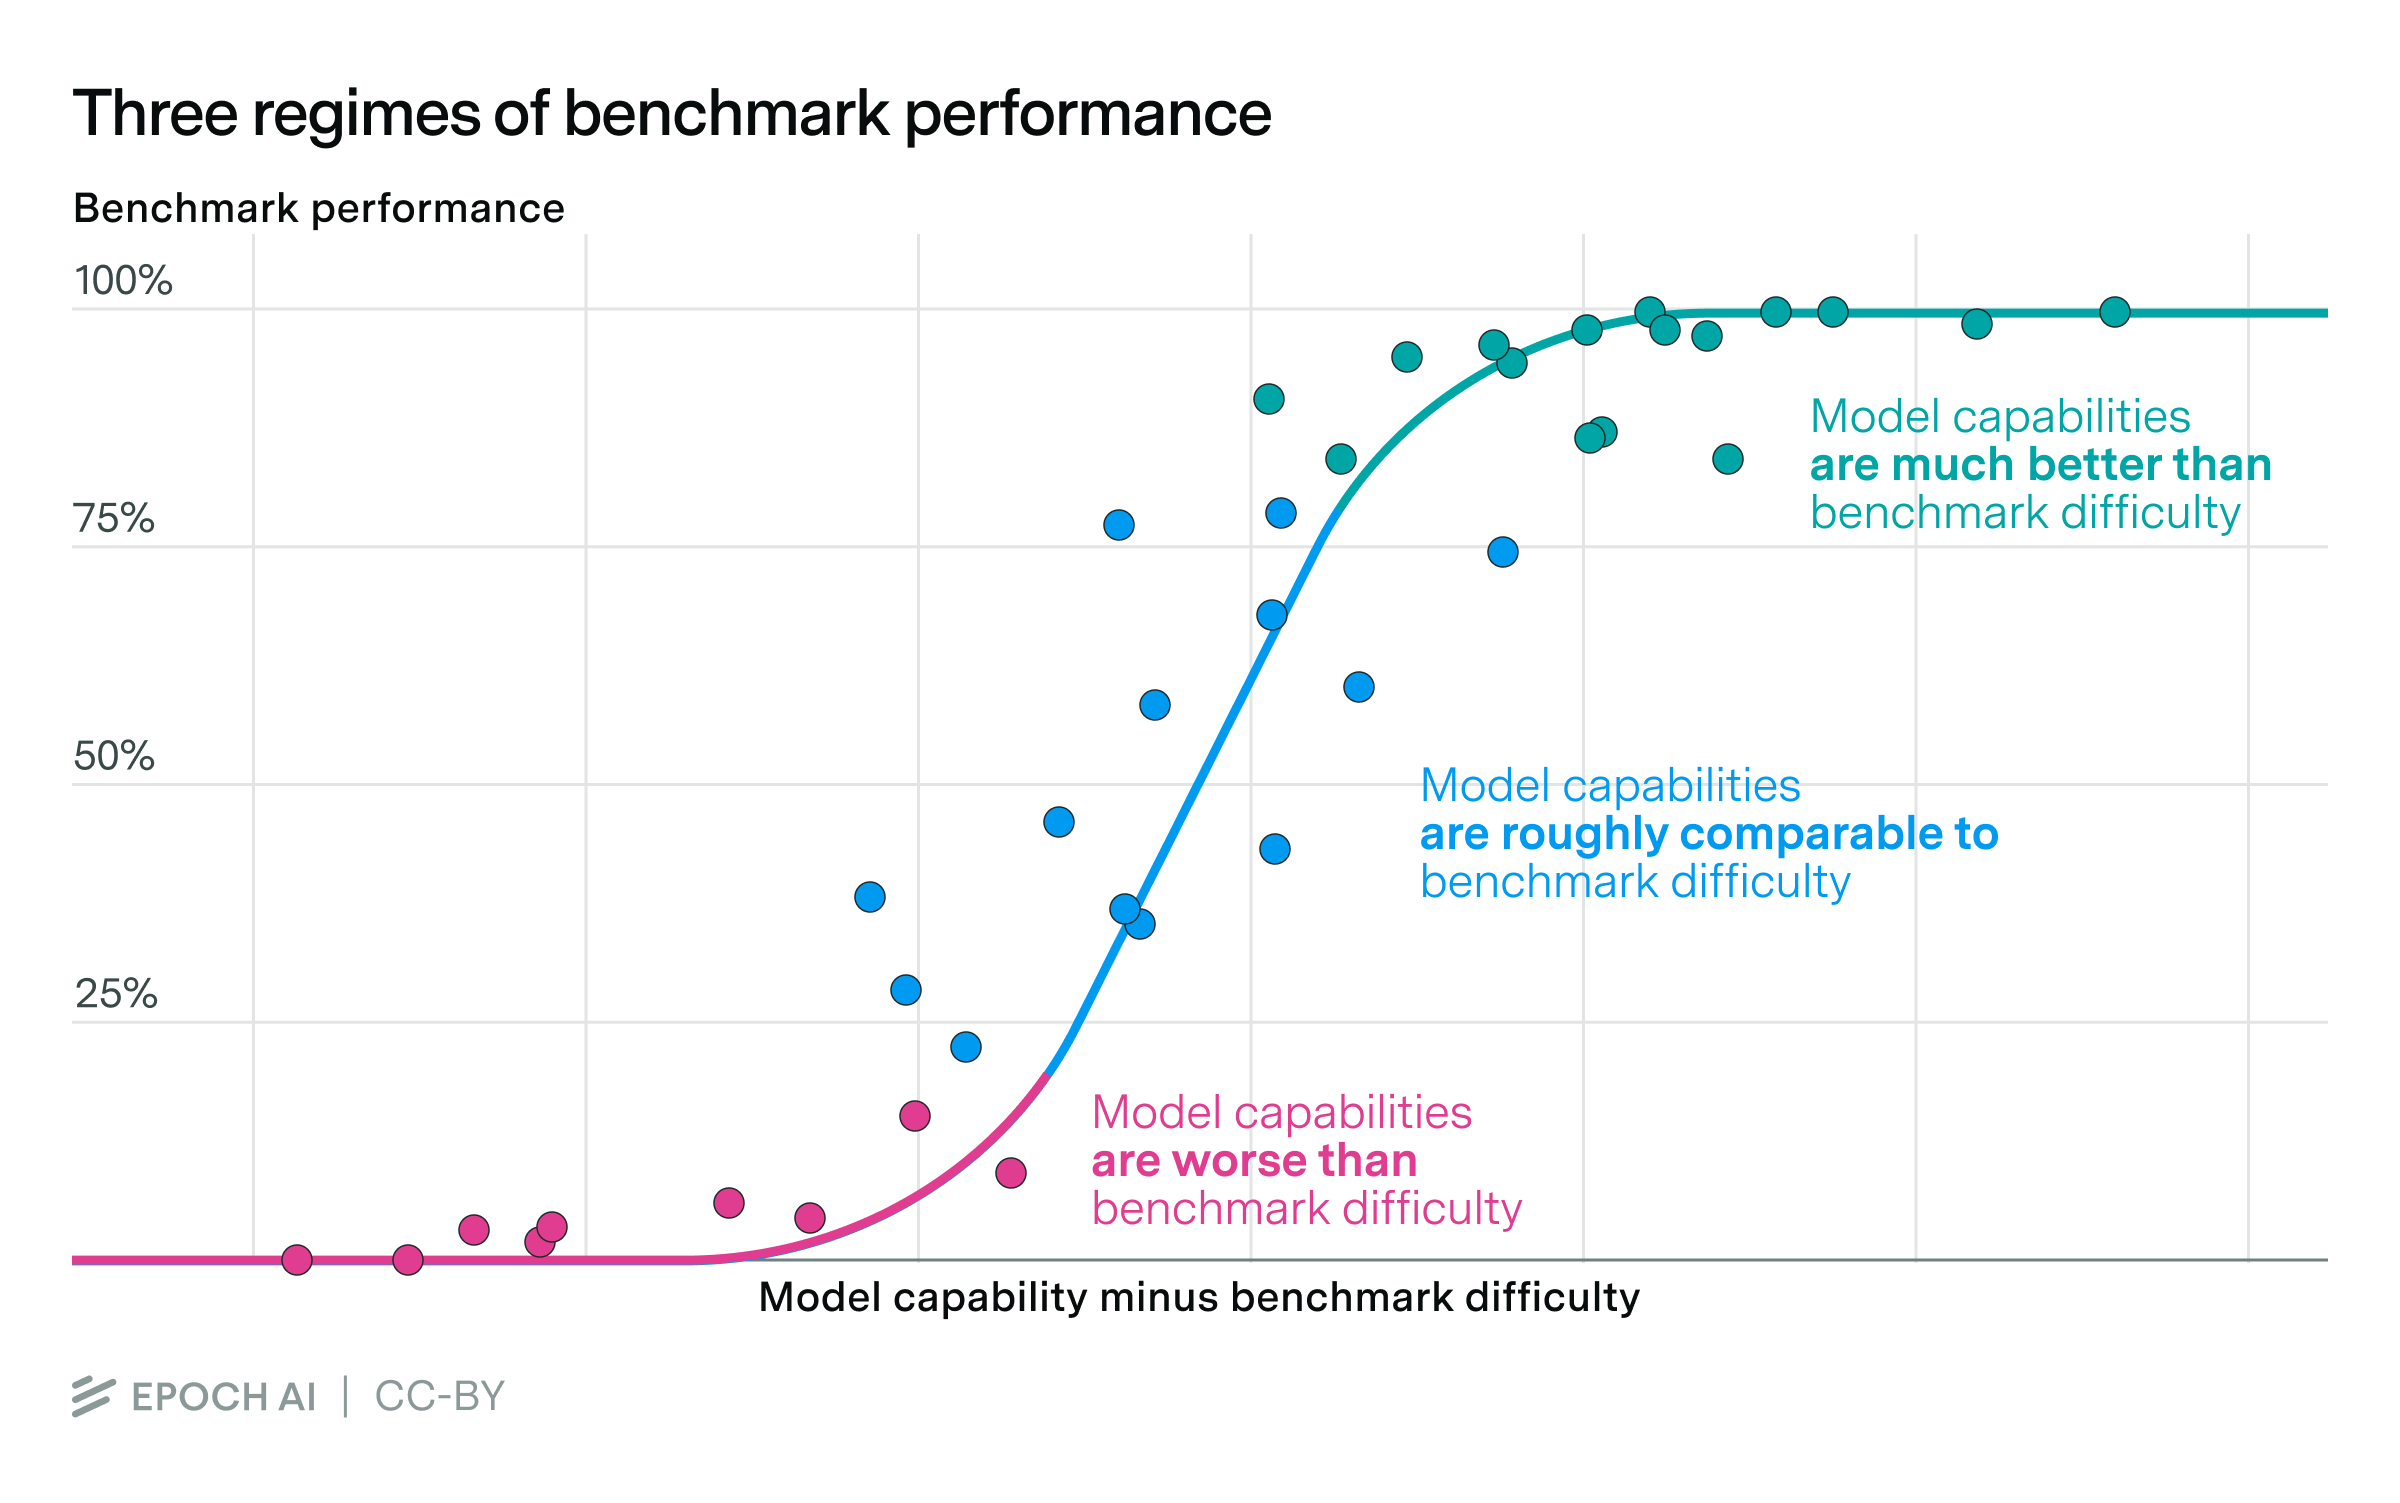
이런 잠재 변수를 추정하려면 실제 벤치마크 점수를 이 변수들에 대응시키는 통계 틀이 필요합니다. 가장 단순한 틀에서는 모델 능력이 벤치마크 성능과 함께 끝없이 선형으로 늘어납니다. 하지만 벤치마크 성능은 0%와 100% 사이에 갇혀 있으므로, 이 대응은 결국 S자 곡선 모양이 되고 세 구간으로 나뉩니다.
- 모델 능력이 벤치마크 난이도보다 훨씬 낮을 때: 벤치마크에 비해 모델이 너무 못하므로 성능은 무작위 기준선보다 나을 것이 없습니다. 이 기준선은 대개 0%이지만 늘 그렇지는 않습니다.1
- 모델 능력이 벤치마크 난이도와 대략 같을 때: S자 곡선의 가운데로, 성능이 능력에 비례해 늘어나며 그 속도는 기울기 변수가 정합니다.
- 모델 능력이 벤치마크 난이도보다 훨씬 높을 때: 이제 모델이 벤치마크에 비해 너무 뛰어나서, 벤치마크는 100%(또는 그 근처)에서 포화됩니다.
마지막으로 저희의 벤치마킹 허브에서 데이터를 모아 이 능력, 난이도, 기울기를 추정합니다. 모두 합쳐 벤치마크 약 40개를 이어 붙였고, 모델 약 200개의 능력을 추정했습니다.
이 틀이 알려 주는 것
이 틀은 모델 능력을 숫자 하나로 담을 수 있다고 가정하는데, 이는 지나친 단순화입니다. 그래도 이 틀로 할 수 있는 일이 많습니다.
우선 저희 방법은 비용이 매우 적게 듭니다. 흔한 모델 리더보드와 달리 사용자가 모델 출력에 투표할 필요도 없고, 새 평가를 돌릴 필요도 없습니다. 기존 데이터를 합치기만 하면 됩니다.
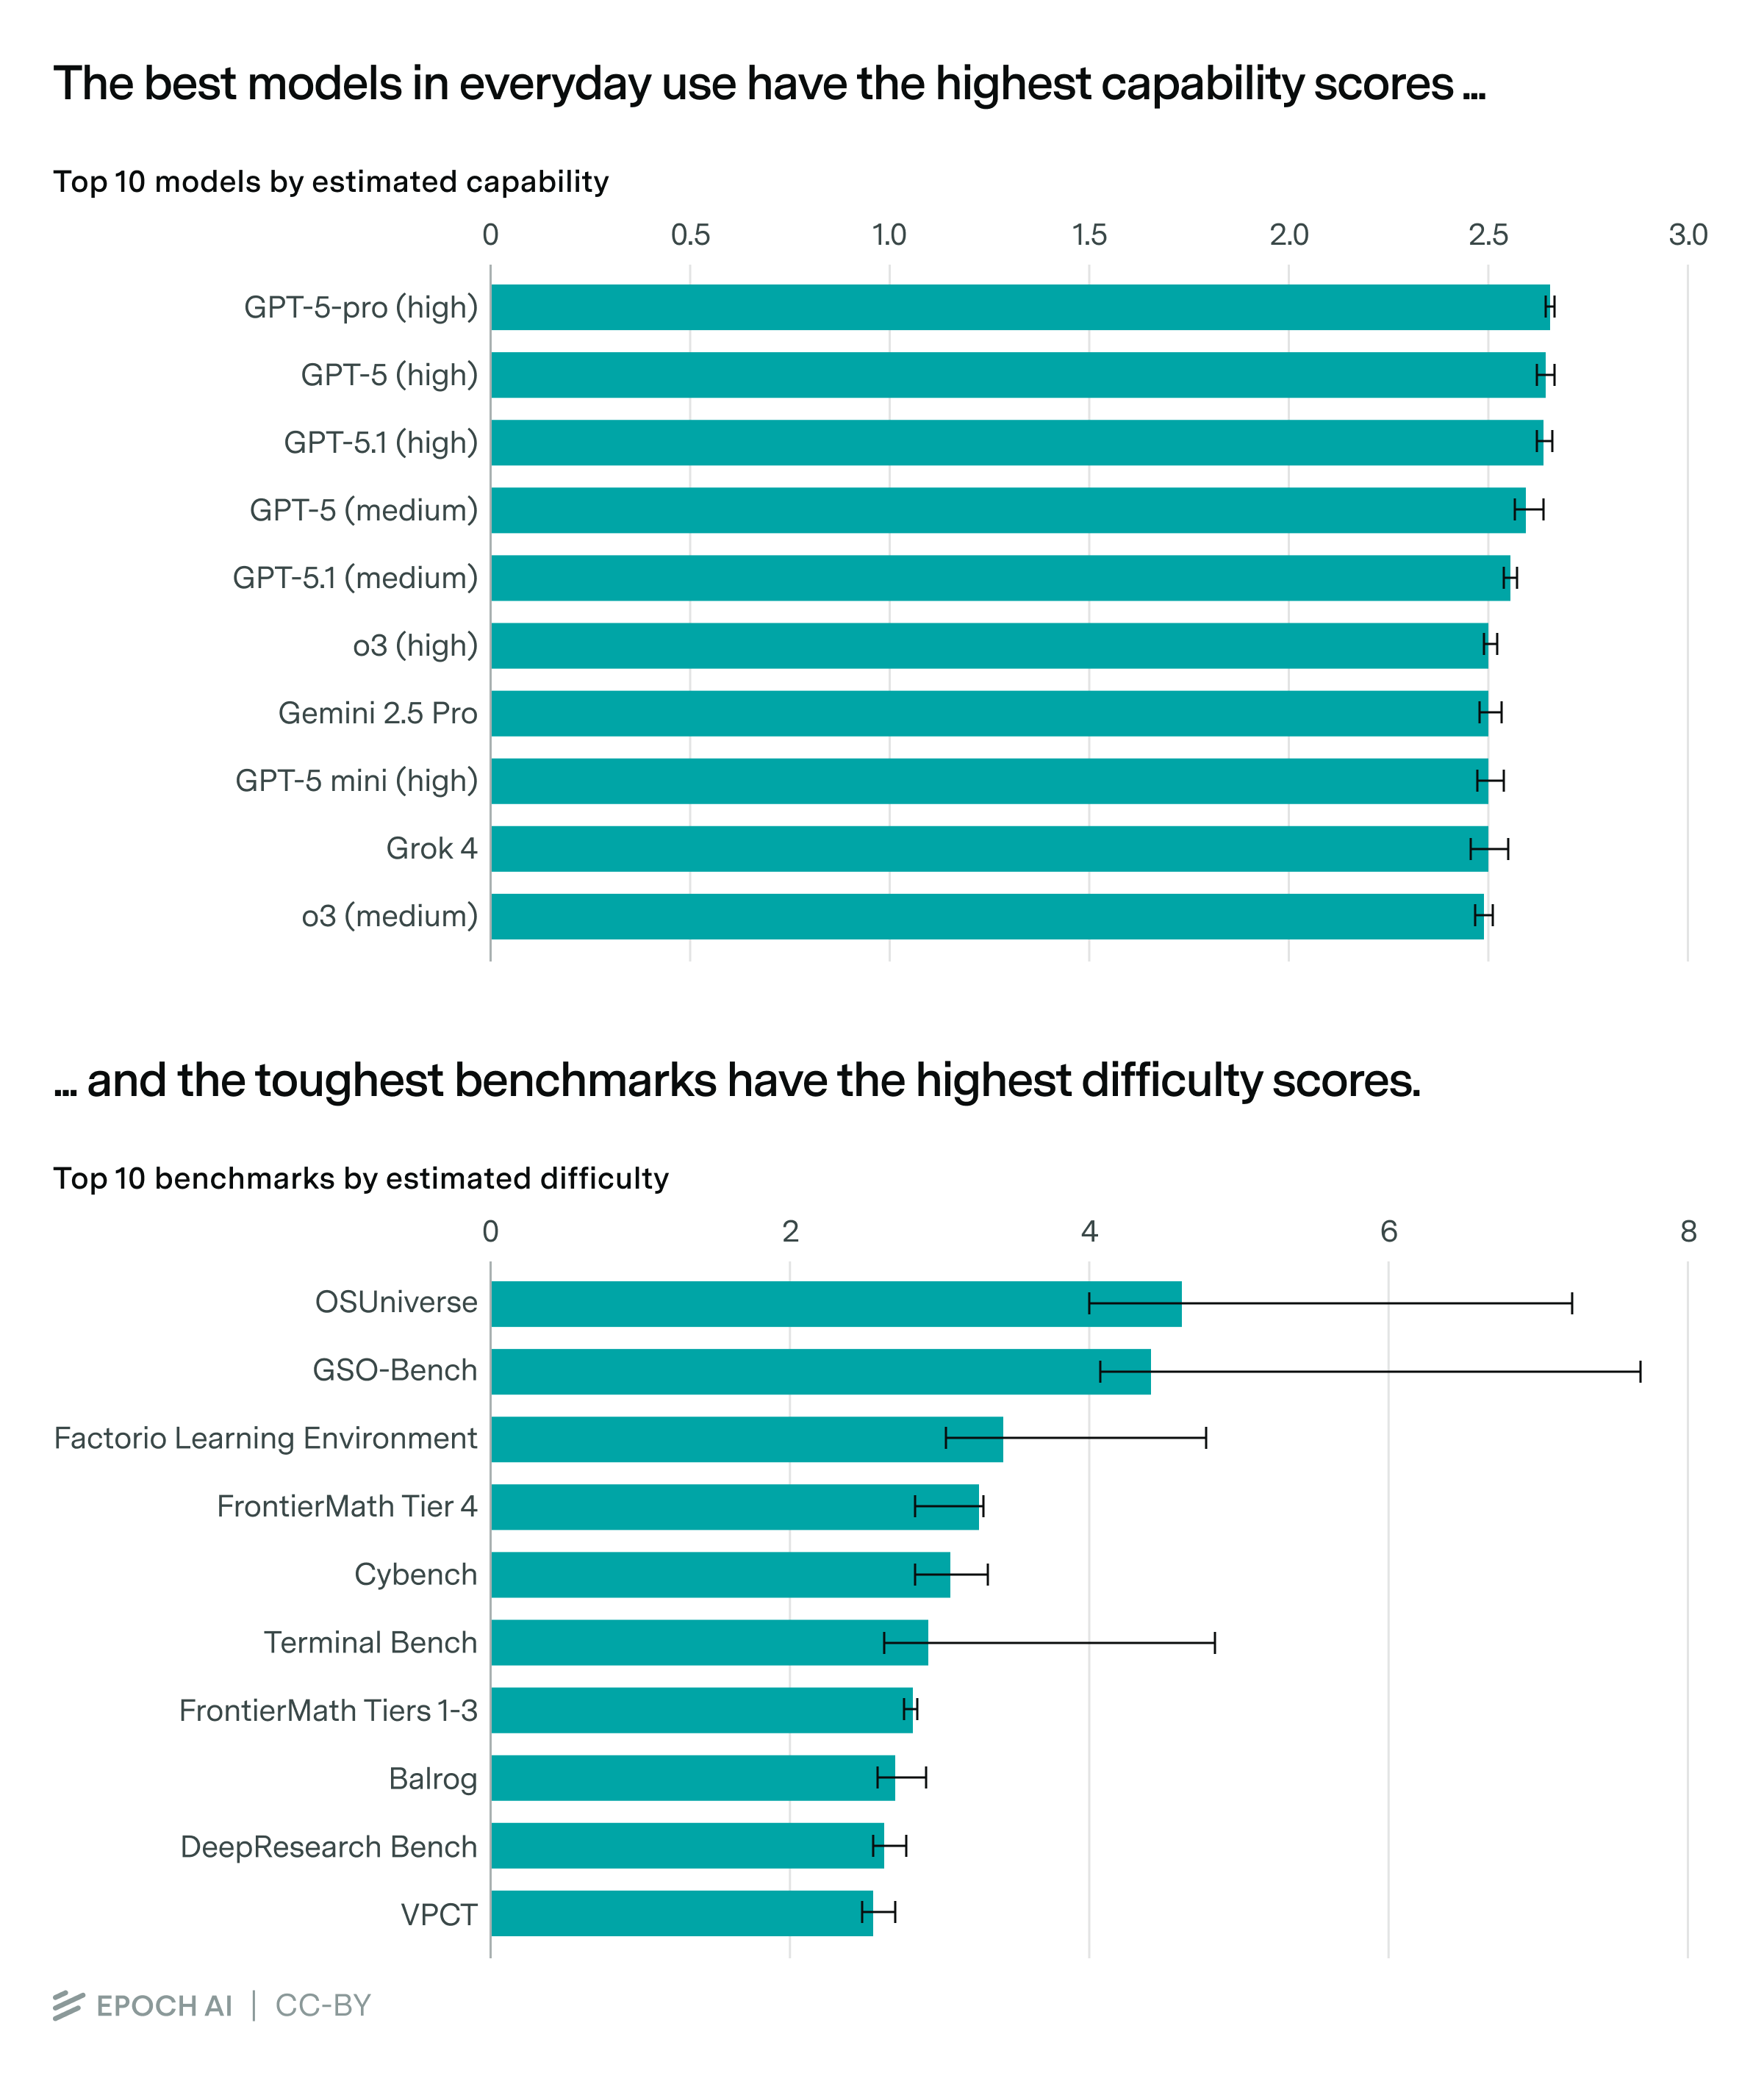
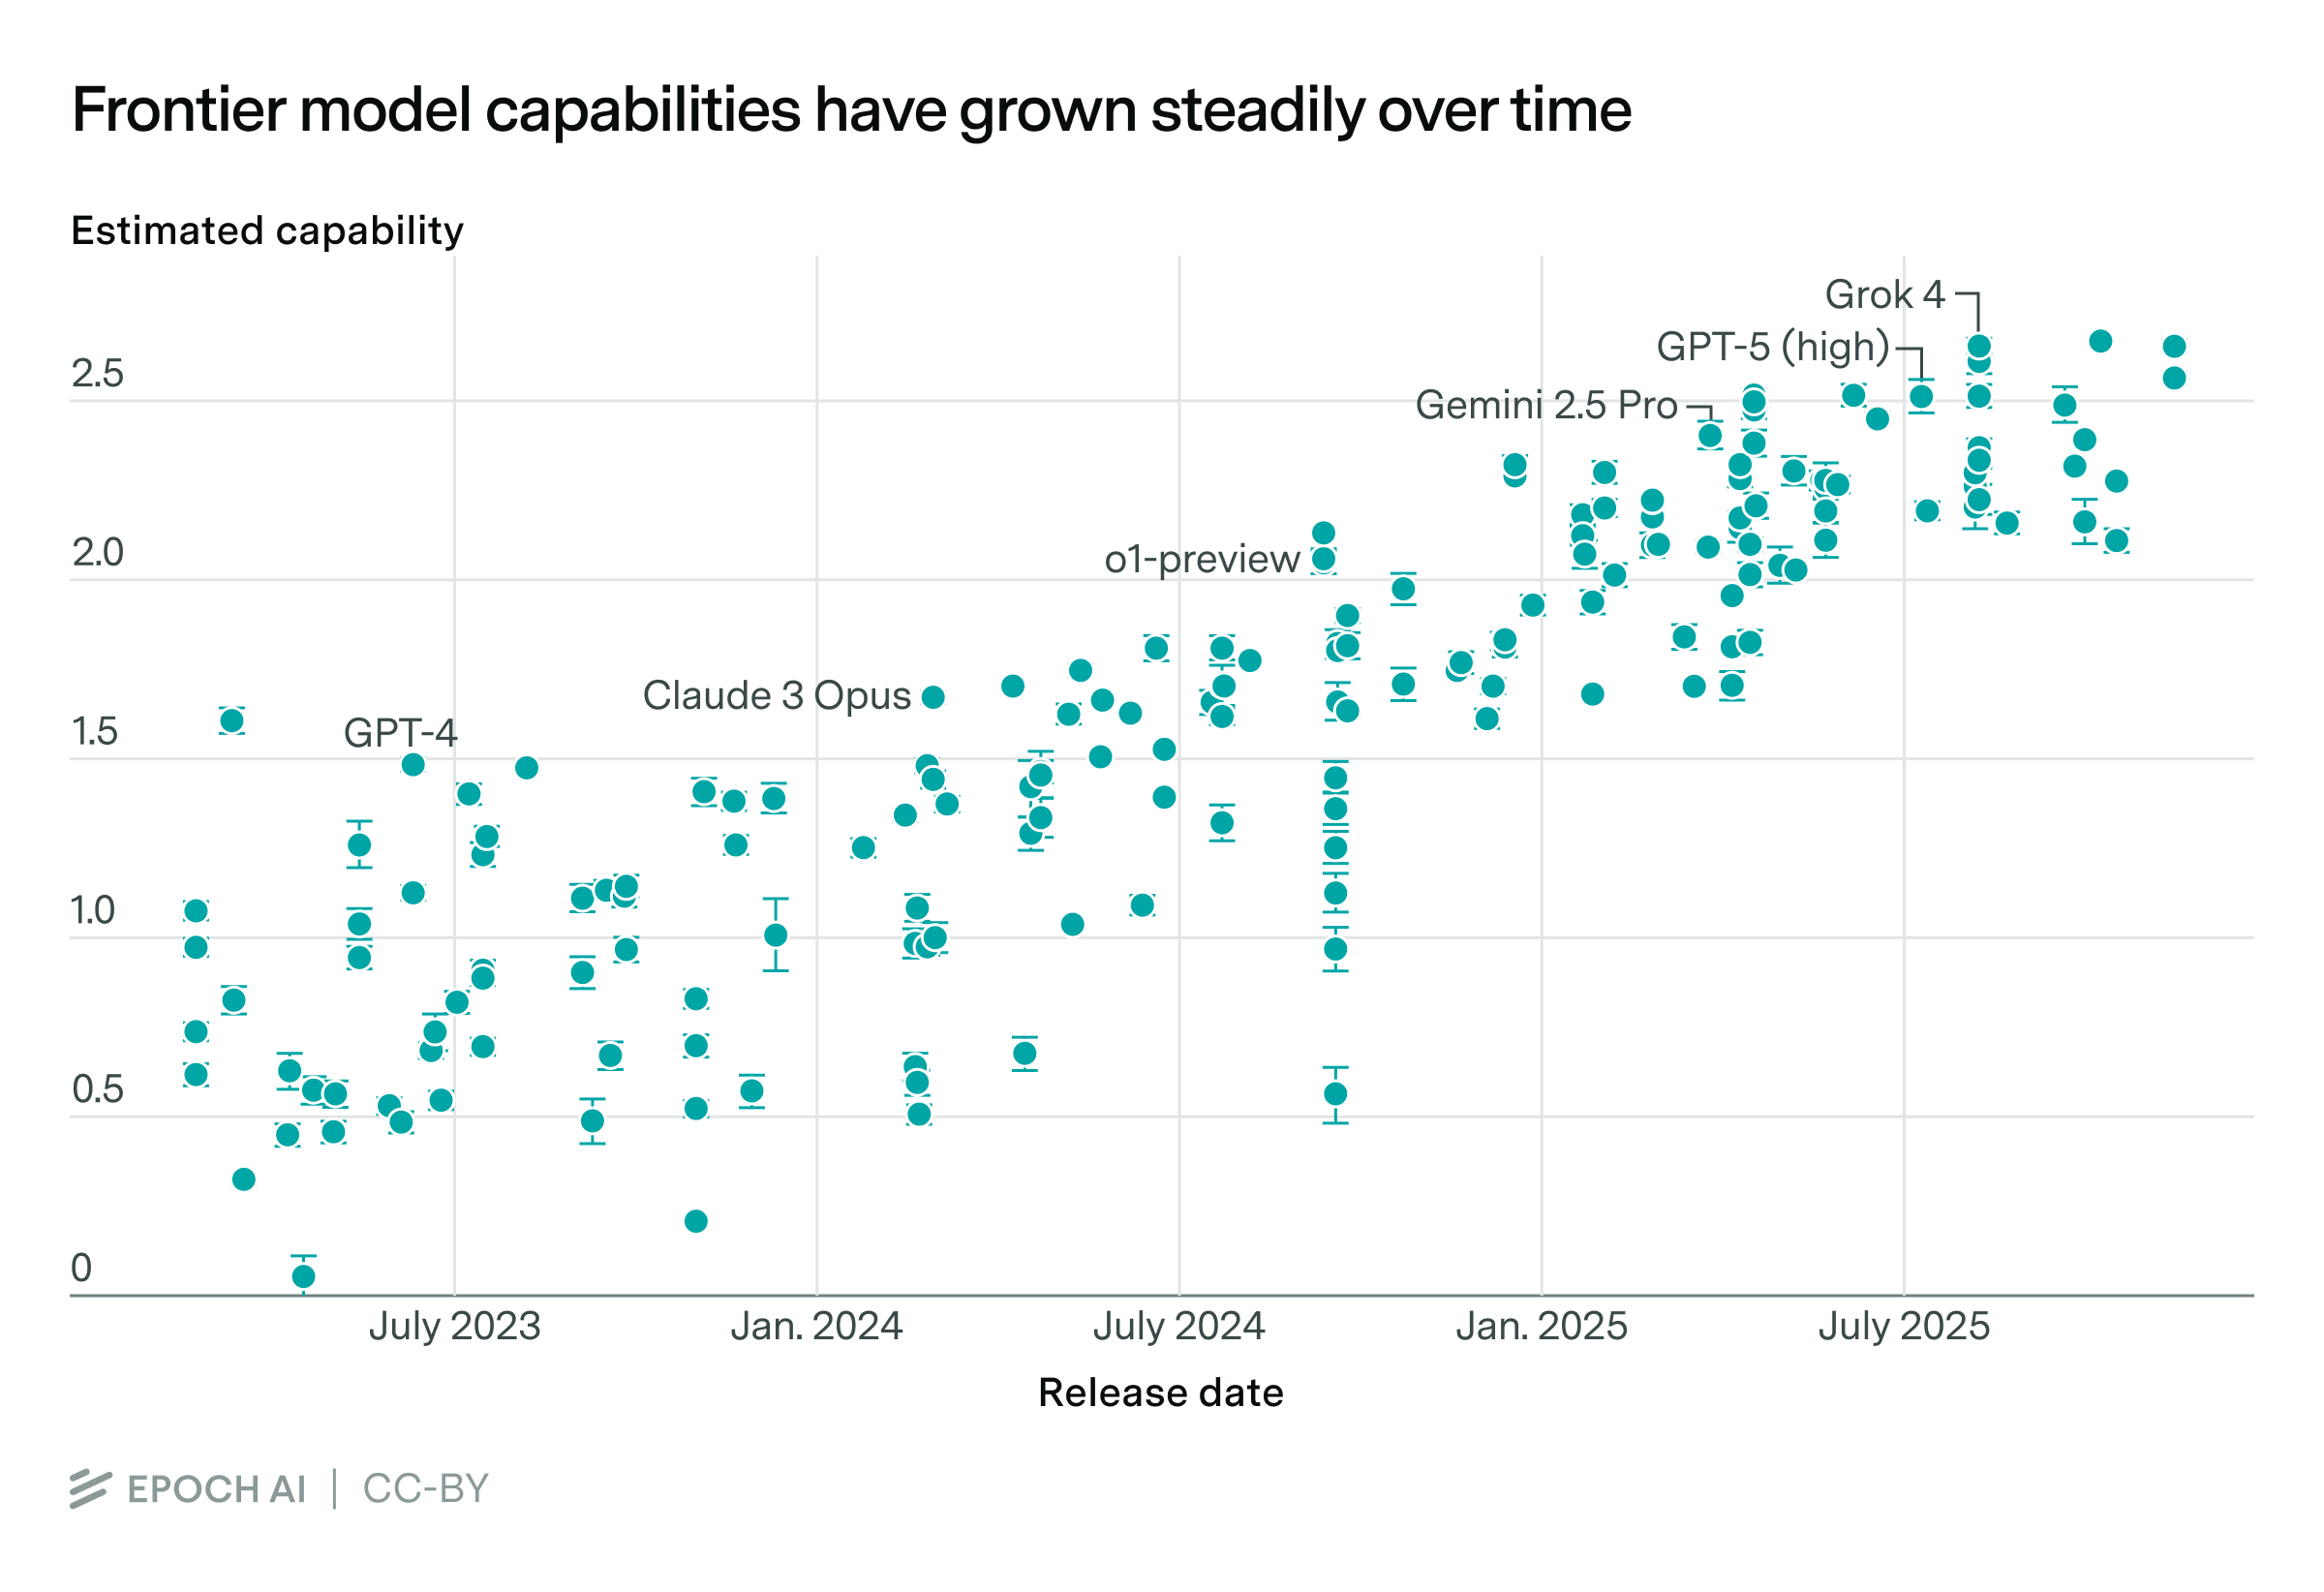
그런데도 다행히 이 방법은 모델 능력과 벤치마크 난이도에 대해 그럴듯한 순위를 내놓습니다. GPT-5.1이나 Gemini 2.5 Pro 같은 모델이 최고 수준 가까이에 있습니다.2 이는 저희가 평가에서, 그리고 이 모델들을 실제로 써 보면서 얻은 직관과 맞습니다.
이 틀로 모델 능력이 시간에 따라 어떻게 달라졌는지도 볼 수 있습니다. 능력에서 최고 수준을 밀어 올린 모델들을 평균하면, 개선 폭은 연간 약 0.6단위입니다. GPT-4.5에서 GPT-5로 넘어가며 일어난 능력 향상과 맞먹는 크기입니다.
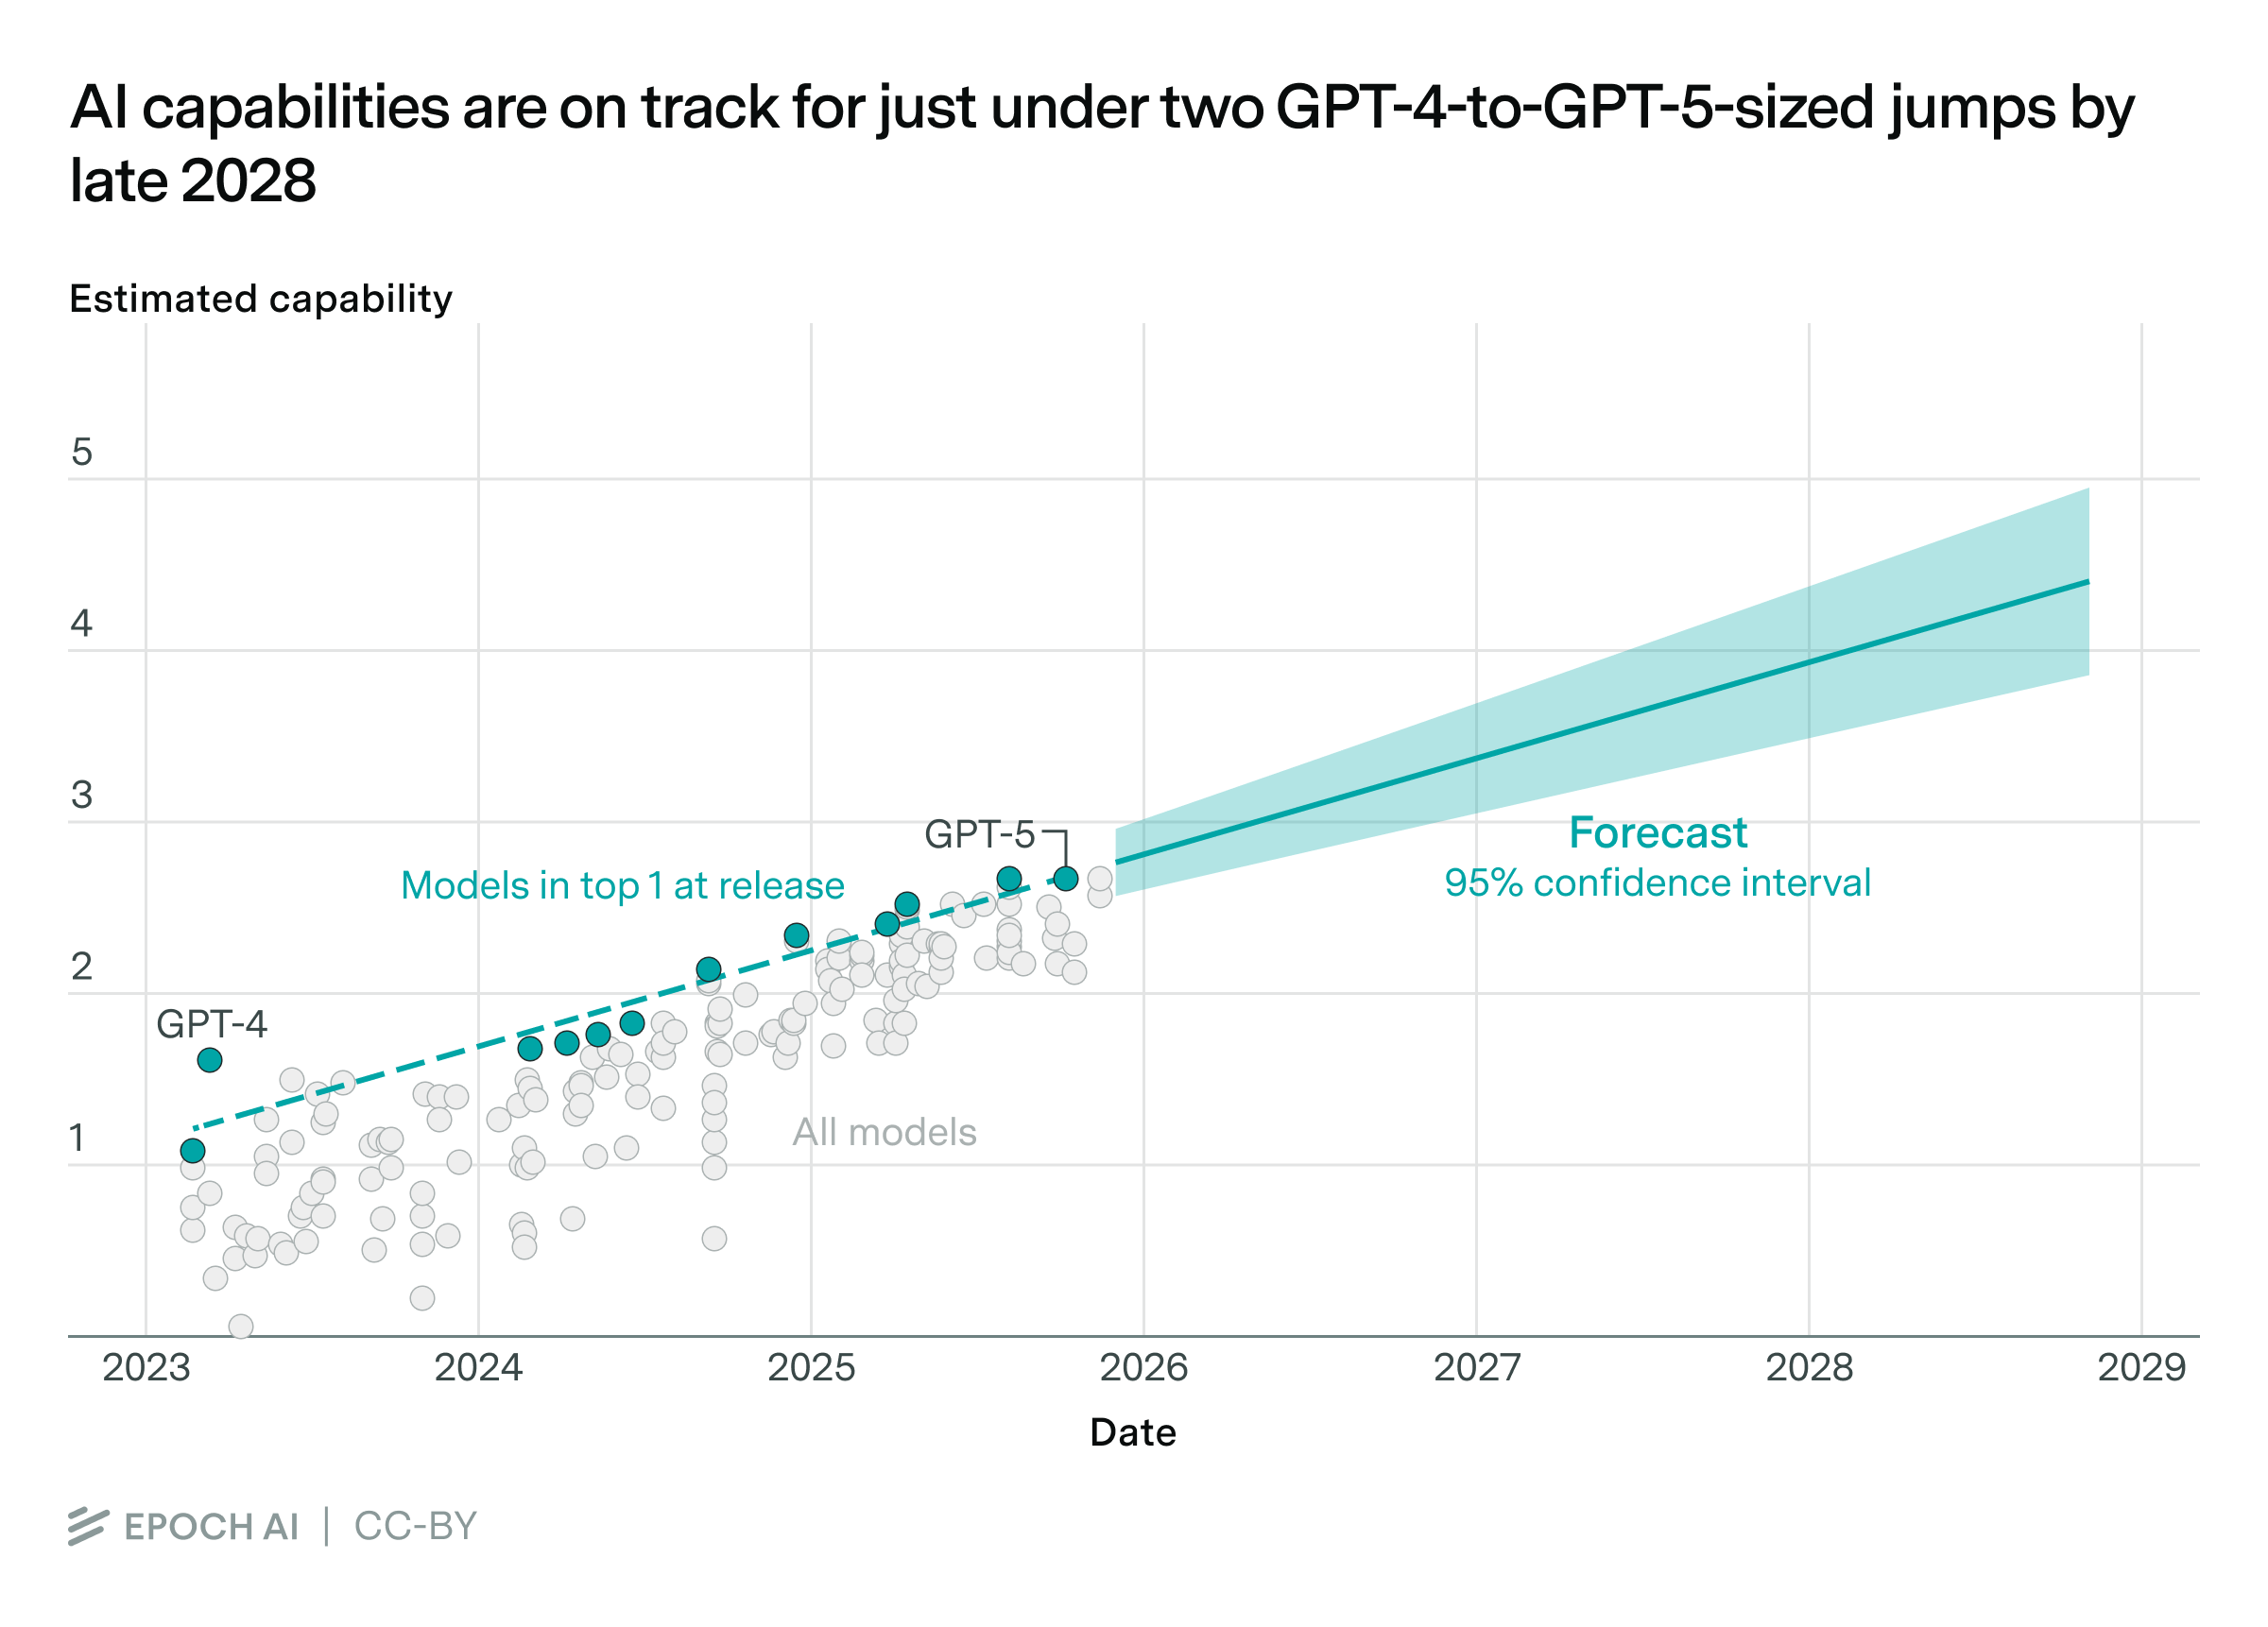
그다음에는 전체 추세를 앞으로 연장해 미래 능력을 단순하게 예측해 볼 수 있습니다.
그리고 이 추세로 소프트웨어 개선을 연구할 수도 있습니다. 소프트웨어가 좋아지면 더 적은 연산량으로 학습해도 같은 능력에 이를 수 있으니 “소프트웨어 효율”이 높아집니다.
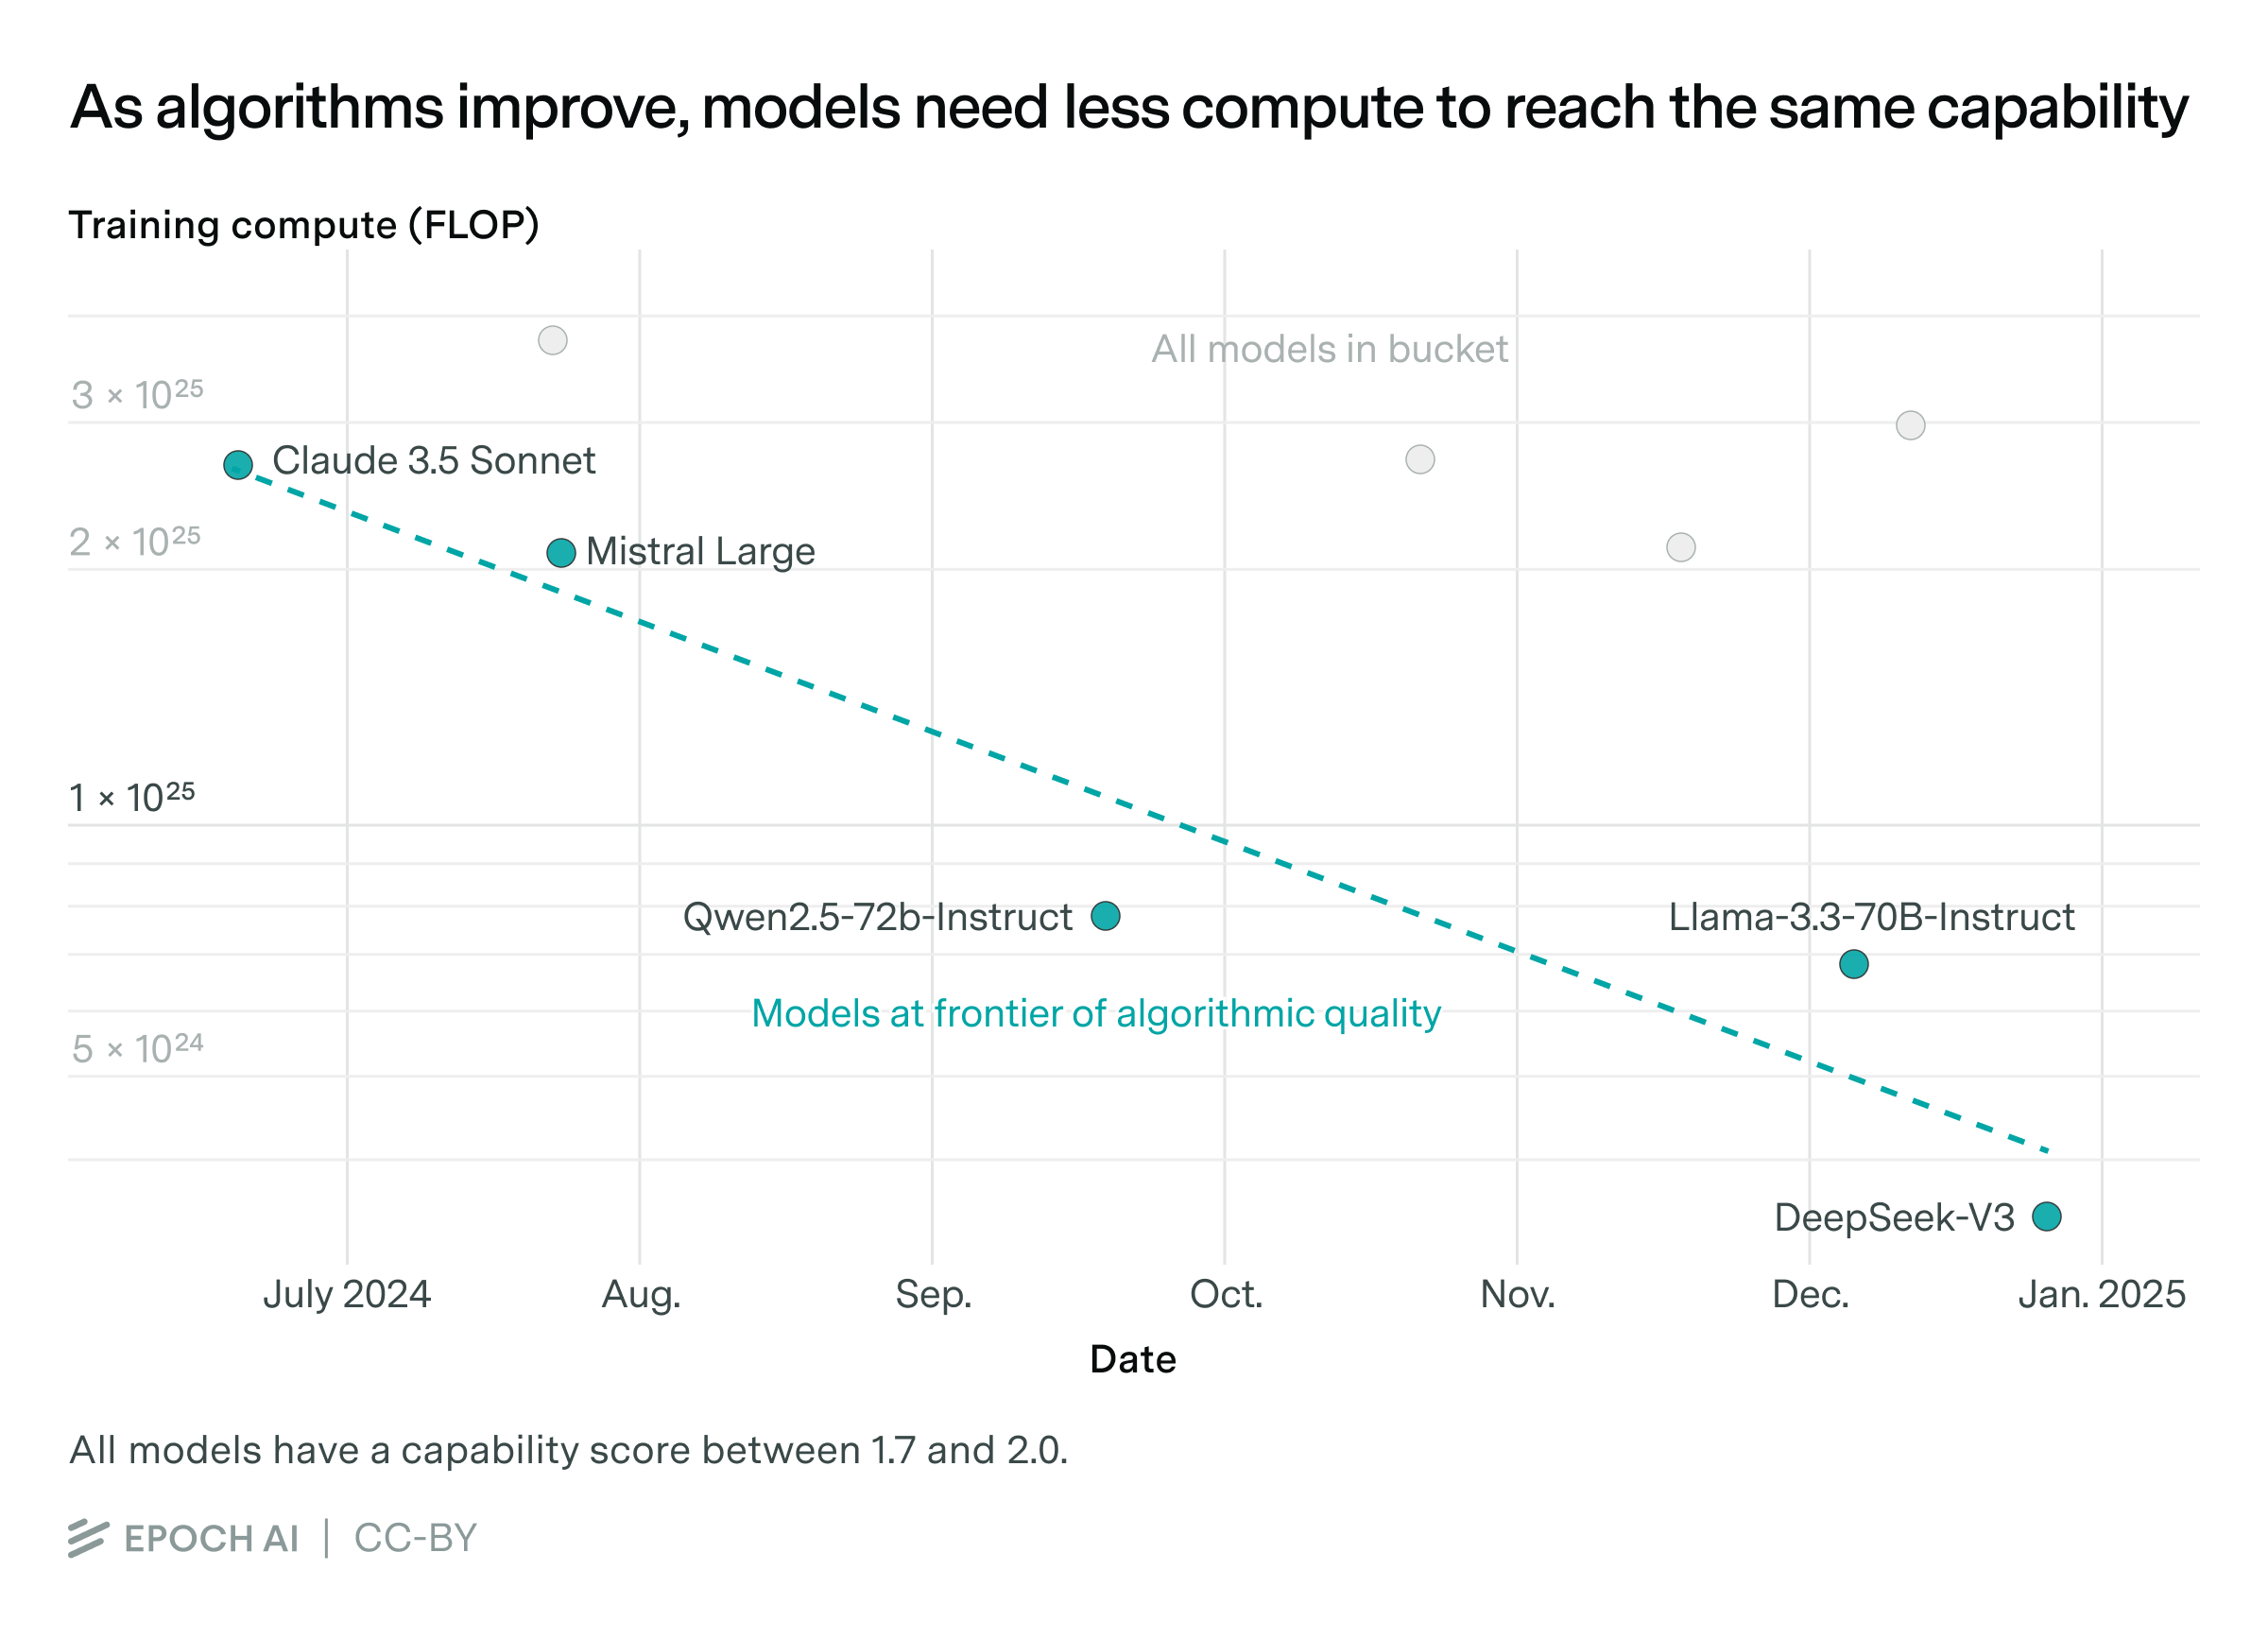
이 효과를 수치로 나타내려고, 이 능력 추세를 모델별 학습에 쓰인 연산량 데이터와 합칩니다. 그러면 최전선 모델들을 통계적으로 분석해, 능력 향상 가운데 얼마가 학습 연산량을 늘린 덕이고 얼마가 소프트웨어가 좋아진 덕인지 말할 수 있습니다. 결과는 이렇습니다. 같은 능력에 이르는 데 필요한 학습 연산량이 해마다 약 6분의 1로 줄어듭니다!
이는 엄청나게 빠른 속도입니다. 하지만 발전이 이보다 훨씬 더 빨라질 수 있다고 주장하는 사람들도 있습니다. AI가 AI 연구를 완전히 자동화할 수 있다면 스스로를 되풀이해 개선하리라는 생각입니다. 저희 틀은 이를 감지할 방법을 줍니다. 능력 점수가 시간에 따라 가속하는지 보면 됩니다. 합성 데이터 모의실험에서 저희는 두 배 빨라지는 가속을 두세 달 안에 안정적으로 감지할 수 있었습니다.
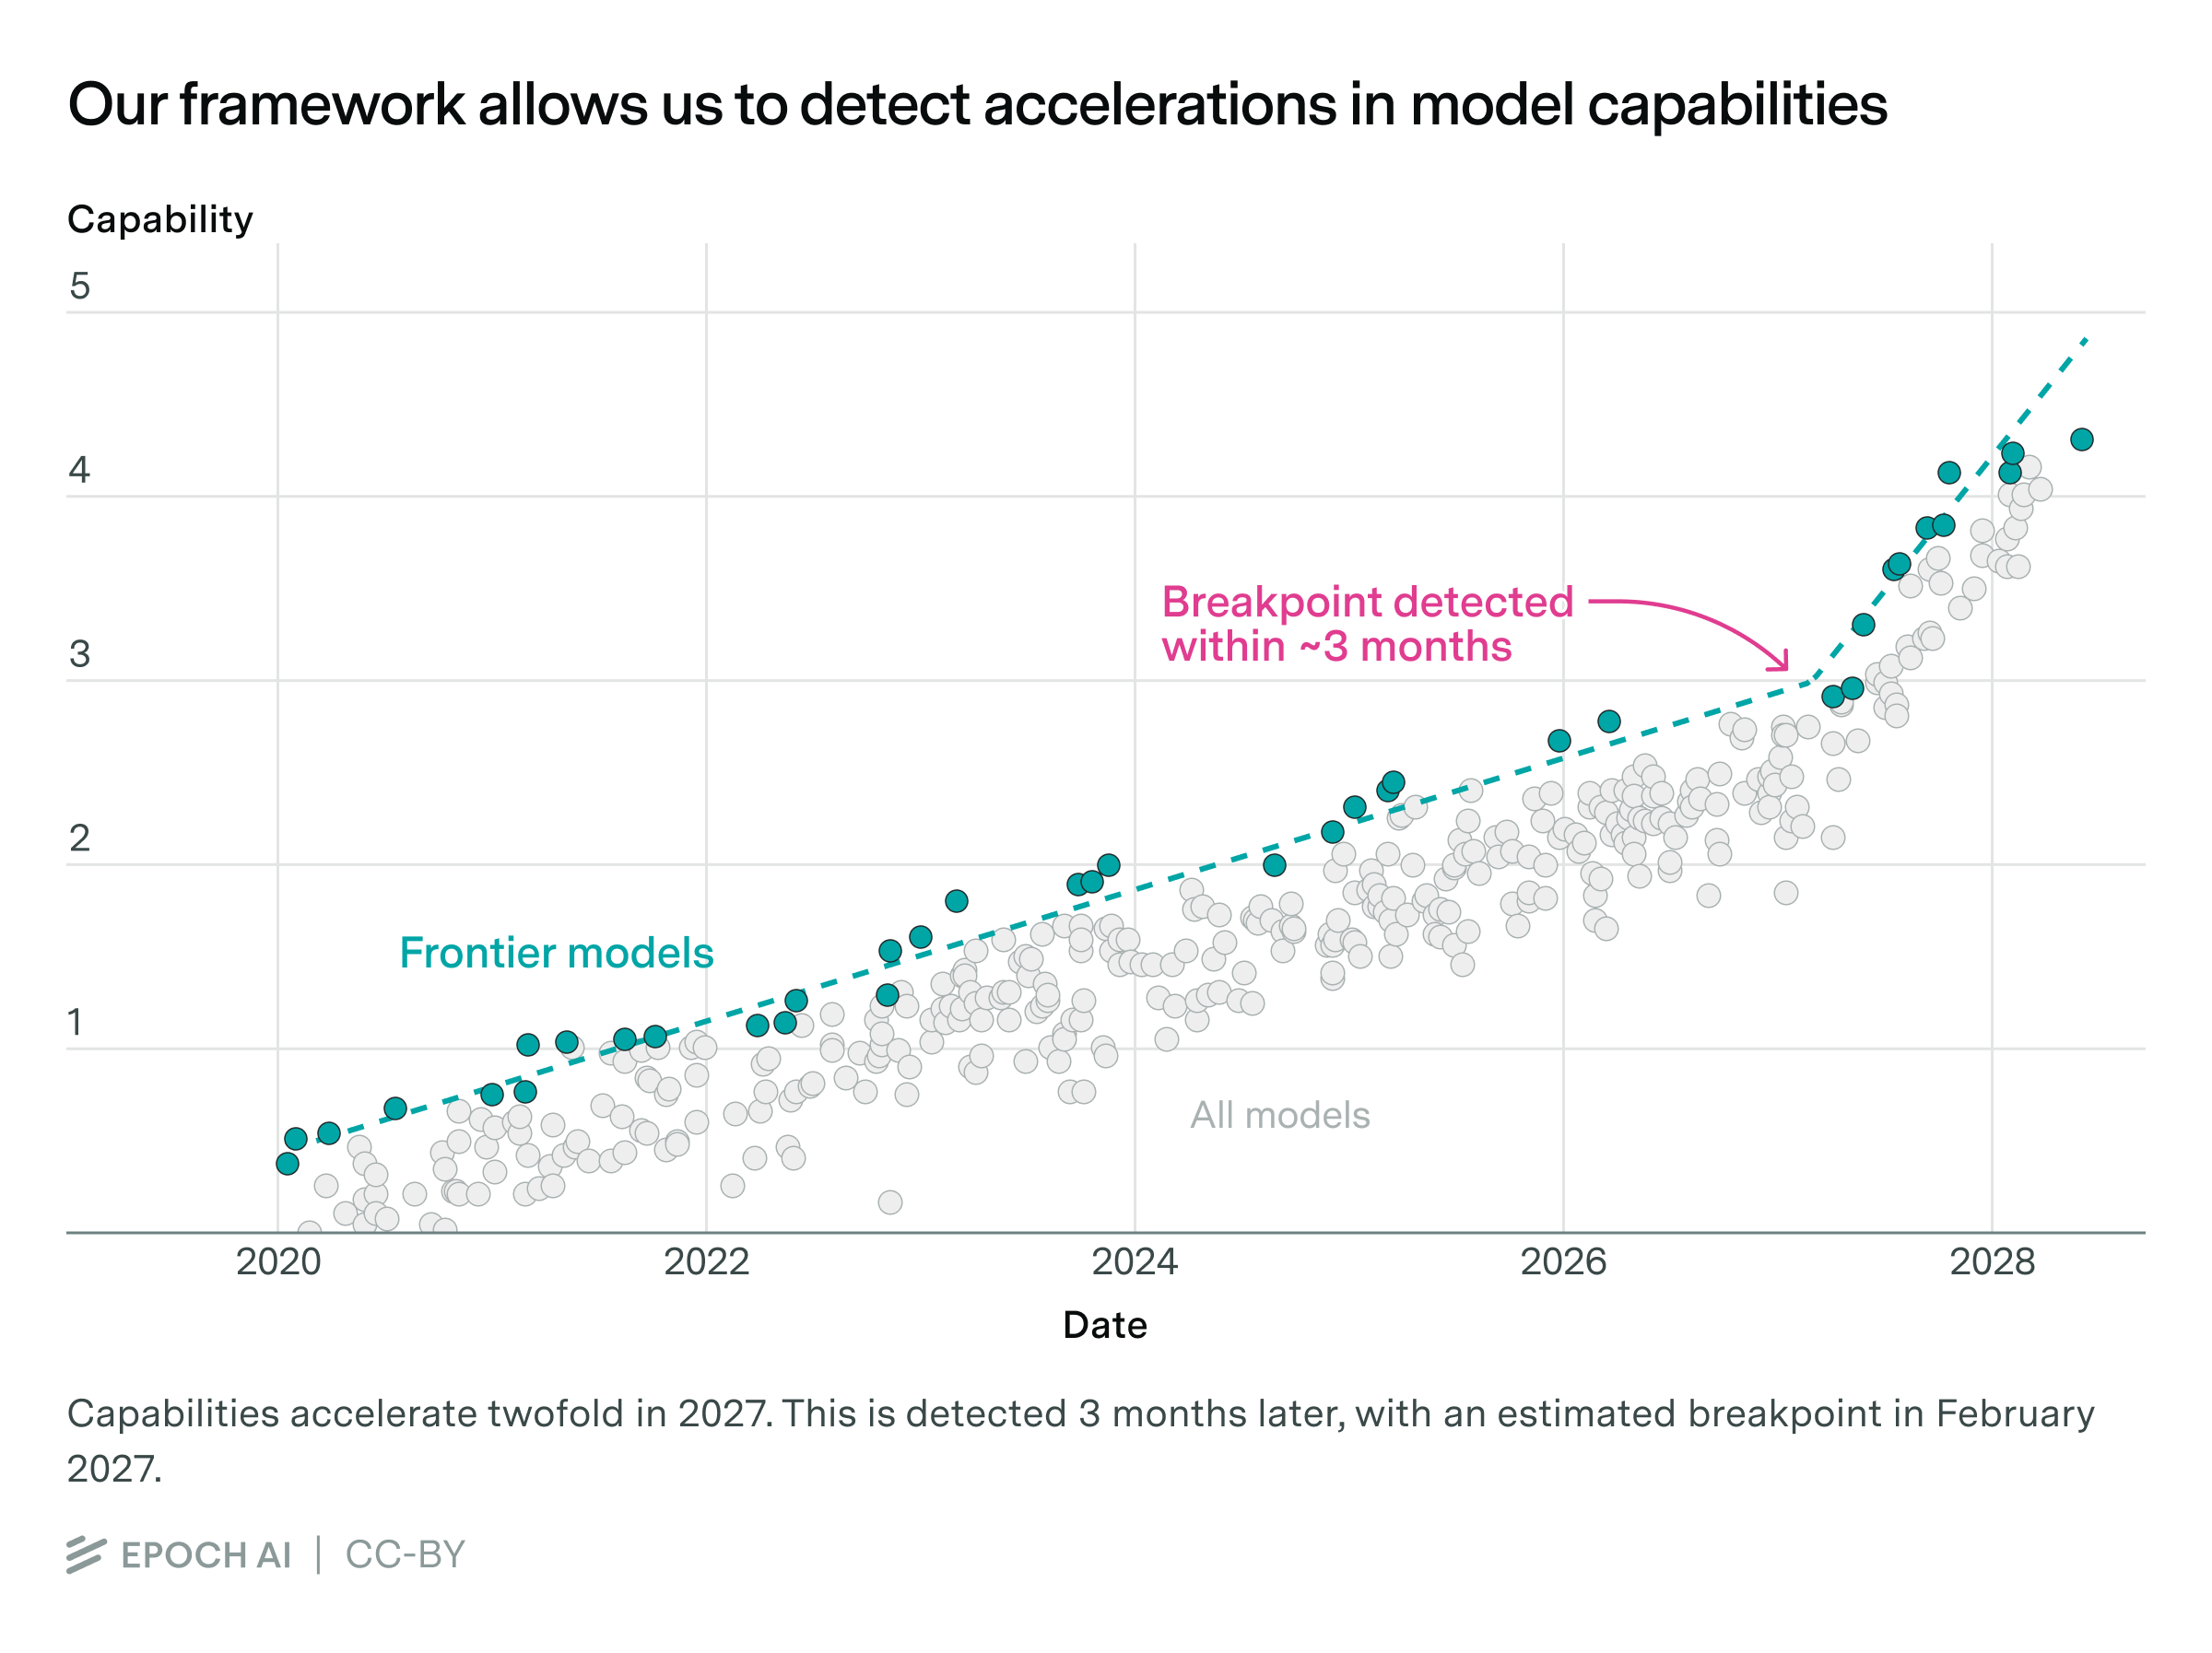
앞으로 벤치마크 데이터가 충분히 쌓이면, 이 방법은 능력이 빠르게 가속하는 것을 일찍 알려 주는 경고 신호가 되어 세상이 대응할 시간을 더 벌어 줄 수 있습니다.
다음 단계
저희 접근에는 몇 가지 한계가 있습니다. 무엇보다 이 틀은 벤치마크에 기대므로, 벤치마크의 한계 대부분을 그대로 물려받습니다. 모델은 전반적으로 나아지지 않고도 특정 벤치마크에서만 아주 잘하도록 최적화될 수 있습니다. 벤치마크는 현실 세계의 복잡함을 담으려 하는 경우가 드뭅니다. 그리고 모델 능력 추정치는 모델을 어떻게 평가하느냐에 따라 달라질 수 있습니다.
하지만 이런 한계는 더 해 볼 일의 방향도 알려 줍니다. 예를 들어 이런 일을 할 수 있습니다.
- 더 많은 벤치마크에서 데이터를 모아 모델 능력과 벤치마크 난이도의 더 긴 추세를 관찰하되, 현실 과제의 복잡함에 더 초점을 맞춘 벤치마크를 우선합니다.
- 모델의 벤치마크 점수를 같은 조건에서 비교할 수 있도록 평가 인프라를 만듭니다.
- 능력의 빠른 가속을 감지하는 방법을 개선합니다. 예를 들어 저희 논문은 가속의 시작을 나타내는 꺾인 점이 하나뿐인 단순한 시나리오를 다룹니다. 하지만 실제 가속은 더 연속적일 수 있고, 그런 경우를 더 직접 겨냥한 방법이 필요합니다.
결국 저희 작업은 AI 벤치마크를 이어 붙이려는 초기 시도일 뿐입니다. 이 작업 덕분에 기존 데이터에서 새로운 통찰을 끌어낼 수 있었고, 탐구할 방향도 많이 보였습니다. 아직 쉽게 딸 수 있는 열매도 많습니다. 그래서 저희가 이 접근을 공개 구현으로 계속 이어 가고 있는 Epoch 능력 지수를 많은 사람이 살펴보기를 기대합니다. 저희 틀을 바탕으로 한 연구나, 벤치마크 점수에서 정보를 끌어내는 다른 방법을 궁리해 AI 발전에 대한 이해를 넓히는 연구도 더 많이 나오기를 바랍니다.
이 작업은 Google DeepMind가 자금을 대고 그곳 연구자들과 함께 했습니다. 이 글에 도움이 되는 의견을 준 Jay Tate와 Robert Sandler에게 감사드립니다.