제이 알라마르: 그림으로 보는 트랜스포머Jay Alammar: The Illustrated Transformer
인코더와 디코더의 큰 구조에서 시작해 셀프 어텐션의 쿼리, 키, 값 계산, 멀티헤드 어텐션, 위치 인코딩, 잔차 연결, 디코더의 출력과 학습 손실까지 그림으로 한 단계씩 풀어 보는 제이 알라마르의 트랜스포머 입문 글
Contents목차
번역문 · 원저자: Jay Alammar · 원문: The Illustrated Transformer · 원문 라이선스: CC BY-NC-SA 4.0. 이 번역문도 원문과 같은 CC BY-NC-SA 4.0을 따릅니다. 원문 글쓴이가 그린 그림은 글과 같은 CC BY-NC-SA 4.0을 따르므로 그대로 실었습니다.
원문: 「The Illustrated Transformer」, Jay Alammar, https://jalammar.github.io/illustrated-transformer/. 2018년 6월 27일에 쓰였고, 뒤에 2020년 7월과 2025년에 내용이 덧붙었습니다. 이 글은 원문을 한국어로 옮긴 번역문입니다.
라이선스: 원문 페이지는 크리에이티브 커먼즈 저작자표시-비영리-동일조건변경허락 4.0 국제 라이선스(CC BY-NC-SA 4.0)를 따른다고 밝히고 있으며, 원문이 권하는 출처 표기는 「Alammar, J (2018). The Illustrated Transformer [Blog post]. Retrieved from https://jalammar.github.io/illustrated-transformer/」입니다. 이 번역도 같은 조건을 따르며 영리 목적으로 쓰지 않습니다. 원문 위쪽 책 소개 칸의 책 표지 그림과, 2025년 덧붙임 아래에 들어 있던 유튜브 영상은 싣지 않고 각각 링크로만 남겼습니다.
토론: Hacker News(65점, 댓글 4개), Reddit r/MachineLearning(29점, 댓글 3개)
번역본: 아랍어, 중국어 간체 1, 중국어 간체 2, 프랑스어 1, 프랑스어 2, 이탈리아어, 일본어, 한국어, 페르시아어, 러시아어, 스페인어 1, 스페인어 2, 베트남어
영상: 이 글을 인용한 MIT의 Deep Learning State of the Art 강의
강의 자료로 쓰인 곳: 스탠퍼드, 하버드, MIT, 프린스턴, CMU 등
업데이트: 이 글이 책이 되었습니다! LLM-book.com을 확인해 보세요. 책의 3장에 이 글을 새로 다듬고 늘린 내용이 실려 있습니다. 원래 트랜스포머가 나온 뒤 7년 동안 최신 트랜스포머 모델이 어떻게 발전해 왔는지(멀티 쿼리 어텐션, RoPE 위치 임베딩 같은 것)를 다룹니다.
앞 글에서는 어텐션을 살펴봤습니다. 어텐션은 요즘 딥러닝 모델 어디에나 쓰이는 방법으로, 신경망 기계 번역 응용의 성능을 끌어올리는 데 도움을 준 개념입니다. 이 글에서는 트랜스포머를 살펴봅니다. 트랜스포머는 어텐션을 써서 이런 모델의 학습 속도를 높이는 모델입니다. 트랜스포머는 특정 작업에서 구글 신경망 기계 번역 모델보다 성능이 좋습니다. 하지만 가장 큰 장점은 트랜스포머가 병렬화에 아주 잘 맞는다는 데 있습니다. 실제로 구글 클라우드는 자사 Cloud TPU를 쓸 때 참고 모델로 트랜스포머를 쓰라고 권합니다. 그러니 이 모델을 하나하나 뜯어보며 어떻게 돌아가는지 살펴봅시다.
트랜스포머는 논문 Attention is All You Need에서 제안되었습니다. 텐서플로 구현은 Tensor2Tensor 패키지의 일부로 나와 있습니다. 하버드 NLP 그룹은 이 논문에 PyTorch 구현을 곁들여 주석을 단 안내서를 만들었습니다. 이 글에서는 내용을 조금 지나치다 싶을 만큼 단순하게 풀고 개념을 하나씩 소개해서, 이 분야를 깊이 알지 못하는 사람도 더 쉽게 이해할 수 있기를 바랍니다.
2025년 업데이트: 이 글의 내용을 애니메이션과 함께 최신으로 다듬은 무료 단기 강좌를 만들었습니다. 원문에는 여기에 소개 영상이 들어 있습니다.
큰 그림으로 보기
먼저 모델을 하나의 블랙박스로 보는 데서 시작하겠습니다. 기계 번역 응용이라면, 이 상자는 한 언어로 된 문장을 받아 다른 언어로 옮긴 번역을 내놓습니다.
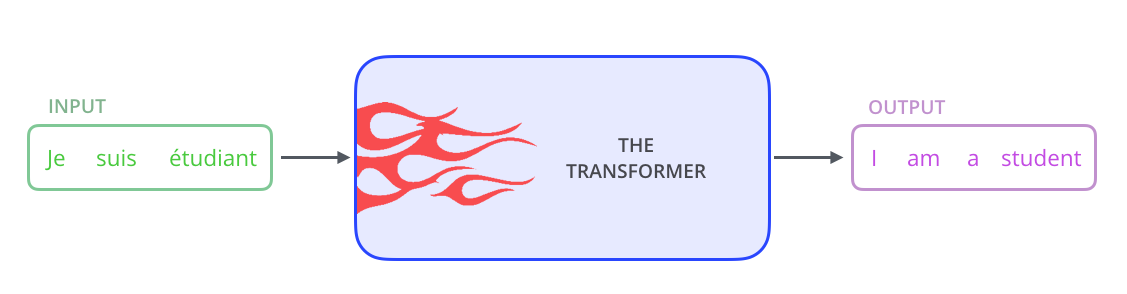
이 옵티머스 프라임 같은 녀석의 뚜껑을 열어 보면, 인코딩 부분과 디코딩 부분, 그리고 둘 사이의 연결이 보입니다.
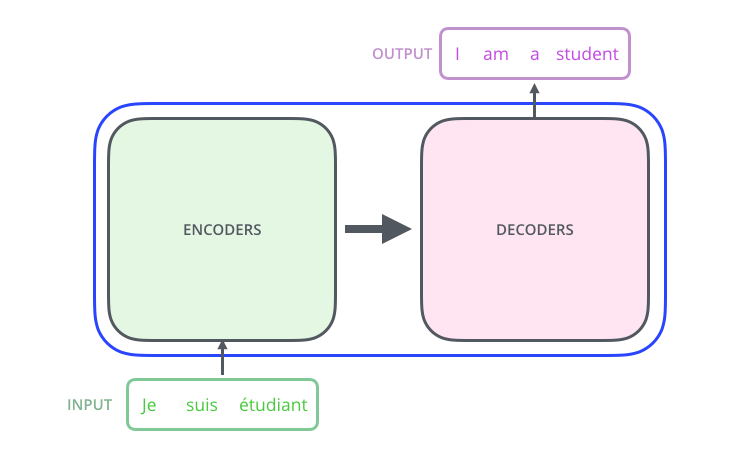
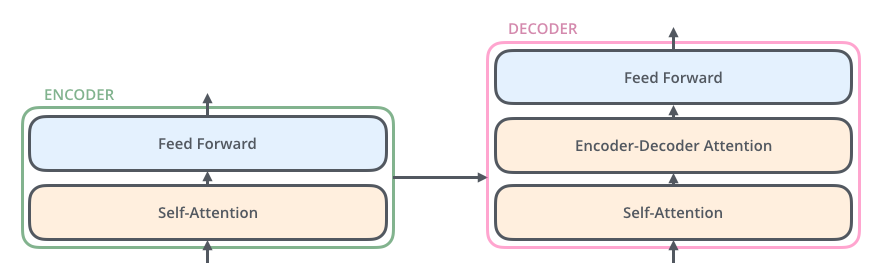
인코딩 부분은 인코더를 여러 개 쌓은 것입니다(논문에서는 여섯 개를 차곡차곡 쌓았습니다. 여섯이라는 수에 특별한 의미는 없으니 다른 구성으로 얼마든지 실험해 볼 수 있습니다). 디코딩 부분은 같은 수의 디코더를 쌓은 것입니다.
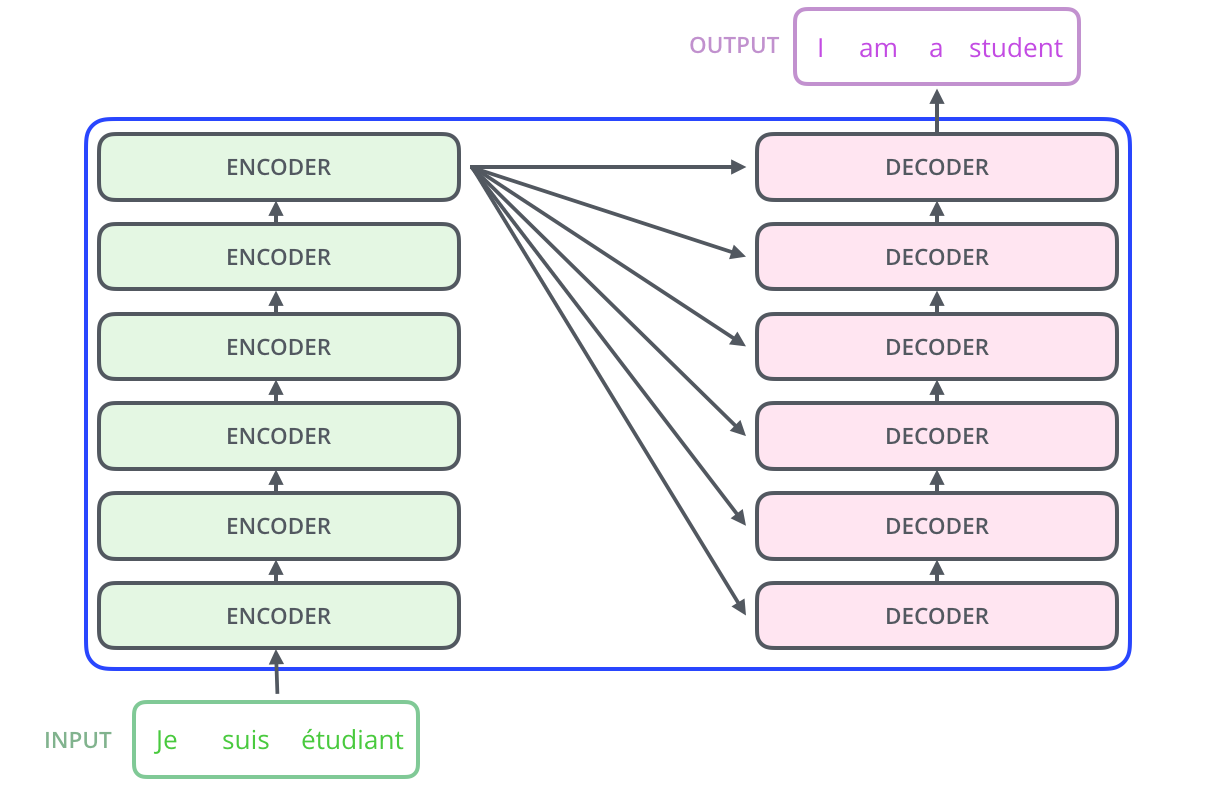
인코더들은 구조가 모두 같습니다(하지만 가중치를 공유하지는 않습니다). 인코더 하나는 하위 층 두 개로 나뉩니다.
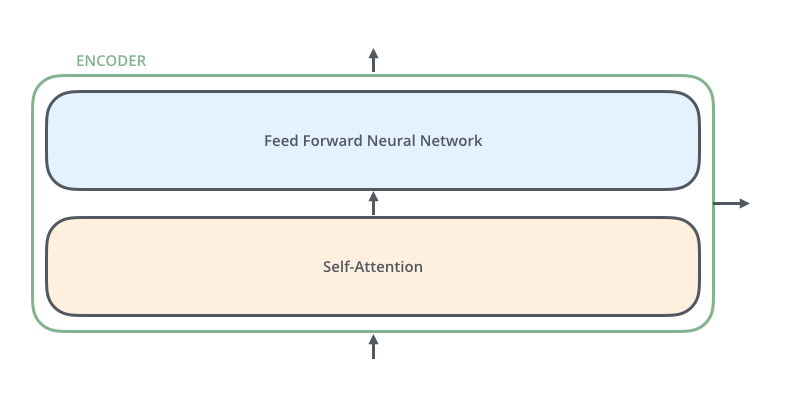
인코더에 들어온 입력은 먼저 셀프 어텐션 층을 지납니다. 셀프 어텐션 층은 인코더가 특정 단어를 인코딩할 때 입력 문장의 다른 단어들을 살펴볼 수 있게 도와주는 층입니다. 셀프 어텐션은 글 뒤쪽에서 더 자세히 보겠습니다.
셀프 어텐션 층의 출력은 피드포워드 신경망으로 들어갑니다. 똑같은 피드포워드 신경망이 위치마다 따로따로 적용됩니다.
디코더에도 이 두 층이 모두 있지만, 그 사이에 어텐션 층이 하나 더 있습니다. 이 층은 디코더가 입력 문장에서 관련 있는 부분에 집중하도록 돕습니다(seq2seq 모델에서 어텐션이 하는 일과 비슷합니다).
그림에 텐서 들여오기
모델의 주요 구성 요소를 봤으니, 이제 여러 벡터와 텐서가 이 구성 요소들 사이를 어떻게 흘러 다니며 학습된 모델의 입력을 출력으로 바꾸는지 살펴보겠습니다.
일반적인 NLP 응용과 마찬가지로, 먼저 임베딩 알고리즘을 써서 입력 단어 하나하나를 벡터로 바꿉니다.
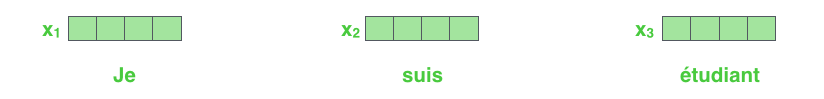 단어마다 크기 512인 벡터로 임베딩됩니다. 이 벡터들을 이런 간단한 상자로 나타내겠습니다.
임베딩은 맨 아래 인코더에서만 일어납니다. 모든 인코더에 공통된 추상화는, 각각 크기 512인 벡터들의 목록을 받는다는 것입니다. 맨 아래 인코더에서는 이 목록이 단어 임베딩이지만, 다른 인코더에서는 바로 아래 인코더의 출력입니다. 이 목록의 크기는 우리가 정할 수 있는 하이퍼파라미터인데, 기본적으로 학습 데이터셋에서 가장 긴 문장의 길이가 됩니다.
입력 수열의 단어들을 임베딩하고 나면, 각 단어는 인코더의 두 층을 차례로 지납니다.
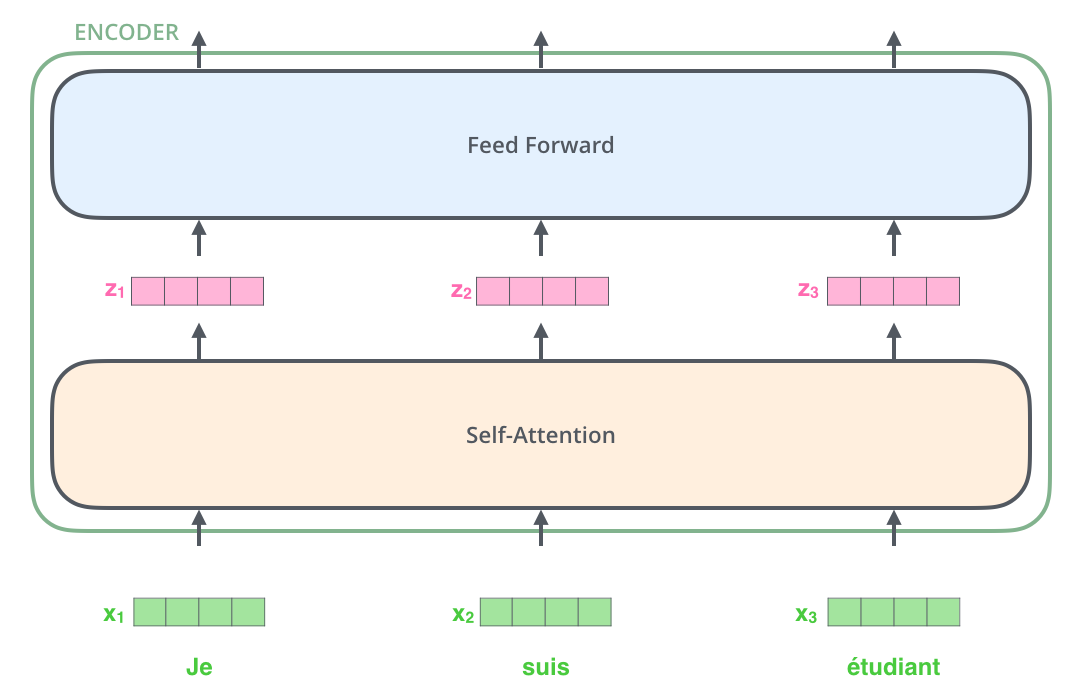
여기서 트랜스포머의 핵심 성질 하나가 보이기 시작합니다. 각 위치의 단어가 인코더 안에서 저마다의 경로를 따라 흐른다는 것입니다. 셀프 어텐션 층에서는 이 경로들 사이에 의존 관계가 있습니다. 하지만 피드포워드 층에는 그런 의존 관계가 없어서, 피드포워드 층을 지나는 동안에는 여러 경로를 병렬로 실행할 수 있습니다.
다음으로 예시를 더 짧은 문장으로 바꿔서, 인코더의 각 하위 층에서 무슨 일이 일어나는지 살펴보겠습니다.
이제 인코딩합니다!
이미 말했듯이 인코더는 벡터들의 목록을 입력으로 받습니다. 인코더는 이 벡터들을 ‘셀프 어텐션’ 층에 넣고, 다음으로 피드포워드 신경망에 넣어 이 목록을 처리한 뒤, 그 출력을 위쪽의 다음 인코더로 보냅니다.
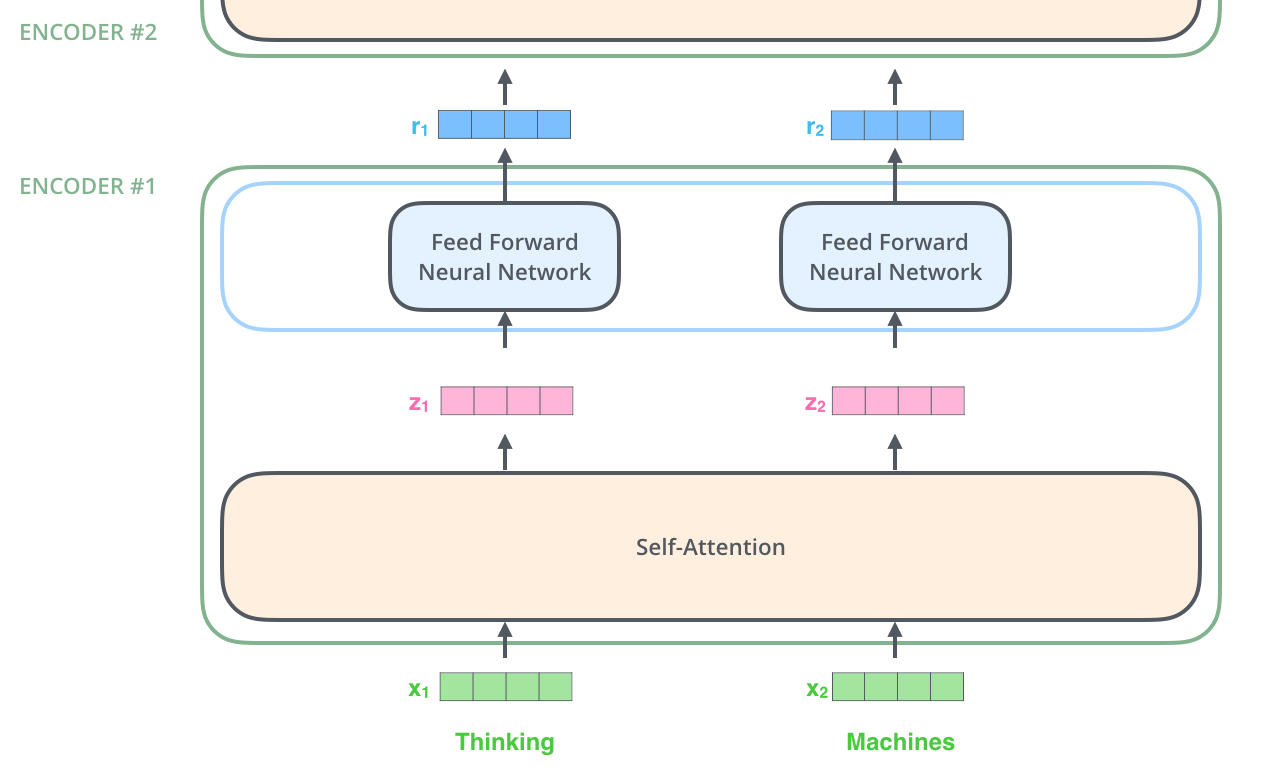 각 위치의 단어가 셀프 어텐션 과정을 지납니다. 그다음 각각 피드포워드 신경망을 지나는데, 똑같은 신경망을 벡터마다 따로 통과합니다.
셀프 어텐션 큰 그림으로 보기
제가 “셀프 어텐션”이라는 말을 누구나 아는 개념인 것처럼 툭툭 던지는 데 속지 마세요. 저도 「Attention is All You Need」 논문을 읽기 전까지는 이 개념을 접해 본 적이 없었습니다. 어떻게 돌아가는지 핵심만 추려 보겠습니다.
다음 문장이 번역하려는 입력 문장이라고 해 봅시다.
“The animal didn't cross the street because it was too tired”
이 문장에서 “it”은 무엇을 가리킬까요? 길일까요, 동물일까요? 사람에게는 쉬운 질문이지만 알고리즘에게는 그렇게 쉽지 않습니다.
모델이 “it”이라는 단어를 처리할 때, 셀프 어텐션 덕분에 모델은 “it”을 “animal”과 연결할 수 있습니다.
모델이 각 단어(입력 수열의 각 위치)를 처리할 때, 셀프 어텐션은 입력 수열의 다른 위치들을 살펴보며 이 단어를 더 잘 인코딩하는 데 도움이 될 단서를 찾게 해 줍니다.
RNN에 익숙하다면, RNN이 은닉 상태를 유지함으로써 앞서 처리한 단어나 벡터의 표현을 지금 처리하는 것과 합치는 방식을 떠올려 보세요. 셀프 어텐션은 트랜스포머가 관련 있는 다른 단어들에 대한 “이해”를 지금 처리하는 단어에 녹여 넣는 방법입니다.
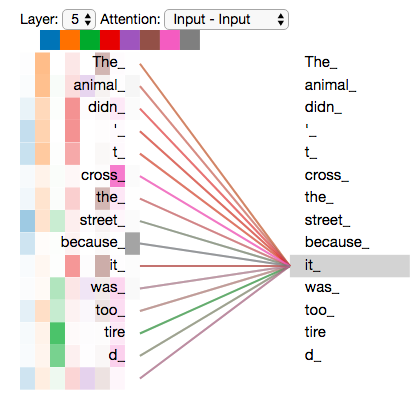
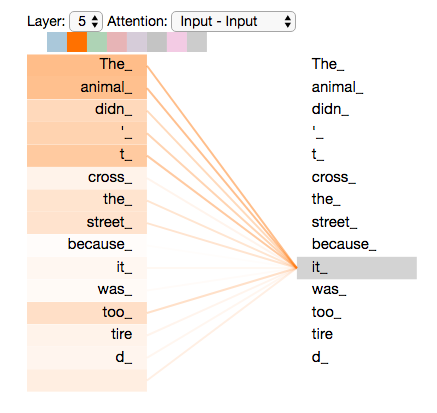 인코더 5번(맨 위 인코더)에서 “it”이라는 단어를 인코딩할 때, 어텐션 메커니즘의 일부는 “The Animal”에 집중했고, 그 표현의 일부를 “it”의 인코딩에 녹여 넣었습니다.
트랜스포머 모델을 불러와 이런 대화형 시각화로 살펴볼 수 있는 Tensor2Tensor 노트북도 꼭 확인해 보세요.
셀프 어텐션 자세히 보기
먼저 벡터를 써서 셀프 어텐션을 계산하는 방법을 보고, 그다음 실제로 행렬을 써서 어떻게 구현하는지 보겠습니다.
셀프 어텐션 계산의 첫 번째 단계는 인코더의 각 입력 벡터(여기서는 각 단어의 임베딩)에서 벡터 세 개를 만드는 것입니다. 그래서 단어마다 쿼리 벡터, 키 벡터, 값 벡터를 만듭니다. 이 벡터들은 임베딩에 학습 과정에서 학습한 행렬 세 개를 곱해서 만듭니다.
이 새 벡터들은 임베딩 벡터보다 차원이 작다는 점에 주목하세요. 이 벡터들의 차원은 64이고, 임베딩과 인코더 입출력 벡터의 차원은 512입니다. 꼭 더 작아야 하는 것은 아니고, 멀티헤드 어텐션의 계산량을 (거의) 일정하게 만들려는 구조상의 선택입니다.
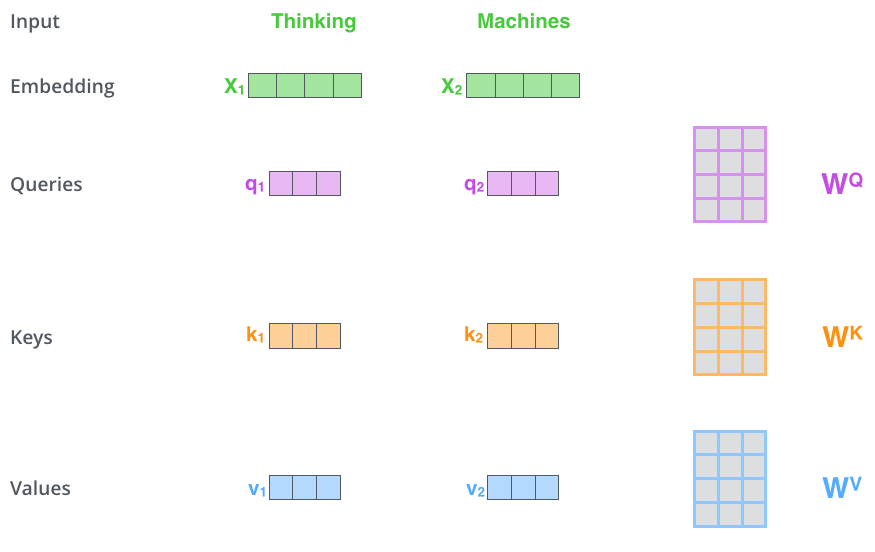 에 가중치 행렬 를 곱하면 그 단어에 딸린 “쿼리” 벡터 이 나옵니다. 결국 입력 문장의 단어마다 “쿼리”, “키”, “값” 투영을 하나씩 만들게 됩니다.
“쿼리”, “키”, “값” 벡터란 무엇일까요?
이들은 어텐션을 계산하고 생각하는 데 쓸모 있는 추상화입니다. 아래에서 어텐션을 어떻게 계산하는지 읽어 나가다 보면, 이 벡터들이 각각 어떤 역할을 하는지 알아야 할 것은 거의 다 알게 됩니다.
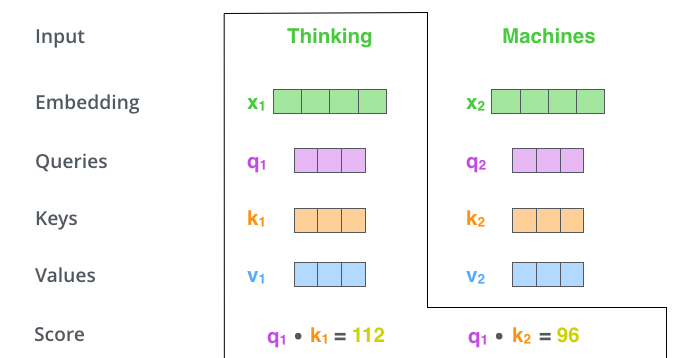
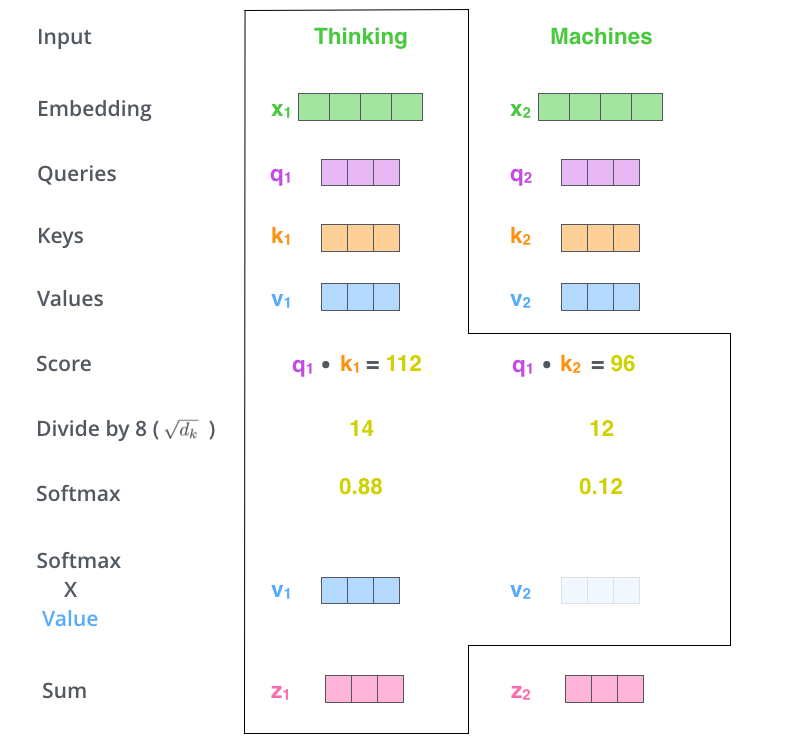
셀프 어텐션 계산의 두 번째 단계는 점수를 계산하는 것입니다. 이 예시의 첫 단어 “Thinking”에 대한 셀프 어텐션을 계산한다고 해 봅시다. 입력 문장의 각 단어를 이 단어에 견주어 점수를 매겨야 합니다. 이 점수는 특정 위치의 단어를 인코딩할 때 입력 문장의 다른 부분에 얼마나 집중할지를 정합니다.
점수는 쿼리 벡터와, 점수를 매기는 상대 단어의 키 벡터를 내적해서 계산합니다. 그래서 1번 위치 단어의 셀프 어텐션을 처리한다면, 첫 번째 점수는 과 의 내적이 됩니다. 두 번째 점수는 과 의 내적입니다.
세 번째와 네 번째 단계는 점수를 8로 나눈 다음(8은 논문에서 쓴 키 벡터 차원 64의 제곱근입니다. 이렇게 하면 그래디언트가 더 안정됩니다. 다른 값을 쓸 수도 있지만, 이것이 기본값입니다), 그 결과를 소프트맥스 연산에 넣는 것입니다. 소프트맥스는 점수를 정규화해서 모두 양수이고 합이 1이 되게 합니다.
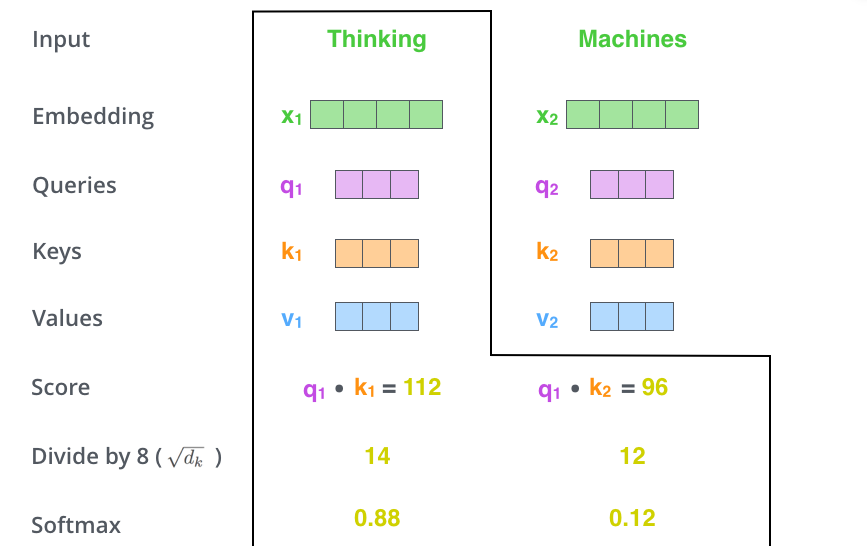
이 소프트맥스 점수는 각 단어가 이 위치에서 얼마나 드러날지를 정합니다. 당연히 이 위치의 단어 자신이 소프트맥스 점수가 가장 높겠지만, 때로는 지금 단어와 관련 있는 다른 단어에 주의를 기울이는 것이 쓸모 있습니다.
다섯 번째 단계는 각 값 벡터에 소프트맥스 점수를 곱하는 것입니다(나중에 더하기 위한 준비입니다). 여기 담긴 직관은, 집중하고 싶은 단어의 값은 그대로 살리고 관련 없는 단어는 (예를 들어 0.001 같은 아주 작은 수를 곱해서) 묻어 버리는 것입니다.
여섯 번째 단계는 가중치가 곱해진 값 벡터들을 더하는 것입니다. 이렇게 하면 이 위치(첫 번째 단어)에서 셀프 어텐션 층의 출력이 나옵니다.
이것으로 셀프 어텐션 계산이 끝납니다. 이렇게 나온 벡터를 피드포워드 신경망으로 보내면 됩니다. 다만 실제 구현에서는 더 빠르게 처리하려고 이 계산을 행렬 꼴로 합니다. 단어 단위에서 계산의 직관을 봤으니, 이제 행렬 꼴을 보겠습니다.
셀프 어텐션의 행렬 계산
첫 번째 단계는 쿼리, 키, 값 행렬을 계산하는 것입니다. 임베딩들을 행렬 에 차곡차곡 넣고, 이것에 학습한 가중치 행렬(, , )을 곱하면 됩니다.
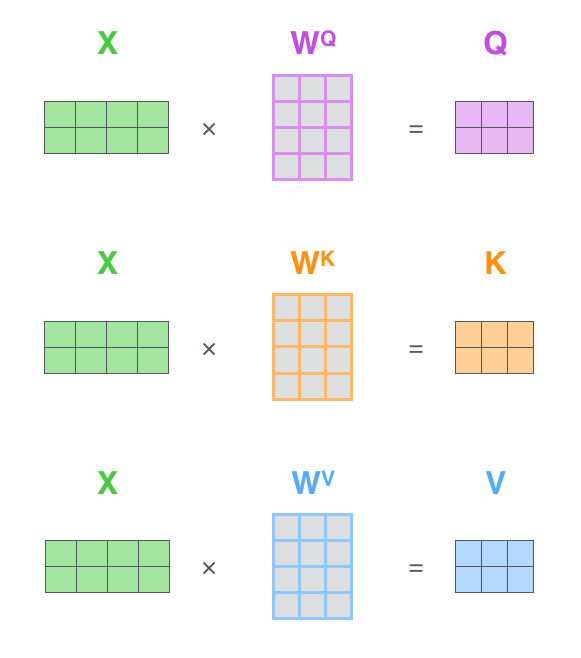 행렬의 각 행은 입력 문장의 단어 하나에 해당합니다. 여기서도 임베딩 벡터(512, 그림에서는 칸 4개)와 q/k/v 벡터(64, 그림에서는 칸 3개)의 크기 차이가 보입니다.
마지막으로, 행렬을 다루고 있으니 두 번째부터 여섯 번째 단계까지를 식 하나로 줄여 셀프 어텐션 층의 출력을 계산할 수 있습니다.
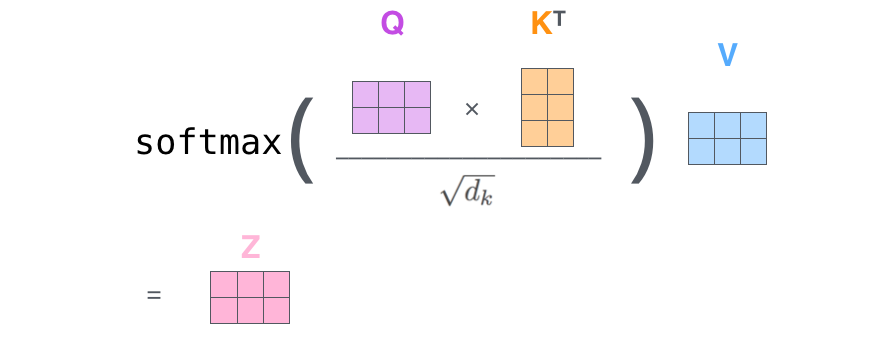 행렬 꼴로 나타낸 셀프 어텐션 계산
머리가 여럿 달린 괴물
논문은 “멀티헤드” 어텐션이라는 메커니즘을 더해 셀프 어텐션 층을 한층 더 다듬었습니다. 이 방법은 어텐션 층의 성능을 두 가지 면에서 높여 줍니다.
-
모델이 서로 다른 위치에 집중하는 능력을 넓혀 줍니다. 물론 위 예시에서 에는 다른 모든 단어의 인코딩이 조금씩 들어 있지만, 실제 그 단어 자신이 대부분을 차지할 수 있습니다. “The animal didn’t cross the street because it was too tired” 같은 문장을 번역한다면 “it”이 어느 단어를 가리키는지 아는 것이 쓸모 있을 겁니다.
-
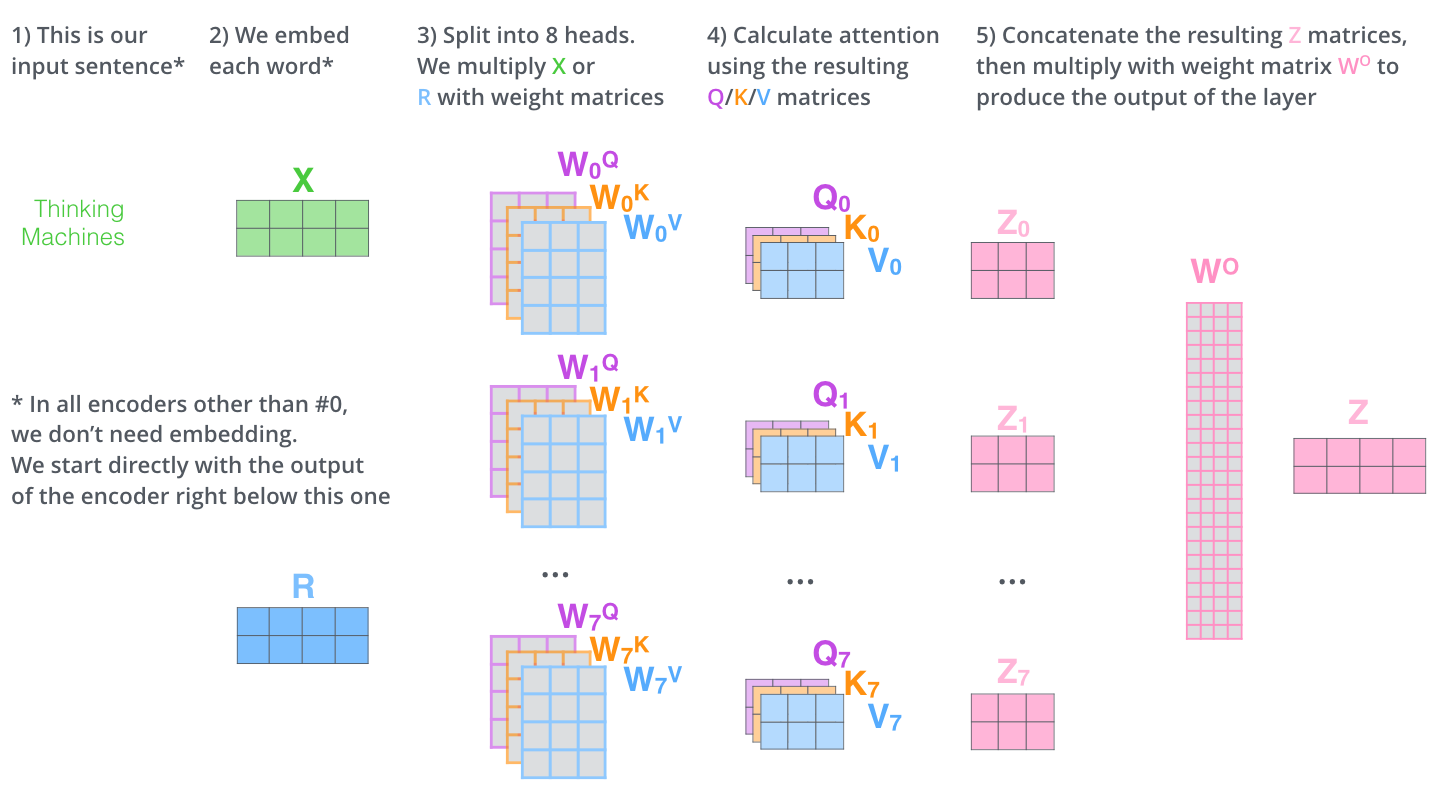
어텐션 층에 여러 개의 “표현 부분 공간”을 줍니다. 곧 보겠지만, 멀티헤드 어텐션에서는 쿼리/키/값 가중치 행렬 묶음이 하나가 아니라 여러 개입니다(트랜스포머는 어텐션 헤드를 여덟 개 쓰므로, 인코더와 디코더마다 여덟 묶음이 생깁니다). 각 묶음은 무작위로 초기화됩니다. 그리고 학습이 끝나면 각 묶음이 입력 임베딩(또는 아래쪽 인코더나 디코더에서 온 벡터)을 서로 다른 표현 부분 공간으로 투영하는 데 쓰입니다.
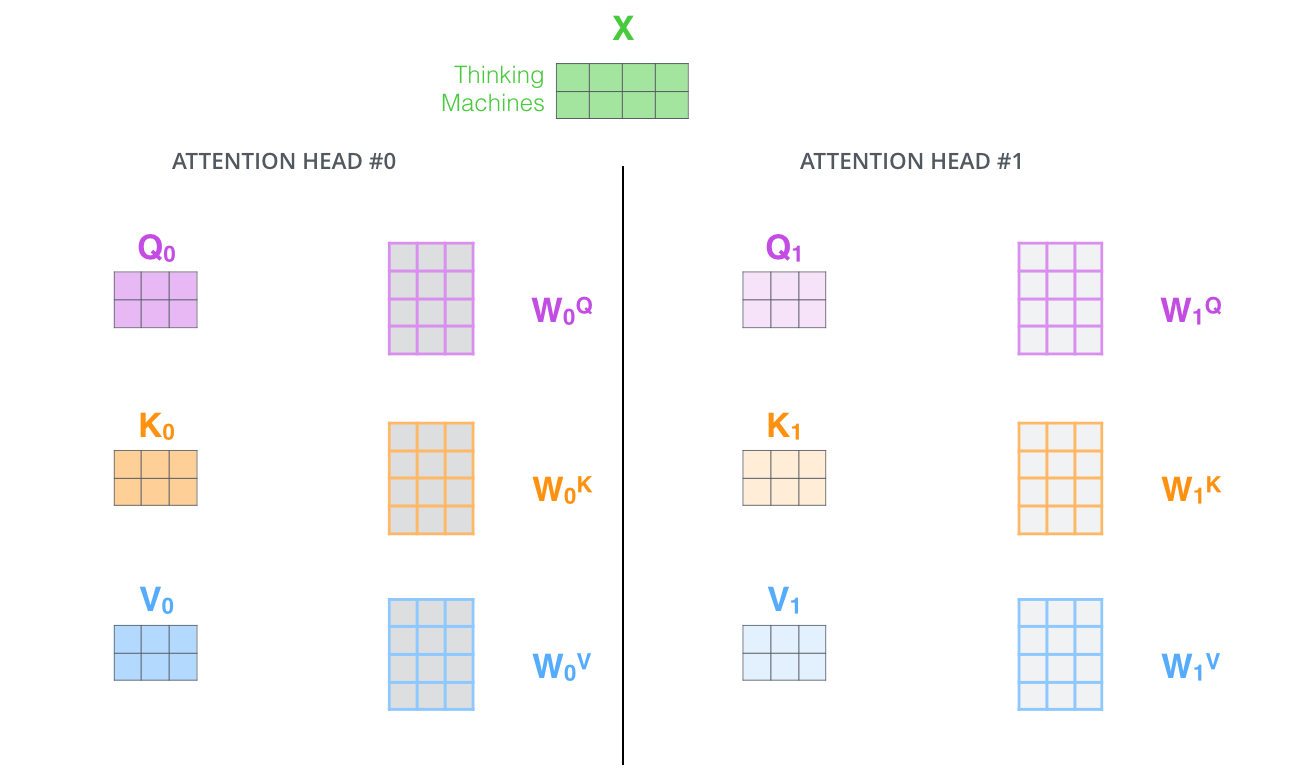 멀티헤드 어텐션에서는 헤드마다 Q/K/V 가중치 행렬을 따로 두므로, 서로 다른 Q/K/V 행렬이 나옵니다. 앞에서처럼 X에 WQ/WK/WV 행렬을 곱해 Q/K/V 행렬을 만듭니다.
앞에서 설명한 셀프 어텐션 계산을 가중치 행렬만 바꿔 여덟 번 하면, 서로 다른 Z 행렬 여덟 개가 나옵니다.
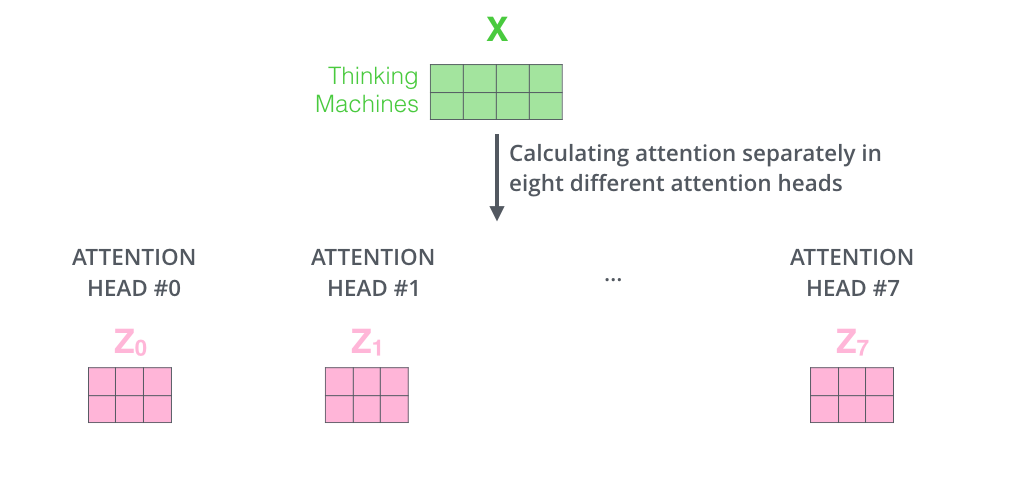
그런데 여기서 작은 문제가 생깁니다. 피드포워드 층은 행렬 여덟 개를 기대하지 않습니다. 행렬 하나(단어마다 벡터 하나)를 기대합니다. 그래서 이 여덟 개를 행렬 하나로 줄일 방법이 필요합니다.
어떻게 할까요? 행렬들을 이어 붙인 다음, 가중치 행렬 WO를 하나 더 곱합니다.
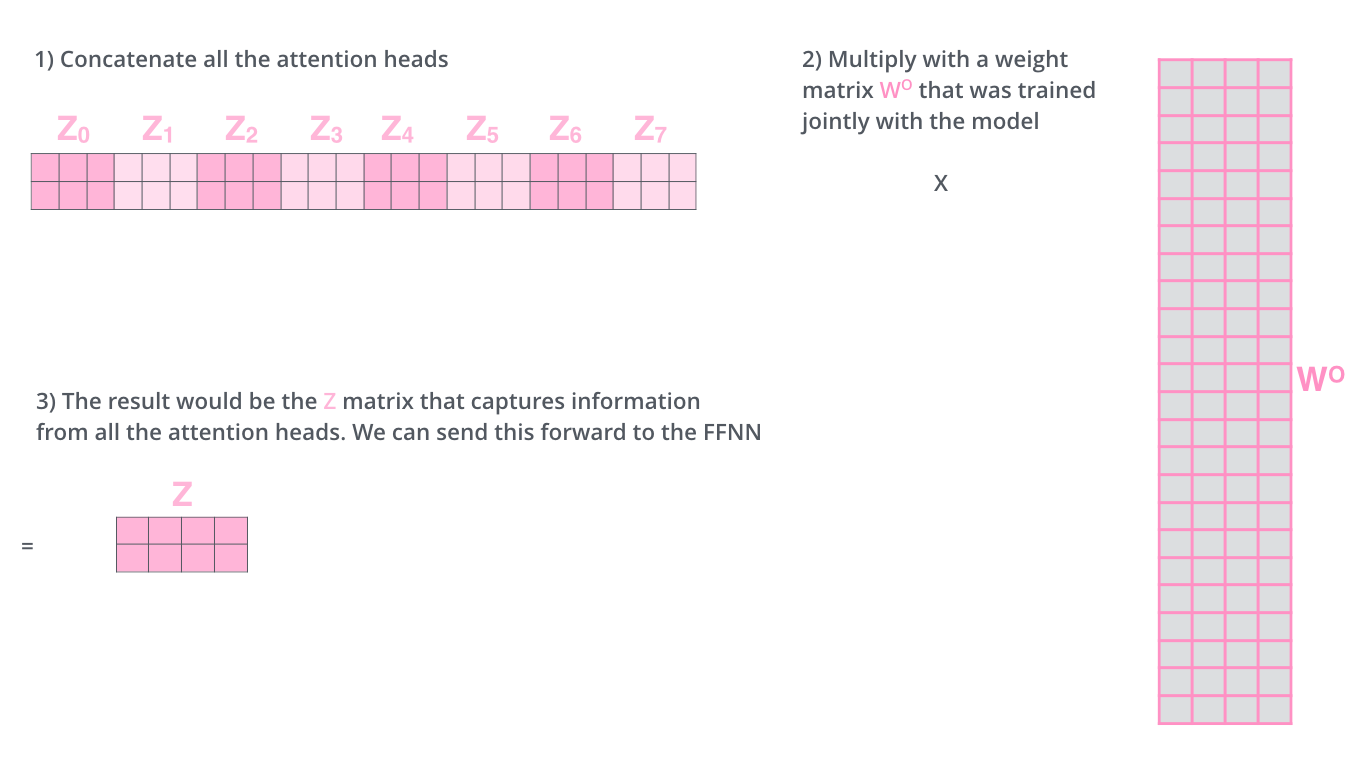
멀티헤드 셀프 어텐션은 사실상 이게 전부입니다. 행렬이 꽤 많다는 건 저도 압니다. 모두 한 그림에 넣어 한자리에서 볼 수 있게 해 보겠습니다.
어텐션 헤드를 다뤘으니, 앞의 예시로 돌아가 예시 문장에서 “it”을 인코딩할 때 여러 어텐션 헤드가 각각 어디에 집중하는지 보겠습니다.
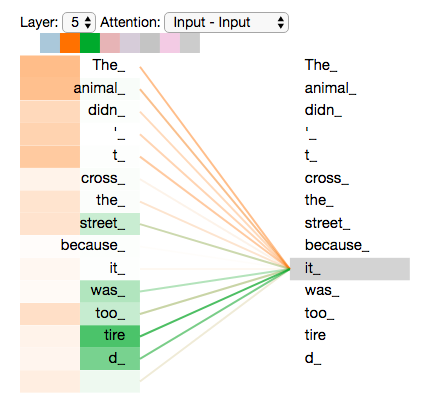 “it”이라는 단어를 인코딩할 때, 한 어텐션 헤드는 “the animal”에 가장 많이 집중하고, 다른 헤드는 “tired”에 집중합니다. 어떤 의미에서, 모델이 만든 “it”의 표현에는 “animal”과 “tired” 두 단어의 표현이 조금씩 녹아 들어 있습니다.
하지만 어텐션 헤드를 모두 그림에 넣으면 해석하기가 더 어려워질 수 있습니다.
위치 인코딩으로 수열의 순서 나타내기
지금까지 설명한 모델에 빠져 있는 것이 하나 있습니다. 입력 수열에서 단어의 순서를 반영하는 방법입니다.
이를 해결하려고 트랜스포머는 각 입력 임베딩에 벡터를 하나 더합니다. 이 벡터들은 모델이 학습하는 특정한 패턴을 따르며, 이 패턴은 모델이 각 단어의 위치나 수열에서 단어 사이의 거리를 알아내는 데 도움이 됩니다. 여기 담긴 직관은, 이 값을 임베딩에 더해 두면 임베딩 벡터가 Q/K/V 벡터로 투영된 뒤 내적 어텐션을 계산할 때 벡터 사이에 의미 있는 거리가 생긴다는 것입니다.
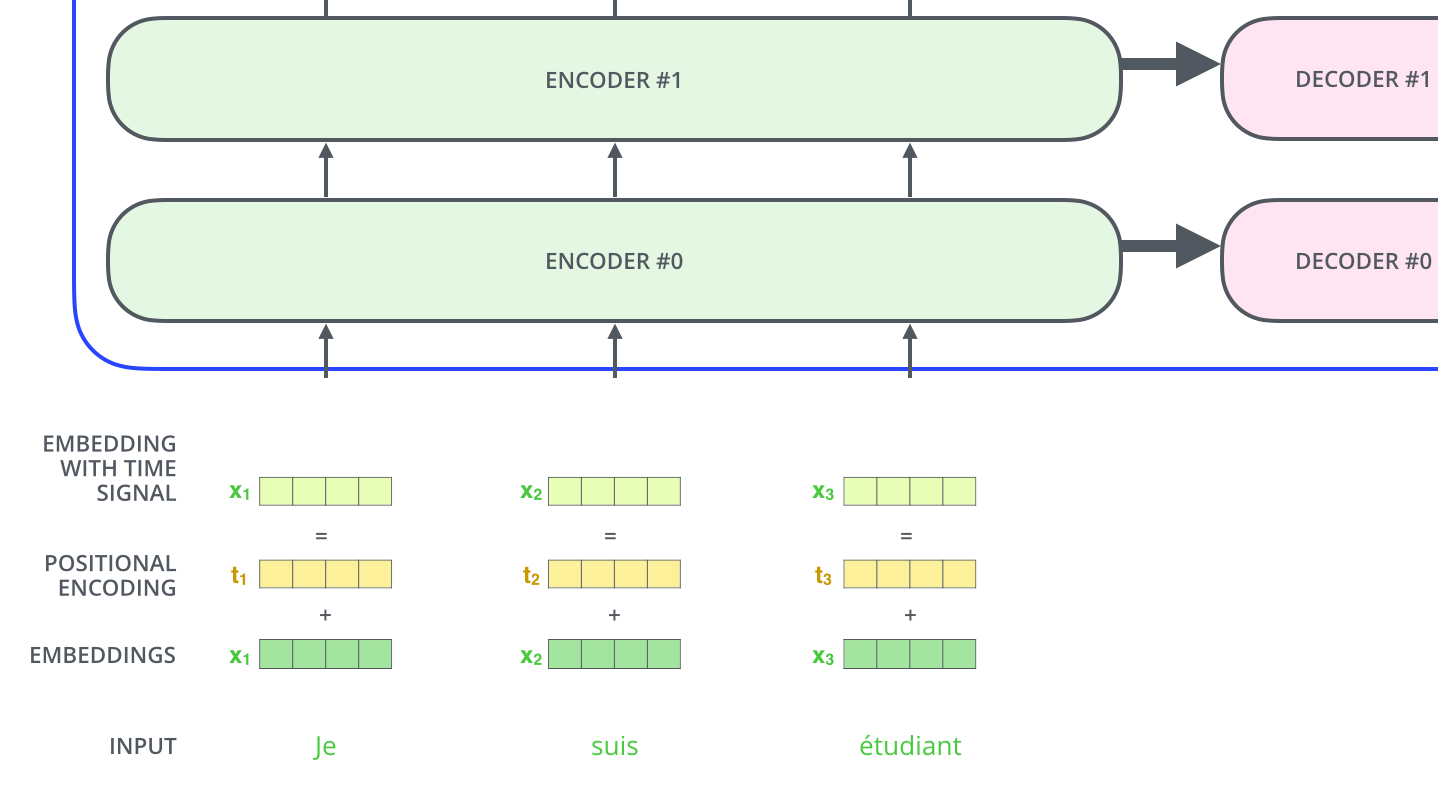 모델에 단어 순서에 대한 감각을 주려고 위치 인코딩 벡터를 더합니다. 이 벡터의 값은 특정한 패턴을 따릅니다.
임베딩 차원이 4라고 하면, 실제 위치 인코딩은 다음과 같이 생깁니다.
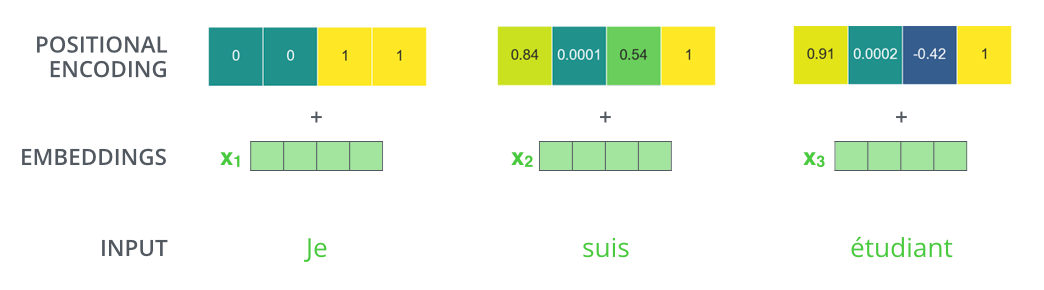 임베딩 크기가 4인 장난감 예시로 본 위치 인코딩의 실제 값
이 패턴은 어떻게 생겼을까요?
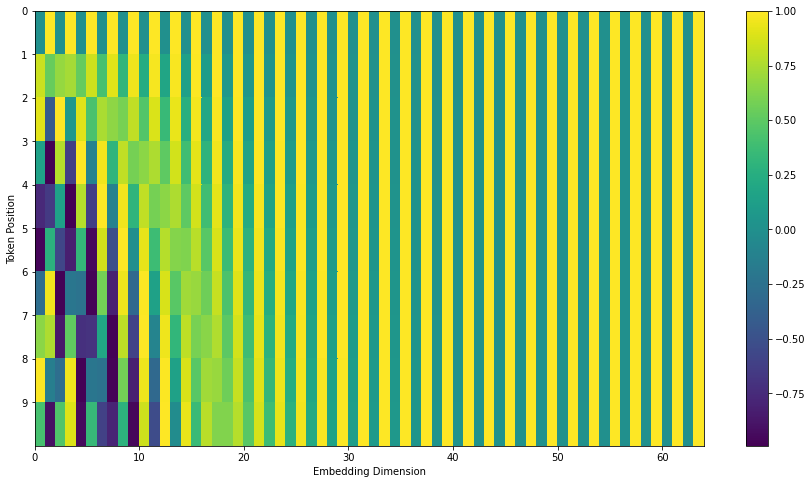
다음 그림에서 각 행은 벡터 하나의 위치 인코딩입니다. 그러니 첫 행은 입력 수열의 첫 단어 임베딩에 더할 벡터입니다. 각 행에는 값이 512개 있고, 각 값은 1과 -1 사이입니다. 패턴이 보이도록 값에 따라 색을 칠했습니다.
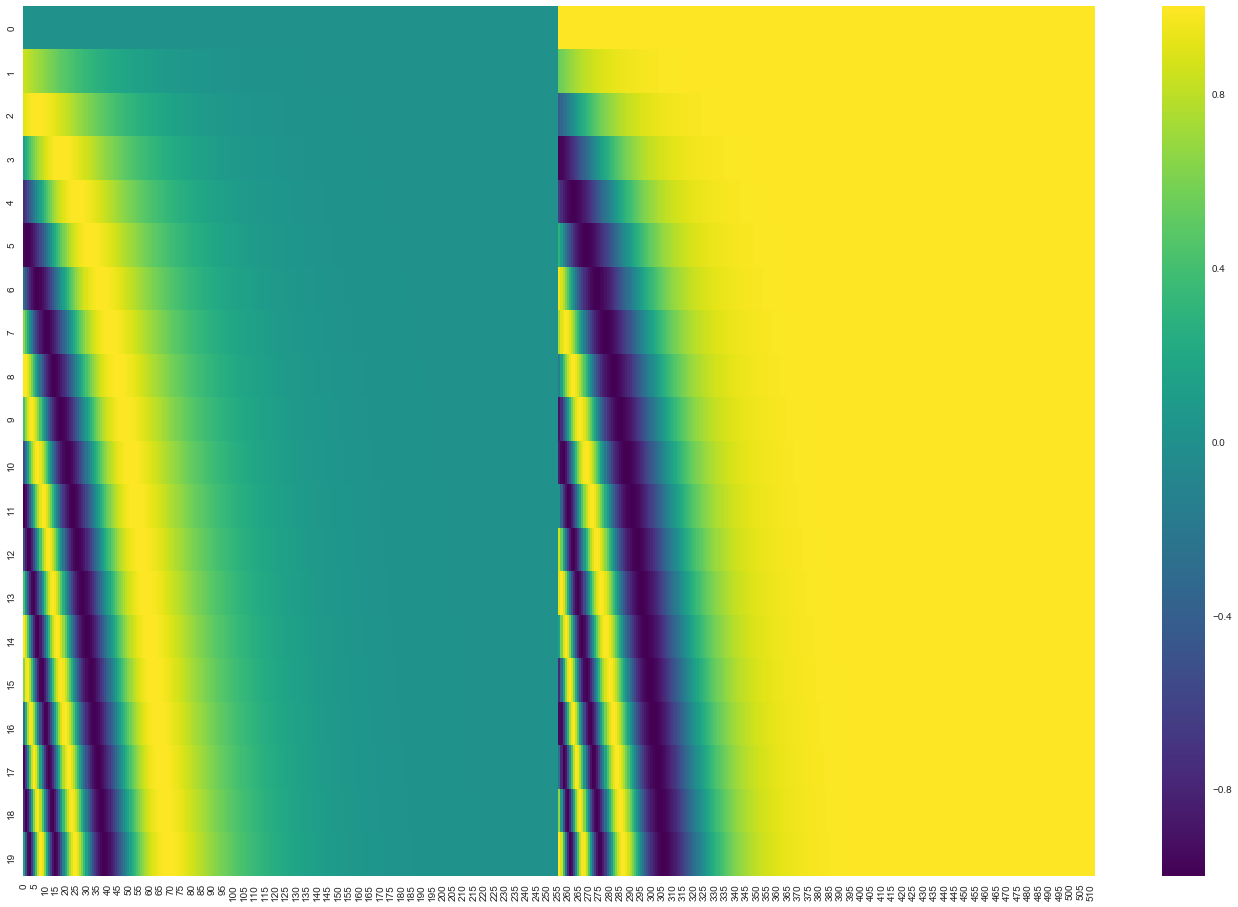 단어 20개(행)에 대해 임베딩 크기 512(열)로 만든 위치 인코딩의 실제 예입니다. 가운데에서 반으로 갈라진 것처럼 보이는데, 왼쪽 절반의 값은 사인을 쓰는 함수 하나로, 오른쪽 절반은 코사인을 쓰는 다른 함수로 만들었기 때문입니다. 그런 다음 둘을 이어 붙여 각 위치 인코딩 벡터를 만듭니다.
위치 인코딩 공식은 논문 3.5절에 나와 있습니다. 위치 인코딩을 만드는 코드는 get_timing_signal_1d()에서 볼 수 있습니다. 위치 인코딩 방법이 이것 하나만 있는 것은 아닙니다. 하지만 이 방법에는 처음 보는 길이의 수열에도 늘려 쓸 수 있다는 장점이 있습니다(예를 들어 학습한 모델에게 학습 데이터의 어떤 문장보다 긴 문장을 번역하라고 할 때).
2020년 7월 업데이트: 위에서 보인 위치 인코딩은 트랜스포머의 Tensor2Tensor 구현에서 가져온 것입니다. 논문에 나온 방법은 조금 다른데, 두 신호를 그대로 이어 붙이지 않고 번갈아 끼워 넣습니다. 다음 그림이 그 모습입니다. 이 그림을 만드는 코드는 여기 있습니다.
잔차 연결
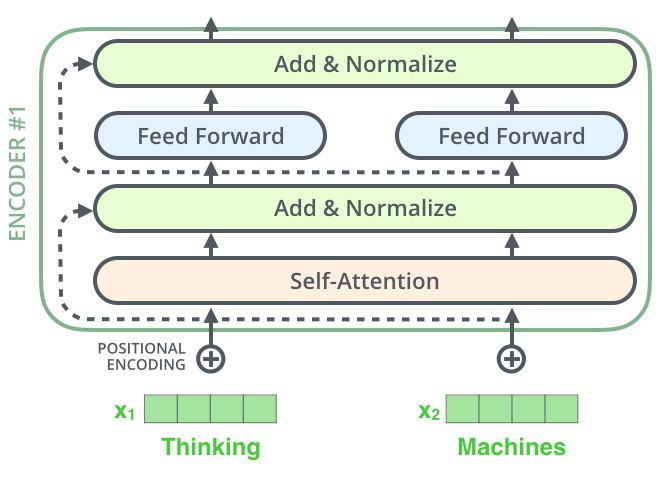
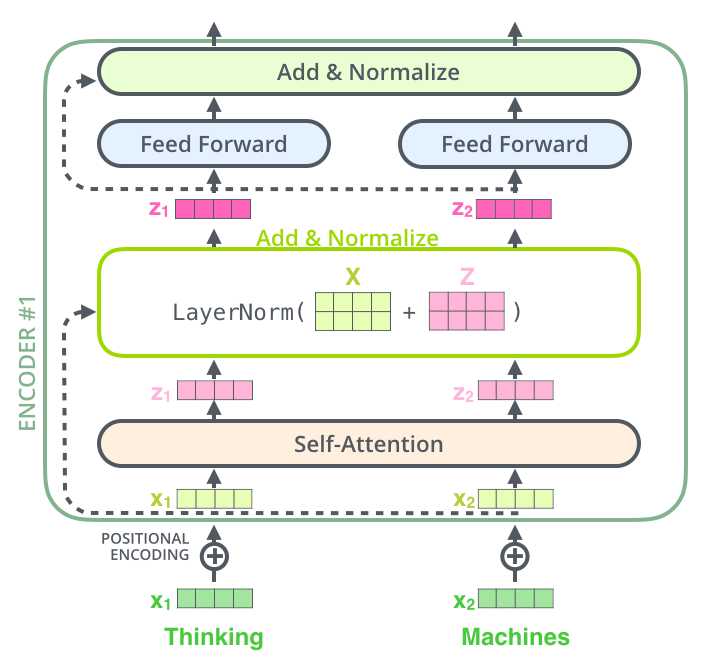
넘어가기 전에 짚어야 할 인코더 구조의 세부 사항이 하나 있습니다. 각 인코더의 각 하위 층(셀프 어텐션, 피드포워드 신경망)은 둘레에 잔차 연결이 있고, 그 뒤에 층 정규화 단계가 이어집니다.
셀프 어텐션에 딸린 벡터와 층 정규화 연산을 그림으로 나타내면 이렇게 됩니다.
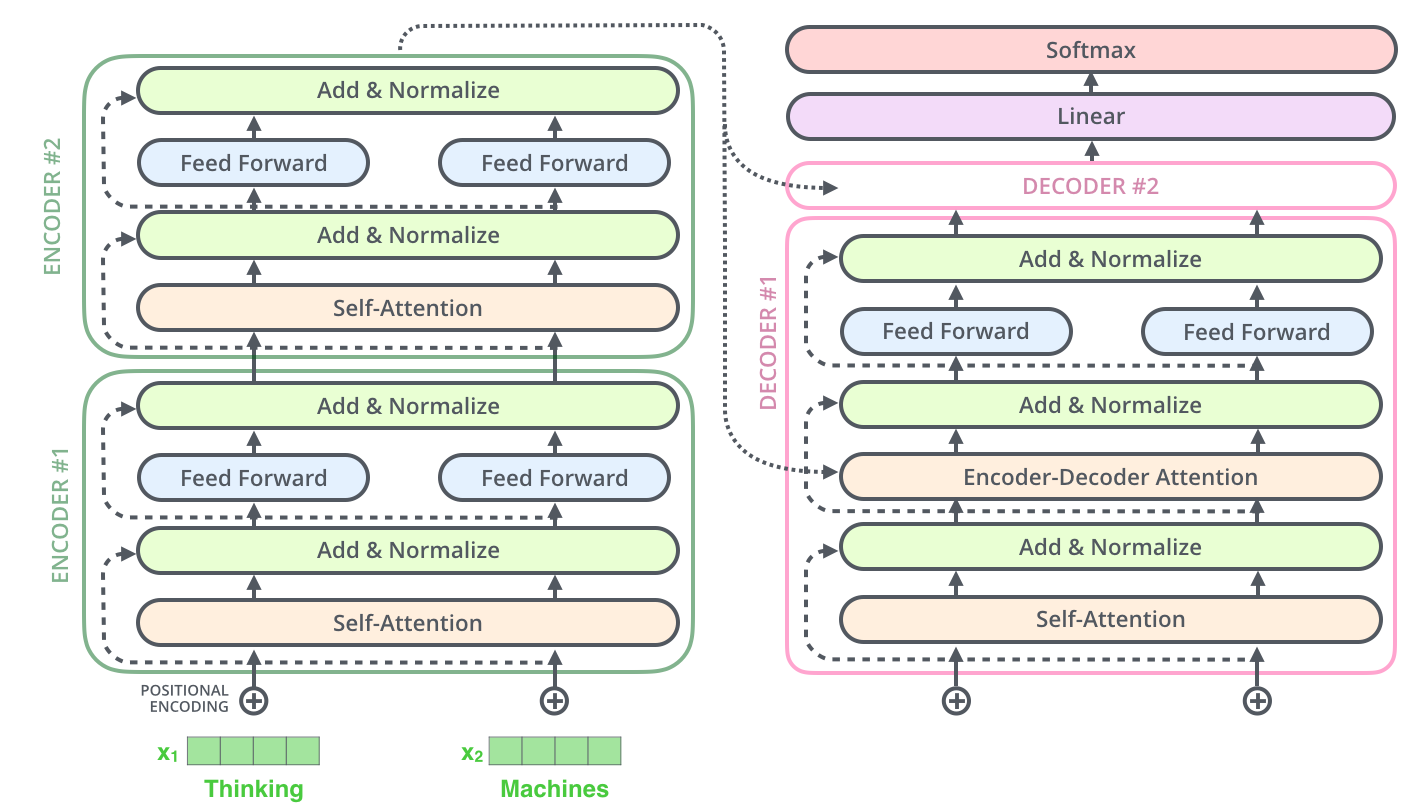
디코더의 하위 층도 마찬가지입니다. 인코더와 디코더를 두 개씩 쌓은 트랜스포머를 떠올려 보면 대략 이렇게 생겼습니다.
디코더 쪽
인코더 쪽 개념을 대부분 다뤘으니, 사실 디코더의 구성 요소가 어떻게 돌아가는지도 이미 아는 셈입니다. 하지만 이것들이 함께 어떻게 일하는지 살펴봅시다.
인코더는 입력 수열을 처리하는 것으로 시작합니다. 그다음 맨 위 인코더의 출력을 어텐션 벡터 K와 V의 묶음으로 바꿉니다. 각 디코더는 “인코더-디코더 어텐션” 층에서 이것을 쓰며, 이 층은 디코더가 입력 수열의 알맞은 곳에 집중하도록 돕습니다.
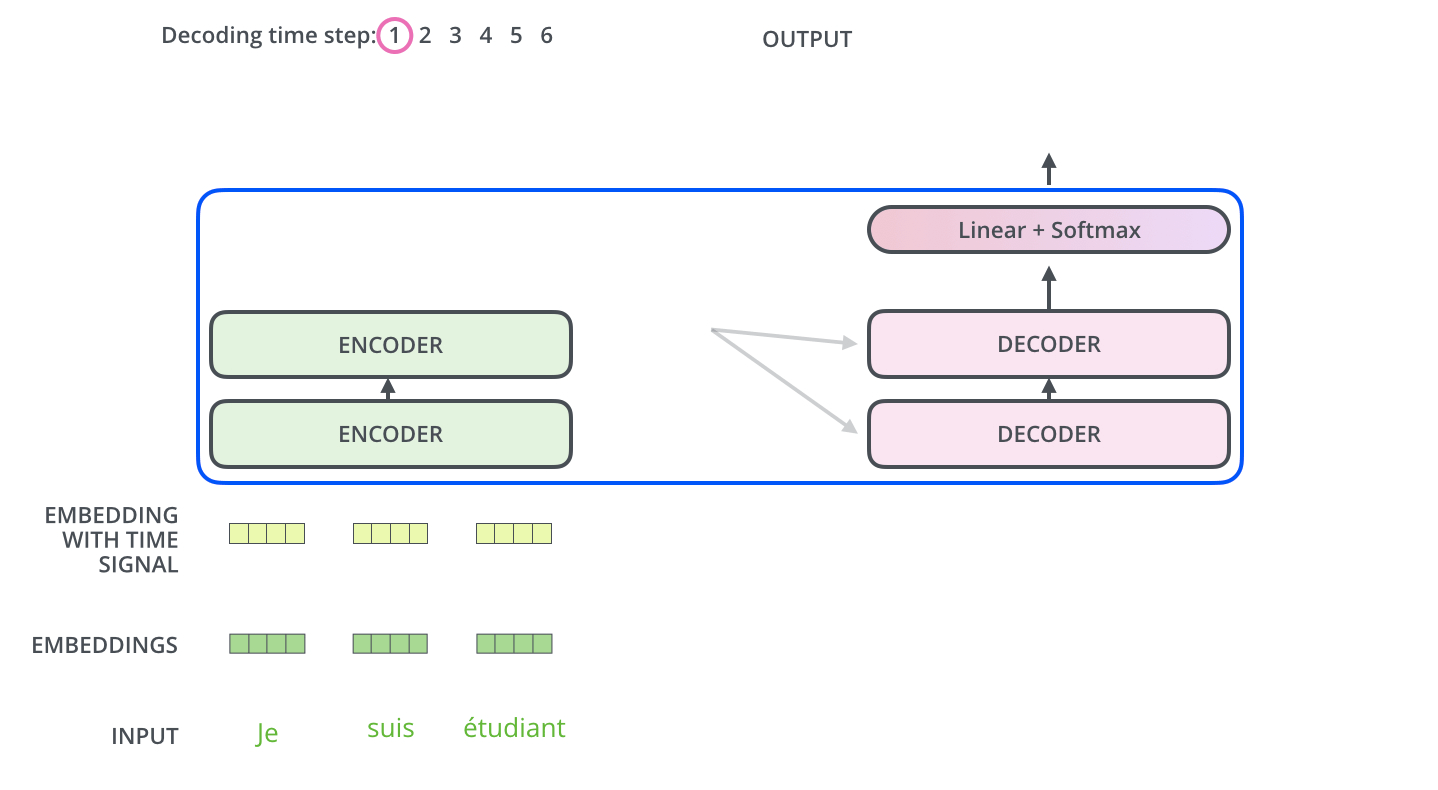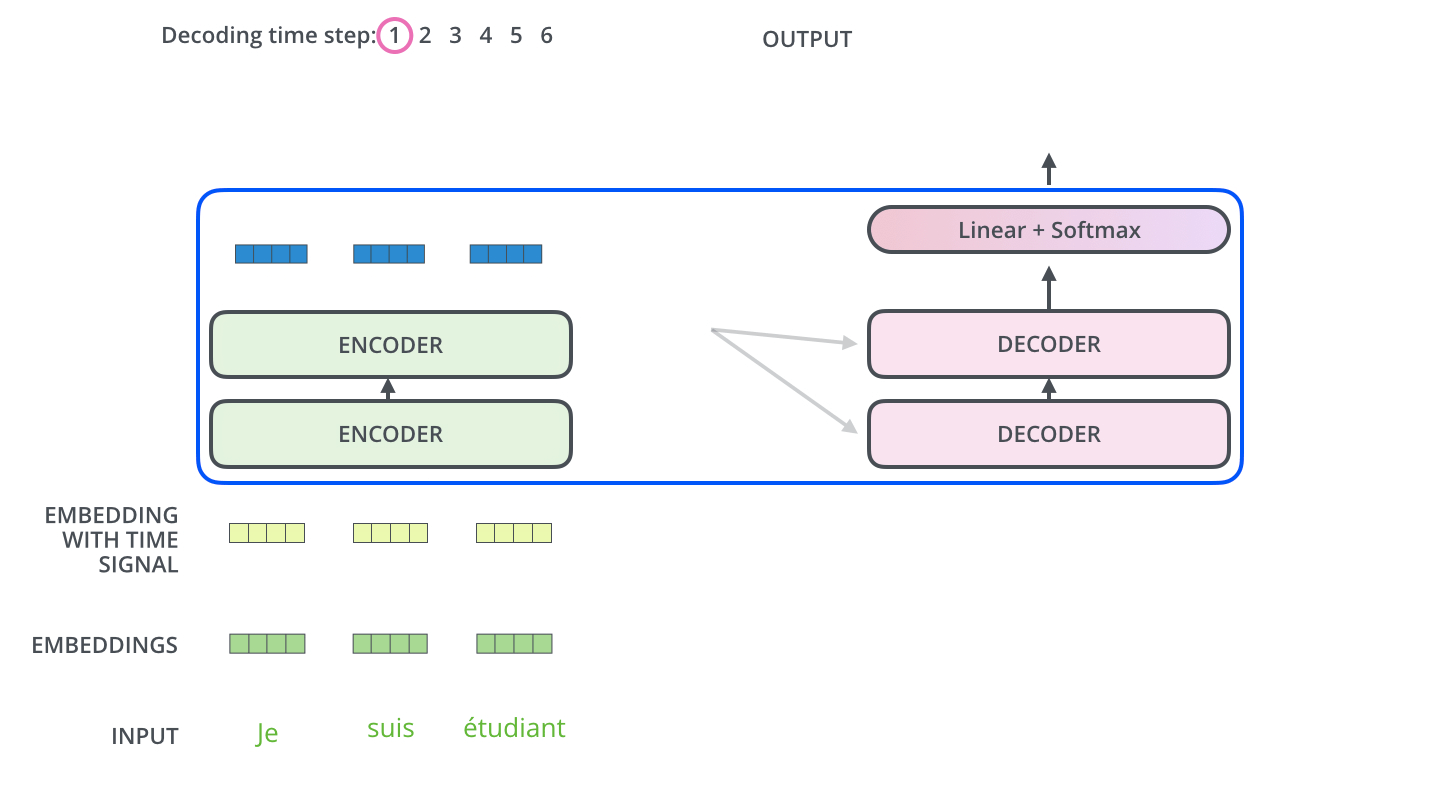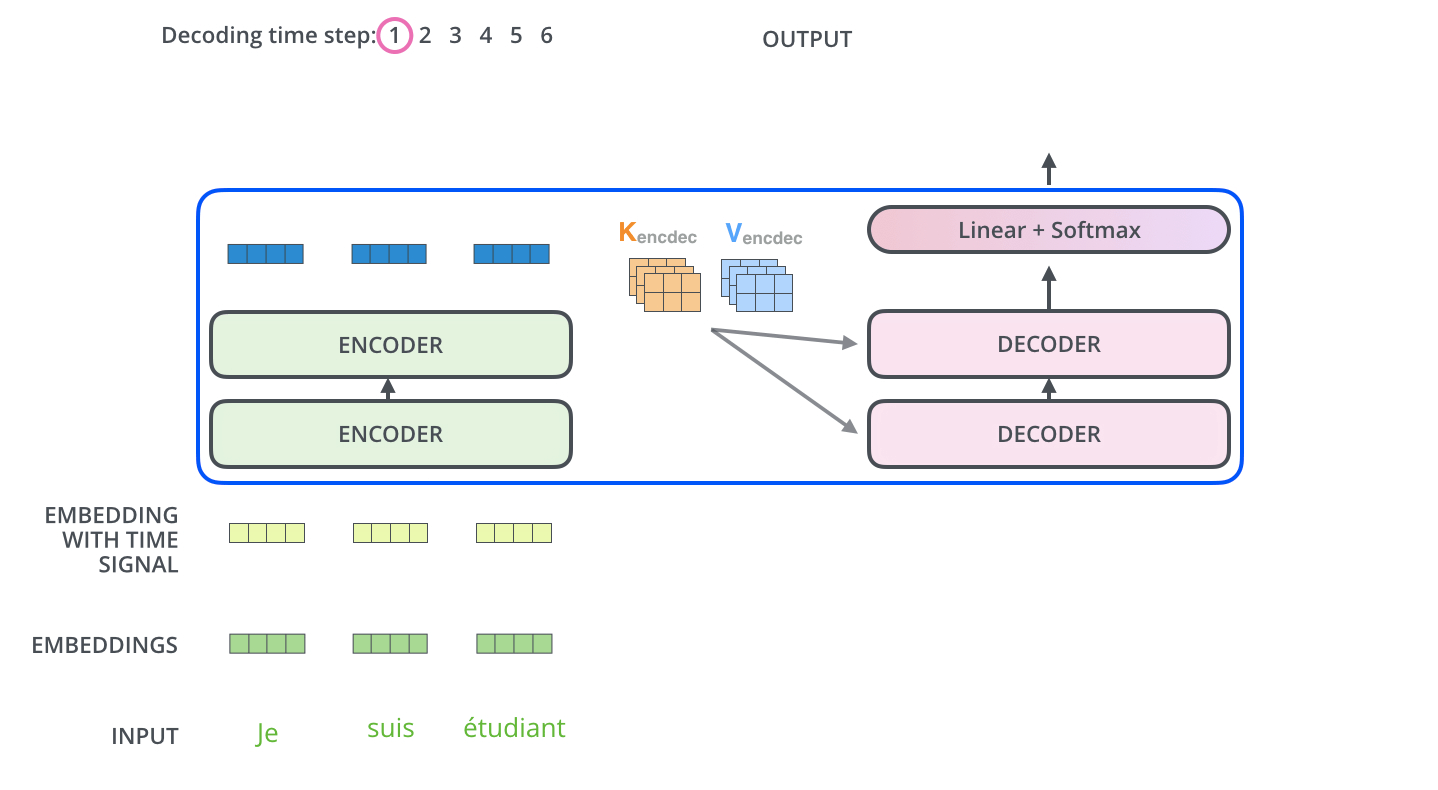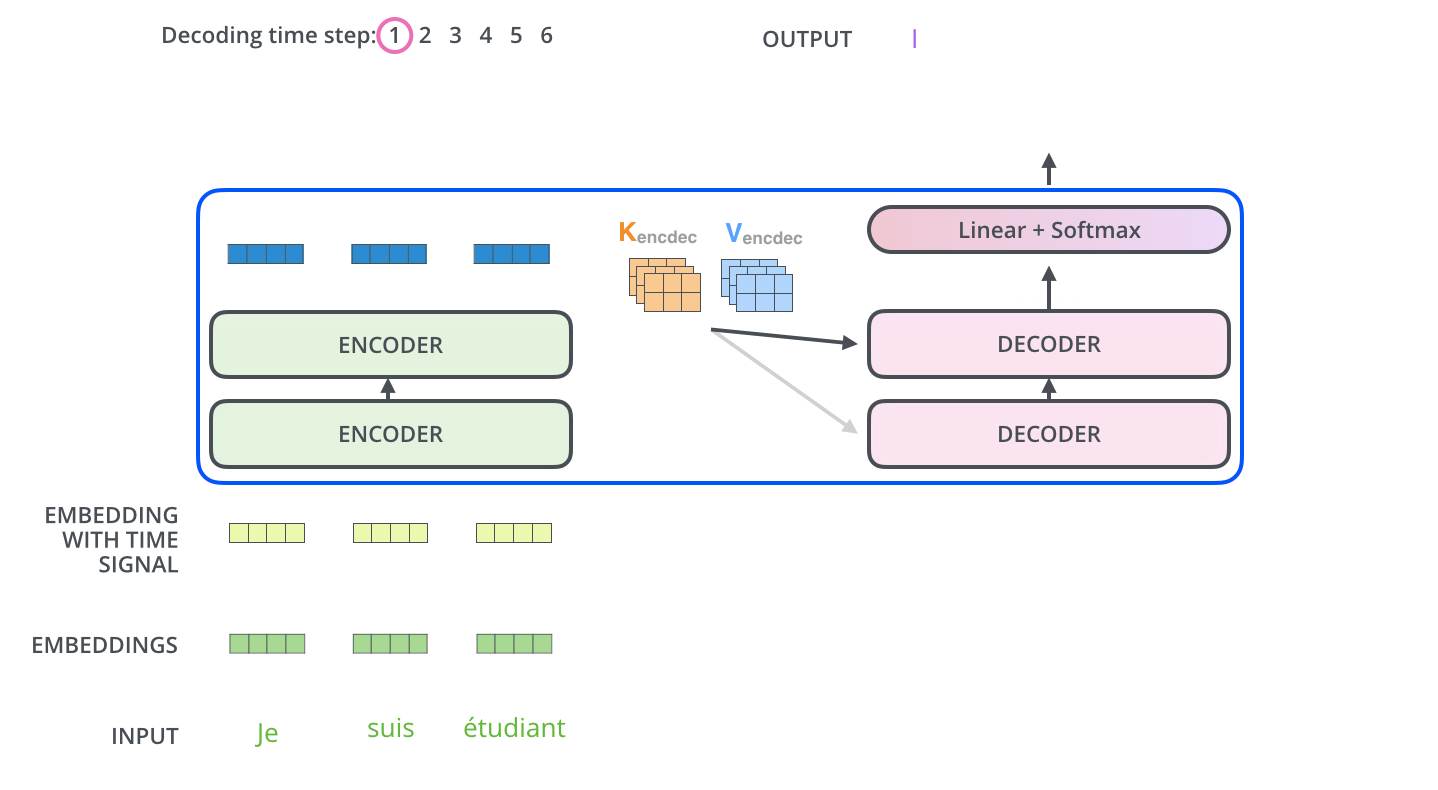 인코딩 단계를 마치면 디코딩 단계를 시작합니다. 디코딩 단계의 각 스텝은 출력 수열(여기서는 영어 번역문)의 원소 하나를 내놓습니다.
이어지는 스텝들은 트랜스포머 디코더가 출력을 마쳤음을 알리는 특수 기호에 이를 때까지 이 과정을 되풀이합니다. 각 스텝의 출력은 다음 시간 스텝에서 맨 아래 디코더로 들어가고, 디코더들은 인코더가 그랬던 것처럼 디코딩 결과를 위로 올려 보냅니다. 그리고 인코더 입력에서 했던 것과 똑같이, 디코더 입력에도 임베딩을 하고 위치 인코딩을 더해 각 단어의 위치를 나타냅니다.
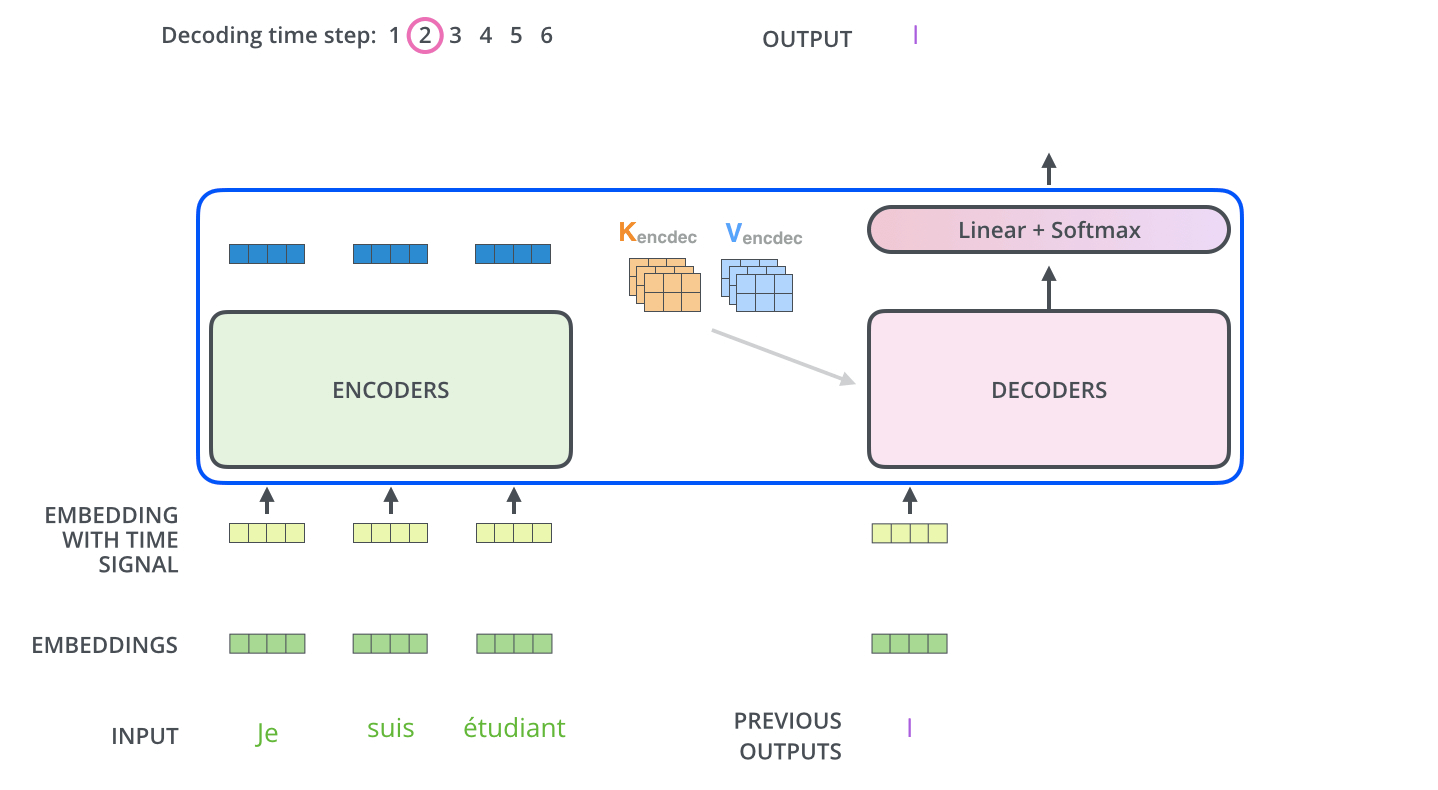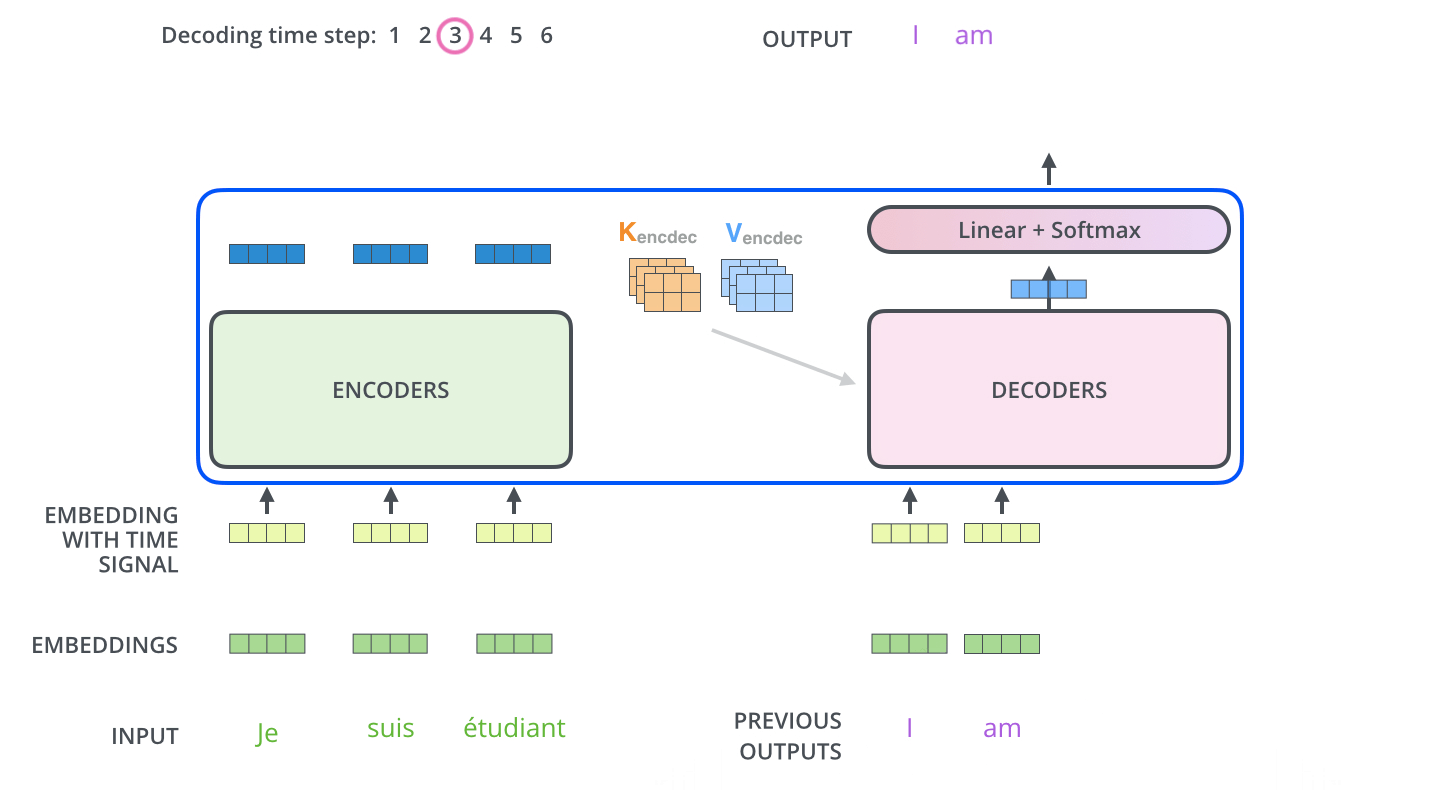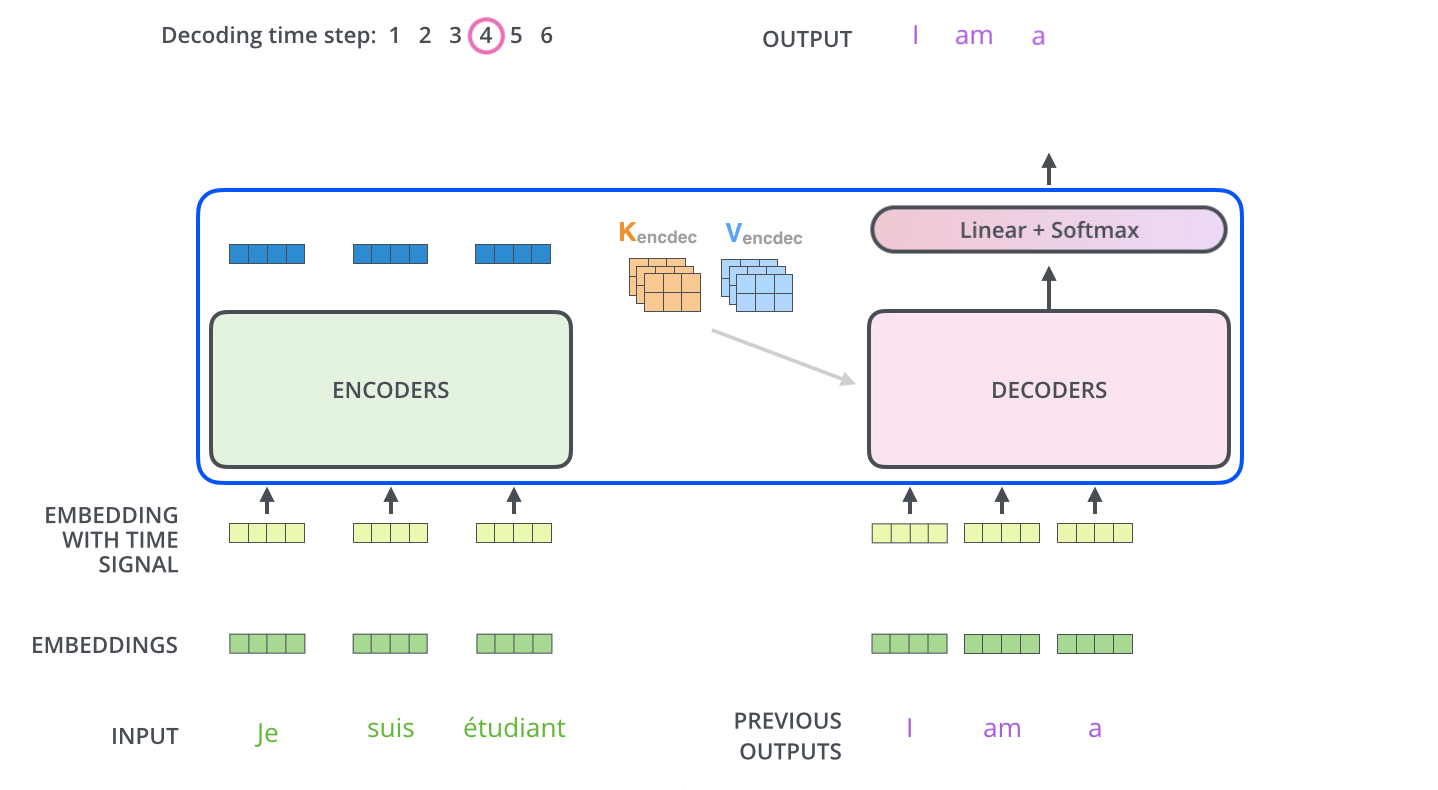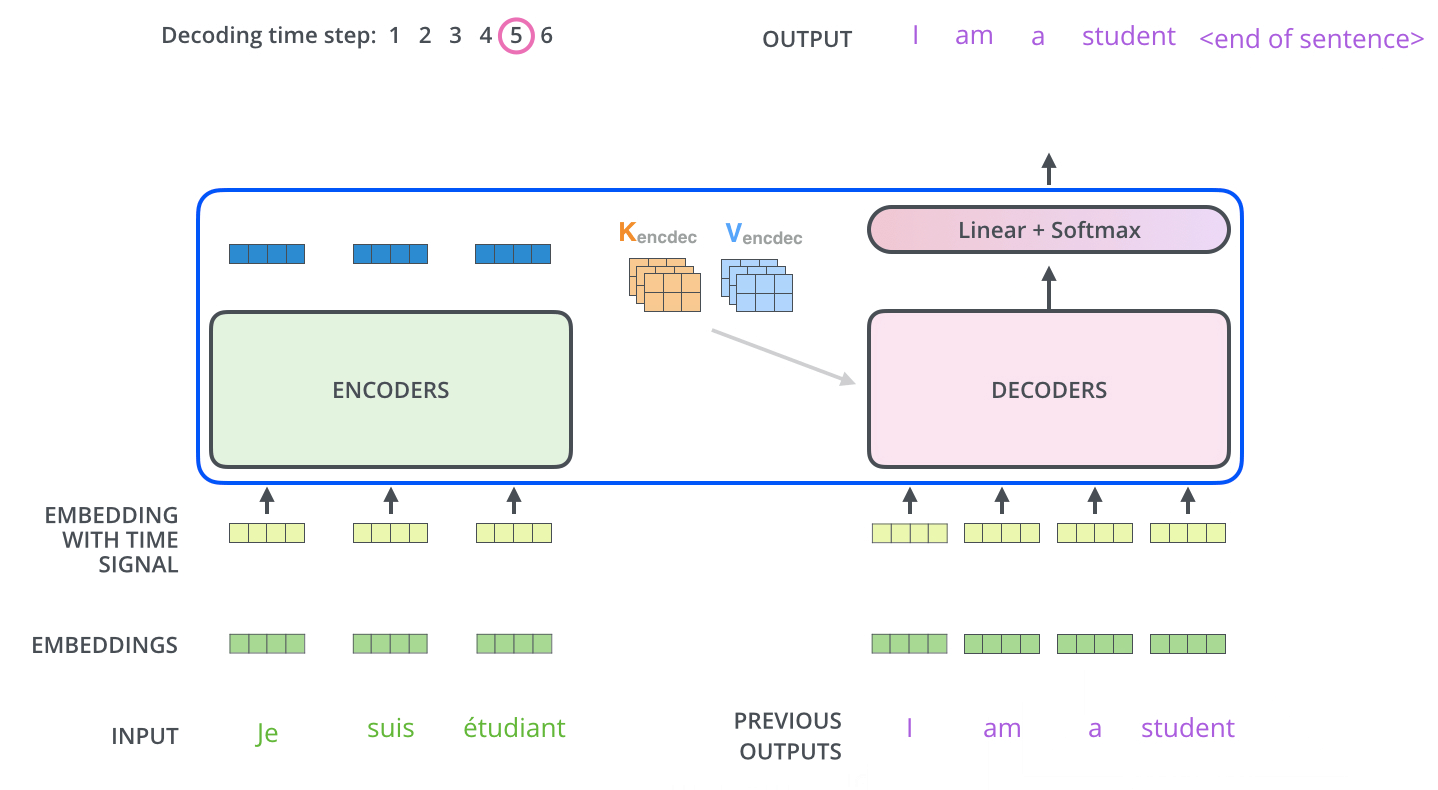
디코더의 셀프 어텐션 층은 인코더의 것과 조금 다르게 돌아갑니다.
디코더에서 셀프 어텐션 층은 출력 수열의 앞쪽 위치에만 주의를 기울일 수 있습니다. 이는 셀프 어텐션 계산에서 소프트맥스 단계 전에 미래 위치를 가려서(-inf로 설정해서) 이뤄집니다.
“인코더-디코더 어텐션” 층은 멀티헤드 셀프 어텐션과 똑같이 돌아가는데, 다만 쿼리 행렬은 바로 아래 층에서 만들고, 키와 값 행렬은 인코더 묶음의 출력에서 가져옵니다.
마지막 선형 층과 소프트맥스 층
디코더 묶음은 실수로 된 벡터를 내놓습니다. 이것을 어떻게 단어로 바꿀까요? 그것이 마지막 선형 층과 그 뒤를 잇는 소프트맥스 층이 하는 일입니다.
선형 층은 단순한 완전 연결 신경망으로, 디코더 묶음이 만든 벡터를 로짓 벡터라고 부르는 훨씬, 훨씬 더 큰 벡터로 투영합니다.
모델이 학습 데이터셋에서 배운 서로 다른 영어 단어를 10,000개 안다고 해 봅시다(모델의 “출력 어휘”). 그러면 로짓 벡터는 칸이 10,000개이고, 각 칸은 단어 하나의 점수에 해당합니다. 선형 층을 거친 모델의 출력은 이렇게 해석합니다.
그다음 소프트맥스 층이 이 점수들을 확률로 바꿉니다(모두 양수이고, 합하면 1.0이 됩니다). 확률이 가장 높은 칸을 고르고, 그 칸에 해당하는 단어를 이 시간 스텝의 출력으로 내놓습니다.
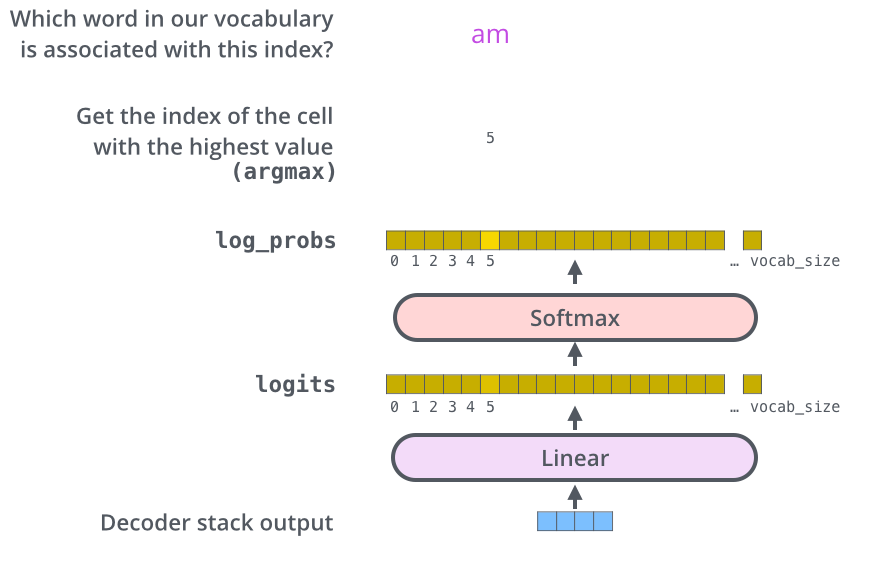 이 그림은 맨 아래, 디코더 묶음의 출력으로 나온 벡터에서 시작합니다. 이 벡터가 출력 단어로 바뀝니다.
학습 되짚어 보기
학습된 트랜스포머의 순전파 과정 전체를 다뤘으니, 모델을 학습시키는 직관도 훑어보면 좋겠습니다.
학습하는 동안 아직 학습되지 않은 모델도 똑같은 순전파를 거칩니다. 하지만 정답이 달린 학습 데이터셋으로 학습시키는 것이므로, 모델의 출력을 실제 정답 출력과 비교할 수 있습니다.
이것을 그림으로 보기 위해, 출력 어휘에 단어가 여섯 개만 있다고 해 봅시다(“a”, “am”, “i”, “thanks”, “student”, 그리고 ‘문장 끝’을 뜻하는 “<eos>”).
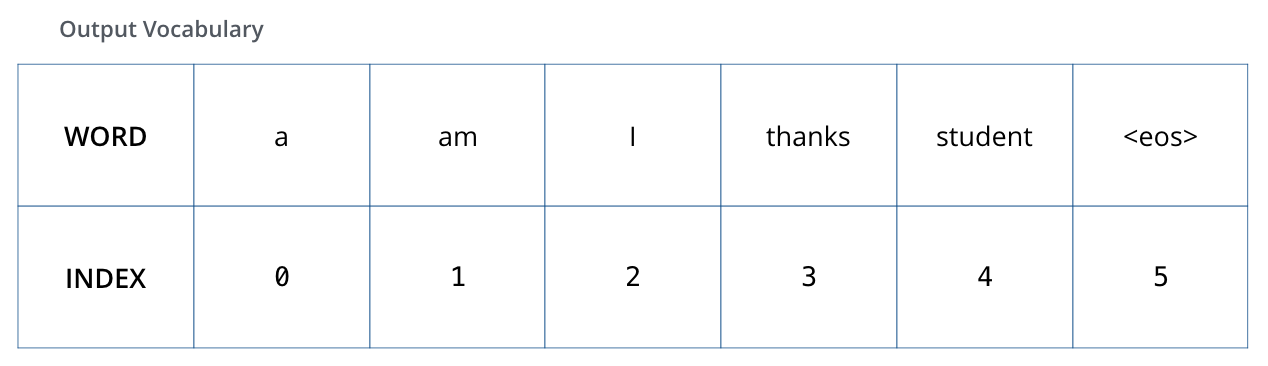 모델의 출력 어휘는 학습을 시작하기도 전, 전처리 단계에서 만들어집니다.
출력 어휘를 정하고 나면, 같은 너비의 벡터로 어휘의 각 단어를 나타낼 수 있습니다. 이것을 원핫 인코딩이라고도 합니다. 예를 들어 “am”이라는 단어는 다음 벡터로 나타낼 수 있습니다.
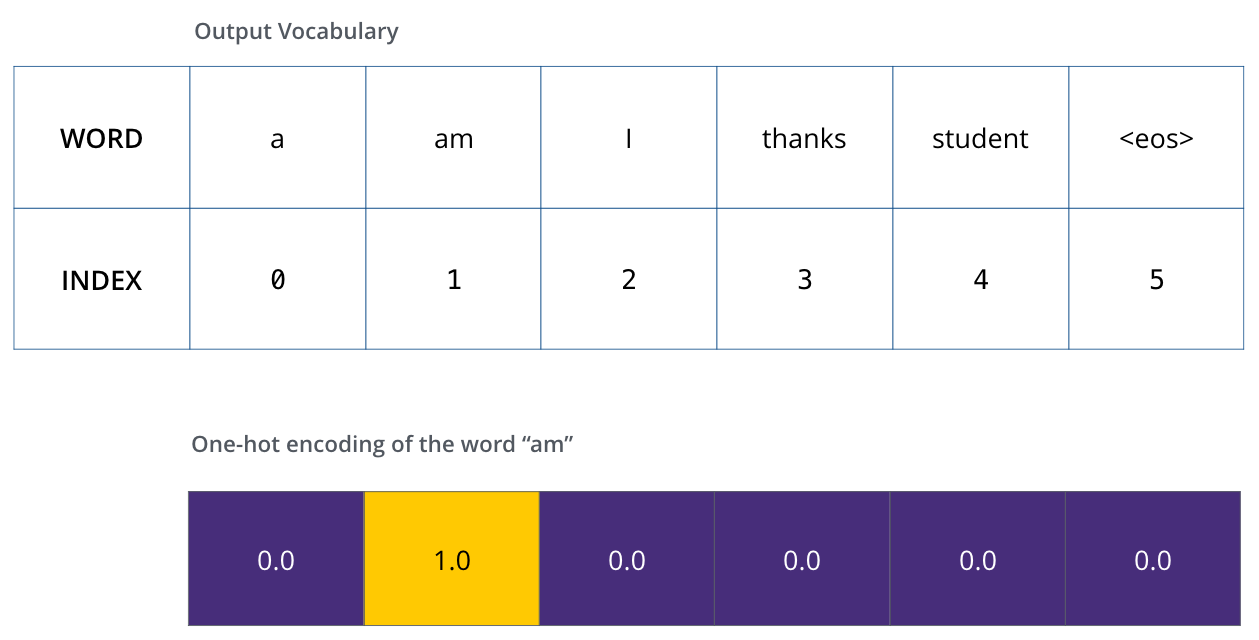 예시: 출력 어휘의 원핫 인코딩
이렇게 되짚어 본 데 이어, 모델의 손실 함수를 이야기해 봅시다. 손실 함수는 학습 단계에서 최적화하는 지표로, 이를 통해 학습된, 그리고 바라건대 놀랍도록 정확한 모델에 이르게 됩니다.
손실 함수
모델을 학습시키는 중이라고 해 봅시다. 학습 단계의 첫 스텝이고, “merci”를 “thanks”로 옮기는 간단한 예시로 학습시킨다고 해 봅시다.
이 말은 출력이 “thanks”라는 단어를 가리키는 확률 분포가 되기를 바란다는 뜻입니다. 하지만 이 모델은 아직 학습되지 않았으므로, 당장은 그렇게 될 가능성이 낮습니다.
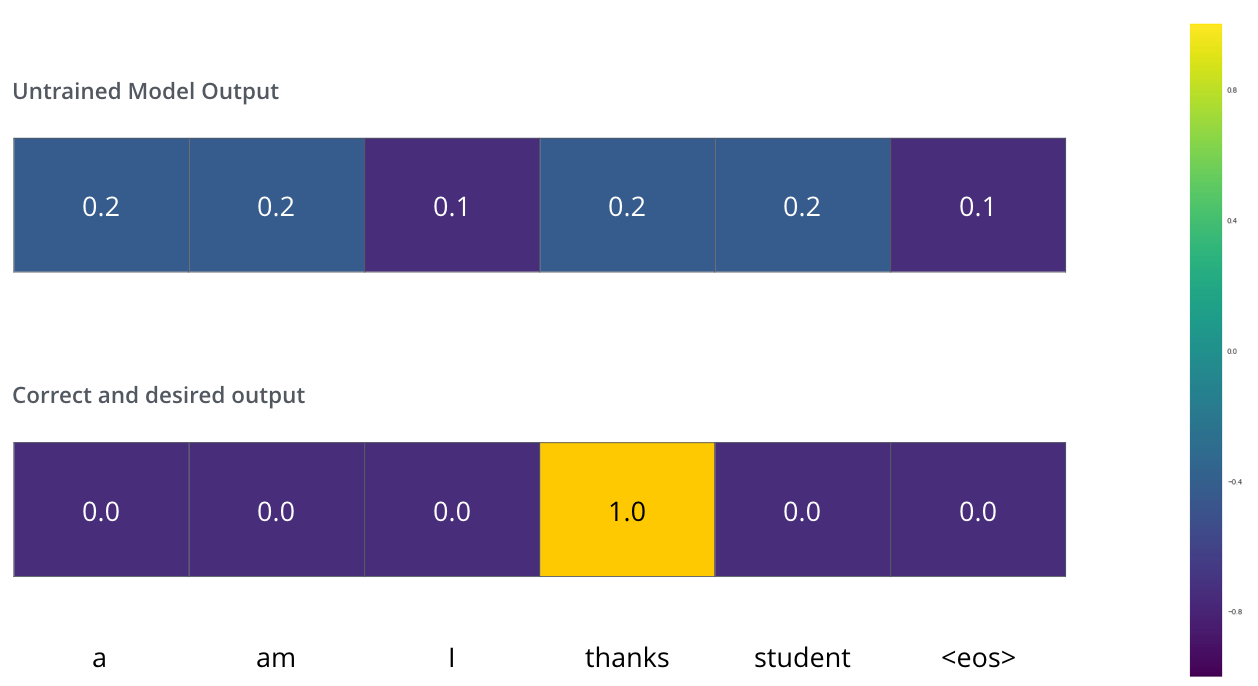 모델의 파라미터(가중치)는 모두 무작위로 초기화되므로, (학습되지 않은) 모델은 각 칸, 곧 각 단어에 아무렇게나 정해진 값을 가진 확률 분포를 내놓습니다. 이것을 실제 출력과 비교한 다음, 역전파로 모델의 가중치를 모두 조금씩 고쳐 출력이 원하는 출력에 더 가까워지게 할 수 있습니다.
두 확률 분포는 어떻게 비교할까요? 그냥 한쪽에서 다른 쪽을 뺍니다. 더 자세한 내용은 교차 엔트로피와 쿨백-라이블러 발산을 참고하세요.
하지만 이것은 지나치게 단순화한 예시라는 점에 주의하세요. 더 현실적으로는 한 단어보다 긴 문장을 씁니다. 예를 들어 입력은 “je suis étudiant”이고 기대하는 출력은 “i am a student”입니다. 이 말은 모델이 다음과 같은 확률 분포들을 차례로 내놓기를 바란다는 뜻입니다.
- 각 확률 분포는 너비가 vocab_size인 벡터로 나타냅니다(장난감 예시에서는 6이지만, 현실에서는 30,000이나 50,000 같은 수입니다).
- 첫 번째 확률 분포는 단어 “i”에 해당하는 칸의 확률이 가장 높습니다.
- 두 번째 확률 분포는 단어 “am”에 해당하는 칸의 확률이 가장 높습니다.
- 이런 식으로 이어지다가, 다섯 번째 출력 분포는 ‘
<end of sentence>’ 기호를 가리킵니다. 이 기호에도 10,000개 원소로 된 어휘 안에 해당하는 칸이 있습니다.
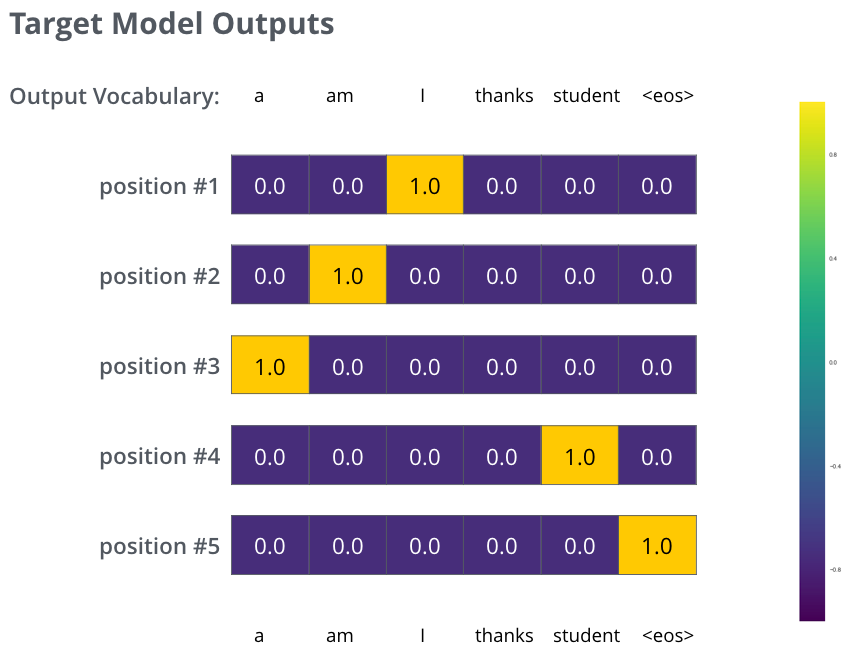 예시 문장 하나에 대해, 학습 예시에서 모델이 맞추도록 학습시킬 목표 확률 분포들
충분히 큰 데이터셋으로 충분히 오래 모델을 학습시키고 나면, 만들어지는 확률 분포가 이렇게 되기를 바랍니다.
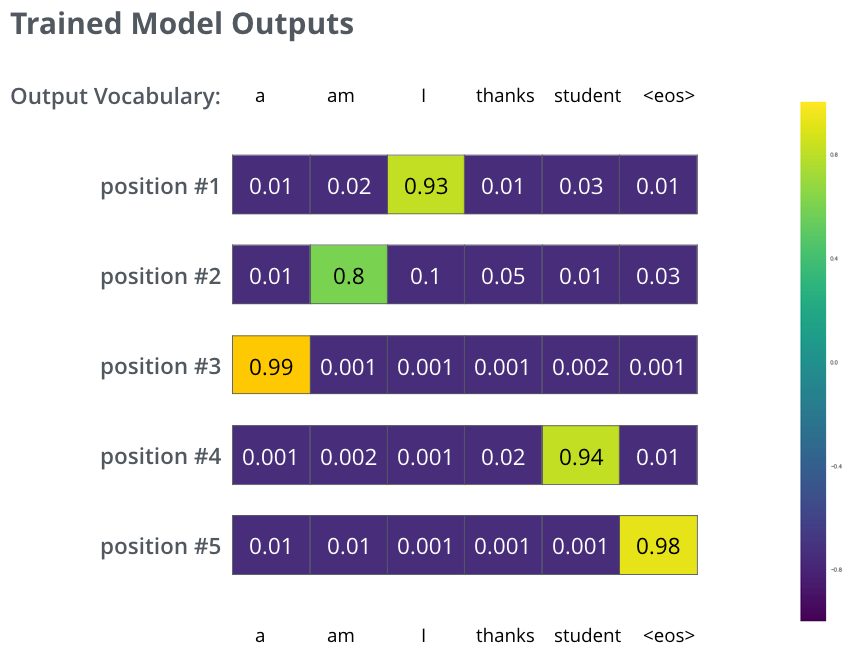 학습을 마치면 모델이 우리가 기대하는 올바른 번역을 내놓기를 바랍니다. 물론 이 문장이 학습 데이터셋에 들어 있었다면 이것이 진짜 실력을 보여 주는 것은 아닙니다(교차 검증 참고). 그 시간 스텝의 출력이 될 가능성이 낮은 위치에도 확률이 조금씩 돌아간다는 점에 주목하세요. 이것은 학습 과정에 도움이 되는 소프트맥스의 아주 쓸모 있는 성질입니다.
모델은 출력을 하나씩 내놓으므로, 모델이 그 확률 분포에서 확률이 가장 높은 단어를 고르고 나머지는 버린다고 생각할 수 있습니다. 이것이 한 가지 방법입니다(탐욕적 디코딩이라고 부릅니다). 다른 방법은 이를테면 상위 두 단어(예를 들어 ‘I’와 ‘a’)를 붙잡아 두고, 다음 스텝에서 모델을 두 번 돌리는 것입니다. 한 번은 첫 출력 위치가 ‘I’라고 가정하고, 또 한 번은 첫 출력 위치가 ‘a’라고 가정합니다. 그리고 1번과 2번 위치를 함께 고려했을 때 오차가 더 작은 쪽을 남깁니다. 이것을 2번과 3번 위치 등에 대해서도 되풀이합니다. 이 방법을 “빔 탐색”이라고 부릅니다. 우리 예시에서는 beam_size가 2였고(언제나 부분 가설, 곧 끝나지 않은 번역 두 개를 메모리에 둔다는 뜻입니다), top_beams도 2입니다(번역 두 개를 돌려준다는 뜻입니다). 둘 다 실험해 볼 수 있는 하이퍼파라미터입니다.
나아가서 트랜스폼하세요
이 글이 트랜스포머의 주요 개념에 처음 다가가는 출발점으로 쓸모 있었기를 바랍니다. 더 깊이 들어가고 싶다면 다음 단계를 권합니다.
- Attention Is All You Need 논문, 트랜스포머 블로그 글(Transformer: A Novel Neural Network Architecture for Language Understanding), 그리고 Tensor2Tensor 발표 글을 읽어 보세요.
- 모델과 그 세부 사항을 차근차근 설명하는 우카시 카이저의 발표를 보세요.
- Tensor2Tensor 저장소의 일부로 제공되는 주피터 노트북을 가지고 놀아 보세요.
- Tensor2Tensor 저장소를 둘러보세요.
후속 연구:
- Depthwise Separable Convolutions for Neural Machine Translation
- One Model To Learn Them All
- Discrete Autoencoders for Sequence Models
- Generating Wikipedia by Summarizing Long Sequences
- Image Transformer
- Training Tips for the Transformer Model
- Self-Attention with Relative Position Representations
- Fast Decoding in Sequence Models using Discrete Latent Variables
- Adafactor: Adaptive Learning Rates with Sublinear Memory Cost
감사의 말
이 글의 앞선 판에 의견을 준 일리야 폴로수힌, 야코프 우슈코라이트, 라이언 존스, 우카시 카이저, 니키 파르마르, 노암 셰이저에게 감사드립니다.
바로잡을 점이나 의견이 있으면 트위터로 연락 주세요.
2018년 6월 27일 작성