Filip Korzeniowski: AMSGrad 실험Filip Korzeniowski: Experiments with AMSGrad
Adam의 수렴 증명에 있는 결함을 고친 AMSGrad를 논문보다 큰 VGG 계열 모델과 로지스틱 회귀로 다시 실험해 보니, 검증 손실은 낮아졌지만 정작 검증 정확도에서는 Adam과 뚜렷한 차이가 없었다고 보고하는 Filip Korzeniowski의 글
Contents목차
번역문 · 원저자: Filip Korzeniowski (fdlm) · 원문: Experiments with AMSGrad · 원문 라이선스: CC BY 4.0. 원문을 한국어로 옮긴 것 말고는 내용을 바꾸지 않았습니다. 원문 글쓴이가 만든 그림은 글과 같은 CC BY 4.0을 따르므로 실었습니다. 원문의 그래프는 화면에서 움직이는 형태라서, 같은 데이터를 원문 페이지에서 그린 그대로 그림 파일로 저장해 실었습니다.
원문: 「Experiments with AMSGrad」, Filip Korzeniowski, https://fdlm.github.io/post/amsgrad/, 2017년 12월 22일 게시. 이 글은 원문을 한국어로 옮긴 번역문입니다.
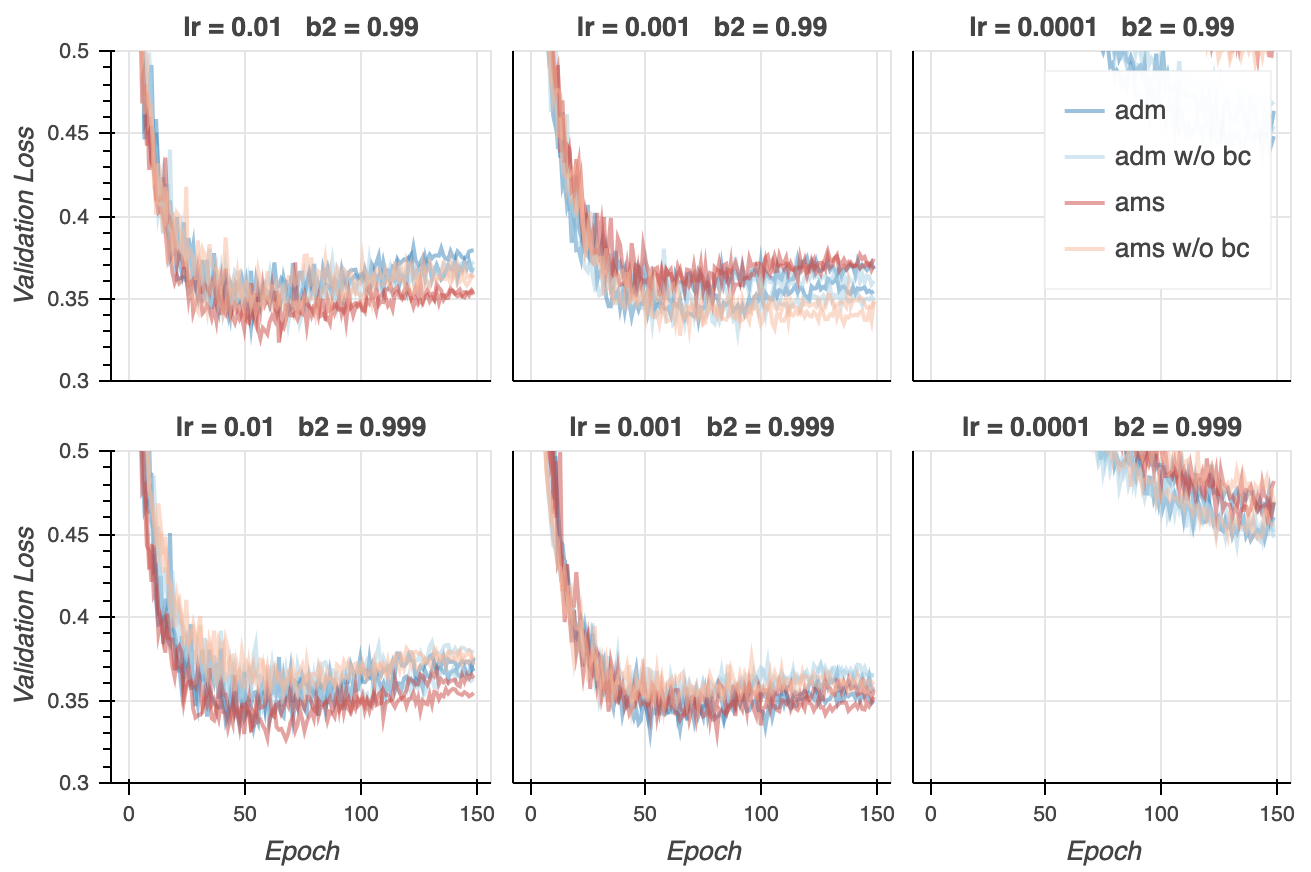
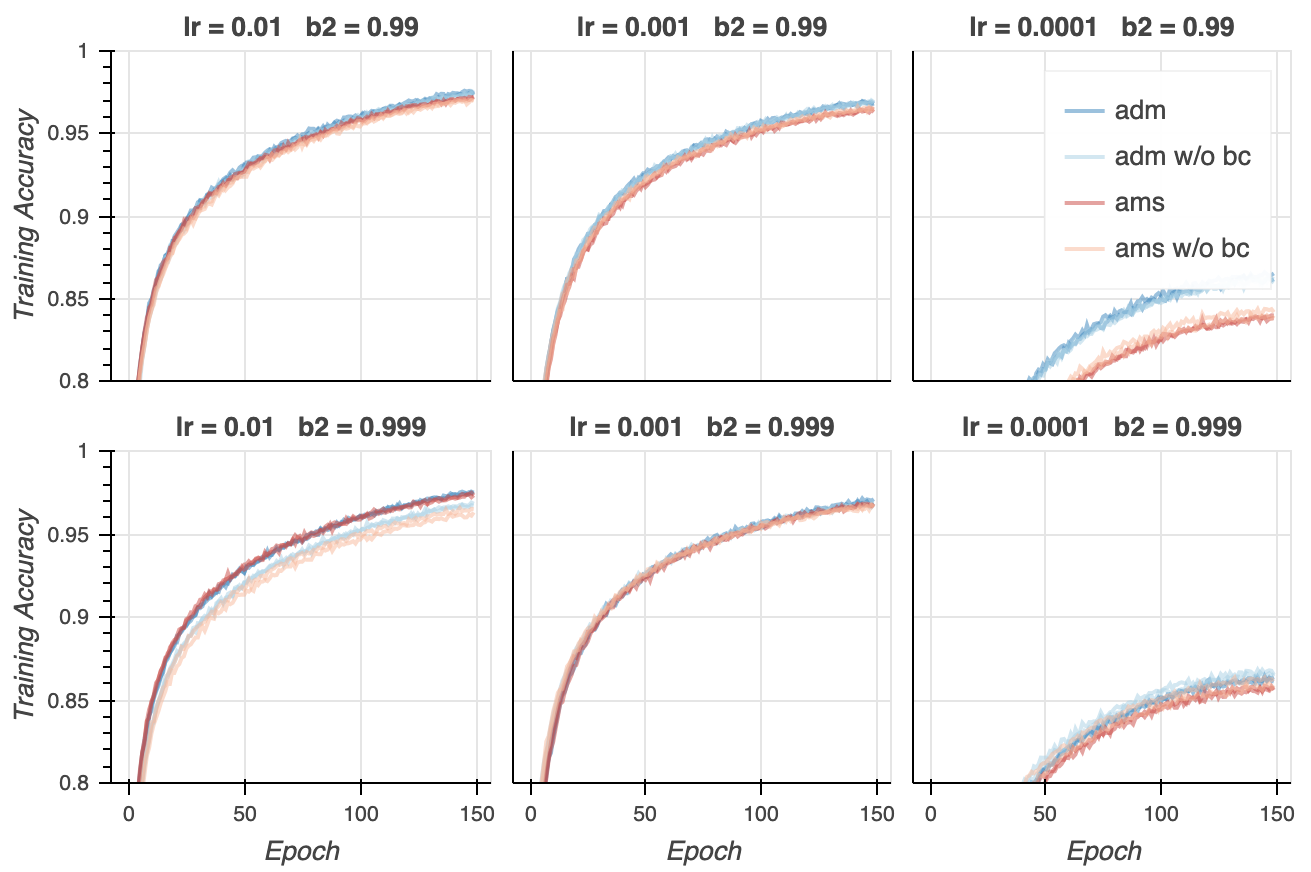
라이선스: 원문 페이지 아래에 “Creative Commons Attribution 4.0 International License를 따른다”고 적혀 있습니다. 이 번역도 원저작자를 밝히고 CC BY 4.0 조건에 따라 싣습니다. 원문의 그래프 17개는 Bokeh로 그린 대화형 그래프를 그림 파일로 저장해 실은 것이라, 확대나 곡선 끄기 같은 조작은 원문에서 할 수 있습니다. 그래프 범례의 adm은 ADAM, ams는 AMSGrad, w/o bc는 편향 보정을 끈 경우를 뜻합니다.
ICLR 2018에 ADAM 업데이트 규칙의 문제를 겨냥한 논문 두 편이 제출되었습니다. On the Convergence of Adam and Beyond(Adam의 수렴과 그 너머)와 Fixing Weight Decay Regularization in Adam(Adam의 가중치 감쇠 정규화 바로잡기)입니다. 앞의 논문은 ADAM의 수렴 증명에 있는 결함을 짚고, 간단한 해법을 내놓습니다. 그렇게 나온 알고리즘을 AMSGrad라고 부릅니다. 논문은 합성 작업 하나와 몇 안 되는 실험으로 AMSGrad의 장점을 보여 줍니다. 하지만 작은 네트워크만 쓰고(MNIST에 1층 MLP, CIFAR-10에 작은 합성곱 신경망), 결국 우리가 교차 엔트로피 손실보다 더 신경 쓰는 지표인 테스트 정확도는 보여 주지 않습니다. 논문에서 CIFAR-10으로 학습한 합성곱 신경망은 학습 손실과 테스트 손실 모두 최신 성능과는 거리가 멉니다(정확도는 알 수 없습니다).
저는 실험 대부분에서 ADAM을 쓰기 때문에, 좀 더 현실적인 네트워크로 AMSGrad를 평가해 보기로 했습니다. 여기서 학습한 모델들도 여전히 작고 최신 성능은 아니지만, 논문에서 보여 준 것보다는 분명히 더 가깝습니다.
AMSGrad를 구현하려고 Lasagne의 ADAM 구현을 가져와 그에 맞게 고쳤습니다. ADAM의 편향 보정을 끌 수 있는 옵션도 더했습니다.
def amsgrad(loss_or_grads, params, learning_rate=0.001, beta1=0.9,
            beta2=0.999, epsilon=1e-8, bias_correction=True):
    all_grads = get_or_compute_grads(loss_or_grads, params)
    t_prev = theano.shared(utils.floatX(0.))
    updates = OrderedDict()

    # Using theano constant to prevent upcasting of float32
    one = T.constant(1)
    t = t_prev + 1

    if bias_correction:
        a_t = learning_rate*T.sqrt(one-beta2**t)/(one-beta1**t)
    else:
        a_t = learning_rate

    for param, g_t in zip(params, all_grads):
        value = param.get_value(borrow=True)
        m_prev = theano.shared(np.zeros(value.shape, dtype=value.dtype),
                               broadcastable=param.broadcastable)
        v_prev = theano.shared(np.zeros(value.shape, dtype=value.dtype),
                               broadcastable=param.broadcastable)
        v_hat_prev = theano.shared(np.zeros(value.shape, dtype=value.dtype),
                                   broadcastable=param.broadcastable)

        m_t = beta1*m_prev + (one-beta1)*g_t
        v_t = beta2*v_prev + (one-beta2)*g_t**2
        v_hat_t = T.maximum(v_hat_prev, v_t)
        step = a_t*m_t/(T.sqrt(v_hat_t) + epsilon)

        updates[m_prev] = m_t
        updates[v_prev] = v_t
        updates[v_hat_prev] = v_hat_t
        updates[param] = param - step

    updates[t_prev] = t
    return updates
먼저 구현이 맞는지 확인해 봅시다. 이를 위해 논문에 나온 합성 실험을 확률적 설정으로 돌려 보았습니다. 그 결과로 나온 학습 곡선은 다음 그래프와 같습니다.
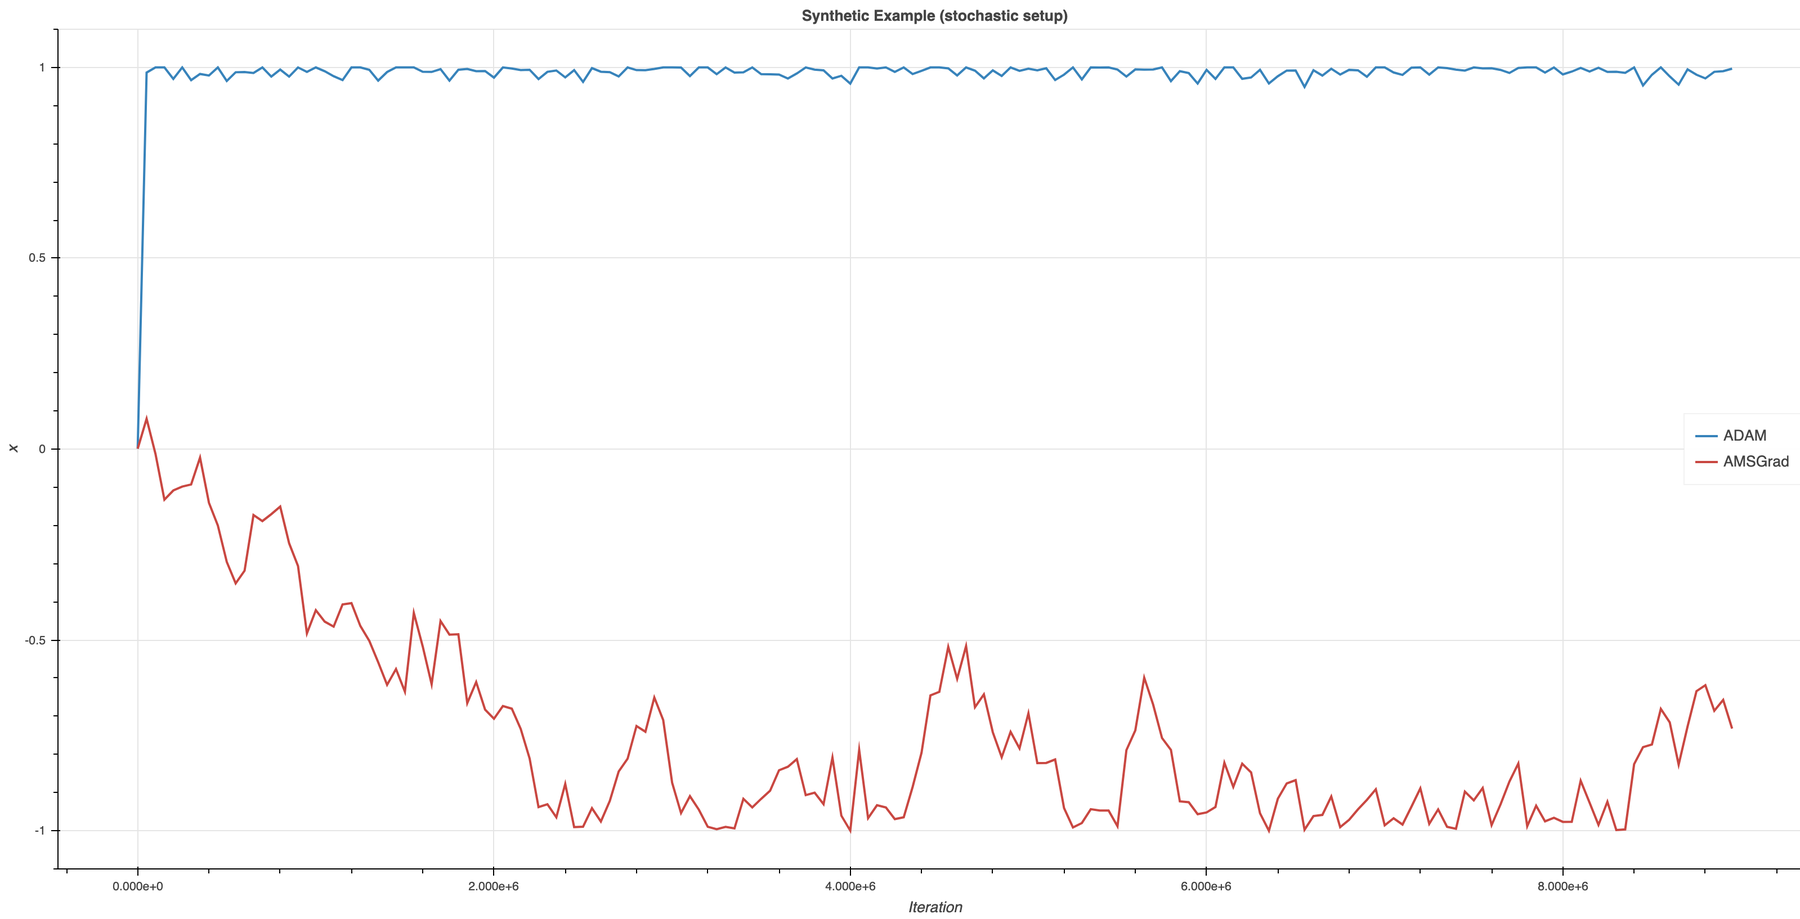
논문의 그래프, 그리고 여기에 있는 재구현과 꽤 비슷합니다. x의 최적값은 -1인데도 ADAM은 1로 잘못 수렴합니다. AMSGrad는 가장 좋은 파라미터 쪽으로 움직입니다.
그다음 네 가지 설정으로 실험했습니다.
- MNIST에 로지스틱 회귀
- “CifarNet”: 논문에 설명된 CIFAR-10용 CNN
- “SmallVgg”: CIFAR-10에 작은 VGG 계열 네트워크
- “Vgg”: CIFAR-10에 더 큰 VGG 계열 네트워크
설정마다 beta2 ∈ {0.99, 0.999}(논문에서 제안한 값), 학습률 ∈ {0.01, 0.001, 0.0001}, 편향 보정 ∈ {켬, 끔}의 조합 하나하나에 대해 학습을 5번씩 돌렸습니다. 배치 크기는 (원래 논문처럼) 128로 두었습니다. 150 에포크 동안 학습했고, 초기 학습률을 선형으로 줄여 150 에포크가 끝날 때 0이 되게 했습니다. CIFAR-10 실험에서 흔히 쓰는 좌우 뒤집기 데이터 증강도 썼습니다. 실험을 재현하는 코드는 여기에 있습니다.
먼저 “Vgg” 설정에 집중하겠습니다. 설정마다 저마다의 특이한 점이 있지만, 결과에서 끌어낼 수 있는 결론은 비슷합니다.
CIFAR-10에 Vgg
여기서 쓴 합성곱 신경망의 구조는 다음과 같습니다.
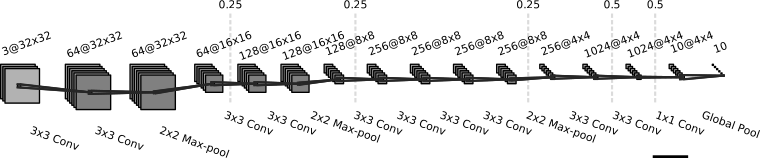
합성곱마다 뒤에 배치 정규화와 ReLU 활성화 함수가 붙습니다. 점선은 드롭아웃을 나타내며, 확률은 선 위에 적힌 값입니다. 자세한 내용은 코드를 보세요.
아래 그래프에서 ADAM의 결과는 늘 파란색, AMSGrad의 결과는 빨간색입니다. 옅은 색은 편향 보정을 끈 경우입니다. 선 하나가 학습 한 번입니다.
학습 손실
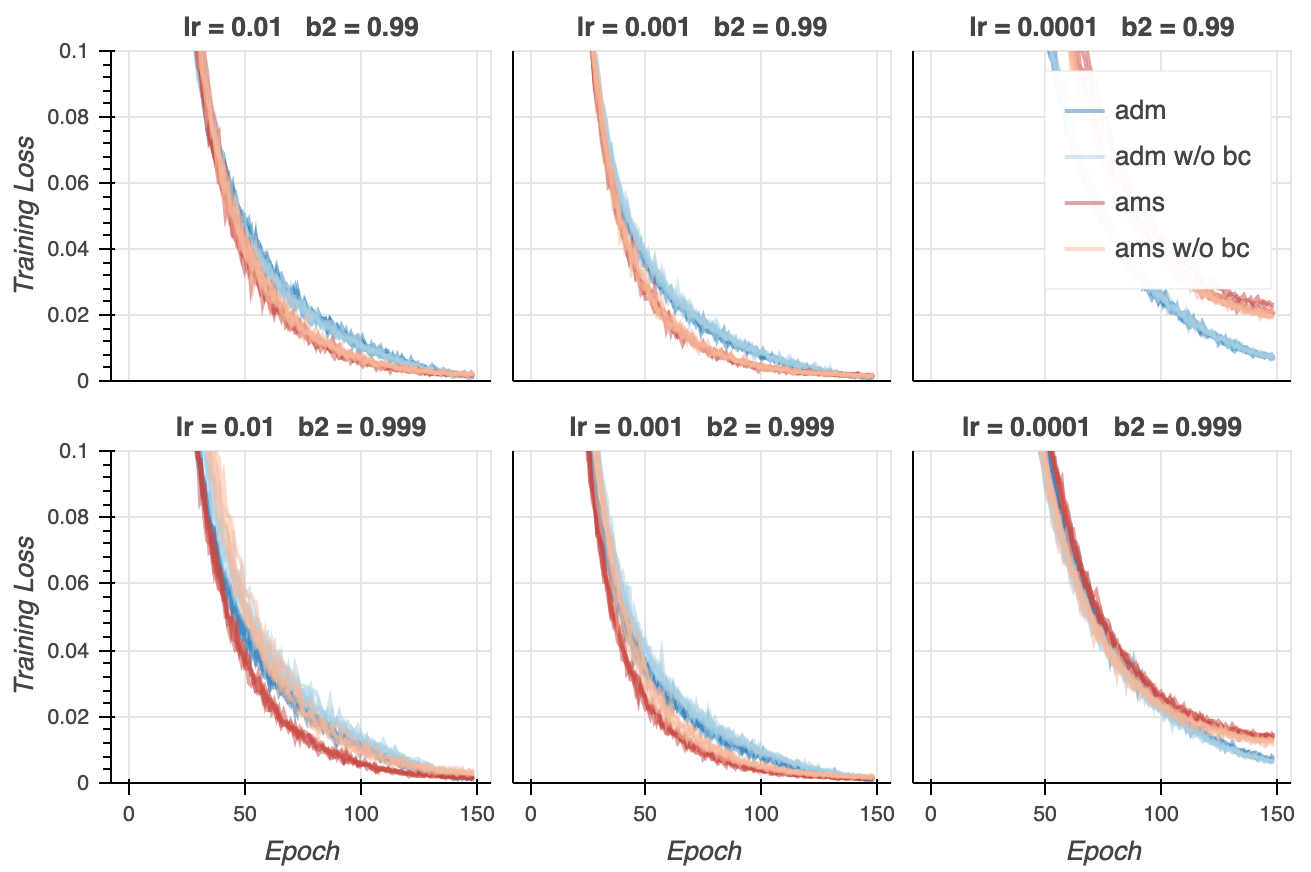
제 실험에서는 학습 손실이 0에 아주 가깝게 내려갔는데, 논문에서는 0.3이었습니다. 물론 제가 훨씬 큰 모델을 썼기 때문입니다. 또 학습률이 너무 낮지 않으면 학습 마지막 단계에서 AMSGrad가 더 빨리 수렴하는 듯하고, 대부분의 경우 편향 보정을 쓰면 수렴에 도움이 된다는 것도 보입니다. 하지만 결국 대부분의 하이퍼파라미터 설정에서(학습률이 너무 낮을 때만 빼고) 모든 변형이 비슷한 최종 손실로 수렴합니다. 확대해 보면 마지막 몇 에포크에서 ADAM이 AMSGrad를 앞지르는 경우가 많습니다. 그게 크게 중요하다는 말은 아닙니다. 어쨌든 학습 손실이니까요. 다만 이런 종류의 모델(과 학습 방식)로 얻은 결과는, 논문에 보고된 CifarNet 모델의 결과와 다릅니다. 논문에서는 AMSGrad의 학습 손실이 ADAM보다 훨씬 낮았습니다(논문의 그림 2, 왼쪽 아래 그래프를 보세요).
검증 손실
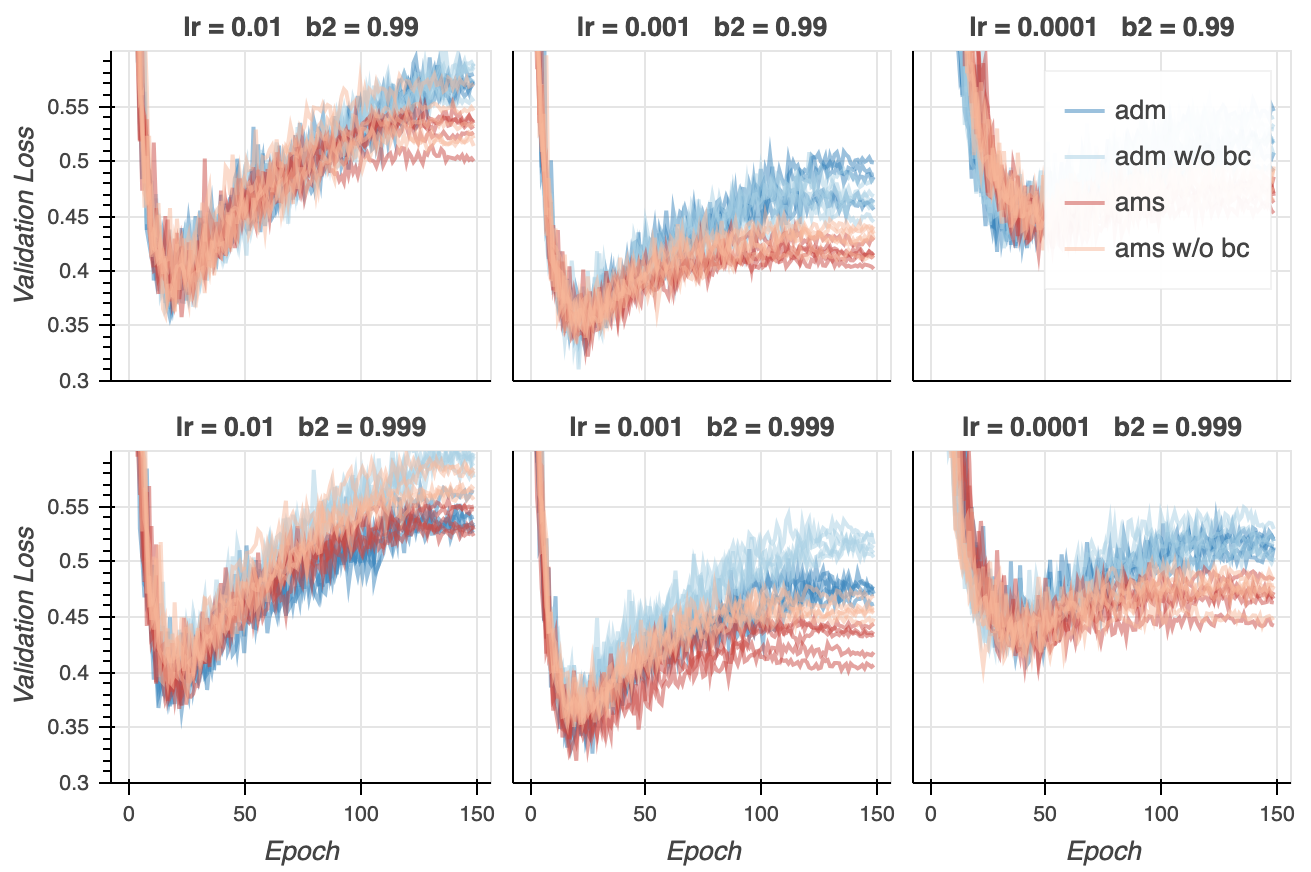
검증 손실은 다르게 움직입니다. 여기서는 특히 후반 에포크에서 AMSGrad가 꾸준히 ADAM보다 낫습니다. 두 알고리즘 모두 비슷한 최소 검증 손실에 이르지만(20에서 25 에포크쯤), 그 뒤로는 ADAM이 더 많이 과적합되는 듯합니다. 이는 적어도 교차 엔트로피 손실로 보면 AMSGrad가 더 잘 일반화한다는 뜻입니다. 이것으로 ADAM이 흔히 표준 SGD보다 일반화를 못 한다는 문제를 고칠 수 있을까요? 이 질문에 답하려면 표준 SGD로 실험을 더 해 봐야 합니다.
학습 정확도
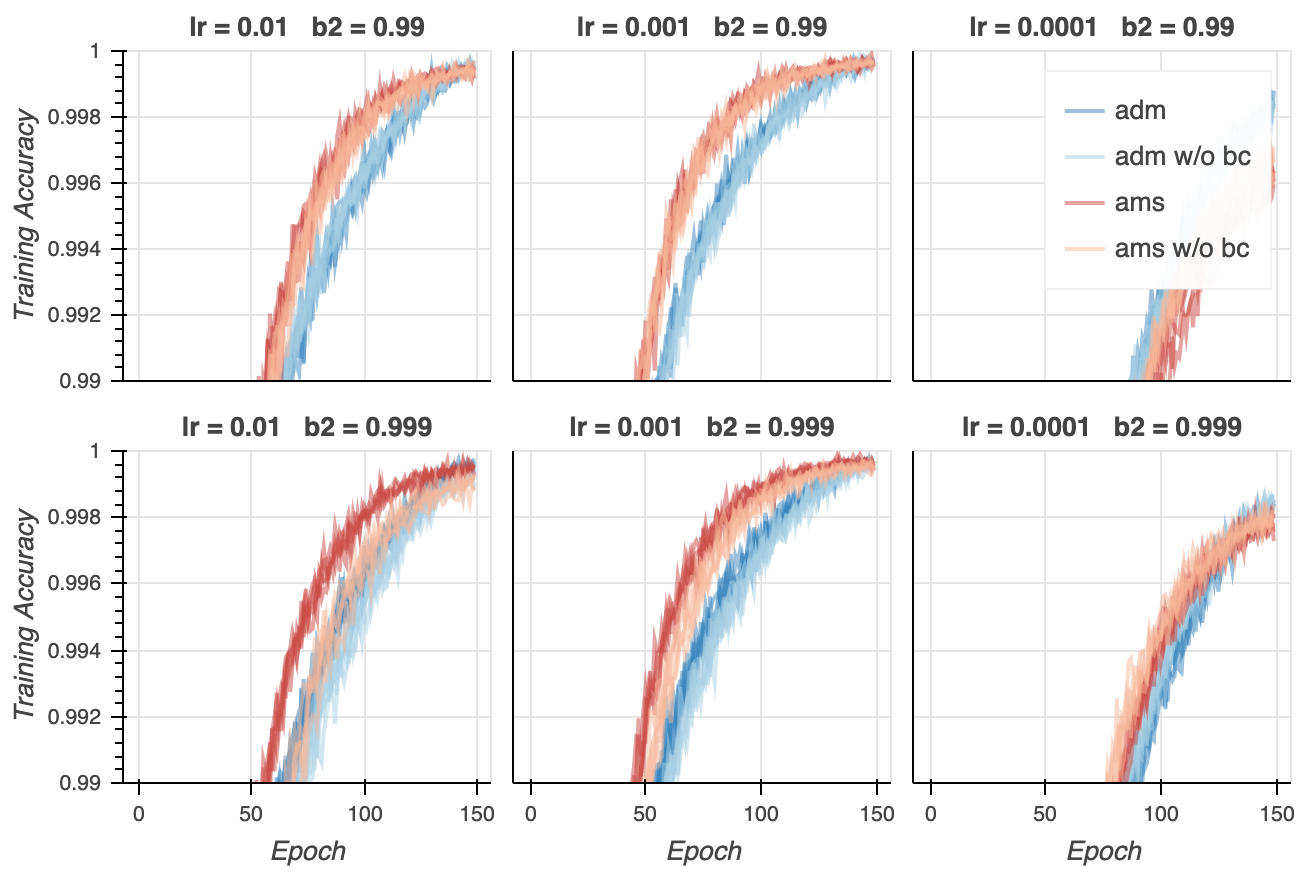
정확도를 봅시다. 분류에 관심이 있다면 정확도가 교차 엔트로피 손실보다 더 중요한 지표입니다. 결국 우리가 알고 싶은 것은 모델이 예제를 몇 개나 맞게 분류하느냐니까요. 먼저 학습 정확도를 봅시다. CIFAR-10에서는 강력한 모델 대부분이 제대로 학습하면 100%에 가까운 정확도에 이릅니다(사실 레이블을 무작위로 바꿔도 100% 정확도에 이를 수 있습니다).
보다시피 학습 정확도는 학습 손실과 아주 비슷하게 움직입니다. AMSGrad가 ADAM보다 빨리 수렴하지만, 결국 둘 다 비슷한 결과에 이릅니다. 하이퍼파라미터가 크게 어긋나지만 않으면(다시 말하지만 학습률이 너무 낮으면 안 됩니다), 어떤 알고리즘을 쓰든 거의 100% 정확도에 이를 수 있습니다.
드디어 가장 흥미로운 부분, 검증 정확도입니다.
검증 정확도
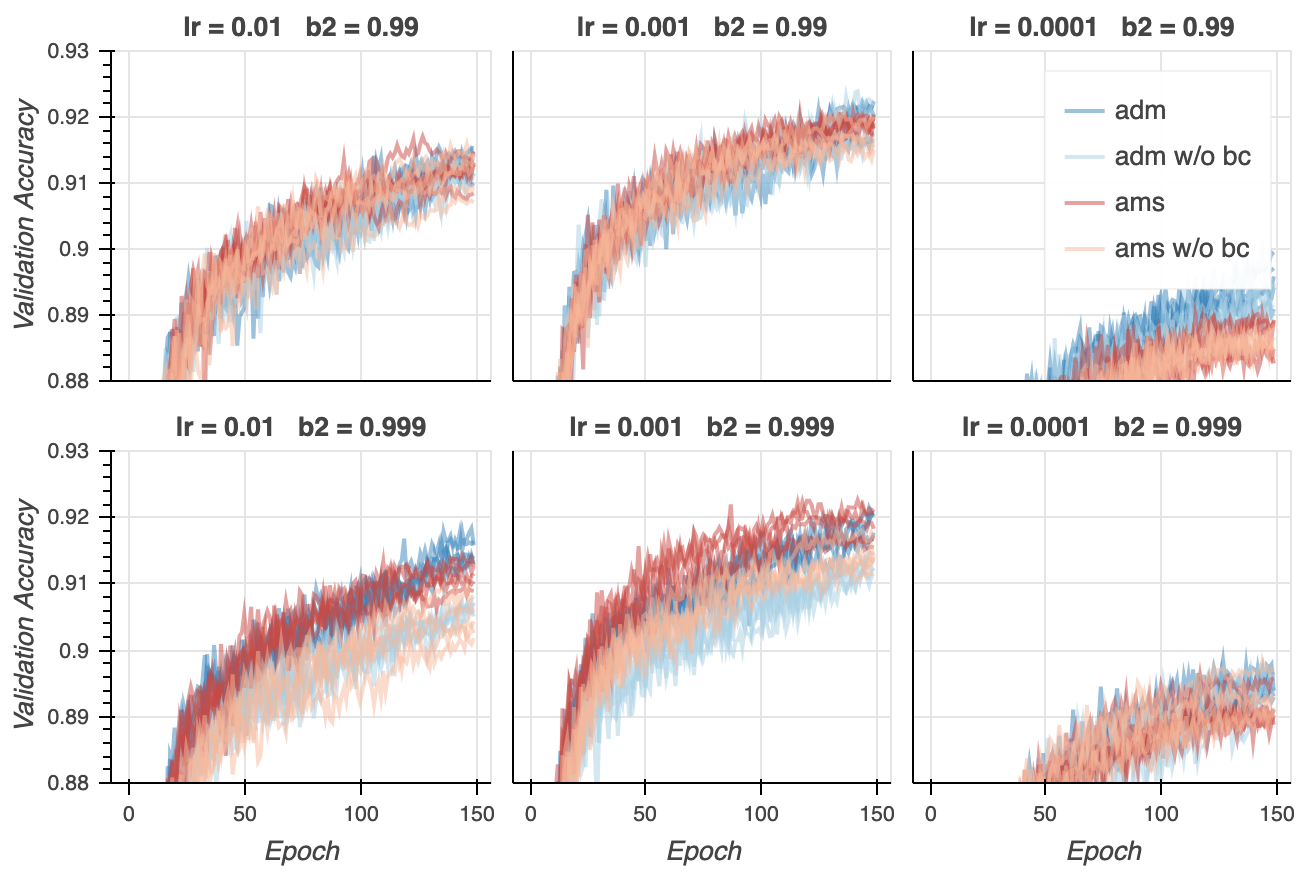
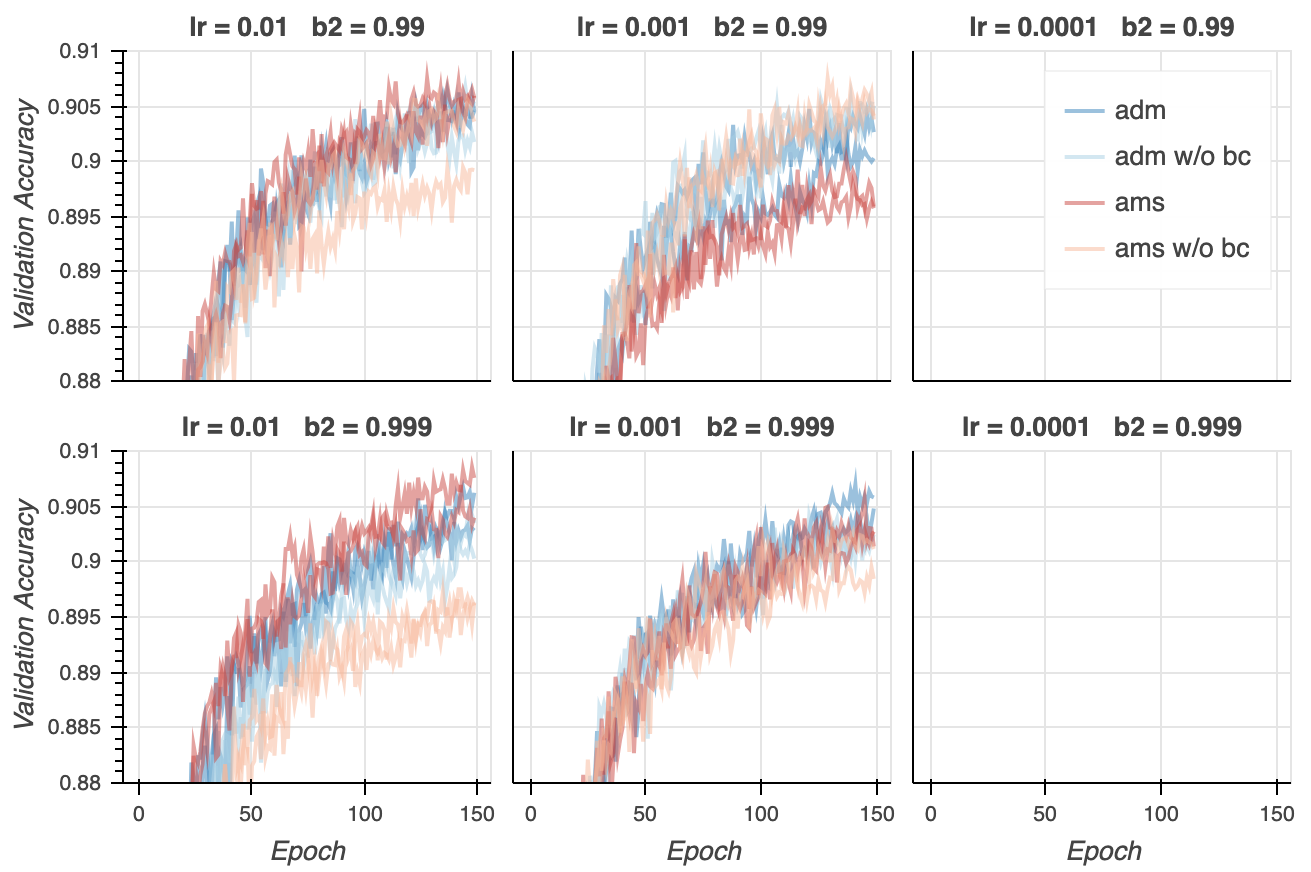
그런데 여기서 실망이 찾아옵니다. AMSGrad가 모든 하이퍼파라미터 설정에서 더 낮은 검증 손실을 냈지만, 검증 정확도에서는 결과가 꽤 애매합니다. 어떤 설정에서는 ADAM이 더 낫고(lr = 0.01, b2=0.999), 다른 설정에서는 AMSGrad가 더 낫습니다(lr=0.001, b2=0.999). 모든 설정을 통틀어 가장 좋은 결과는 lr=0.001, b2=0.99인 ADAM이 냈지만, 의미 있는 차이라고는 생각하지 않습니다. 하이퍼파라미터만 알맞게 정하면 두 알고리즘이 똑같이 잘 작동하는 것으로 보입니다.
논의
논문은 ADAM의 수렴 증명에 있는 결정적인 결함을 짚었고, 증명이 성립하도록 고친 알고리즘인 AMSGrad를 보여 주었습니다. 하지만 실제로 어떤 영향이 있는지에 대한 실험 평가는 좀 부족하다고 느꼈습니다. 논문에서 저자들은 이렇게 주장합니다(강조는 제가 했습니다). “AMSGrad는 학습 손실과 정확도에서 ADAM보다 상당히 더 좋은 성능을 낸다. 나아가 이 성능 향상은 테스트 손실에서도 좋은 성능으로 이어진다.” 아쉽게도 제가 쓴 모델과 학습 방식에서는 제 실험이 이 주장을 뒷받침하지 않습니다.
- 학습 세트에서의 성능은 손실로 보든 정확도로 보든 둘이 비슷합니다.
- 테스트(여기서는 검증) 손실은 실제로 AMSGrad가 더 낮습니다. 하지만
- 테스트 손실이 나아졌다고 해서 테스트 정확도가 좋아지지는 않습니다. (공정하게 말하면, 저자들이 그렇게 주장한 적은 없습니다.)
- 테스트 손실과 테스트 정확도가 다르게 움직인다는 사실은 중요한 질문을 던집니다. 범주형 교차 엔트로피는 분류용 네트워크를 학습하는 데 얼마나 알맞을까요? 더 잘할 수는 없을까요?
분명히 해 두자면, ADAM의 약점을 짚어 낸 저자들의 작업은 높이 평가합니다. 증명을 아직 확인해 보지는 않았지만(듣자 하니 지금까지 ADAM의 증명도 아무도 확인하지 않았던 모양입니다), 저자들의 결론을 믿는 쪽으로 기웁니다. 또 인위적인 예제들은 ADAM이 특정 조건에서 작동하지 않는다는 것을 실제로 보여 줍니다. 좋은 논문이라고 생각합니다.
하지만 실제로 어떤 영향이 있는지는 실험으로 더 살펴봐야 합니다. 이 글에서 설명한 실험들은 실제로 ADAM과 AMSGrad 사이에 큰 차이가 있다고 보여 주지 않습니다.
부록
여기서는 다른 설정들의 결과를 보여 드립니다.
MNIST에 로지스틱 회귀
이 설정은 논문의 실험 하나를 그대로 반영해서 흥미롭습니다. 유일한 차이는 학습률 일정입니다. 논문은 t를 반복 횟수라 할 때 α/√t를 쓰고, 저는 앞에서 설명한 대로 에포크마다 선형으로 줄입니다. 결과를 봅시다.
학습 손실
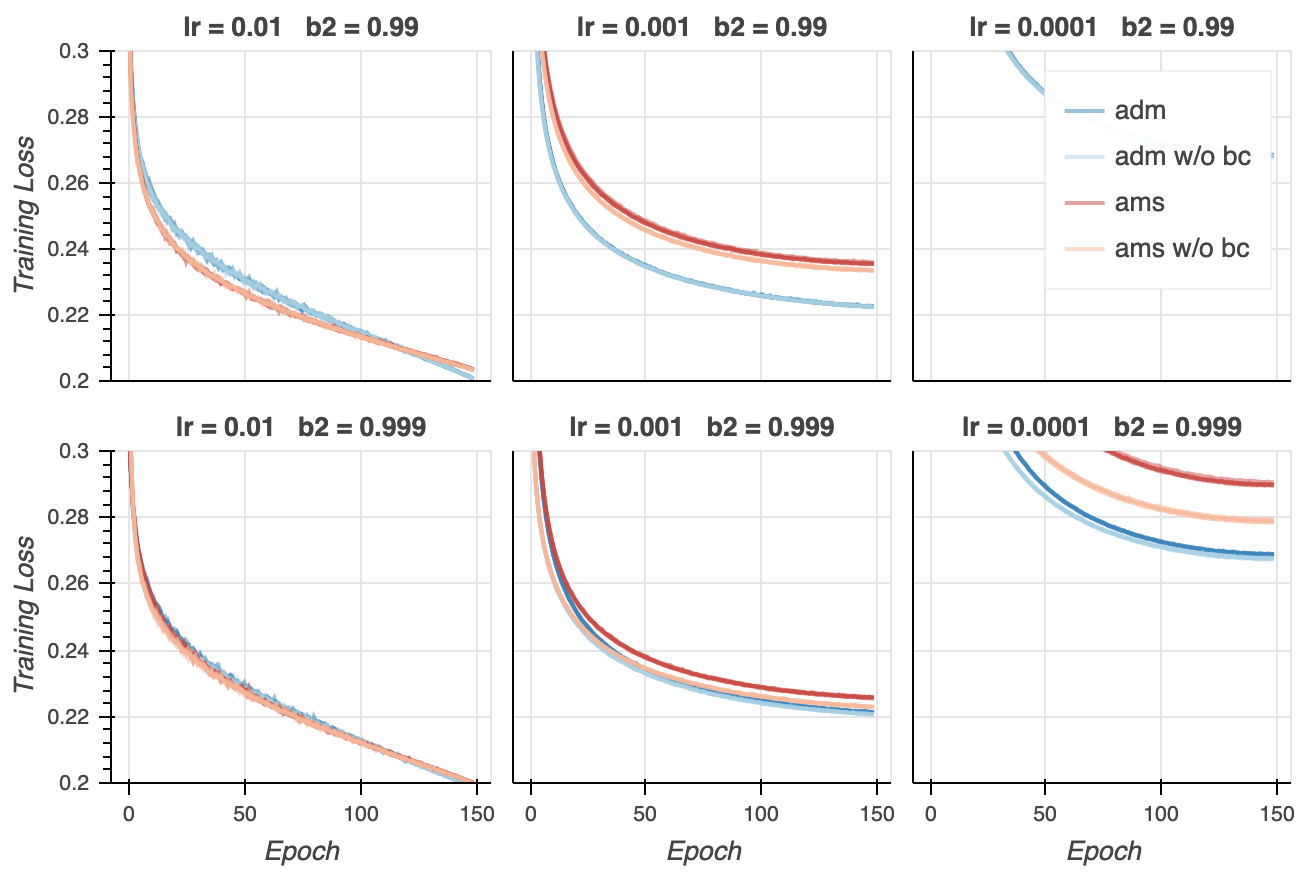
먼저 보이는 것은 학습률을 선형으로 줄이면 학습 손실을 훨씬 낮출 수 있다는 점입니다. 논문에서는 학습 손실 곡선이 5,000번 반복(배치 크기 128에서 약 13 에포크) 뒤에 약 0.25에서 평평해지는 듯한데, 제 실험에서는 하이퍼파라미터에 따라 0.2까지 내려갑니다. 또 하나 흥미로운 점은 모든 설정에서 ADAM이 가장 낮은 최종 학습 손실을 낸다는 것입니다. 이는 논문의 결과, 특히 AMSGrad가 ADAM보다 파라미터 변화에 더 강건하다는 주장과 어긋납니다.
검증 손실
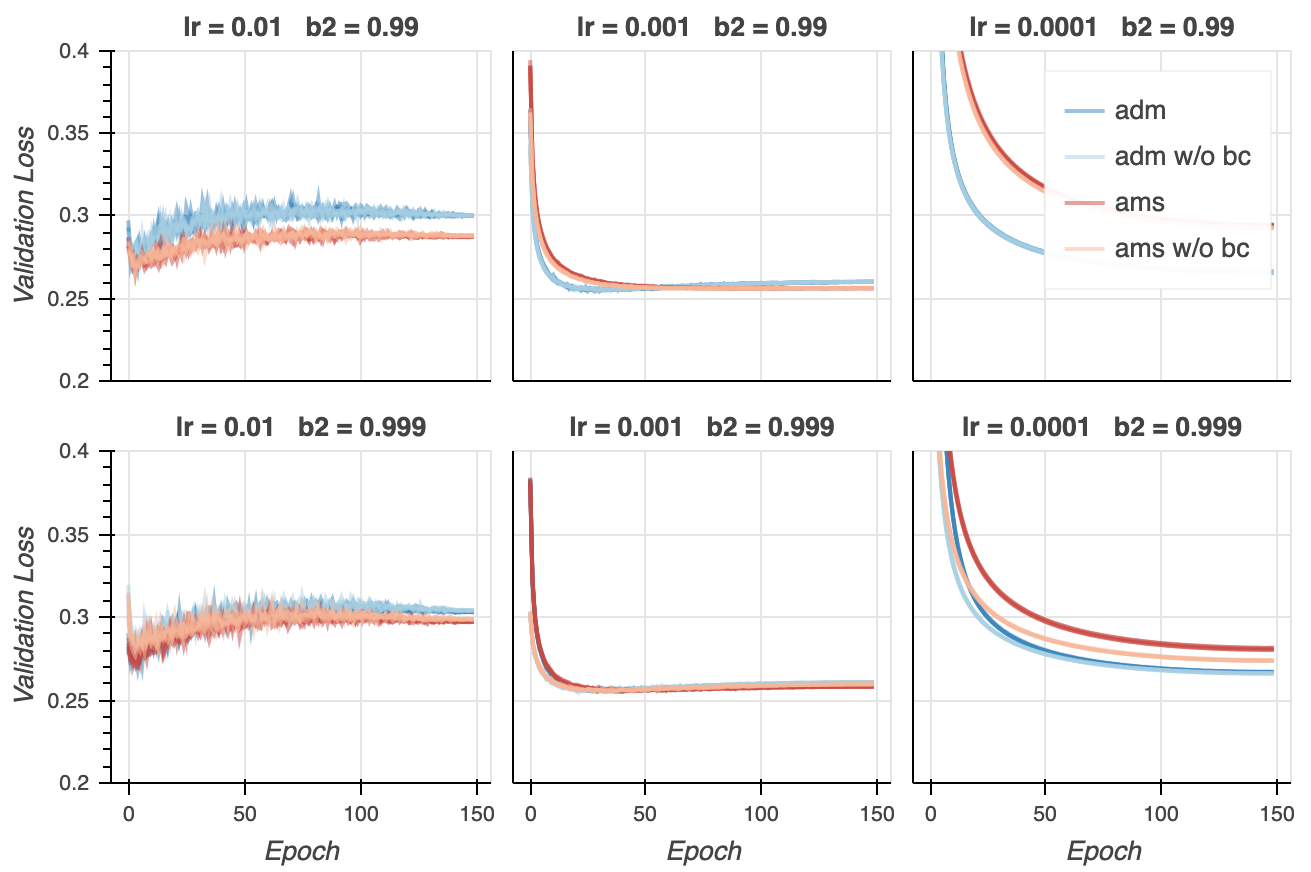
여기서는 양상이 다릅니다. (학습률을 너무 낮게 쓰지 않는 한) 대개 AMSGrad가 가장 낮은 검증 손실을 냅니다. 하지만 lr=0.002, b2=0.99에서는 ADAM이 (아주 근소한 차이로) 가장 낮은 검증 손실을 내고, 그 뒤로는 발산합니다.
학습 정확도
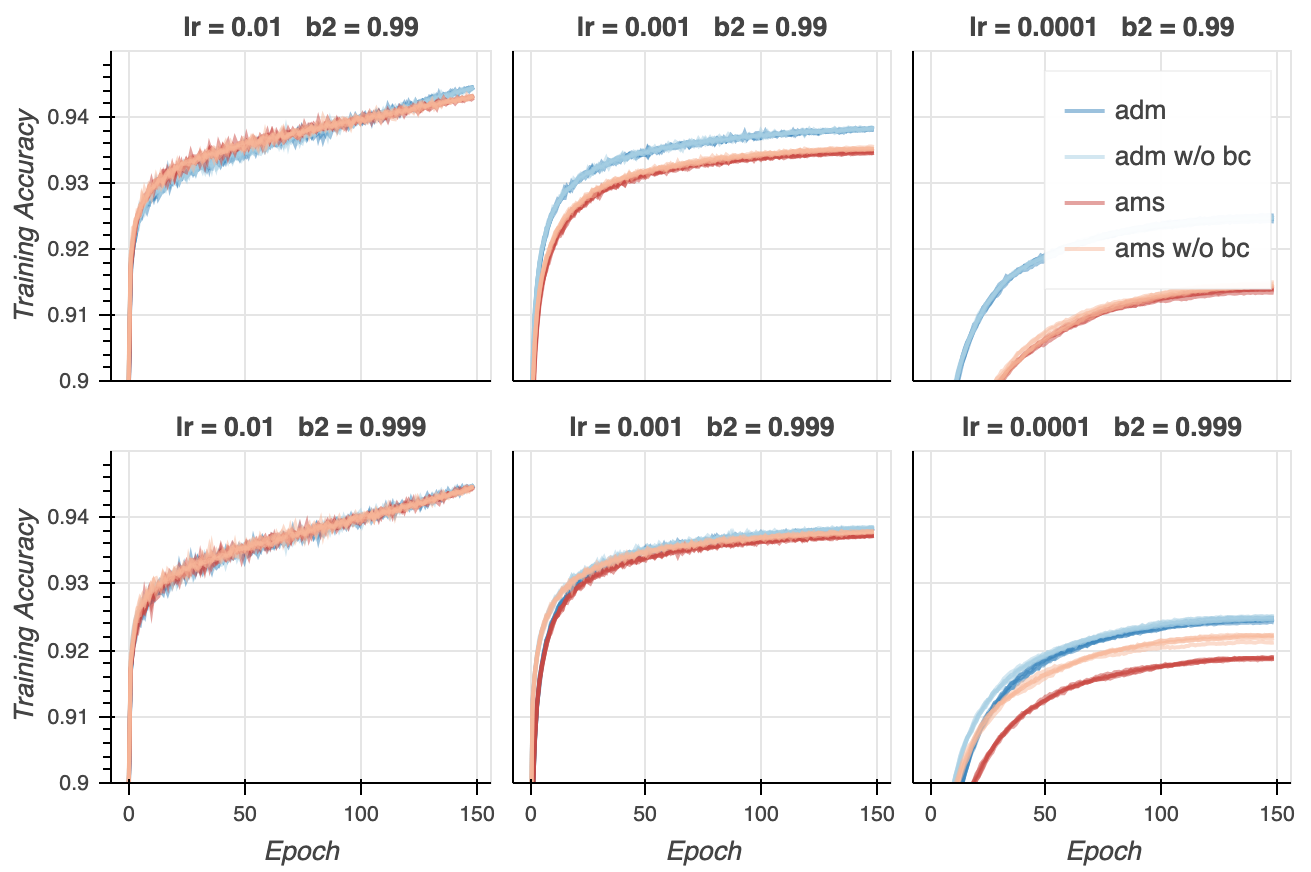
학습 정확도는 학습 손실과 아주 비슷하게 움직이고, 검증 정확도도 마찬가지입니다.
검증 정확도
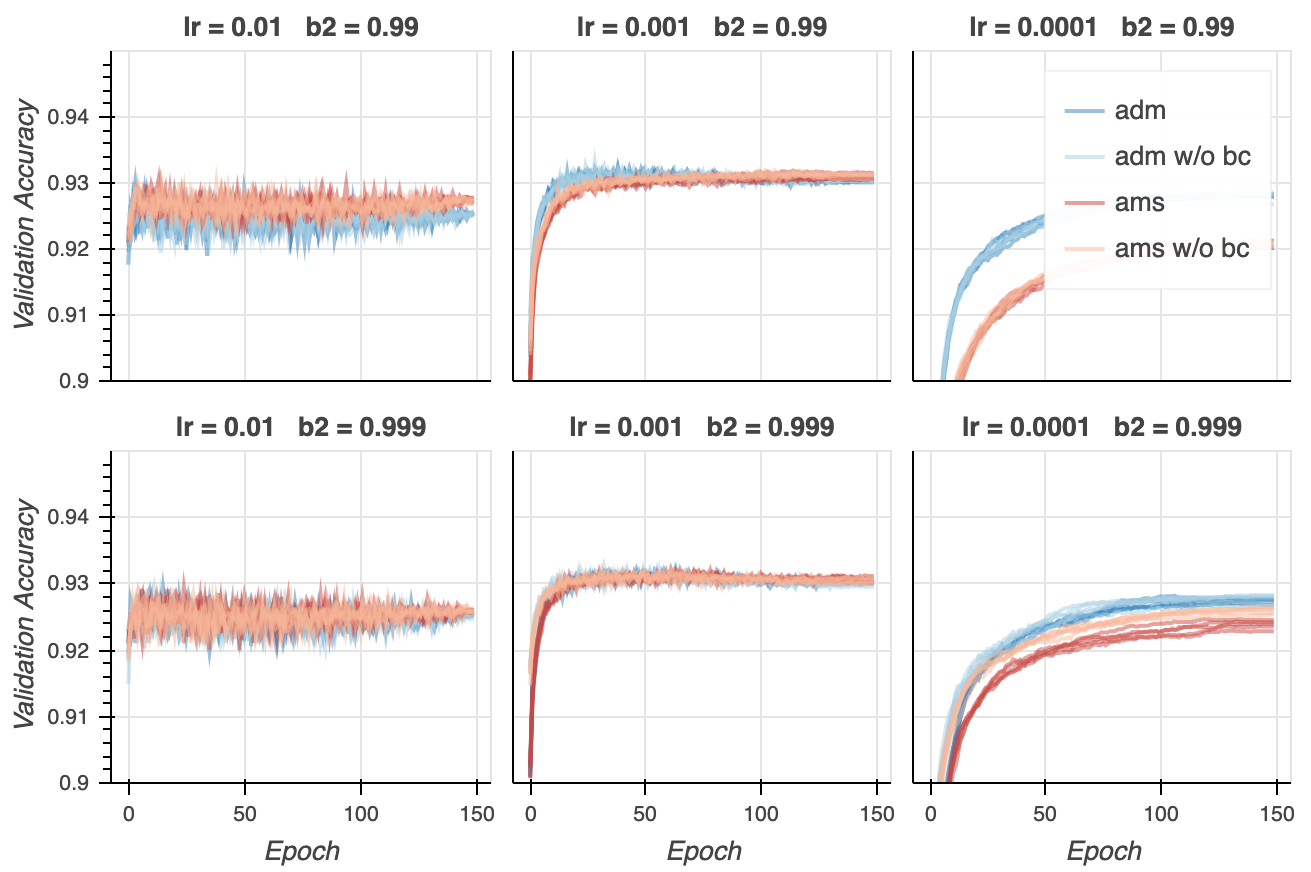
이 결과로 보면 실제로 AMSGrad가 ADAM보다 뚜렷이 유리하지는 않은 듯합니다. 결과는 학습률과 beta2를 어떻게 고르느냐에 달려 있습니다. 또 AMSGrad가 하이퍼파라미터 변화에 더 강건하다는 주장도 이 결과로는 확인되지 않습니다.
CIFAR-10에 CifarNet
여기서는 논문에 설명된 합성곱 신경망을 다시 구현해 보려 했습니다. 하지만 학습 곡선을 재현할 수 없었습니다. 학습률과 beta2에 따라 학습 손실은 더 좋아지되 검증 손실은 더 나빠지거나, 둘 다 논문에 나온 것보다 나빴습니다. 논문이 모델의 세부 사항을 다 밝히지 않아서(예를 들어 초기화 방식이나 L2 정규화를 썼는지 알 수 없습니다) 이런 일의 원인을 찾기는 어렵습니다. 어쨌든 결과는 다음과 같습니다.
학습 손실
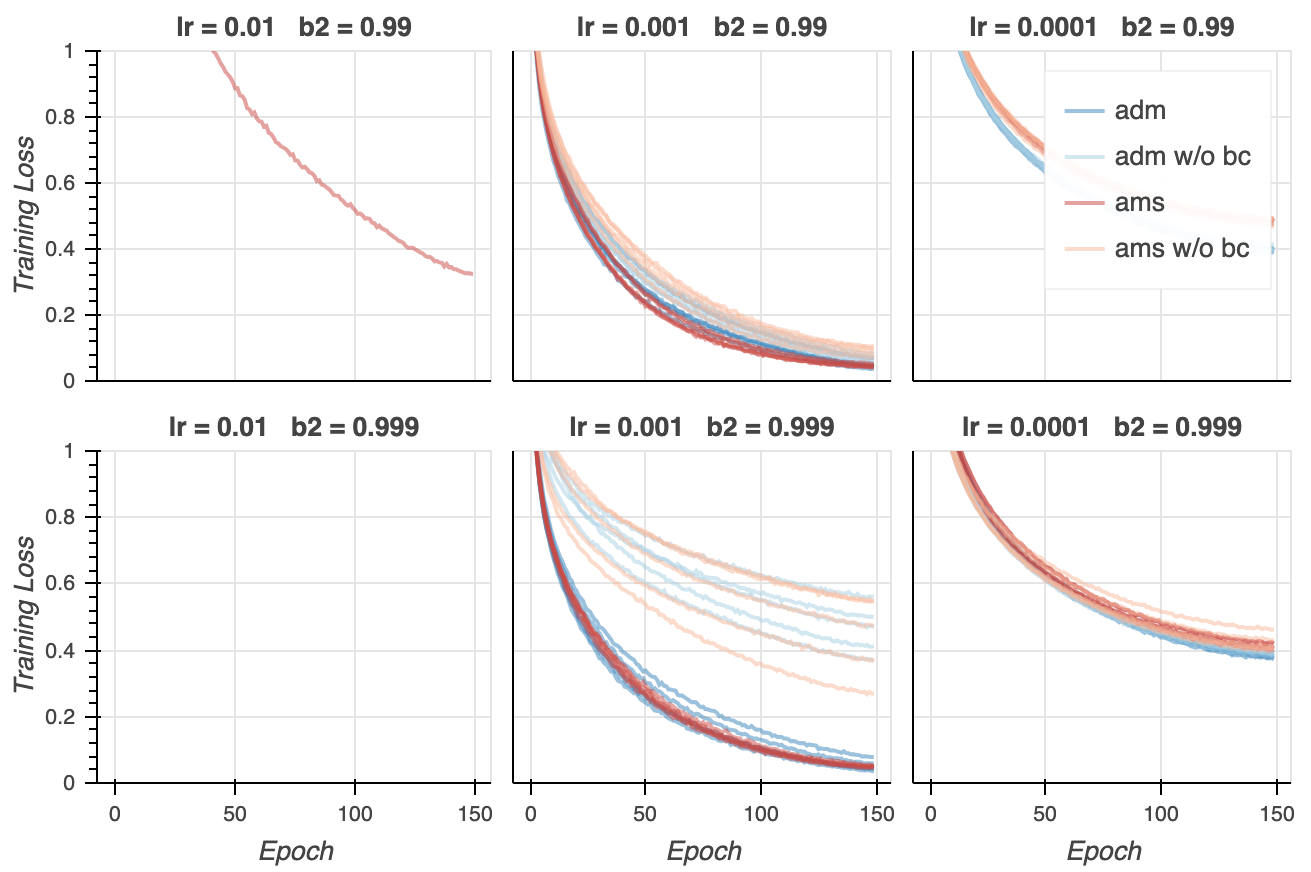
학습률이 높으면 두 알고리즘 모두 수렴하지 못합니다. 학습 손실로 보면 표준 학습률인 0.001이 가장 잘 작동하는 듯합니다. 가장 낮은 학습 손실은 ADAM이 냈지만, AMSGrad를 쓴 실행들이 편차가 더 작은 듯합니다. 다만 이를 확인하려면 실험이 더 필요하다고 생각합니다.
검증 손실
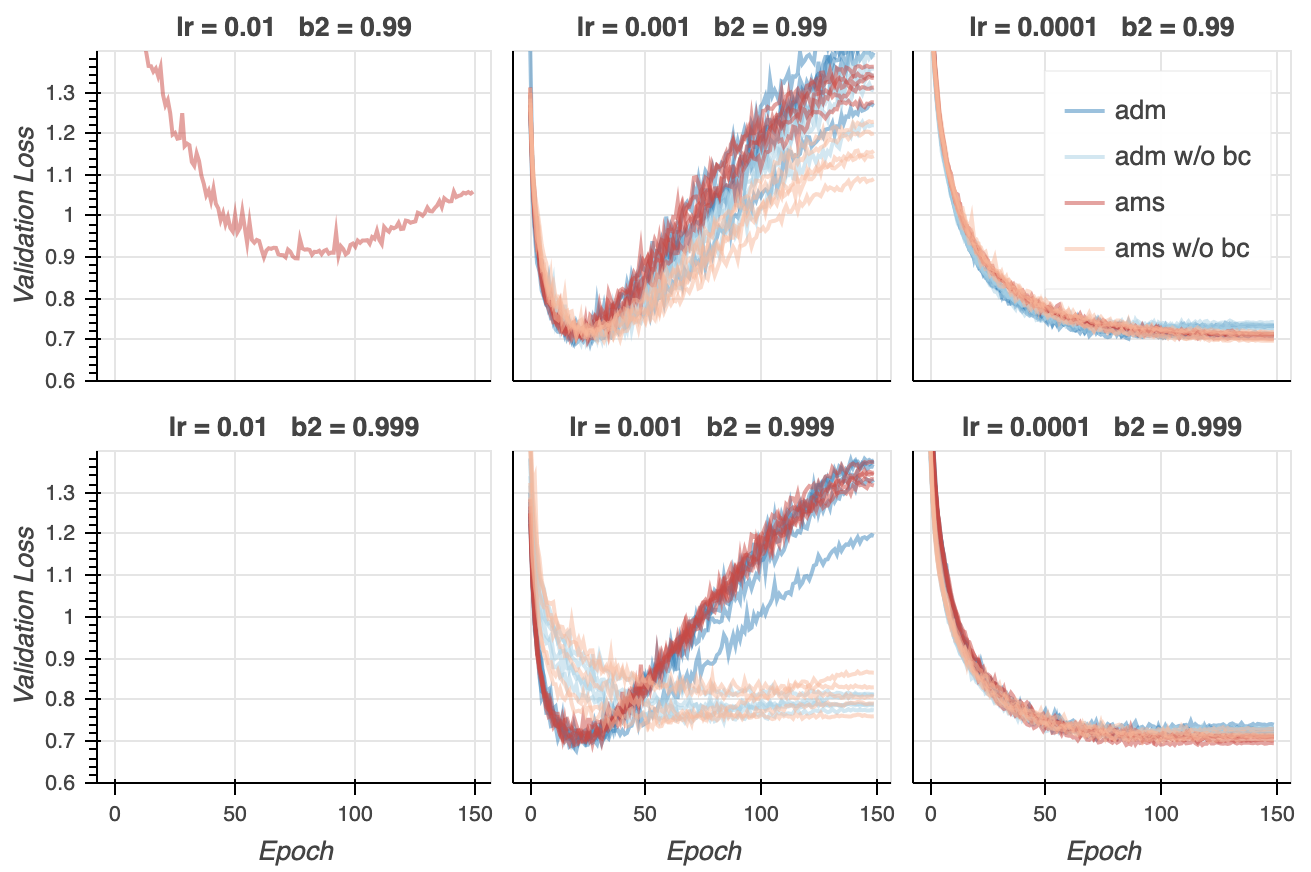
학습 손실이 가장 좋았던 설정들에서 검증 손실이 심하게 발산합니다. 두 알고리즘이 비슷하게 영향을 받습니다. 학습률을 낮춰 학습한 모델들이 훨씬 잘 일반화하는 듯합니다. 미리 밝혀 두자면, 정확도로 보면 양상이 아주 달라집니다.
학습 정확도
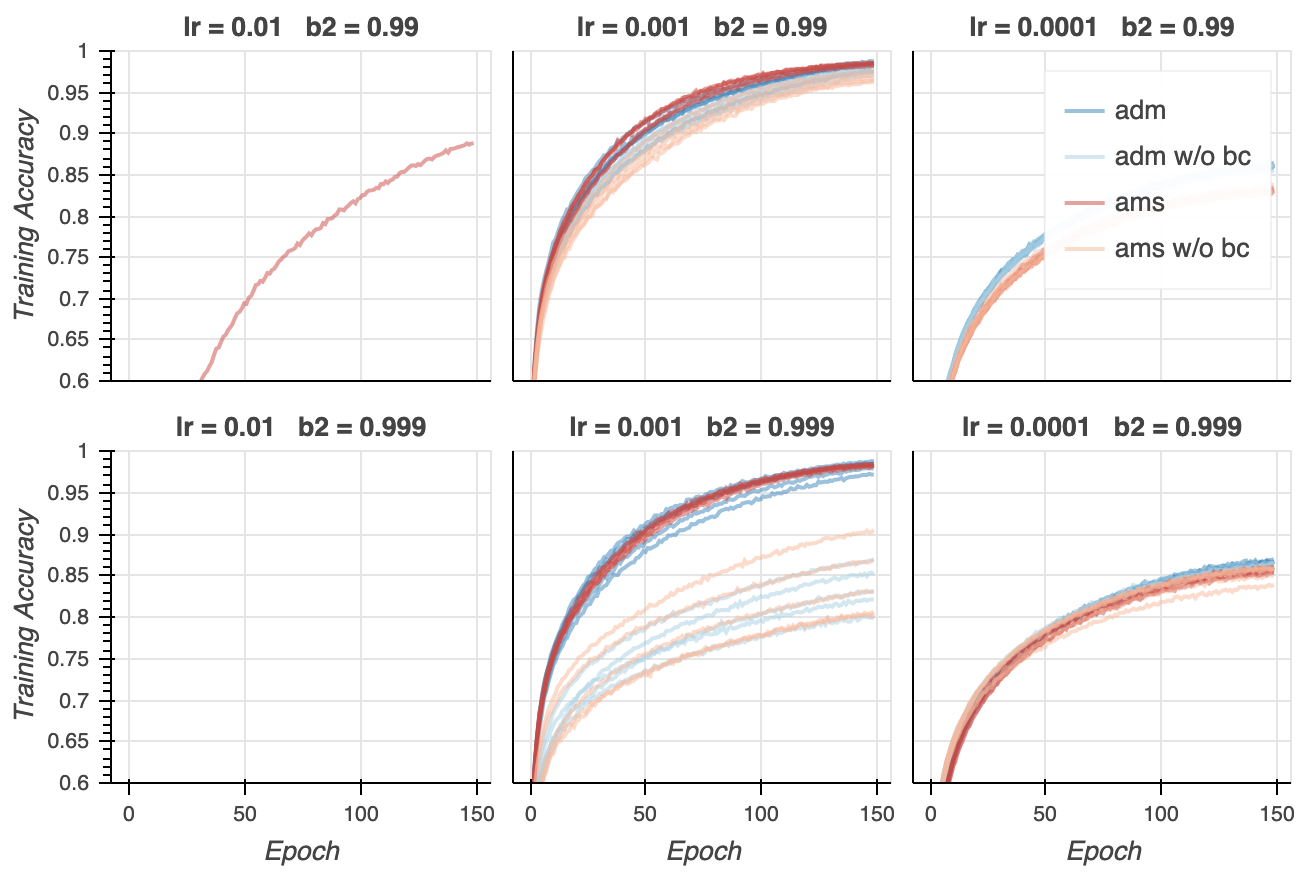
학습 정확도는 학습 손실과 비슷하게 움직입니다.
검증 정확도
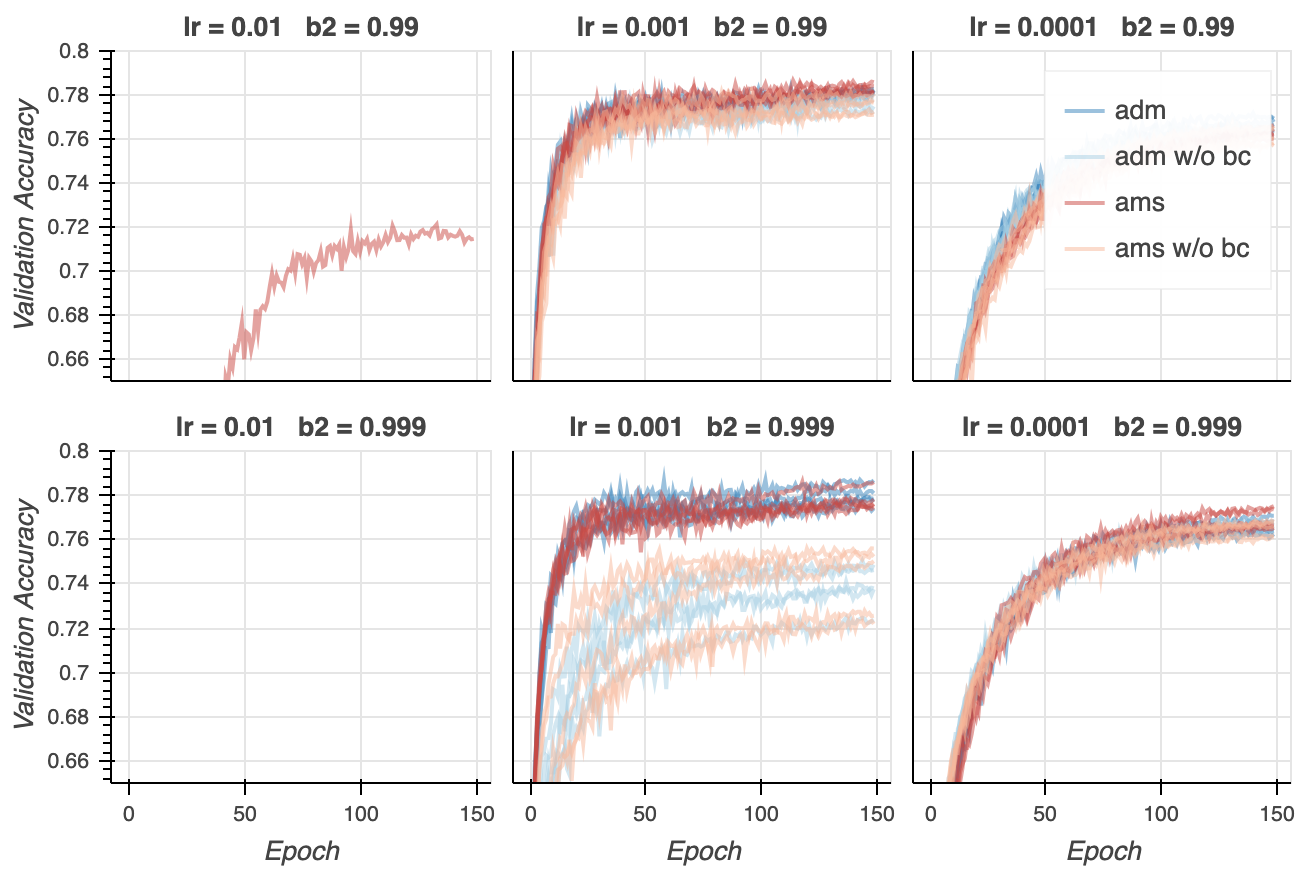
이제 더 흥미로운 부분입니다. 검증 손실이 심하게 발산하는 것을 보았는데도, 검증 정확도는 실제로 바로 그 모델들이 가장 좋습니다. 검증 손실로는 더 잘 일반화하는 듯 보였던 모델들이, 검증 정확도로는 더 잘 일반화하지 않습니다. 이 점을 꼭 기억해 둘 필요가 있습니다.
설정에 따라 ADAM과 AMSGrad가 아주 근소한 차이로 서로를 앞섭니다. 더 중요한 것은, 어떤 최적화 알고리즘을 쓰든 이 모델은 최신 모델들에 비해 훨씬 못하다는 점입니다(검증 정확도 78%에 그칩니다).
CIFAR-10에 SmallVgg
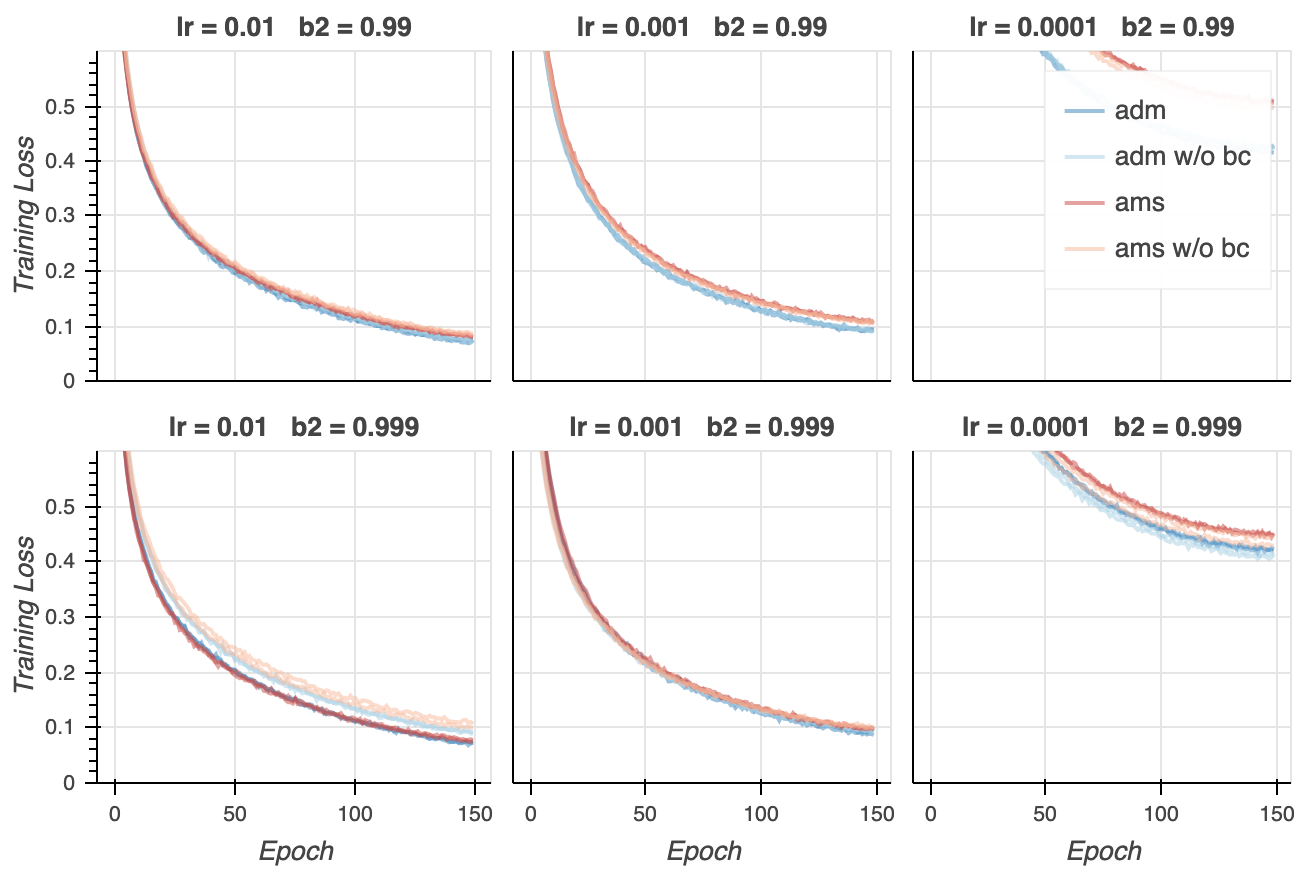
주요 실험에 쓴 모델을 작게 줄인 버전입니다. 층마다 필터를 절반만 쓰고, 블록마다 합성곱 층을 두 개만 씁니다. 이 실험들의 결과는 새로운 것을 더해 주지 않으므로 따로 해석하지 않겠습니다.
학습 손실
검증 손실
학습 정확도
검증 정확도