안드레이 카파시: CS231n 신경망 3부: 학습과 평가Andrej Karpathy: CS231n: Neural Networks Part 3: Learning and Evaluation
그래디언트 검사 요령, 학습 전 점검, 손실과 정확도와 업데이트 비율로 학습 과정 지켜보기, 모멘텀과 네스테로프부터 Adagrad, RMSprop, Adam까지 파라미터 업데이트, 하이퍼파라미터 탐색, 모델 앙상블을 한 번에 정리한 스탠퍼드 CS231n 강의 노트
Contents목차
번역문 · 원저자: Andrej Karpathy (Stanford CS231n) · 원문: CS231n: Neural Networks Part 3: Learning and Evaluation · 원문 라이선스: MIT (Copyright (c) 2015 Andrej Karpathy). 원문의 저작권 표시와 MIT 허가 문구는 글 끝 「라이선스 고지」에 그대로 옮겼습니다. 원문 그림 9개 중 6개는 글과 같은 MIT 허가를 따르는 원문 글쓴이의 그림이라 그대로 실었습니다. 나머지 3개는 다른 사람이 만든 그림이라 이 글에서 쓸 수 있는지 확인하지 못해 싣지 않았고, 그 자리에는 설명만 남겼습니다. 이 3개는 원문에서 볼 수 있습니다.
원문: 「Neural Networks Part 3: Learning and Evaluation」, 스탠퍼드 CS231n(Deep Learning for Computer Vision) 강의 노트, https://cs231n.github.io/neural-networks-3/. 원본 소스는 GitHub의
neural-networks-3.md이며, 2015년 1월 30일에 처음 올라왔습니다. 이 글은 원문을 한국어로 옮긴 번역문입니다.라이선스: 강의 노트 저장소 cs231n/cs231n.github.io는 MIT 라이선스(Copyright (c) 2015 Andrej Karpathy)를 따릅니다. 코드와 코드 안 주석은 원문 그대로 두었습니다. 원문 목차의 각 항목은 본문 절로 이어지는 링크인데, 여기서는 목록만 옮겼습니다.
목차:
- 그래디언트 검사
- 학습 전 점검
- 학습 과정 지켜보기
- 손실 함수
- 학습/검증 정확도
- 가중치 대 업데이트 비율
- 층별 활성값/그래디언트 분포
- 시각화
- 파라미터 업데이트
- 1차 방법(SGD), 모멘텀, 네스테로프 모멘텀
- 학습률 줄이기
- 2차 방법
- 파라미터별 적응형 학습률(Adagrad, RMSProp)
- 하이퍼파라미터 최적화
- 평가
- 모델 앙상블
- 요약
- 더 읽을거리
학습
앞 절들에서는 신경망의 정적인 부분을 다뤘습니다. 네트워크 연결 구조, 데이터, 손실 함수를 어떻게 구성하는지였습니다. 이 절은 동적인 부분, 곧 파라미터를 학습하고 좋은 하이퍼파라미터를 찾는 과정을 다룹니다.
그래디언트 검사
이론상 그래디언트 검사는 해석적 그래디언트와 수치 그래디언트를 비교하는 것만큼 간단합니다. 실제로는 훨씬 손이 많이 가고 실수하기 쉬운 과정입니다. 아래는 알아 두면 좋은 요령과 주의할 점입니다.
중심 차분 공식을 쓰세요. 수치 그래디언트를 구할 때 쓰는 유한 차분 근사로 흔히 보았을 공식은 다음과 같습니다.
(수식 안의 “bad, do not use”는 “나쁨, 쓰지 말 것”이라는 뜻입니다.) 여기서 는 아주 작은 수로, 실제로는 1e-5 정도입니다. 실제로는 다음과 같은 중심 차분 공식을 쓰는 편이 훨씬 낫습니다.
(“use instead”는 “대신 이것을 쓸 것”이라는 뜻입니다.) 이렇게 하면 그래디언트의 차원 하나하나를 검사할 때마다 손실 함수를 두 번 계산해야 하지만(그래서 비용이 두 배쯤 듭니다), 그래디언트 근사는 훨씬 정밀해집니다. 이를 확인하려면 와 를 테일러 전개해 보면 됩니다. 첫 번째 공식은 오차가 차수이지만, 두 번째 공식은 오차 항이 차수뿐입니다(곧 2차 근사입니다).
비교할 때는 상대 오차를 쓰세요. 수치 그래디언트 과 해석적 그래디언트 를 비교하는 세부 사항은 어떨까요? 둘이 맞지 않는다는 것을 어떻게 알 수 있을까요? 차이 이나 그 제곱을 지켜보다가, 그 차이가 어떤 문턱값을 넘으면 그래디언트 검사가 실패했다고 정하고 싶을 수 있습니다. 하지만 이 방식에는 문제가 있습니다. 예를 들어 두 값의 차이가 1e-4라고 해 봅시다. 두 그래디언트가 1.0 정도라면 아주 적당한 차이로 보이므로, 두 그래디언트가 일치한다고 여길 것입니다. 그런데 두 그래디언트가 모두 1e-5 차수이거나 그보다 작다면, 1e-4는 엄청나게 큰 차이이고 실패일 가능성이 높습니다. 그래서 언제나 상대 오차를 보는 편이 더 적절합니다.
이 식은 차이를 두 그래디언트 절댓값과 견주어 비율로 봅니다. 보통 상대 오차 공식에는 두 항 가운데 하나(어느 쪽이든)만 들어간다는 점에 유의하세요. 저는 둘 중 큰 값을 쓰는(또는 둘을 더하는) 쪽을 좋아합니다. 그래야 식이 대칭이 되고, 둘 중 하나가 0일 때(특히 ReLU를 쓰면 자주 생깁니다) 0으로 나누는 일을 막을 수 있기 때문입니다. 다만 둘 다 0인 경우는 따로 챙겨서, 그 경계 사례에서는 그래디언트 검사를 통과한 것으로 처리해야 합니다. 실제로는 이렇습니다.
- 상대 오차 > 1e-2이면 대개 그래디언트가 틀렸을 가능성이 큽니다.
- 1e-2 > 상대 오차 > 1e-4이면 마음이 놓이지 않아야 합니다.
- 1e-4 > 상대 오차이면 꺾이는 점이 있는 목적 함수에서는 대개 괜찮습니다. 하지만 꺾이는 점이 없다면(예를 들어 tanh 비선형 함수와 소프트맥스를 쓸 때), 1e-4는 너무 높습니다.
- 1e-7 이하이면 기뻐하셔도 됩니다.
또 네트워크가 깊을수록 상대 오차가 커진다는 점도 기억하세요. 그래서 10층 네트워크에서 입력 데이터에 대해 그래디언트 검사를 한다면, 오차가 층을 지나며 쌓이므로 상대 오차 1e-2도 괜찮을 수 있습니다. 거꾸로 미분 가능한 함수 하나에서 오차가 1e-2라면, 그래디언트가 틀렸을 가능성이 큽니다.
배정밀도를 쓰세요. 흔한 함정 하나는 단정밀도 부동소수점으로 그래디언트 검사를 계산하는 것입니다. 그러면 그래디언트를 올바르게 구현했는데도 상대 오차가 높게(1e-2까지) 나오는 일이 잦습니다. 제 경험으로는 배정밀도로 바꾸기만 했는데 상대 오차가 1e-2에서 1e-8로 뚝 떨어지는 것을 본 적도 있습니다.
부동소수점이 잘 작동하는 범위 안에 머무세요. 「What Every Computer Scientist Should Know About Floating-Point Arithmetic」(모든 컴퓨터 과학자가 알아야 할 부동소수점 연산)을 끝까지 읽어 보면 좋습니다. 오차가 왜 생기는지 알게 되고, 더 꼼꼼한 코드를 쓸 수 있게 됩니다. 예를 들어 신경망에서는 손실 함수를 배치 크기로 정규화하는 일이 흔합니다. 그런데 데이터 포인트 하나당 그래디언트가 아주 작다면, 거기에 데이터 포인트 수로 한 번 더 나누면 아주 작은 수가 나오기 시작하고, 그러면 수치 문제가 더 많이 생깁니다. 그래서 저는 언제나 수치 그래디언트와 해석적 그래디언트의 원래 값을 출력해 보고, 비교하는 수가 지나치게 작지 않은지 확인하는 편입니다(예를 들어 절댓값이 대략 1e-10 이하라면 걱정할 만합니다). 그렇다면 손실 함수에 상수를 곱해 잠시 키워서, 부동소수점이 더 촘촘한 “좋은” 범위로 옮겨 오는 것이 좋습니다. 가장 좋은 것은 부동소수점 지수가 0인 1.0 정도입니다.
목적 함수의 꺾이는 점. 그래디언트 검사 중에 알아 두어야 할 부정확함의 원인 하나는 꺾이는 점 문제입니다. 꺾이는 점이란 목적 함수에서 미분할 수 없는 부분을 말하며, ReLU(), SVM 손실, Maxout 뉴런 같은 함수 때문에 생깁니다. 에서 ReLU 함수의 그래디언트를 검사한다고 해 봅시다. 이므로 이 점에서 해석적 그래디언트는 정확히 0입니다. 그런데 수치 그래디언트는 가 꺾이는 점을 넘어갈 수 있으므로(예를 들어 이면), 0이 아닌 기여가 생겨 느닷없이 0이 아닌 그래디언트를 계산합니다. 아주 드문 경우라고 생각할 수도 있지만, 사실은 매우 흔할 수 있습니다. 예를 들어 CIFAR-10에 쓰는 SVM에는 항이 45만 개까지 들어 있습니다. 예제가 5만 개이고 예제마다 목적 함수에 항이 9개씩 생기기 때문입니다. 게다가 SVM 분류기를 단 신경망에는 ReLU 때문에 꺾이는 점이 훨씬 더 많습니다.
손실을 계산할 때 꺾이는 점을 넘었는지는 알아낼 수 있다는 점에 유의하세요. 꼴의 함수에서 “이긴 쪽”이 누구였는지, 곧 순전파 때 x와 y 중 어느 쪽이 더 컸는지를 모두 기록해 두면 됩니다. 와 를 계산할 때 이긴 쪽이 하나라도 바뀌었다면, 꺾이는 점을 넘은 것이고 수치 그래디언트는 정확하지 않습니다.
데이터 포인트를 조금만 쓰세요. 위의 꺾이는 점 문제를 푸는 방법 하나는 데이터 포인트를 적게 쓰는 것입니다. 꺾이는 점이 있는 손실 함수(예를 들어 ReLU나 마진 손실 등을 써서)는 데이터 포인트가 적을수록 꺾이는 점도 적으므로, 유한 차분 근사를 할 때 그중 하나를 넘을 가능성이 줄어듭니다. 게다가 데이터 포인트 2~3개쯤으로 그래디언트 검사를 통과한다면, 배치 전체로도 거의 틀림없이 통과할 것입니다. 데이터 포인트를 아주 적게 쓰면 그래디언트 검사도 더 빠르고 효율적이 됩니다.
스텝 크기 h를 조심하세요. 작을수록 좋은 것은 아닙니다. 가 아주 작아지면 수치 정밀도 문제에 부딪히기 시작할 수 있기 때문입니다. 그래디언트 검사가 통과하지 않을 때, 를 1e-4나 1e-6으로 바꾸면 갑자기 그래디언트가 맞게 나오는 경우도 있습니다. 이 위키백과 글에는 x축에 h 값, y축에 수치 그래디언트 오차를 그린 그래프가 있습니다.
“특징적인” 작동 상태에서 그래디언트를 검사하세요. 그래디언트 검사는 파라미터 공간의 특정한(그리고 대개 무작위인) 한 점에서 이루어진다는 점을 알아야 합니다. 그 점에서 그래디언트 검사가 통과했다고 해서, 그래디언트가 전역적으로 올바르게 구현되었다고 바로 확신할 수는 없습니다. 게다가 무작위 초기화 지점은 파라미터 공간에서 가장 “특징적인” 점이 아닐 수 있고, 오히려 그래디언트가 올바르게 구현된 것처럼 보이지만 실제로는 그렇지 않은 이상한 상황을 만들 수도 있습니다. 예를 들어 가중치를 아주 작게 초기화한 SVM은 모든 데이터 포인트에 거의 정확히 0인 점수를 매기고, 그래디언트는 모든 데이터 포인트에서 특정한 패턴을 보입니다. 그래디언트를 잘못 구현해도 이 패턴은 여전히 나올 수 있고, 어떤 점수가 다른 점수보다 큰 더 특징적인 작동 상태로는 일반화되지 않을 수 있습니다. 그러니 안전하려면 짧은 번인 시간을 두어 네트워크가 조금 학습하게 한 다음, 손실이 줄기 시작한 뒤에 그래디언트 검사를 하는 것이 가장 좋습니다. 첫 반복에서 검사하면, 이상한 경계 사례가 생겨 그래디언트의 잘못된 구현을 가릴 위험이 있습니다.
정규화가 데이터를 압도하지 않게 하세요. 손실 함수는 데이터 손실과 정규화 손실(예를 들어 가중치에 대한 L2 페널티)의 합인 경우가 많습니다. 알아 두어야 할 위험 하나는 정규화 손실이 데이터 손실을 압도할 수 있다는 것입니다. 그러면 그래디언트가 주로 정규화 항(대개 그래디언트 식이 훨씬 단순합니다)에서 나오게 됩니다. 이 때문에 데이터 손실 그래디언트의 잘못된 구현이 가려질 수 있습니다. 그래서 먼저 정규화를 끄고 데이터 손실만 검사한 다음, 정규화 항을 따로 검사하는 것을 권합니다. 정규화 항만 검사하는 방법 하나는 코드를 고쳐 데이터 손실의 기여를 없애는 것입니다. 다른 방법은 정규화 강도를 키워서, 그래디언트 검사에서 정규화의 효과가 무시할 수 없을 만큼 커지고 잘못된 구현이 드러나게 하는 것입니다.
드롭아웃과 데이터 증강을 끄는 것을 잊지 마세요. 그래디언트 검사를 할 때는 드롭아웃, 무작위 데이터 증강 같은, 네트워크의 비결정적인 효과를 모두 꺼야 합니다. 그러지 않으면 수치 그래디언트를 추정할 때 당연히 큰 오차가 생길 수 있습니다. 이런 효과를 끄는 데 따르는 단점은 그 부분의 그래디언트는 검사하지 못한다는 것입니다(예를 들어 드롭아웃이 올바르게 역전파되지 않을 수도 있습니다). 그러니 와 를 계산하기 전, 그리고 해석적 그래디언트를 계산하기 전에 특정한 난수 시드를 강제로 지정하는 편이 더 나은 해법일 수 있습니다.
몇몇 차원만 검사하세요. 실제로 그래디언트는 파라미터 수백만 개 크기일 수 있습니다. 이럴 때는 그래디언트의 일부 차원만 검사하고 나머지는 맞다고 가정하는 것이 현실적입니다. 주의하세요: 조심할 점 하나는 파라미터마다 따로 몇 차원씩 그래디언트를 검사해야 한다는 것입니다. 어떤 응용에서는 편의상 파라미터들을 하나의 큰 파라미터 벡터로 합쳐 둡니다. 이럴 때 예를 들어 편향은 전체 벡터에서 아주 적은 수의 파라미터만 차지할 수 있습니다. 그러니 무작위로 뽑지 말고 이 점을 고려해, 모든 파라미터가 올바른 그래디언트를 받는지 확인하는 것이 중요합니다.
학습 전에: 점검 요령
비싼 최적화에 뛰어들기 전에 해 볼 만한 점검이 몇 가지 있습니다.
- 우연 수준의 성능에서 손실이 맞게 나오는지 보세요. 파라미터를 작게 초기화했을 때 예상한 손실이 나오는지 확인하세요. 먼저 데이터 손실만 확인하는 것이 가장 좋습니다(그러니 정규화 강도를 0으로 두세요). 예를 들어 소프트맥스 분류기를 쓰는 CIFAR-10이라면 초기 손실은 2.302일 것으로 예상합니다. 클래스가 10개이므로 클래스마다 확률이 0.1로 고르게 퍼져 있을 것이고, 소프트맥스 손실은 정답 클래스의 음의 로그 확률이므로 -ln(0.1) = 2.302이기 때문입니다. Weston Watkins SVM이라면 (모든 점수가 거의 0이므로) 원하는 마진이 모두 어겨질 것이라 예상하고, 따라서 손실은 9일 것으로 예상합니다(틀린 클래스마다 마진이 1이므로). 이런 손실이 나오지 않는다면 초기화에 문제가 있을 수 있습니다.
- 두 번째 점검으로, 정규화 강도를 키우면 손실이 커져야 합니다.
- 데이터의 아주 작은 부분집합에 과적합시켜 보세요. 마지막으로 가장 중요한 점검입니다. 데이터셋 전체로 학습하기 전에 데이터의 아주 작은 일부(예를 들어 예제 20개)로 학습해 보고, 비용이 0이 되는지 확인하세요. 이 실험에서도 정규화는 0으로 두는 것이 가장 좋습니다. 그러지 않으면 비용이 0에 이르지 못할 수 있습니다. 작은 데이터셋으로 이 점검을 통과하지 못한다면, 전체 데이터셋으로 넘어갈 가치가 없습니다. 다만 아주 작은 데이터셋에 과적합할 수 있는데도 구현이 틀렸을 수 있다는 점에 유의하세요. 예를 들어 어떤 버그 때문에 데이터 포인트의 특징이 무작위라면, 작은 학습 세트에는 과적합할 수 있겠지만 전체 데이터셋으로 넓혔을 때 일반화는 전혀 보이지 않을 것입니다.
학습 과정 지켜보기
신경망을 학습하는 동안 지켜보면 좋은 양이 여럿 있습니다. 이런 그래프는 학습 과정을 들여다보는 창이며, 서로 다른 하이퍼파라미터 설정에 대한 감을 얻고 더 효율적으로 학습하려면 설정을 어떻게 바꿔야 할지 아는 데 써야 합니다.
아래 그래프들의 x축은 언제나 에폭 단위입니다. 에폭은 학습 중에 모든 예제를 평균적으로 몇 번 보았는지를 잽니다(예를 들어 1에폭이면 모든 예제를 한 번씩 본 것입니다). 반복 횟수는 배치 크기를 어떻게 정하느냐에 따라 달라지므로, 반복 횟수보다 에폭을 기록하는 편이 낫습니다.
손실 함수
학습 중에 기록해 두면 좋은 첫 번째 양은 손실입니다. 순전파 때 개별 배치마다 계산되는 값입니다. 아래는 시간에 따른 손실을 그린 만화 같은 그림인데, 특히 그 모양이 학습률에 관해 무엇을 알려 줄 수 있는지 보여 줍니다.
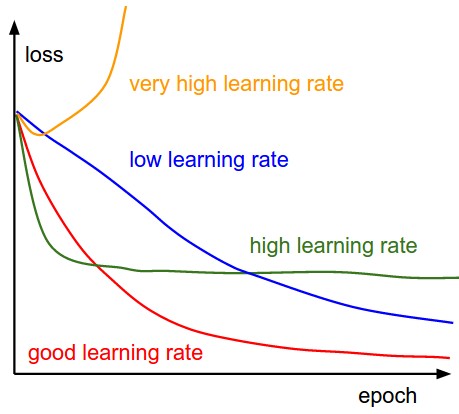
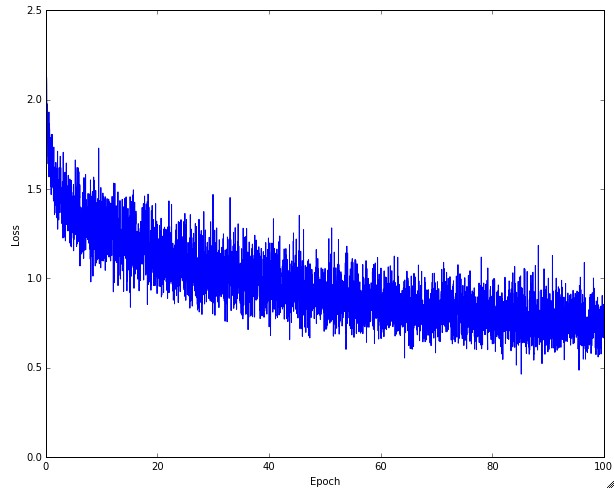
왼쪽(첫 번째 그림): 학습률에 따라 달라지는 효과를 그린 만화입니다. 학습률이 낮으면 개선이 선형으로 일어납니다. 학습률이 높으면 지수 함수에 더 가까워 보이기 시작합니다. 학습률이 높을수록 손실이 더 빨리 줄지만, 더 나쁜 손실 값에서 멈춰 버립니다(초록 선). 최적화에 “에너지”가 너무 많아서, 파라미터가 혼란스럽게 튀어 다니며 최적화 지형의 좋은 자리에 자리 잡지 못하기 때문입니다. 오른쪽(두 번째 그림): CIFAR-10 데이터셋으로 작은 네트워크를 학습할 때, 시간에 따른 전형적인 손실 함수의 예입니다. 이 손실 함수는 그럴듯해 보이고(줄어드는 속도로 보아 학습률이 조금 작은 것일 수도 있지만 단정하기 어렵습니다), 배치 크기가 조금 작을 수 있다는 것도 보여 줍니다(비용이 조금 지나치게 들쭉날쭉하기 때문입니다).
손실이 “흔들리는” 정도는 배치 크기와 관련이 있습니다. 배치 크기가 1이면 흔들림이 비교적 큽니다. 배치 크기가 데이터셋 전체이면, 그래디언트 업데이트마다 손실 함수가 단조롭게 줄어들 것이므로(학습률을 너무 높게 잡지 않았다면) 흔들림이 가장 작습니다.
손실 함수를 로그 스케일로 그리기를 좋아하는 사람들도 있습니다. 학습 진행은 대개 지수 함수 꼴이므로, 그래프가 하키 스틱 모양 대신 조금 더 해석하기 쉬운 직선으로 보입니다. 또 교차 검증한 여러 모델을 같은 손실 그래프에 그리면, 모델들 사이의 차이가 더 뚜렷이 보입니다.
손실 함수가 우스꽝스럽게 보일 때도 있습니다. lossfunctions.tumblr.com을 보세요.
학습/검증 정확도
분류기를 학습할 때 기록해 두면 좋은 두 번째 중요한 양은 검증 정확도와 학습 정확도입니다. 이 그래프로 모델이 얼마나 과적합하는지에 관해 귀중한 통찰을 얻을 수 있습니다.
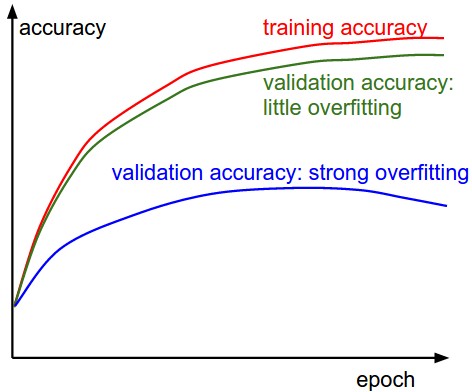
학습 정확도와 검증 정확도 사이의 간격은 과적합의 정도를 나타냅니다. 그림에는 가능한 두 경우가 나와 있습니다. 파란 검증 오차 곡선은 학습 정확도에 비해 검증 정확도가 아주 낮아서, 과적합이 심하다는 것을 보여 줍니다(어느 시점 이후로는 검증 정확도가 오히려 떨어지기 시작할 수도 있다는 점에 유의하세요). 실제로 이런 모습을 보면 정규화를 강하게 하거나(L2 가중치 페널티를 키우거나 드롭아웃을 늘리는 등) 데이터를 더 모으는 것이 좋습니다. 다른 경우는 검증 정확도가 학습 정확도를 꽤 잘 따라가는 경우입니다. 이 경우는 모델의 용량이 충분히 크지 않다는 뜻이므로, 파라미터 수를 늘려 모델을 키우세요.
가중치 대 업데이트 비율
마지막으로 기록해 보면 좋은 양은 값의 크기에 대한 업데이트 크기의 비율입니다. 주의하세요: 원래 그래디언트가 아니라 업데이트입니다(예를 들어 기본 SGD라면 그래디언트에 학습률을 곱한 값입니다). 이 비율은 파라미터 묶음마다 따로 계산해 기록하는 것이 좋습니다. 대략적인 경험칙으로는 이 비율이 1e-3 언저리여야 합니다. 이보다 낮으면 학습률이 너무 낮을 수 있습니다. 더 높으면 학습률이 너무 높을 가능성이 큽니다. 구체적인 예는 다음과 같습니다.
# assume parameter vector W and its gradient vector dW
param_scale = np.linalg.norm(W.ravel())
update = -learning_rate*dW # simple SGD update
update_scale = np.linalg.norm(update.ravel())
W += update # the actual update
print update_scale / param_scale # want ~1e-3
최솟값이나 최댓값을 기록하는 대신, 그래디언트와 업데이트의 노름을 계산해 기록하기를 좋아하는 사람들도 있습니다. 이런 지표들은 대개 서로 상관관계가 있어서, 결과도 대체로 비슷하게 나옵니다.
층별 활성값/그래디언트 분포
초기화를 잘못하면 학습 과정이 느려지거나 아예 멈춰 버릴 수 있습니다. 다행히 이 문제는 비교적 쉽게 진단할 수 있습니다. 방법 하나는 네트워크의 모든 층에 대해 활성값과 그래디언트의 히스토그램을 그려 보는 것입니다. 직관적으로, 이상한 분포가 보인다면 좋은 신호가 아닙니다. 예를 들어 tanh 뉴런이라면, 모든 뉴런이 0을 출력하거나 모든 뉴런이 -1 또는 1에서 완전히 포화된 모습이 아니라, 뉴런 활성값이 [-1,1] 범위 전체에 퍼져 있는 분포를 보고 싶습니다.
첫 번째 층 시각화
마지막으로 이미지 픽셀을 다룰 때는, 첫 번째 층의 특징을 눈으로 볼 수 있게 그려 보면 도움도 되고 뿌듯하기도 합니다.
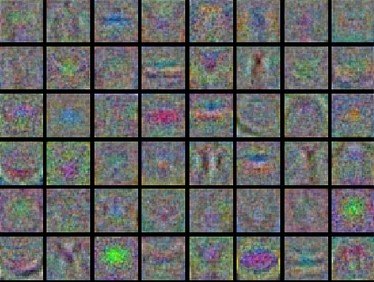
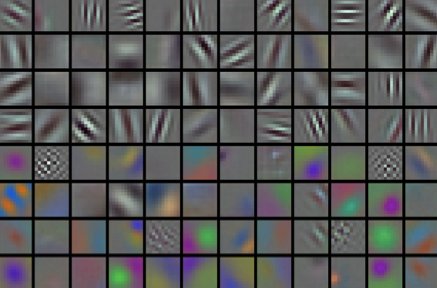
신경망 첫 번째 층의 가중치를 시각화한 예입니다. 왼쪽(첫 번째 그림): 잡음이 많은 특징은 수렴하지 않은 네트워크, 잘못 잡은 학습률, 너무 낮은 가중치 정규화 페널티 같은 문제의 증상일 수 있습니다. 오른쪽(두 번째 그림): 매끄럽고 깔끔하며 다양한 특징은 학습이 잘 진행되고 있다는 좋은 신호입니다.
파라미터 업데이트
역전파로 해석적 그래디언트를 계산하고 나면, 그 그래디언트로 파라미터를 업데이트합니다. 업데이트하는 방법은 여러 가지가 있으며, 이제 그것들을 살펴보겠습니다.
심층 신경망의 최적화는 지금도 아주 활발한 연구 분야라는 점을 말해 둡니다. 이 절에서는 실제로 보게 될 만한, 자리 잡은 흔한 기법들을 골라 그 직관을 짧게 설명하고, 자세한 분석은 이 수업의 범위 밖으로 남겨 둡니다. 관심 있는 독자를 위해 더 읽을거리도 몇 가지 알려 드립니다.
SGD와 이런저런 장치들
기본 업데이트. 가장 단순한 업데이트는 파라미터를 음의 그래디언트 방향으로 바꾸는 것입니다(그래디언트는 증가하는 방향을 가리키는데, 우리는 대개 손실 함수를 최소화하고 싶기 때문입니다). 파라미터 벡터를 x, 그래디언트를 dx라 하면 가장 단순한 업데이트는 다음과 같습니다.
# Vanilla update
x += - learning_rate * dx
여기서 learning_rate는 하이퍼파라미터, 곧 고정된 상수입니다. 데이터셋 전체로 계산하고 학습률이 충분히 낮다면, 이 업데이트는 손실 함수에서 뒷걸음질하지 않는다는 것이 보장됩니다.
모멘텀 업데이트는 심층 네트워크에서 거의 언제나 더 빨리 수렴하는 또 다른 방법입니다. 이 업데이트는 최적화 문제를 물리적으로 바라보는 데서 나왔다고 볼 수 있습니다. 구체적으로, 손실을 언덕이 많은 지형의 높이로 해석할 수 있습니다(따라서 위치 에너지로도 해석할 수 있습니다. 이므로 이기 때문입니다). 파라미터를 난수로 초기화하는 것은 어떤 위치에 초기 속도가 0인 입자를 놓는 것과 같습니다. 그러면 최적화 과정은 파라미터 벡터(곧 입자)가 지형 위를 굴러가는 과정을 시뮬레이션하는 것과 같다고 볼 수 있습니다.
입자에 작용하는 힘은 위치 에너지의 그래디언트와 관련되므로(곧 ), 입자가 받는 힘은 정확히 손실 함수의 (음의) 그래디언트입니다. 게다가 이므로, 이 관점에서 (음의) 그래디언트는 입자의 가속도에 비례합니다. 앞에서 본 SGD 업데이트와는 다르다는 점에 유의하세요. SGD에서는 그래디언트가 위치에 바로 더해졌습니다. 반면 물리적 관점에서는 그래디언트가 속도에만 직접 영향을 주고, 속도가 다시 위치에 영향을 주는 업데이트가 나옵니다.
# Momentum update
v = mu * v - learning_rate * dx # integrate velocity
x += v # integrate position
여기서는 0으로 초기화되는 변수 v와 하이퍼파라미터 하나(mu)가 새로 들어옵니다. 안타깝게도 이름이 잘못 붙어서, 최적화에서는 이 변수를 모멘텀이라 부르지만(보통 값은 0.9 정도입니다), 물리적 의미는 마찰 계수에 더 가깝습니다. 사실상 이 변수는 속도를 줄여 계의 운동 에너지를 낮춥니다. 그러지 않으면 입자가 언덕 바닥에서 영영 멈추지 않을 것입니다. 교차 검증할 때 이 파라미터는 보통 [0.5, 0.9, 0.95, 0.99] 같은 값으로 둡니다. 학습률을 점점 줄이는 일정(아래에서 다룹니다)과 비슷하게, 학습 후반으로 갈수록 모멘텀을 키우는 모멘텀 일정이 최적화에 조금 도움이 될 때도 있습니다. 전형적인 설정은 모멘텀을 0.5 정도에서 시작해 여러 에폭에 걸쳐 0.99 정도로 올리는 것입니다.
모멘텀 업데이트를 쓰면, 파라미터 벡터는 그래디언트가 꾸준히 가리키는 방향이면 어느 쪽으로든 속도를 쌓아 갑니다.
네스테로프 모멘텀은 모멘텀 업데이트를 조금 바꾼 것으로, 최근 인기를 얻고 있습니다. 볼록 함수에 대해 이론적으로 더 강한 수렴 보장이 있고, 실제로도 표준 모멘텀보다 꾸준히 조금 더 잘 작동합니다.
네스테로프 모멘텀의 핵심 발상은 이렇습니다. 지금 파라미터 벡터가 어떤 위치 x에 있다고 합시다. 위의 모멘텀 업데이트를 보면, 모멘텀 항만으로도(곧 그래디언트가 들어간 두 번째 항을 빼고도) 파라미터 벡터가 mu * v만큼 밀려갈 참이라는 것을 알 수 있습니다. 그러니 그래디언트를 계산하려는 참이라면, 대략적인 미래 위치 x + mu * v를 “내다보기”로 삼을 수 있습니다. 곧 우리가 머지않아 도착할 곳 근처의 한 점입니다. 따라서 “낡은” 위치 x 대신 x + mu * v에서 그래디언트를 계산하는 것이 이치에 맞습니다.
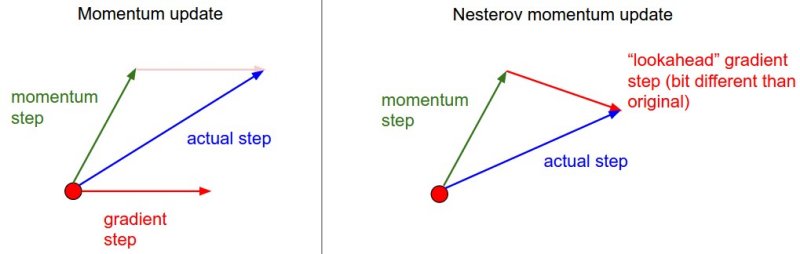
네스테로프 모멘텀. 현재 위치(빨간 원)에서 그래디언트를 계산하는 대신, 모멘텀이 우리를 초록 화살표 끝으로 데려갈 것을 알고 있습니다. 그래서 네스테로프 모멘텀에서는 이 “내다본” 위치에서 그래디언트를 계산합니다.
조금 어색한 표기로 쓰면, 다음과 같이 하고 싶은 것입니다.
x_ahead = x + mu * v
# evaluate dx_ahead (the gradient at x_ahead instead of at x)
v = mu * v - learning_rate * dx_ahead
x += v
(코드 안 주석은 “x 대신 x_ahead에서의 그래디언트 dx_ahead를 계산한다”는 뜻입니다.) 하지만 실제로 사람들은 업데이트를 기본 SGD나 앞의 모멘텀 업데이트와 되도록 비슷하게 표현하는 쪽을 좋아합니다. 위의 업데이트를 변수 변환 x_ahead = x + mu * v로 조작해, 업데이트를 x 대신 x_ahead로 표현하면 그렇게 할 수 있습니다. 곧 실제로 저장해 두는 파라미터 벡터가 언제나 앞선 버전이 되는 것입니다. x_ahead로 쓴(그리고 이름을 다시 x로 바꾼) 식은 다음과 같습니다.
v_prev = v # back this up
v = mu * v - learning_rate * dx # velocity update stays the same
x += -mu * v_prev + (1 + mu) * v # position update changes form
이 식들이 어디서 나왔는지, 네스테로프 가속 모멘텀의 수학적 공식화를 이해하려면 다음 글을 더 읽어 보기를 권합니다.
- Yoshua Bengio의 Advances in optimizing Recurrent Networks, 3.5절.
- Ilya Sutskever의 학위 논문(pdf) 7.2절에 이 주제를 더 길게 설명해 두었습니다.
학습률 줄이기
심층 네트워크를 학습할 때는 대개 시간이 지남에 따라 학습률을 줄이는 것이 도움이 됩니다. 염두에 두면 좋은 직관은 이렇습니다. 학습률이 높으면 계에 운동 에너지가 너무 많아서, 파라미터 벡터가 혼란스럽게 튀어 다니며 손실 함수의 더 깊지만 더 좁은 곳에 자리 잡지 못합니다. 언제 학습률을 줄일지 정하기는 까다로울 수 있습니다. 천천히 줄이면 오랫동안 별 개선 없이 혼란스럽게 튀어 다니느라 계산을 낭비하게 됩니다. 하지만 너무 급하게 줄이면 계가 너무 빨리 식어서, 닿을 수 있는 가장 좋은 자리에 이르지 못합니다. 학습률 감소를 구현하는 흔한 방식은 세 가지입니다.
- 계단식 감소: 몇 에폭마다 학습률을 어떤 비율로 줄입니다. 전형적인 값은 5에폭마다 학습률을 절반으로 줄이거나, 20에폭마다 0.1배로 줄이는 것입니다. 이 숫자들은 문제와 모델의 종류에 크게 좌우됩니다. 실제로 보게 될 만한 경험칙 하나는, 학습률을 고정해 두고 학습하면서 검증 오차를 지켜보다가 검증 오차가 더 나아지지 않을 때마다 학습률을 상수배(예를 들어 0.5배)로 줄이는 것입니다.
- 지수 감소는 수학적으로 꼴입니다. 여기서 는 하이퍼파라미터이고 는 반복 횟수입니다(에폭 단위를 써도 됩니다).
- 1/t 감소는 수학적으로 꼴입니다. 여기서 는 하이퍼파라미터이고 는 반복 횟수입니다.
실제로는 계단식 감소가 조금 더 나았습니다. 여기에 들어가는 하이퍼파라미터(줄이는 비율과 에폭 단위의 시점)가 하이퍼파라미터 보다 해석하기 쉽기 때문입니다. 마지막으로, 계산 예산이 허락한다면 천천히 줄이는 쪽을 택해 더 오래 학습하세요.
2차 방법
딥러닝에서 최적화에 널리 쓰이는 두 번째 방법 묶음은 뉴턴 방법에 바탕을 둡니다. 뉴턴 방법은 다음 업데이트를 반복합니다.
여기서 는 헤세 행렬로, 함수의 2차 편미분으로 이루어진 정사각 행렬입니다. 항은 경사 하강법에서 본 그래디언트 벡터입니다. 직관적으로 헤세 행렬은 손실 함수의 국소적인 곡률을 나타내므로, 이를 이용하면 더 효율적으로 업데이트할 수 있습니다. 구체적으로 헤세 행렬의 역행렬을 곱하면, 곡률이 완만한 방향으로는 더 과감하게 나아가고 곡률이 가파른 방향으로는 더 짧게 나아가게 됩니다. 결정적으로, 업데이트 공식에 학습률 하이퍼파라미터가 전혀 없다는 점에 주목하세요. 이 방법을 지지하는 사람들은 이것을 1차 방법보다 크게 나은 점으로 꼽습니다.
하지만 위 업데이트는 대부분의 딥러닝 응용에서 현실적이지 않습니다. 헤세 행렬을 명시적으로 계산하는(그리고 역행렬을 구하는) 일은 공간으로나 시간으로나 비용이 아주 크기 때문입니다. 예를 들어 파라미터가 100만 개인 신경망의 헤세 행렬은 크기가 [1,000,000 x 1,000,000]이고, RAM을 약 3,725기가바이트 차지합니다. 그래서 헤세 역행렬을 근사하려는 다양한 준뉴턴 방법이 개발되었습니다. 그중 가장 널리 쓰이는 것은 L-BFGS로, 시간에 걸친 그래디언트 정보를 이용해 근사를 암묵적으로 만듭니다(곧 전체 행렬은 한 번도 계산하지 않습니다).
하지만 메모리 걱정을 없애더라도, L-BFGS를 순진하게 적용할 때의 큰 단점은 학습 세트 전체에 대해 계산해야 한다는 것입니다. 학습 세트에는 예제가 수백만 개 있을 수 있습니다. 미니배치 SGD와 달리, L-BFGS를 미니배치에서 작동하게 만드는 일은 더 까다롭고 지금도 활발한 연구 분야입니다.
실제로는 현재 L-BFGS나 비슷한 2차 방법을 대규모 딥러닝과 합성곱 신경망에 적용하는 경우는 흔하지 않습니다. 대신 (네스테로프) 모멘텀에 바탕을 둔 SGD 변형들이 더 표준적입니다. 더 단순하고 규모를 키우기도 더 쉽기 때문입니다.
더 읽을거리:
- Large Scale Distributed Deep Networks는 Google Brain 팀의 논문으로, 대규모 분산 최적화에서 L-BFGS와 SGD 변형들을 비교합니다.
- SFO 알고리즘은 SGD의 장점과 L-BFGS의 장점을 합치려 합니다.
파라미터별 적응형 학습률 방법
지금까지 살펴본 방법들은 모두 학습률을 전역적으로, 모든 파라미터에 똑같이 조정했습니다. 학습률 조정은 비용이 큰 과정이어서, 학습률을 적응적으로, 그것도 파라미터마다 조정하는 방법을 고안하는 데 많은 노력이 들어갔습니다. 이런 방법 중 다수는 여전히 다른 하이퍼파라미터 설정이 필요할 수 있지만, 원래의 학습률보다 더 넓은 범위의 하이퍼파라미터 값에서 무난하게 작동한다는 것이 그 근거입니다. 이 절에서는 실제로 보게 될 만한 흔한 적응형 방법 몇 가지를 소개합니다.
Adagrad는 Duchi 등이 처음 제안한 적응형 학습률 방법입니다.
# Assume the gradient dx and parameter vector x
cache += dx**2
x += - learning_rate * dx / (np.sqrt(cache) + eps)
변수 cache의 크기는 그래디언트의 크기와 같으며, 파라미터별로 그래디언트 제곱의 합을 기록한다는 점에 주목하세요. 이 값으로 파라미터 업데이트 단계를 원소별로 정규화합니다. 그래디언트를 크게 받는 가중치는 실질 학습률이 줄고, 업데이트를 작게 또는 드물게 받는 가중치는 실질 학습률이 커진다는 점에 주목하세요. 재미있게도 제곱근 연산이 아주 중요한 것으로 드러났습니다. 제곱근이 없으면 알고리즘 성능이 훨씬 나빠집니다. 평활 항 eps(보통 1e-4에서 1e-8 사이의 값)는 0으로 나누는 것을 막습니다. Adagrad의 단점은, 딥러닝에서는 단조롭게 줄어드는 학습률이 대개 너무 공격적이어서 학습을 너무 일찍 멈춰 버린다는 것입니다.
RMSprop. RMSprop은 아주 효과적이지만 아직 논문으로 발표되지 않은 적응형 학습률 방법입니다. 재미있게도 지금 이 방법을 쓰는 사람은 모두 Geoff Hinton의 Coursera 강의 6강 슬라이드 29쪽을 인용합니다. RMSProp 업데이트는 Adagrad의 공격적이고 단조롭게 줄어드는 학습률을 누그러뜨리려고, Adagrad 방법을 아주 단순하게 고칩니다. 구체적으로, 그래디언트 제곱의 이동 평균을 대신 써서 다음과 같이 됩니다.
cache = decay_rate * cache + (1 - decay_rate) * dx**2
x += - learning_rate * dx / (np.sqrt(cache) + eps)
여기서 decay_rate는 하이퍼파라미터이고 전형적인 값은 [0.9, 0.99, 0.999]입니다. x+= 업데이트는 Adagrad와 똑같지만, cache 변수는 “새는” 값이라는 점에 주목하세요. 따라서 RMSProp은 여전히 가중치마다 그래디언트 크기에 따라 학습률을 조절하므로 고르게 맞춰 주는 이로운 효과가 있지만, Adagrad와 달리 업데이트가 단조롭게 작아지지는 않습니다.
Adam. Adam은 최근 제안된 업데이트로, 모멘텀을 단 RMSProp과 조금 닮았습니다. (단순화한) 업데이트는 다음과 같습니다.
m = beta1*m + (1-beta1)*dx
v = beta2*v + (1-beta2)*(dx**2)
x += - learning_rate * m / (np.sqrt(v) + eps)
업데이트가 RMSProp 업데이트와 똑같아 보이지만, 원래의(그리고 아마 잡음이 섞인) 그래디언트 벡터 dx 대신 그래디언트의 “매끄러운” 버전 m을 쓴다는 점만 다릅니다. 논문에서 권하는 값은 eps = 1e-8, beta1 = 0.9, beta2 = 0.999입니다. 실제로 지금은 Adam을 기본 알고리즘으로 쓰기를 권하며, 대개 RMSProp보다 조금 더 잘 작동합니다. 하지만 SGD+네스테로프 모멘텀도 대안으로 시도해 볼 만한 경우가 많습니다. 완전한 Adam 업데이트에는 편향 보정 장치도 들어 있습니다. 처음 몇 시간 단계에서는 벡터 m,v가 0으로 초기화되어 있어서, 충분히 “데워지기” 전까지는 0 쪽으로 치우쳐 있다는 점을 보정하는 장치입니다. 편향 보정 장치를 넣은 업데이트는 다음과 같습니다.
# t is your iteration counter going from 1 to infinity
m = beta1*m + (1-beta1)*dx
mt = m / (1-beta1**t)
v = beta2*v + (1-beta2)*(dx**2)
vt = v / (1-beta2**t)
x += - learning_rate * mt / (np.sqrt(vt) + eps)
(첫 줄 주석은 “t는 1부터 무한대까지 가는 반복 횟수”라는 뜻입니다.) 이제 업데이트가 다른 파라미터들뿐 아니라 반복 횟수의 함수이기도 하다는 점에 유의하세요. 자세한 내용은 논문이나, 이 내용을 더 풀어 설명한 강의 슬라이드를 참고하세요.
더 읽을거리:
- Unit Tests for Stochastic Optimization은 확률적 최적화의 표준 벤치마크로 쓸 일련의 시험을 제안합니다.
[그림: 손실 곡면의 등고선 위에서 SGD, 모멘텀, NAG, Adagrad, Adadelta, RMSprop 같은 여러 최적화 알고리즘의 경로가 시간에 따라 움직이는 애니메이션]
[그림: 말안장 모양 곡면 위에서 여러 최적화 알고리즘이 안장점을 벗어나는 모습을 보여 주는 애니메이션. SGD는 꼭대기에 머물고 RMSprop 같은 방법은 빠져나간다]
학습 과정의 동역학에 대한 직관을 키우는 데 도움이 될 만한 애니메이션입니다. 왼쪽(첫 번째 그림): 손실 곡면의 등고선과, 여러 최적화 알고리즘이 시간에 따라 움직이는 모습입니다. 모멘텀 기반 방법들이 “지나쳐 가는” 모습에 주목하세요. 최적화가 언덕을 굴러 내려가는 공처럼 보입니다. 오른쪽(두 번째 그림): 최적화 지형의 안장점을 시각화한 것입니다. 안장점에서는 차원마다 곡률의 부호가 다릅니다(한 차원은 위로 휘고 다른 차원은 아래로 휩니다). SGD는 대칭을 깨는 데 아주 애를 먹고 꼭대기에 갇혀 버린다는 점에 주목하세요. 반대로 RMSprop 같은 알고리즘은 안장 방향으로 아주 낮은 그래디언트를 보게 됩니다. RMSprop 업데이트의 분모 항 때문에 이 방향의 실질 학습률이 커지고, 그래서 RMSProp이 앞으로 나아갈 수 있습니다. 그림 출처: Alec Radford.
하이퍼파라미터 최적화
지금까지 보았듯이 신경망을 학습하려면 하이퍼파라미터를 많이 정해야 할 수 있습니다. 신경망에서 가장 흔한 하이퍼파라미터는 다음과 같습니다.
- 초기 학습률
- 학습률 감소 일정(감소 상수 등)
- 정규화 강도(L2 페널티, 드롭아웃 강도)
하지만 앞에서 보았듯이, 상대적으로 덜 민감한 하이퍼파라미터도 훨씬 많습니다. 예를 들어 파라미터별 적응형 학습 방법의 하이퍼파라미터, 모멘텀과 그 일정 설정 등입니다. 이 절에서는 하이퍼파라미터 탐색을 할 때 쓸 만한 요령을 몇 가지 더 설명합니다.
구현. 큰 신경망은 대개 학습하는 데 오래 걸리므로, 하이퍼파라미터 탐색에 며칠에서 몇 주가 걸릴 수 있습니다. 이 점은 코드베이스 설계에 영향을 주므로 염두에 두어야 합니다. 한 가지 설계는 무작위 하이퍼파라미터를 계속 뽑아 최적화를 수행하는 워커를 두는 것입니다. 학습하는 동안 워커는 에폭마다 검증 성능을 기록하고, 모델 체크포인트를(시간에 따른 손실 같은 갖가지 학습 통계와 함께) 파일에 씁니다. 공유 파일 시스템에 쓰는 것이 좋습니다. 파일 이름에 검증 성능을 바로 넣어 두면, 진행 상황을 살펴보고 정렬하기 쉬워서 유용합니다. 그리고 마스터라고 부를 두 번째 프로그램을 둡니다. 마스터는 계산 클러스터 전체에서 워커를 띄우거나 멈추고, 워커가 쓴 체크포인트를 살펴보고 학습 통계를 그래프로 그리는 등의 일도 할 수 있습니다.
교차 검증보다 검증 폴드 하나를 쓰세요. 대부분의 경우, 적당한 크기의 검증 세트 하나를 쓰면 여러 폴드로 교차 검증할 필요 없이 코드베이스가 크게 단순해집니다. 사람들이 어떤 파라미터를 “교차 검증했다”고 말하는 것을 듣게 될 텐데, 많은 경우 실제로는 검증 세트 하나만 썼다고 보면 됩니다.
하이퍼파라미터 범위. 하이퍼파라미터는 로그 스케일에서 탐색하세요. 예를 들어 학습률을 뽑는 전형적인 방법은 learning_rate = 10 ** uniform(-6, 1)입니다. 곧 균등 분포에서 난수를 뽑은 다음, 10을 그 난수만큼 거듭제곱합니다. 정규화 강도에도 같은 전략을 써야 합니다. 직관적으로 이는 학습률과 정규화 강도가 학습 동역학에 곱셈으로 영향을 주기 때문입니다. 예를 들어 학습률에 0.01을 더하는 고정된 변화는, 학습률이 0.001이면 동역학에 엄청난 영향을 주지만 학습률이 10이면 거의 영향이 없습니다. 업데이트에서 학습률이 계산된 그래디언트에 곱해지기 때문입니다. 그러니 학습률에 어떤 값을 더하거나 빼서 범위를 잡기보다, 학습률에 어떤 값을 곱하거나 나눠서 범위를 잡는 편이 훨씬 자연스럽습니다. 일부 파라미터(예를 들어 드롭아웃)는 대신 보통 원래 스케일에서 탐색합니다(예를 들어 dropout = uniform(0,1)).
격자 탐색보다 무작위 탐색을 쓰세요. Bergstra와 Bengio가 Random Search for Hyper-Parameter Optimization(하이퍼파라미터 최적화를 위한 무작위 탐색)에서 주장했듯이, “하이퍼파라미터 최적화에는 무작위로 고른 시도가 격자 위의 시도보다 더 효율적”입니다. 알고 보면 대개 구현하기도 더 쉽습니다.
[그림: 왼쪽은 격자 배치, 오른쪽은 무작위 배치로 9번 시도한 점을 보여 주고, 각 축 바깥에 중요한 파라미터와 중요하지 않은 파라미터에 따른 성능 곡선을 그린 그림. 무작위 배치가 중요한 파라미터 축에서 더 많은 서로 다른 값을 시험한다]
Bergstra와 Bengio의 Random Search for Hyper-Parameter Optimization에 나오는 핵심 그림입니다. 어떤 하이퍼파라미터가 다른 것보다 훨씬 중요한 경우가 아주 많습니다(예를 들어 이 그림에서는 위쪽 하이퍼파라미터가 왼쪽 하이퍼파라미터보다 중요합니다). 격자 탐색 대신 무작위 탐색을 하면, 중요한 하이퍼파라미터의 좋은 값을 훨씬 정밀하게 찾아낼 수 있습니다.
가장 좋은 값이 경계에 있으면 조심하세요. 하이퍼파라미터(예를 들어 학습률)를 나쁜 범위에서 탐색하고 있을 때가 있습니다. 예를 들어 learning_rate = 10 ** uniform(-6, 1)을 쓴다고 합시다. 결과를 받으면, 최종 학습률이 이 구간의 가장자리에 있지 않은지 다시 확인하는 것이 중요합니다. 가장자리에 있다면 구간 너머에 있는 더 좋은 하이퍼파라미터 설정을 놓치고 있을 수 있습니다.
탐색을 거친 단계에서 세밀한 단계로 나눠 진행하세요. 실제로는 먼저 넓은 범위(예를 들어 10 ** [-6, 1])에서 탐색한 다음, 가장 좋은 결과가 어디서 나오는지에 따라 범위를 좁혀 가는 것이 도움이 됩니다. 또 처음의 거친 탐색에서는 1에폭이나 그보다 짧게만 학습하는 것이 도움이 됩니다. 많은 하이퍼파라미터 설정에서 모델이 아예 학습하지 않거나, 곧바로 비용이 무한대로 터져 버리기 때문입니다. 그다음 두 번째 단계에서는 5에폭으로 더 좁은 범위를 탐색하고, 마지막 단계에서는 최종 범위에서 훨씬 많은 에폭으로 자세히 탐색하는 식으로 할 수 있습니다(예를 들어).
베이즈 하이퍼파라미터 최적화는 하이퍼파라미터 공간을 더 효율적으로 탐색하는 알고리즘을 만드는 데 몰두하는 하나의 연구 분야입니다. 핵심 발상은 여러 하이퍼파라미터에서 성능을 물어볼 때, 탐색과 활용 사이의 균형을 알맞게 잡는 것입니다. 이런 모델에 바탕을 둔 라이브러리도 여럿 개발되었는데, 잘 알려진 것으로 Spearmint, SMAC, Hyperopt가 있습니다. 하지만 합성곱 신경망을 쓰는 실제 환경에서는, 신중하게 고른 구간에서의 무작위 탐색을 이기기가 여전히 비교적 어렵습니다. 현장에서 나온 이야기를 여기에서 더 보세요.
평가
모델 앙상블
실제로 신경망 성능을 몇 퍼센트 끌어올리는 믿을 만한 방법 하나는, 독립적인 모델을 여러 개 학습하고 시험할 때 그 예측을 평균하는 것입니다. 앙상블에 들어가는 모델 수가 늘수록 성능은 대개 단조롭게 좋아집니다(다만 늘어나는 폭은 점점 줄어듭니다). 게다가 앙상블 안의 모델이 다양할수록 개선이 더 극적입니다. 앙상블을 만드는 방법은 몇 가지가 있습니다.
- 같은 모델, 다른 초기화. 교차 검증으로 가장 좋은 하이퍼파라미터를 정한 다음, 그 하이퍼파라미터로 무작위 초기화만 다르게 해 모델 여러 개를 학습합니다. 이 방법의 위험은 다양성이 초기화에서만 나온다는 것입니다.
- 교차 검증 중에 찾은 상위 모델들. 교차 검증으로 가장 좋은 하이퍼파라미터를 정한 다음, 상위 몇 개(예를 들어 10개) 모델을 골라 앙상블을 만듭니다. 앙상블의 다양성은 커지지만, 최적이 아닌 모델이 들어갈 위험이 있습니다. 실제로는 교차 검증 뒤에 모델을 다시 학습할 필요가 없으므로 이 방법이 더 하기 쉬울 수 있습니다.
- 모델 하나의 서로 다른 체크포인트. 학습 비용이 아주 크다면, 네트워크 하나의 체크포인트를 시간에 따라(예를 들어 에폭마다) 여러 개 받아 그것들로 앙상블을 만들어 어느 정도 효과를 본 사람들도 있습니다. 당연히 다양성이 다소 부족하지만, 실제로는 그런대로 잘 작동할 수 있습니다. 이 방법의 장점은 비용이 아주 적다는 것입니다.
- 학습 중 파라미터의 이동 평균. 바로 앞 방법과 관련된 것으로, 성능을 거의 언제나 1~2퍼센트 더 얻는 값싼 방법입니다. 학습하는 동안 지난 가중치들의 지수적으로 감소하는 합을 담은, 네트워크 가중치의 두 번째 사본을 메모리에 유지하는 것입니다. 이렇게 하면 지난 몇 번의 반복에 걸친 네트워크 상태를 평균하게 됩니다. 지난 몇 단계에 걸쳐 “매끄럽게” 만든 이 가중치가 거의 언제나 더 나은 검증 오차를 낸다는 것을 알게 될 것입니다. 염두에 둘 대략적인 직관은 이렇습니다. 목적 함수는 그릇 모양이고 네트워크는 최빈점 주변을 뛰어다니므로, 평균은 최빈점에 더 가까운 어딘가에 있을 가능성이 더 큽니다.
모델 앙상블의 단점 하나는 시험 예제를 평가하는 데 시간이 더 걸린다는 것입니다. 관심 있는 독자라면 Geoff Hinton의 최근 연구 “Dark Knowledge”(어두운 지식)에서 영감을 얻을 수 있을 것입니다. 앙상블의 로그 우도를 수정된 목적 함수에 넣어, 좋은 앙상블을 다시 모델 하나로 “증류”하는 발상입니다.
요약
신경망을 학습하려면:
- 작은 데이터 배치로 구현의 그래디언트를 검사하고, 함정들을 알아 두세요.
- 점검 삼아 초기 손실이 그럴듯한지, 그리고 데이터의 아주 작은 부분에서 학습 정확도 100%에 이를 수 있는지 확인하세요.
- 학습하는 동안 손실, 학습/검증 정확도를 지켜보고, 조금 더 신경 쓰고 싶다면 파라미터 값에 대한 업데이트 크기도 지켜보세요(~1e-3이어야 합니다). 합성곱 신경망을 다룬다면 첫 번째 층의 가중치도 보세요.
- 권하는 업데이트 방법은 SGD+네스테로프 모멘텀 또는 Adam, 이 두 가지입니다.
- 학습 기간에 걸쳐 학습률을 줄이세요. 예를 들어 정해진 에폭 수가 지나면, 또는 검증 정확도가 더 오르지 않을 때마다 학습률을 절반으로 줄이세요.
- 좋은 하이퍼파라미터는 (격자 탐색이 아니라) 무작위 탐색으로 찾으세요. 탐색은 거친 단계(넓은 하이퍼파라미터 범위, 1~5에폭만 학습)에서 세밀한 단계(좁은 범위, 훨씬 많은 에폭 학습)로 나눠 진행하세요.
- 성능을 더 얻으려면 모델 앙상블을 만드세요.
더 읽을거리
- Leon Bottou의 SGD 요령
- Yann LeCun의 Efficient BackProp(pdf)
- Yoshua Bengio의 Practical Recommendations for Gradient-Based Training of Deep Architectures
라이선스 고지
원문은 MIT 라이선스로 공개되어 있습니다. 아래는 원문 저장소(cs231n/cs231n.github.io)의 저작권 표시와 허가 문구 전문입니다.
Copyright (c) 2015 Andrej Karpathy
Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the "Software"), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions:
The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software.
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE.