Andrew Gibiansky: 고성능 컴퓨팅 기법을 딥러닝에 들여오기Andrew Gibiansky: Bringing HPC Techniques to Deep Learning
여러 GPU에서 그래디언트를 평균할 때 통신 비용이 GPU 수에 비례해 늘어나는 문제를, 고성능 컴퓨팅에서 쓰던 링 올리듀스로 풀어 GPU 수와 상관없는 통신량으로 데이터 병렬 학습을 40개 GPU까지 선형으로 늘린 Baidu SVAIL의 글
번역문 · 원저자: Andrew Gibiansky · 원문: Bringing HPC Techniques to Deep Learning · 원문 라이선스: CC BY-SA 2.0. 이 번역문도 원문과 같은 CC BY-SA 2.0을 따릅니다. 원문 글쓴이가 그린 그림은 글과 같은 CC BY-SA 2.0을 따르므로 그대로 실었습니다.
원문: 「Bringing HPC Techniques to Deep Learning」, Andrew Gibiansky, https://andrew.gibiansky.com/blog/machine-learning/baidu-allreduce/, 2017년 2월 21일 게시. 이 글은 원문을 한국어로 옮긴 번역문입니다.
라이선스: 원문 블로그 바닥글에 “이 블로그의 콘텐츠는 CC-BY-SA 라이선스를 따른다”고 적혀 있습니다. 이 번역도 같은 CC BY-SA 2.0 조건을 따릅니다. 참고: 이 글은 원래 Baidu Research 기술 블로그에 쓴 것으로, 그쪽의 허락을 받아 여기에 다시 싣습니다. 그 뒤로 이 아이디어는 발전을 거듭해 Uber의 훌륭한 Horovod 라이브러리에 들어갔습니다. 여러 GPU나 여러 노드에서 돌리는 딥러닝 애플리케이션에 MPI나 NCCL을 쓰려면 Horovod가 가장 쉬운 길입니다.
요약: 지난 몇 년 동안 신경망의 규모가 커졌고, 학습에는 엄청난 양의 데이터와 계산 자원이 들 수 있습니다. 필요한 만큼의 계산 능력을 얻으려고 저희는 고성능 컴퓨팅에서는 흔하지만 딥러닝에서는 잘 쓰이지 않는 기법으로 모델을 수십 개의 GPU로 늘립니다. 링 올리듀스라는 이 기법은 GPU끼리 통신하는 데 드는 시간을 줄여 주어, GPU가 쓸모 있는 계산에 더 많은 시간을 쓰게 합니다. Baidu의 실리콘밸리 AI 연구소에서는 이 기법으로 최고 수준의 음성 인식 모델을 성공적으로 학습시켰습니다. 저희는 링 올리듀스 구현을 라이브러리로, 그리고 TensorFlow 패치로 공개하게 되어 기쁩니다. 이 라이브러리들을 공개해 딥러닝 공동체가 모델을 더 효과적으로 키울 수 있기를 바랍니다.
링 올리듀스가 무엇이고 왜 많은 GPU로 쉽게 늘릴 수 있게 해 주는지 알고 싶다면 계속 읽어 주세요!
들어가며
지난 몇 년 동안 신경망은 다양한 문제에서 놀라울 만큼 효과적인 도구임이 드러났고, 크기와 계산 요구량도 빠르게 커졌습니다. 2012년에는 이미지 인식용 합성곱 신경망 SuperVision이 GPU 두 개로 일주일 동안, 매개변수 6천만 개로 물체 인식에서 큰 진전을 이뤘습니다1. 2016년에는 연구자들이 매개변수가 10억 개 넘는 신경망을 GPU 32개로 3주 동안 학습시켜 언어 모델링에서 돌파구를 열었습니다2. Baidu Research의 실리콘밸리 AI 연구소에서도 2014년에 나온 음성 인식 시스템 Deep Speech의 첫 판은 매개변수가 약 1,100만 개였는데3, 한 해 뒤의 다음 판은 1억 개로 늘었습니다4.
신경망의 매개변수 수와 계산 요구량이 늘어날수록, 신경망 학습을 많은 노드와 많은 GPU에 효율적으로 나누어 병렬화하는 일이 점점 더 중요해집니다. 큰 신경망이 학습을 마칠 때까지 몇 달씩 기다리면 실험이 느려지고 이후 개발도 막히기 때문입니다. 이 글에서는 고성능 컴퓨팅 분야의 기법 하나를 소개하고, 이를 딥러닝에 적용해 신경망 학습 성능을 크게 높일 수 있음을 보여 드립니다.
통신 문제
신경망 학습을 여러 GPU에 나누어 병렬화할 때는, 여러 연산을 쓸 수 있는 GPU들에 어떻게 나눠 맡길지 정해야 합니다. 여기서는 데이터 병렬 확률적 경사 하강법이라는 기법에 집중합니다. 일반 SGD와 마찬가지로 경사 하강은 데이터의 부분집합(미니배치)으로 하며, 전체 데이터셋을 다 돌기까지 여러 번 반복합니다. 그런데 데이터 병렬 학습에서는 GPU마다 신경망 모델 전체의 완전한 사본을 갖고, 반복마다 미니배치 샘플 가운데 일부만 맡습니다. 반복마다 모든 GPU는 자기 데이터로 신경망의 순전파를 돌리고, 이어서 오차 역전파로 신경망 매개변수에 대한 손실의 그래디언트를 계산합니다. 마지막으로 GPU들이 서로 통신해 여러 GPU가 계산한 그래디언트를 평균하고, 평균 그래디언트를 가중치에 적용해 새 가중치를 얻습니다. 모든 GPU는 발맞춰 반복을 진행하며, 한 GPU가 자기 반복을 마치면 가중치를 제대로 갱신할 수 있도록 다른 모든 GPU가 반복을 마칠 때까지 기다려야 합니다. 이는 GPU 하나에서 SGD를 하는 것과 같지만, 데이터를 여러 GPU에 나누고 계산을 병렬로 해서 속도를 높입니다.
GPU가 두 개뿐이고 매개변수가 메가바이트 단위라면, GPU들이 정확히 어떻게 통신하는지는 크게 중요하지 않을 수 있습니다. 하지만 모델의 매개변수가 수십억 개라서 그래디언트가 기가바이트 단위의 공간을 차지하고(매개변수마다 그래디언트 값이 하나씩 있으므로), 수십 개의 GPU를 조율해야 한다면 통신 방식이 결정적으로 중요해집니다.
예를 들어 생각할 수 있는 가장 단순한 통신 방식을 봅시다. GPU마다 미니배치에서 자기 몫에 대한 그래디언트를 계산합니다. 그런 다음 모든 GPU가 자기 그래디언트를 GPU 하나에 보내고, 그 GPU가 모든 그래디언트의 평균을 내 다른 모든 GPU에 돌려보냅니다.
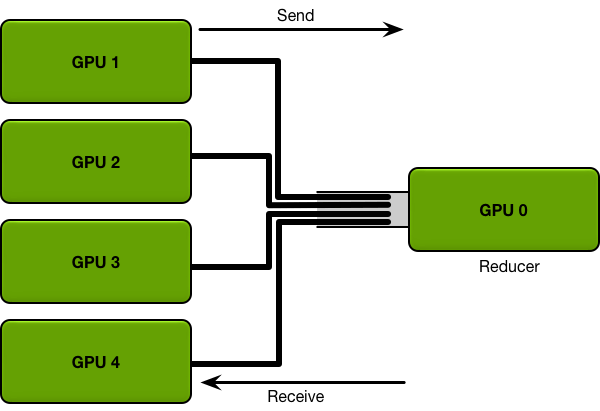
리듀서 GPU 하나로 데이터를 보내고 받기
보낼 데이터가 많을수록 보내는 데 시간이 더 걸립니다. 모든 통신 채널에는 최대 처리량(대역폭)이 있기 때문입니다. 예를 들어 좋은 인터넷 연결은 초당 15메가바이트, 기가비트 이더넷은 초당 125메가바이트의 대역폭을 낼 수 있습니다. HPC 클러스터의 Infiniband 같은 전용 네트워크 하드웨어는 노드 사이에 초당 몇 기가바이트의 대역폭을 낼 수 있습니다.
GPU 하나가 데이터를 받고 보내는 이 단순한 방식에서는, 그 GPU 하나가 모든 GPU에게서 모든 매개변수를 받고 모든 GPU에게 모든 매개변수를 보내야 합니다. 시스템에 GPU가 많을수록 통신 비용이 커집니다.
이 통신 전략이 실제 모델에서 어떻게 작동하는지 따져 봅시다. Baidu의 Deep Speech 24를 본뜬, 학습 가능한 매개변수가 3억 개인 음성 인식 신경망을 예로 듭니다. 매개변수 3억 개에 매개변수당 4바이트면 데이터는 대략 1.2기가바이트입니다. 시스템의 네트워크 하드웨어가 초당 1기가바이트의 대역폭을 낸다고 해 봅시다. 그러면 앞에서 설명한 방식으로 시스템을 GPU 두 개에 병렬화하면 반복마다 1.2초씩 느려집니다. 학습을 GPU 열 개에 병렬화하면 반복마다 10.8초씩 느려집니다. GPU 수가 늘수록 반복 한 번에 드는 시간이 선형으로 늘어납니다. 반복 한 번에 몇 초씩 걸린다 해도, 통신 비용이 이렇게 선형으로 늘어나면 병렬화를 더 하기가 금세 비현실적이 되고 학습 효율이 무너집니다.
한 가지 대안은 학습 알고리즘의 동기적 성질을 포기하고, 모든 GPU가 경사 하강 반복을 발맞춰 진행해야 한다는 제약을 없애는 것입니다. 그러면 모델을 병렬화하기는 쉬워질 수 있지만, 이 제약을 없앤 알고리즘(비동기 SGD의 여러 변형)은 디버깅하기 어려울 수 있고 어떤 모델에서는 기대에 못 미치는 결과로 수렴할 수 있습니다. 그래서 이 글에서는 다루지 않습니다.
대신 고성능 컴퓨팅 분야의 분산 리덕션 알고리즘을 쓰고, 대역폭 면에서 최적인 링 올리듀스를 활용해 통신 문제를 풀 수 있습니다.
링 올리듀스
앞에서 설명한 단순한 통신 전략의 핵심 문제는 통신 비용이 시스템의 GPU 수에 비례해 늘어난다는 점이었습니다. 반면 링 올리듀스는 통신 비용이 일정해서 시스템의 GPU 수와 상관없고, 오직 시스템 안에서 GPU 사이의 가장 느린 연결로만 정해지는 알고리즘입니다. 사실 통신 비용에서 대역폭만 따지고 지연 시간을 무시한다면, 링 올리듀스는 최적의 통신 알고리즘입니다5. (모델이 커서 많은 양의 데이터를 적은 횟수로 보내야 할 때는 이것이 통신 비용을 잘 어림한 값입니다.)
링 올리듀스에서 GPU들은 논리적인 고리 모양으로 배치됩니다. GPU마다 왼쪽 이웃과 오른쪽 이웃이 하나씩 있어야 하며, 데이터는 늘 오른쪽 이웃에게만 보내고 왼쪽 이웃에게서만 받습니다.
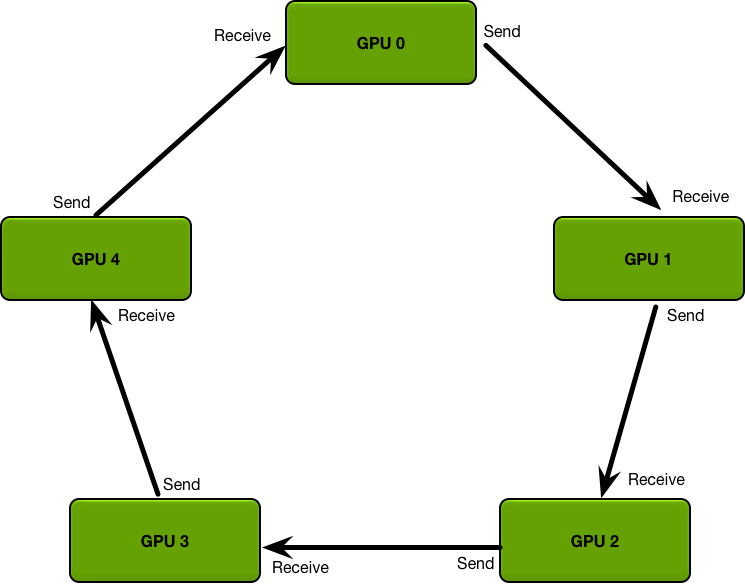
논리적인 고리 모양으로 배치된 GPU들
알고리즘은 두 단계로 진행됩니다. 먼저 스캐터 리듀스를, 그다음 올개더를 합니다. 스캐터 리듀스 단계에서 GPU들은 데이터를 주고받아, 결국 각 GPU가 최종 결과의 한 덩어리씩을 갖게 됩니다. 올개더 단계에서는 GPU들이 그 덩어리들을 주고받아, 결국 모든 GPU가 완전한 최종 결과를 갖게 됩니다.
스캐터 리듀스
단순하게 하려고, 목표가 커다란 부동소수점 배열 하나의 모든 원소를 원소별로 더하는 것이라고 해 봅시다. 시스템에 GPU가 N개 있고, GPU마다 같은 크기의 배열을 갖고 있으며, 올리듀스가 끝나면 모든 GPU가 원래 배열들의 수를 더한 값을 담은 같은 크기의 배열을 가져야 합니다.
먼저 GPU들은 배열을 더 작은 덩어리 N개로 나눕니다(N은 고리에 있는 GPU 수).
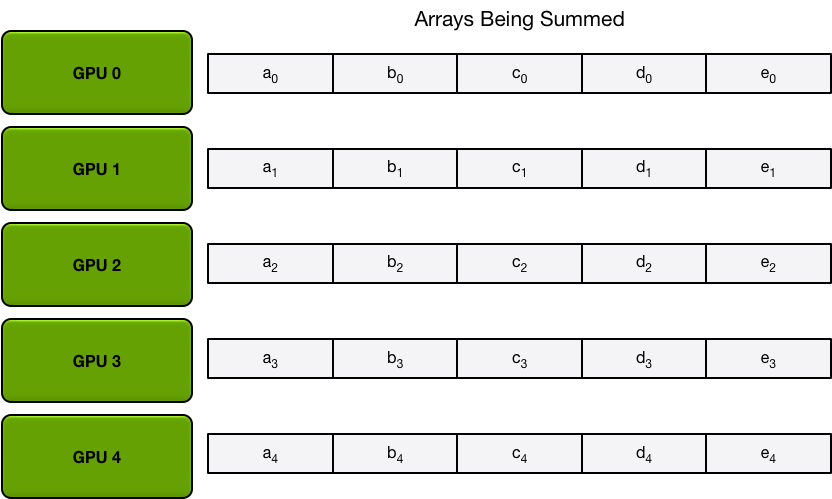
배열을 덩어리 N개로 나누기
다음으로 GPU들은 스캐터 리듀스를 N-1번 반복합니다. 반복마다 GPU는 자기 덩어리 하나를 오른쪽 이웃에게 보내고, 왼쪽 이웃에게서 덩어리 하나를 받아 자기 덩어리에 누적합니다. 각 GPU가 보내고 받는 덩어리는 반복마다 다릅니다. n번째 GPU는 덩어리 n을 보내고 덩어리 n-1을 받는 것으로 시작해, 거기서부터 거꾸로 진행하며 반복마다 직전 반복에서 받은 덩어리를 보냅니다.
예를 들어 첫 번째 반복에서 위 그림의 GPU 다섯 개는 다음 덩어리들을 보내고 받습니다.
| GPU | 보냄 | 받음 |
|---|---|---|
| 0 | 덩어리 0 | 덩어리 4 |
| 1 | 덩어리 1 | 덩어리 0 |
| 2 | 덩어리 2 | 덩어리 1 |
| 3 | 덩어리 3 | 덩어리 2 |
| 4 | 덩어리 4 | 덩어리 3 |
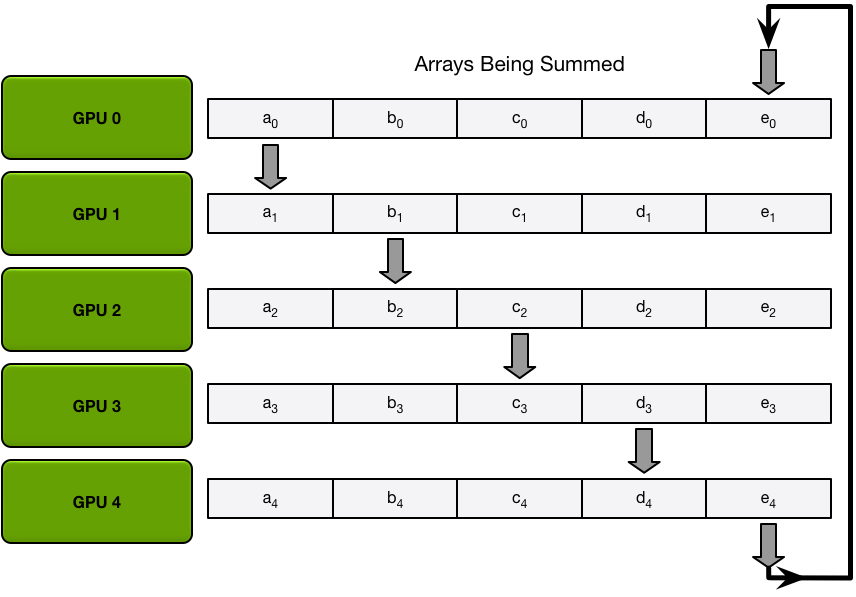
스캐터 리듀스 첫 번째 반복의 데이터 전송
첫 번째 보내기와 받기가 끝나면, 각 GPU에는 두 GPU에 있던 같은 덩어리의 합으로 된 덩어리가 하나씩 생깁니다. 예를 들어 두 번째 GPU의 첫 번째 덩어리는 두 번째 GPU와 첫 번째 GPU에 있던 그 덩어리 값들의 합이 됩니다.
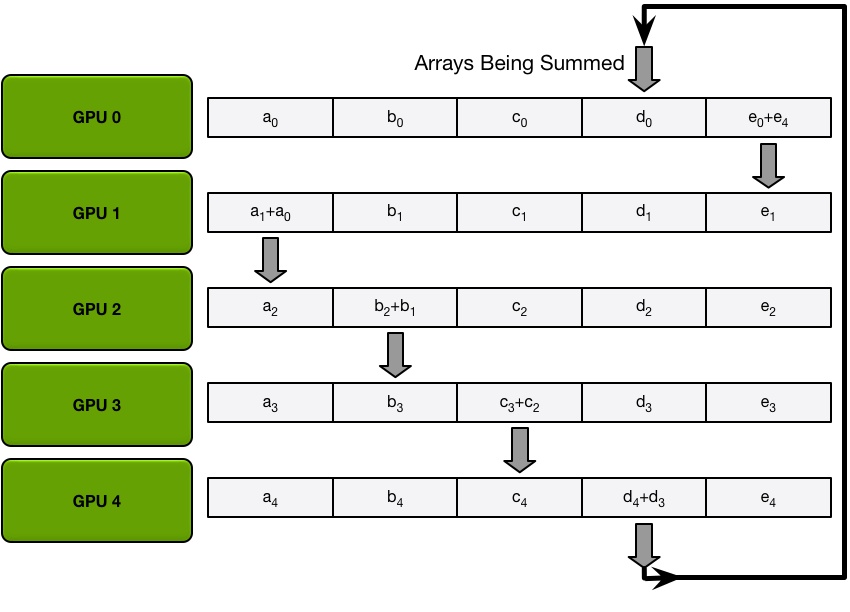
스캐터 리듀스 첫 번째 반복이 끝난 뒤의 중간 합
다음 반복에서도 이 과정이 이어지고, 끝나면 각 GPU는 모든 GPU에 걸친 그 덩어리 값들의 합을 담은 덩어리를 하나씩 갖게 됩니다. 아래 그림들은 첫 번째 반복부터 스캐터 리듀스가 끝날 때까지의 모든 데이터 전송과 중간 결과를 보여 줍니다.
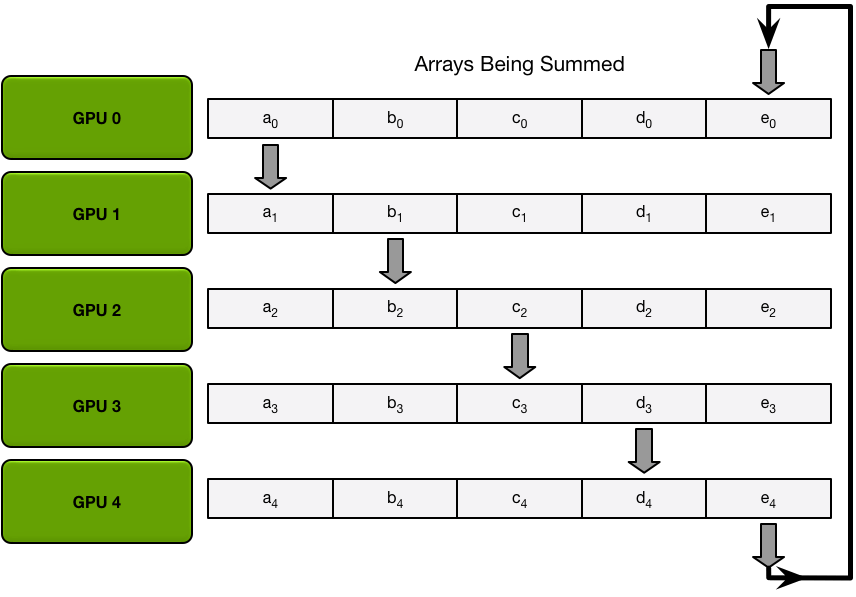
스캐터 리듀스 데이터 전송 (1번째 반복)
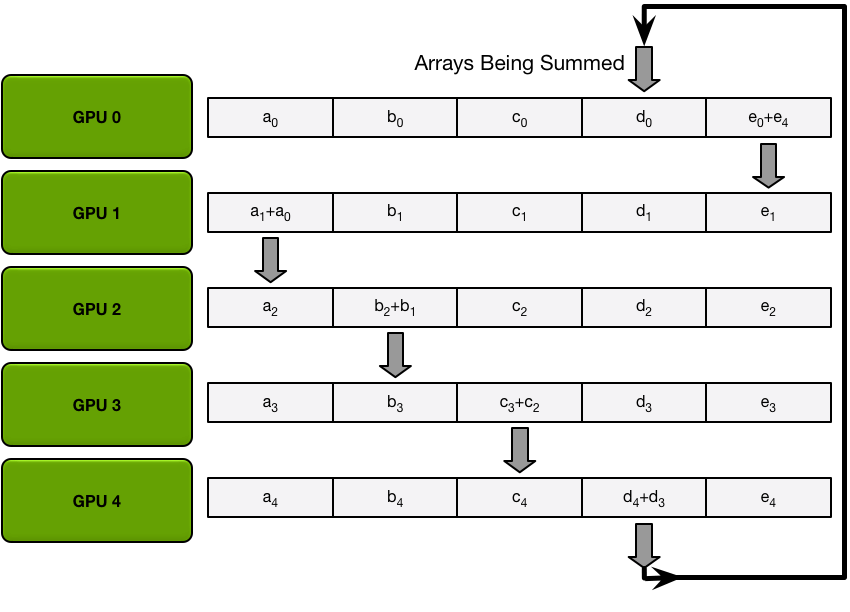
스캐터 리듀스 데이터 전송 (2번째 반복)
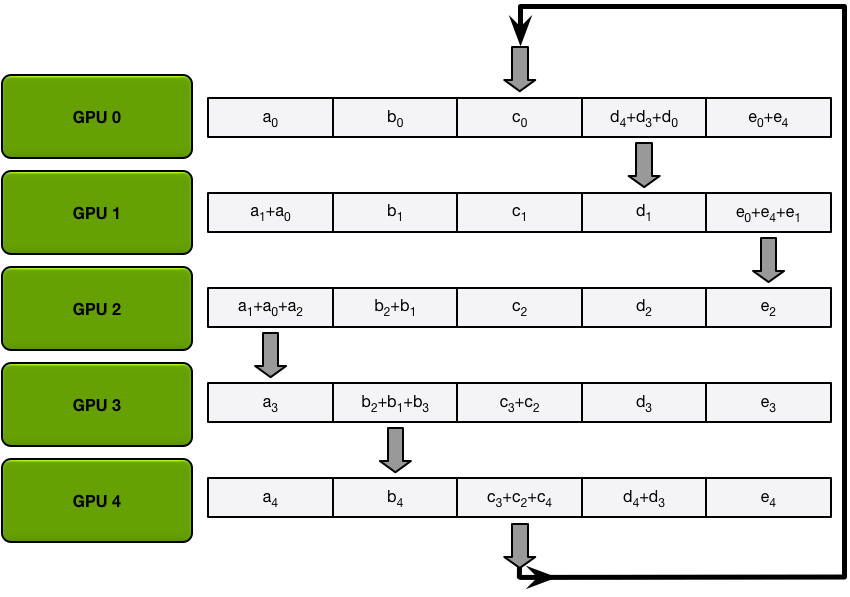
스캐터 리듀스 데이터 전송 (3번째 반복)
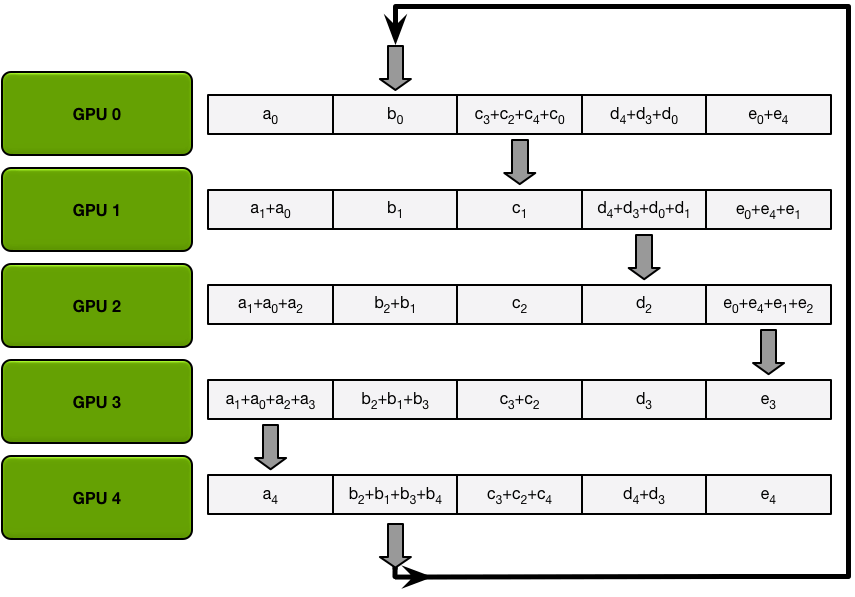
스캐터 리듀스 데이터 전송 (4번째 반복)
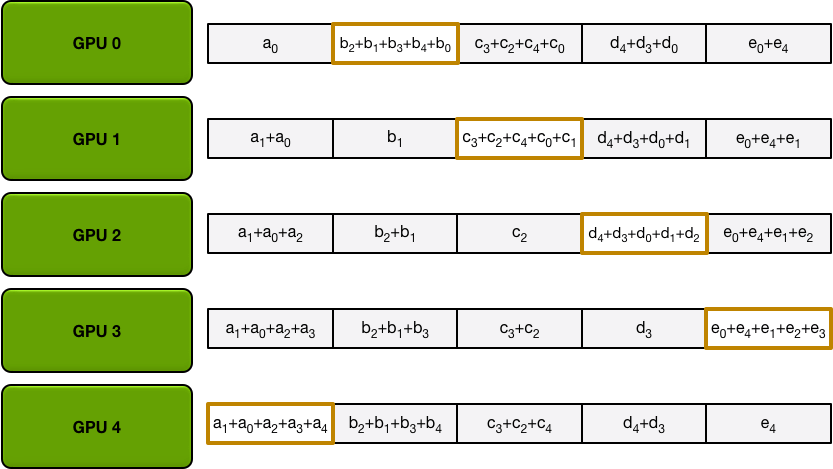
스캐터 리듀스 전송이 모두 끝난 뒤의 최종 상태
올개더
스캐터 리듀스 단계가 끝나면 모든 GPU가 값의 배열을 하나씩 갖고 있고, 그 값들 가운데 일부(GPU마다 덩어리 하나)는 모든 GPU의 몫이 다 들어간 최종 값입니다. 올리듀스를 마치려면 GPU들이 이 덩어리들을 주고받아, 모든 GPU가 필요한 값을 모두 갖게 해야 합니다.
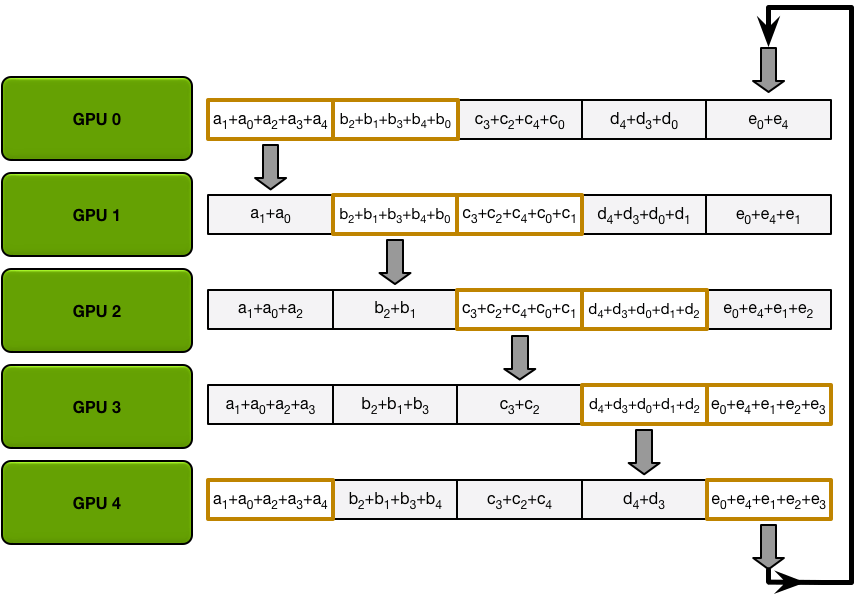
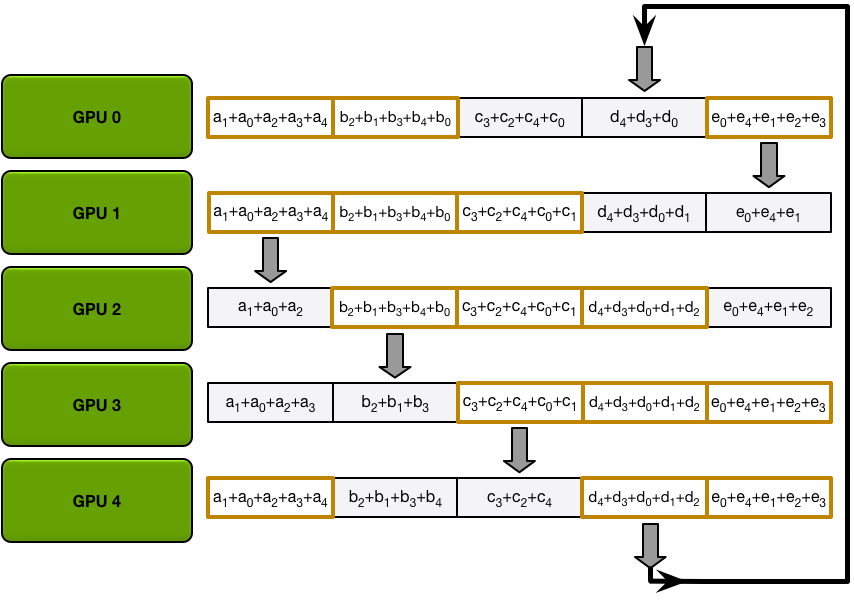
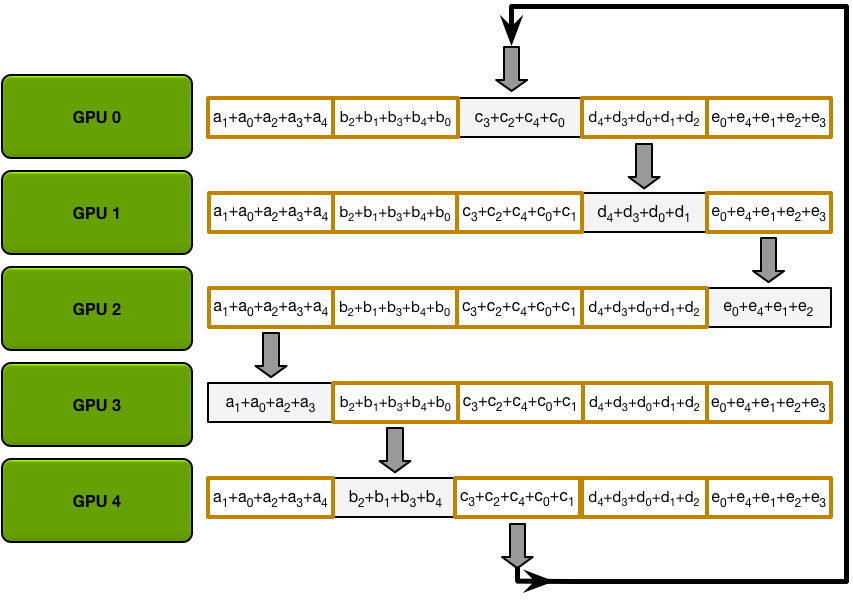
링 올개더는 스캐터 리듀스와 똑같이 진행되지만(보내기와 받기를 N-1번 반복), 받은 값을 누적하는 대신 덩어리를 그냥 덮어씁니다. n번째 GPU는 n+1번째 덩어리를 보내고 n번째 덩어리를 받는 것으로 시작하며, 이후 반복에서는 언제나 방금 받은 덩어리를 보냅니다.
예를 들어 GPU 다섯 개 구성의 첫 번째 반복에서 GPU들은 다음 덩어리들을 보내고 받습니다.
| GPU | 보냄 | 받음 |
|---|---|---|
| 0 | 덩어리 1 | 덩어리 0 |
| 1 | 덩어리 2 | 덩어리 1 |
| 2 | 덩어리 3 | 덩어리 2 |
| 3 | 덩어리 4 | 덩어리 3 |
| 4 | 덩어리 0 | 덩어리 4 |
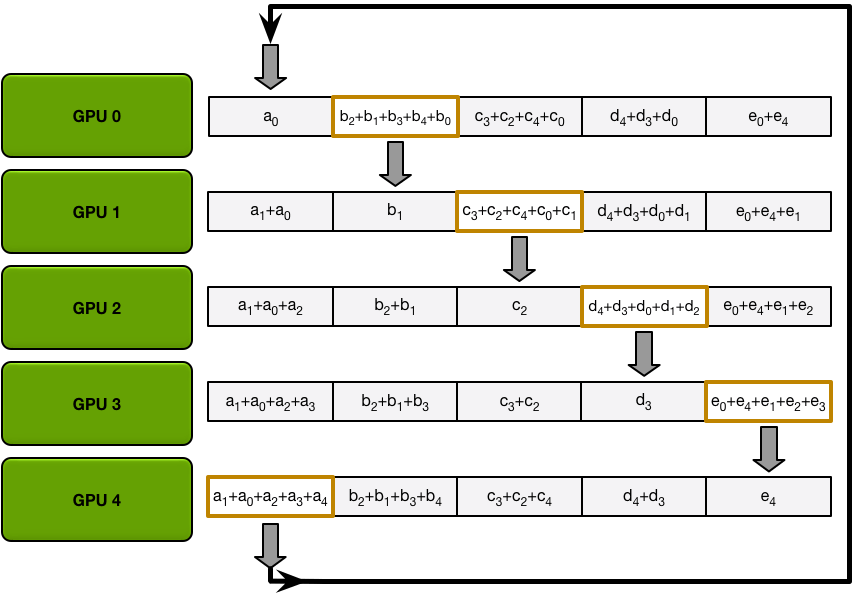
올개더 첫 번째 반복의 데이터 전송
첫 번째 반복이 끝나면 각 GPU는 최종 배열의 덩어리를 두 개씩 갖게 됩니다.
다음 반복에서도 이 과정이 이어지고, 끝나면 각 GPU는 배열 전체에 대해 모두 누적된 값을 갖게 됩니다. 아래 그림들은 첫 번째 반복부터 올개더가 끝날 때까지의 모든 데이터 전송과 중간 결과를 보여 줍니다.
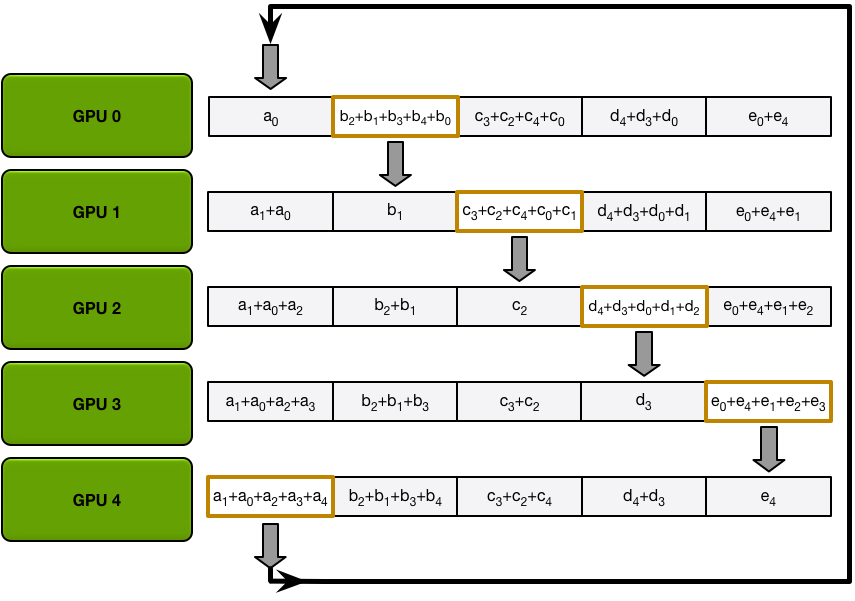
올개더 데이터 전송 (1번째 반복)
올개더 데이터 전송 (2번째 반복)
올개더 데이터 전송 (3번째 반복)
올개더 데이터 전송 (4번째 반복)
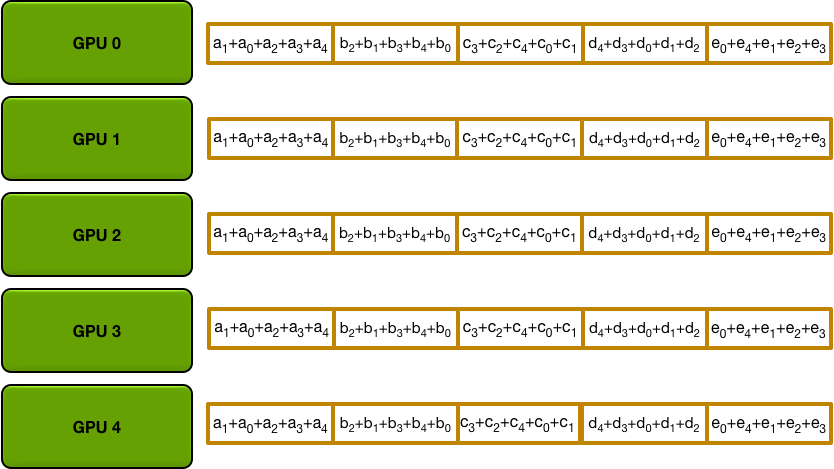
올개더 전송이 모두 끝난 뒤의 최종 상태
올리듀스의 통신 비용
“들어가며”에서 설명한 단순한 통신 알고리즘에서는 통신 비용이 GPU 수에 비례해 늘었던 것을 떠올려 보세요. 올리듀스가 잘 작동하는 가장 큰 이유는 더는 그렇지 않다는 데 있습니다.
앞에서 설명한 시스템에서 GPU N개는 각각 스캐터 리듀스를 위해 N-1번, 올개더를 위해 N-1번 값을 보내고 받습니다. 한 번에 GPU는 K / N개의 값을 보내는데, 여기서 K는 여러 GPU에 걸쳐 더하는 배열에 든 값의 총개수입니다. 따라서 각 GPU가 주고받는 데이터의 총량은
이고, 중요한 점은 이 값이 GPU 수와 상관없다는 것입니다.
모든 전송이 나뉜 반복 단위로 동기적으로 일어나므로, 올리듀스의 속도는 고리에서 이웃한 GPU 사이의 가장 느린(대역폭이 가장 낮은) 연결에 묶입니다. GPU마다 이웃을 알맞게 고르면 이 알고리즘은 대역폭 면에서 최적이며, 올리듀스를 하는 가장 빠른 알고리즘입니다(지연 시간 비용이 대역폭에 비해 무시할 만하다고 가정할 때)5. 대체로 한 노드에 있는 GPU들을 고리에서 서로 붙여 두면 알고리즘이 가장 잘 작동합니다. 그래야 네트워크 경합이 가장 적어지는데, 경합이 생기면 GPU와 GPU 사이 연결의 실효 대역폭이 크게 줄어들 수 있습니다.
올리듀스를 딥러닝에 적용하기
링 올리듀스는 고성능 컴퓨팅 분야에서는 잘 알려진 알고리즘이지만, 딥러닝에서는 꽤 드물게 쓰이는 편입니다. 저희 연구소에서는 이 도구를 모든 데이터 병렬 학습의 바탕으로 삼아, 학습을 수십 개의 GPU로 효과적으로 늘릴 수 있었습니다.
통신 오버헤드를 줄이려면 신경망의 구조를 활용할 수 있습니다. 반복마다 모든 GPU는 순전파를 돌려 오차를 계산하고, 이어서 역전파를 돌려 신경망의 각 매개변수에 대한 그래디언트를 계산합니다. 역전파는 출력층에서 시작해 입력층 쪽으로 가며 그래디언트를 계산하므로, 출력층 매개변수의 그래디언트는 앞쪽 층의 그래디언트보다 훨씬 먼저 나옵니다. 올리듀스는 신경망 매개변수의 일부만 골라 따로 할 수도 있으므로, 다른 그래디언트를 아직 계산하는 동안 출력층 매개변수에 대한 올리듀스를 시작할 수 있습니다. 이렇게 하면 통신이 역전파 단계의 나머지 계산과 겹치므로, 각 GPU가 통신이 끝나기를 기다리는 시간의 총합이 줄어듭니다.
예를 들어 2번 참고 문헌2에 나온 것과 비슷하지만 학습 가능한 매개변수가 약 3억 개인(그래서 그래디언트 총크기가 1.2기가바이트인) 언어 모델을 생각해 봅시다. 올리듀스를 쓰면 각 GPU는 약 2.4기가바이트의 데이터를 보내고 받아야 합니다. CUDA를 인식하는 MPI 구현(OpenMPI 같은)을 쓰면 GPUDirect RDMA로 GPU 사이에 초당 대략 10기가바이트의 대역폭으로 데이터를 옮길 수 있습니다. 하지만 저희 클러스터의 노드 사이 연결은 더 느려서, Infiniband가 초당 대략 6기가바이트의 대역폭을 냅니다. 병목은 Infiniband 연결이므로, 반복 한 번에는 대략 다음 시간이 듭니다.
신경망의 깊은 층일수록 그래디언트가 먼저 나오므로, 역전파 전체가 끝나기 전에 데이터 전송을 시작할 수 있습니다. 그래서 실제 오버헤드는 400밀리초보다 적을 수 있으며, 통신과 계산이 겹치는 정도는 최적화하는 신경망의 성격에 따라 다를 수 있습니다.
저희는 앞에서 말한 언어 모델을 구현하고, GPU 하나(통신 오버헤드 없음)에서 GPU 40개까지 늘려 가며 반복당 걸리는 시간을 시험했습니다. 이 GPU 40개는 GPU 8개씩 든 노드 5개로 구성되고, 노드끼리는 Infiniband로 이어져 있습니다. 배치 크기 32로 언어 모델을 300번 반복해 돌리고, 초당 처리한 샘플 수를 계산했습니다.
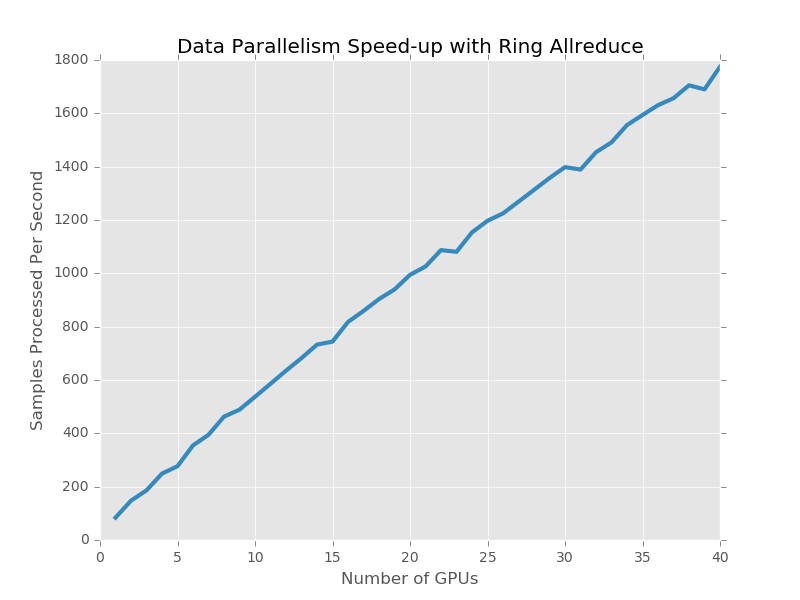
매개변수 3억 개짜리 언어 모델에서 초당 처리 샘플 수는 동기 학습을 함께 하는 GPU 수에 비례해 늘어납니다.
보시다시피 전체 시스템의 처리량은 GPU 수에 비례해 늘어납니다. 어느 지점을 넘으면 GPU를 더 넣어도 반복 한 번이 크게 느려지지 않습니다. GPU 40개에서 모델을 돌리면 반복당 대략 650~700밀리초가 걸리고, GPU 하나에서는 대략 370밀리초가 걸립니다. 저희 어림으로는 통신에 400밀리초가 걸릴 테니, 역전파와 데이터 전송을 겹쳐서 반복마다 70~120밀리초를 더 아끼고 있는 셈입니다.
맺음말
고성능 컴퓨팅 분야의 기법인 링 올리듀스를 쓰면 신경망의 그래디언트를 많은 장치와 많은 노드에 걸쳐 효율적으로 평균할 수 있습니다. 학습할 때 대역폭 면에서 최적인 이 알고리즘을 쓰면, 동기적 확률적 경사 하강법의 결정성과 예측 가능한 수렴 특성은 그대로 지키면서도 통신 오버헤드를 크게 줄이고 훨씬 많은 장치로 늘릴 수 있습니다. 이 알고리즘은 신경망 구조나 딥러닝 프레임워크를 가리지 않고, 데이터 병렬 학습의 효율에 눈에 보이는 이득을 바로 줄 수 있으며, 꽤 단순해서 구현하기도 쉽습니다.
여러분이 이 기법을 더 쉽게 활용할 수 있도록, 저희는 오늘 baidu-allreduce를 공개합니다. 올리듀스 알고리즘을 보여 주는 C 라이브러리로, MPI를 쓰는 어떤 애플리케이션에도 넣을 수 있습니다. 또한 Uber의 훌륭한 Horovod 라이브러리는 저희가 여기서 처음 개척한 기법을 구현하고 있습니다.
다른 딥러닝 프레임워크들도 알맞은 곳에서 비슷한 기법을 활용하기를, 그리고 이 도구들로 여러분이 어떤 프레임워크를 고르든 신경망 모델을 많은 기계로 쉽고 효율적으로 늘릴 수 있기를 바랍니다.
참고 문헌
각주
-
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. “ImageNet classification with deep convolutional neural networks.” Advances in neural information processing systems. 2012. ↩
-
Jozefowicz, Rafal, et al. “Exploring the limits of language modeling.” arXiv preprint arXiv:1602.02410 (2016). ↩ ↩2
-
Hannun, Awni, et al. “Deep speech: Scaling up end-to-end speech recognition.” arXiv preprint arXiv:1412.5567 (2014). ↩
-
Amodei, Dario, et al. “Deep speech 2: End-to-end speech recognition in english and mandarin.” arXiv preprint arXiv:1512.02595 (2015). ↩ ↩2
-
Patarasuk, Pitch, and Xin Yuan. “Bandwidth optimal all-reduce algorithms for clusters of workstations.” Journal of Parallel and Distributed Computing 69.2 (2009): 117-124. ↩ ↩2